- DeepSeek-V4.1-Flash-1017 深度拆解:架构没变,凭什么把 Agent 成本打到 1/50?
- 一、模型概览
- 1.1 官方官宣说了什么
- 1.2 关键前提:1017 是"小版本",不是新架构
- 1.3 版本谱系
- 1.4 规格一览
- 二、核心技术:五大架构创新
- 2.1 要解决的根本矛盾
- 2.2 创新一:Causal Encoder-Decoder(CED)——Prefill 计算砍半
- 2.3 创新二:CSA2——跨层 KV 与索引复用
- 2.3.1 三种静态模式
- 2.3.2 分层稀疏索引器(Hierarchical Sparse Indexer)
- 2.3.3 两处减法
- 2.4 创新三:FP4 主 KV 缓存——存储再砍一半
- 2.5 创新四:SWA Bounded Replay——把"缓存未命中"从灾难变成小摩擦
- 2.6 创新五:Engram / DSpark / Single-Pass mHC
- 2.7 创新账本
- 三、1017 自身的优化:不换架构,怎么涨 11 分?
- 3.1 优化一:把"造任务"本身变成可训练能力
- 3.2 优化二:两条专门的训练环境生产线
- 3.3 优化三:可连续控制的推理力度(1~100)
- 3.4 优化四:更短的任务时间与输出长度
- 3.5 优化五:Harness 协同优化
- 3.6 优化六:"许愿式编程"——从零构建完整项目
- 四、核心能力效果:评测全景
- 4.1 官方横向对比(1017 版本)
- 4.2 相比上一版的进步幅度(1017 的价值所在)
- 4.3 技术报告里的完整评测(V4.1-Flash 基线)
- 4.4 换 Harness 会不会掉点?(落地最关键的一张表)
- 4.5 第三方机构的口径(与官方的温差)
- 五、价格情况
- 5.1 官方定价(人民币 / 百万 tokens)
- 5.2 官方定价(美元 / 百万 tokens)
- 5.3 新增的 Search / Fetch 计费
- 六、性价比分析
- 6.1 帕累托前沿:SWE 场景的性价比位置
- 6.2 实际账单算一遍
- 6.3 成本优势的三个来源
- 6.4 与竞品的性价比对照
- 七、短板与风险
- 7.1 六个必须注意的点
- 7.2 官方自己划的能力边界
- 7.3 一句话定位
- 八、总结
- 8.1 四点结论
- 8.2 数字速记
- 参考资料
DeepSeek-V4.1-Flash-1017 深度拆解:架构没变,凭什么把 Agent 成本打到 1/50?
调研对象:DeepSeek-V4.1-Flash-1017(2026 年 10 月 17 日官方发布) 一手来源:DeepSeek 官方公众号发布稿、API 官方文档、Hugging Face 模型卡与 51 页技术报告、Artificial Analysis、LMArena、OpenRouter、Terminal-Bench 官方榜 一句话结论:架构完全继承 V4.1-Flash,涨分全靠后训练;Agent 能力打进第一梯队,成本维持在 1/50 量级。
一、模型概览
1.1 官方官宣说了什么
2026 年 10 月 17 日,DeepSeek 官方公众号发布《DeepSeek V4.1 Flash 新版本:许愿式编程一键成真》,开篇即明确:
"DeepSeek V4.1 Flash 现已更新至 V4.1-Flash-1017 版本,官方网页端、APP 与 API 模型已同步变更为新模型。" [1]
官宣交代了四件事,也是本文后续章节的骨架:
| # | 官宣内容 | 关键信息 |
|---|---|---|
| 1 | 性能-费用的帕累托改进 | 各基准长足提升,同时缩短任务运行时间与输出长度,多个 Harness 下达到新的性能-费用帕累托最优 |
| 2 | 从零开始的完整项目开发 | 通过基于自反馈的 RL,提升游戏开发、3D 建模等"许愿式"编程能力 |
| 3 | 开放自研搜索 API | 新增 Search / Fetch 接口,各 5 元 / 千次 |
| 4 | 模型开源 | HuggingFace + ModelScope 同步放出权重 |
同日,Hugging Face 仓库 deepseek-ai/DeepSeek-V4.1-Flash-1017 上线(创建 2026-10-17 02:40 UTC,权重最后更新 05:46 UTC,48 个 safetensors 分片)[2];API 文档同步把 deepseek-flash 的模型版本标注为 DeepSeek-V4.1-Flash-1017 [3]。
1.2 关键前提:1017 是"小版本",不是新架构
这一点决定了后面所有数据该怎么读,必须先说清楚。
证据一:两份 config.json 逐项一致。
| 配置项 | V4.1-Flash | V4.1-Flash-1017 |
|---|---|---|
architectures |
DeepseekV41ForCausalLM |
DeepseekV41ForCausalLM |
model_type |
deepseek_v41 |
deepseek_v41 |
num_hidden_layers |
40 | 40 |
n_routed_experts |
384 | 384 |
max_position_embeddings |
1048576 | 1048576 |
kv_source_layer_ids |
[2,8,14,20] |
[2,8,14,20] |
engram_layer_ids |
[1,14] |
[1,14] |
| 权重分片数 | 48 | 48 |
数据来源:V4.1-Flash config.json [4] 与 1017 config.json [5]。
证据二:官方自己的措辞。
1017 模型卡第一句是 "a minor update to DeepSeek-V4.1-Flash, delivering substantial improvements across reasoning, coding, agentic tasks, and visual benchmarks" [2]。"minor update"(小更新)却带来"substantial improvements"(大幅提升)——这个矛盾本身就是本文要解释的核心现象。
重点:由此得出两条阅读路径——
- 讲架构创新,必须读 V4.1-Flash 的技术报告(51 页),1017 的模型卡只有一张评测表和几行说明;
- 讲"为什么一个月涨 11 分",答案在后训练,不在架构。
1.3 版本谱系
DeepSeek-V4 系列
├── V4-Flash(284B backbone / 13B 激活)
├── V4-Pro(1.6T backbone / 49B 激活)
│
└── V4.1-Flash(552B backbone / Prefill 8B、Decode 16B)
    │   ← 2026-09 发布,架构大改:
    │     CED / CSA2 / FP4 KV / SWA Bounded Replay / Engram / DSpark
    │     配 51 页技术报告
    │
    └── V4.1-Flash-1017  ← 2026-10-17 发布,本次主角
          ├─ 架构:完全继承(config.json 逐项一致)
          ├─ 变化:后训练权重 + 数据管线(自反馈 RL + Agent 任务合成)
          └─ 结果:Terminal-Bench 4.0 从 31.2 → 42.3,DeepSWE 74.2 → 77.0
1.4 规格一览
| 项目 | 规格 | 来源 |
|---|---|---|
| 总参数(Backbone) | 552B | [6] |
| 激活参数 | Prefill 8B / Decode 16B | [6] |
| 上下文 | 1M tokens | [3] |
| 最大输出 | 384K tokens | [3] |
| 输入模态 | 文本 + 图像(原生多模态,非外挂) | [7] |
| 输出模态 | 文本 | [6] |
| 思考模式 | 非思考 / 思考(默认开启),reasoning_effort 连续可调 1~100 |
[8] |
| 许可 | MIT(权重可商用) | [2] |
| 权重格式 | FP8 量化(专家权重 FP4),48 分片 | [5] |
| 视觉编码器 | DeepSeek-ViT,32 层,patch 14,3×3 pixel-unshuffle,单图最多 1024 token | [5] |
| 并发限制 | 2500(V4-Pro 为 500) | [3] |
二、核心技术:五大架构创新
阅读提示:本章讲的是 V4.1-Flash 引入、1017 完整继承的架构。1017 的性能上限完全建立在这套架构之上——不理解 CED 和 KV 压缩,就无法理解它为什么能把长上下文 Agent 做到这个价格。
2.1 要解决的根本矛盾
技术报告开篇就把矛盾摆出来了:长程 Agent 的调用模式让模型负载变成输入密集型。
一次 Agent 任务:
  工具调用 → 新增一大段工具返回 → KV Cache 未命中 → 重新 Prefill
  下一轮  → 又一段工具返回        → 又未命中         → 又 Prefill
在这种模式下,Prefill 计算、KV Cache 存储、KV Cache 搬运三者同时成为瓶颈。技术报告原话:稀疏注意力已经把"算"的成本降下来了,于是"存"和"搬"变成了新的主要瓶颈 [9]。
V4.1-Flash 的所有架构创新,都是在打这三个瓶颈。
2.2 创新一:Causal Encoder-Decoder(CED)——Prefill 计算砍半
这是最核心的架构创新,也是"8B / 16B 非对称激活"的来源。
思路源自 YoCo(Sun et al., 2024):让上半部分层直接共享下半部分层生成的 KV Cache。CED 在此基础上做了结构性改进——提升整体 KV 缓存容量与 KV 生成的"计算深度" [9]。
具体做法是把 40 层 Transformer 切成两半:
        输入 1M tokens
              │
   ┌──────────▼────────────┐
   │  前 20 层:Causal Encoder │  只跑这 20 层
   │  (激活 8B 参数)         │  Prefill 只算到这里
   └──────────┬────────────┘
              │ H(L/2) 最终隐状态
              │
   ┌──────────▼────────────┐
   │  后 20 层:Decoder       │  KV 由 H(L/2) 投影而来
   │  (激活 16B 参数)        │  不自己生成全局 KV
   └──────────┬────────────┘
              ▼
           输出 token
数学表达(技术报告公式 1):
C_l = H(L/2) · W_KV_l
Z_l = H(L/2) · W_Z_l        (l > L/2)
即第 l 层(l > L/2)的 KV 条目 C_l 与压缩权重 Z_l,都从第 L/2 层隐状态投影得出,不是从自己的隐状态 H_l 算出。
效果:对长序列 N ≫ n_win,Prefill 复杂度从 O(N·L) 降到 O(N·L/2 + n_win·L/2) ≈ O(N·L/2),整体计算量减半。
注意:SWA 没有偷懒。 滑动窗口注意力的 KV 仍逐层从当前层隐状态计算,以保证局部 KV 的"计算深度"。代价是 Decoder 的 SWA KV 需额外 prefill n_win × L/2 个 token——因此配套引入 Decoder SWA Bounded Replay(见 2.5)。
重点:这就是它参数写成"8B / 16B"两个数字而不是一个的原因。Prefill 用 8B,Decode 用 16B。Agent 场景 95% 的算力花在 Prefill 上,这个非对称设计直接命中成本要害。
2.3 创新二:CSA2——跨层 KV 与索引复用
Compressed Sparse Attention 2 解决的是"KV 存得贵"。
技术报告指出,KV 成本可在三个乘性维度上压缩 [9]:
| 维度 | 代表技术 | 作用 |
|---|---|---|
| 条目大小 | GQA、MLA | 减少 KV 头数 / 用共享潜变量 |
| 序列长度 | CSA、HCA(V4 引入) | 每 m 个 token 压成 1 个条目 |
| 层维度 | IndexCache、YOIO、HySparse | 层间复用缓存或索引 |
CSA2 的野心是三个维度同时下手——这也是它区别于既有方案的地方:IndexCache 只复用索引、省不了主 KV;YOIO 全层共享一次路由、限制表达力;HySparse 仍保留完整注意力层。没有一项覆盖全部三个维度。
2.3.1 三种静态模式
每个 CSA2 层被静态分配三种模式之一。三种模式都自己算 query 和 SWA KV,区别在于主 KV、Indexer K、Top-K 索引这三样从哪来:
| 模式 | 主 KV | Indexer K | Top-K 索引 | 计算量 |
|---|---|---|---|---|
Full |
本层计算 | 从主 KV 投影 | 本层重新选 | 完整路径,最贵 |
Reindex |
复用最近一个 Full 层 | 复用 | 本层重算(可变化) | 省主 KV |
Reuse |
复用最近一个 Full 层 | 复用 | 复用最近一个产出索引的层 | 最省 |
重点:这个设计最巧妙处在于把"缓存共享"与"索引复用"解耦了。Reindex 允许稀疏选择在不同层之间变化(保住表达力),同时主 KV 和 Indexer K 仍共享(省存储)。过去的方案要么只能共享索引,要么只能共享缓存。
2.3.2 分层稀疏索引器(Hierarchical Sparse Indexer)
Decoder 里第一个 Full 模式层选出自己的 Top-512 索引,同时把选中的块建成一个共享候选池。后续所有 Reindex 层只能从这个池子里选 Top-512。
效果:越深的索引层搜索范围越小,索引成本与上下文长度解耦。这是 1M 上下文还能保持低延迟的关键。
2.3.3 两处减法
CSA2 相比 CSA 还做了简化,官方说法是"简化实现 + 提升训练效率":
- 去掉相邻压缩条目之间的重叠源条目;
- 去掉压缩时的绝对位置嵌入;
- Indexer K 改为从主 KV 投影,替代 CSA 里独立的压缩路径。
2.4 创新三:FP4 主 KV 缓存——存储再砍一半
这是"KV 存得贵"的第二刀。做法是把量化感知训练(QAT)从 Indexer 扩展到主 KV Cache。
选型细节(技术报告 2.4.4):
| 项目 | 选择 | 原因 |
|---|---|---|
| 格式 | OCP 标准 MXFP4 | 兼容尽可能多的硬件平台 |
| 数据格式 | E2M1 | 在约 4 bit 的候选格式里精度与简单性的平衡点 |
| Scale | 每 16 通道一个 E4M3 | 参考 NVFP4,但省掉二级全局 scale |
| 动态范围 | 最大 448 × 6 = 2688 | 远高于 KV 量级上界,够用 |
注意一个工程细节:FP4 在这里的作用是省存储,不是加速矩阵乘。注意力计算前会先把缓存反量化回更高精度,因此不需要硬件原生支持 FP4 矩阵乘——这是它能跨硬件平台部署的关键。
2.5 创新四:SWA Bounded Replay——把"缓存未命中"从灾难变成小摩擦
这是"KV 搬得贵"的解法,也是整套设计里最巧妙的一处。
问题:SWA 的 KV 依赖跨层累积。要精确重建 L 层的 SWA KV,得重放 L × n_win 个 token——代价太大。所以过去的方案只能把 SWA KV 也持久化到 SSD,占空间又占带宽。
做法:只重放最近 n_win 个 token,并接受这是近似状态。重放区间起点为 s 时,位置 i 的 query 只关注 [max(s, i-W+1), i] 范围内的 SWA key。
效果(这是重点):
精确重建:L × n_win 个 token 的前向计算    ← 灾难
Bounded Replay:n_win 个 token 的前向计算  ← 可以接受
技术报告原话:"把一次灾难性的 miss 变成一次优雅、廉价的降级(a graceful, inexpensive degradation)"——正因如此,SWA KV 才可以完全从持久化 KV 缓存里删掉。
2.6 创新五:Engram / DSpark / Single-Pass mHC
这三个是效率侧的"锦上添花",但组合起来收益不小。
| 组件 | 是什么 | 关键参数 |
|---|---|---|
| Engram | 条件记忆模块,把"记忆"与"计算"解耦,按 token 查表 | 196B 参数,分 2 个模块置于第 1、14 层;N-gram 阶数 {2,3,4},8 个哈希头,每阶总嵌入维度 2048;每头索引约 16M 条目的表(表长取不同素数);FP8 精度 |
| DSpark | 投机解码,半自回归草稿 + 置信度调度验证 | 3 层 Transformer 草稿器,SWA 窗口 128;一次前向并行出 5 个草稿位置;轻量 Markov 头建模草稿间依赖;置信度头预测逐位置接受概率 |
| Single-Pass mHC | 单遍残差流混合,配 Mega-mHC kernel | 把 V4 里 3 个串行 kernel 合成 1 个,激活内存流量从 (4n+4)d 降到接近下界 (2n+2)d |
重点(DSpark 的一个细节):它与 V3 的 MTP 不同。MTP 是预训练阶段与主干联合训练;DSpark 是预训练之后单独一个阶段训练,训练时主干冻结。后训练阶段继续训练 DSpark,但梯度不回传主干。这样 DSpark 能一直跟随策略演进,同时加速在线服务和 RL rollout。
Engram 的推理细节:地址是确定性的,嵌入可通过后台 RDMA 从主机内存预取,第一个模块的预取还能与第一个 Transformer 块的计算重叠。
2.7 创新账本
| 指标 | 数值 | 对比基线 |
|---|---|---|
| 全局 KV(常驻 HBM) | 890 bytes / token | 约为 V4-Flash 的 1/4 |
| 持久化 KV(SSD / 主机内存) | 约 1/8 | 靠 SWA Bounded Replay 实现 |
| Prefill 计算 | 减半 | 靠 CED 的 O(N·L/2) |
| 相比 DeepSeek-V1 的 KV 压缩 | 437 倍 | 技术报告 Figure 1(b) |
| 骨干参数 | 552B | V4-Flash 为 284B |
| 激活参数 | Prefill 8B / Decode 16B | V4-Flash 为 13B 固定 |
| 训练数据 | 45T tokens 多模态语料 | 64K 序列训稀疏注意力,34T token 处扩到 1M |
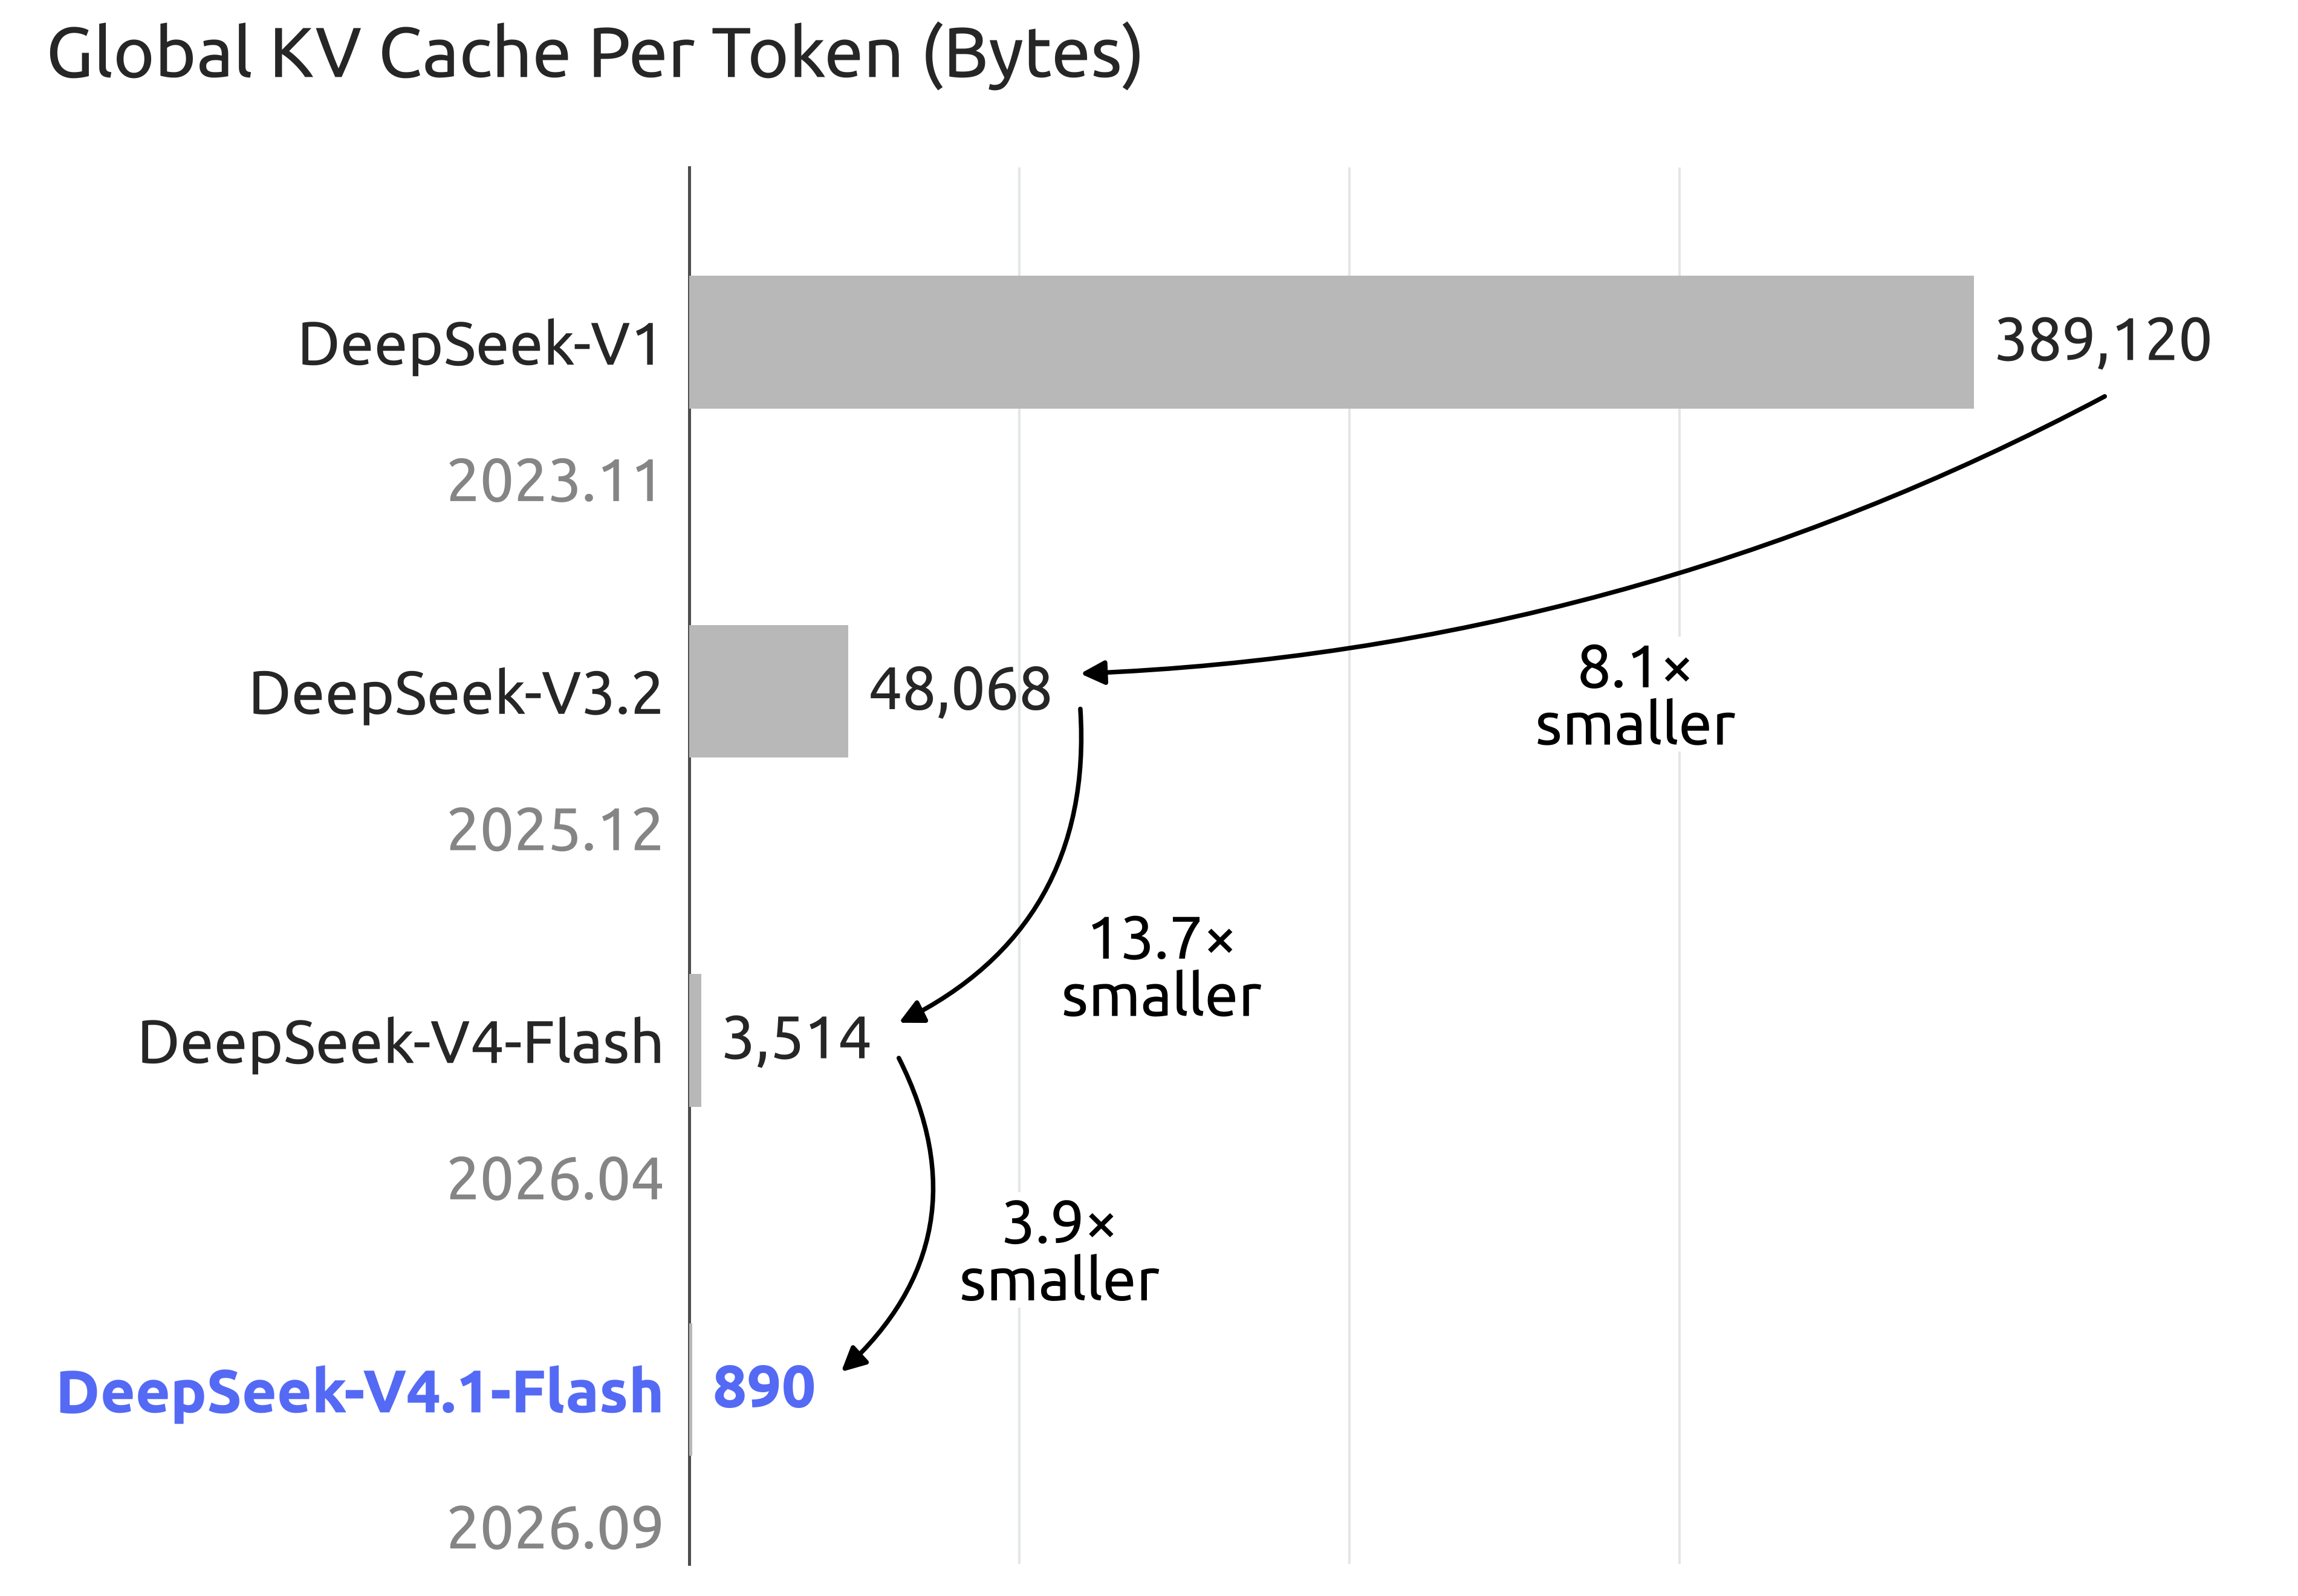
图 1:DeepSeek 各代模型每 token 的全局 KV Cache 大小(字节)。V4.1-Flash 相比 V4-Flash 约 4 倍、相比 V1 约 437 倍压缩。来源:官方技术报告 Figure 1(b) [9]
弊端说明(官方自己承认的):技术报告结论章节明确写道,CSA2 的候选选择误差、SWA Bounded Replay 的近似状态重建,在未被测试覆盖的极端边界场景下仍可能导致能力退化。原话是 "no finite test suite can cover every extreme input and deployment condition",并点名后续要重点压测"长上下文稀疏检索"和"缓存恢复边界的 SWA 状态重建" [9]。
这意味着:接近 1M 上下文的场景必须自建压测集,不能只信官方 benchmark。
三、1017 自身的优化:不换架构,怎么涨 11 分?
这是本章的核心问题:架构一模一样,Terminal-Bench 4.0 却从 31.2 涨到 42.3。钱花在哪了?
官方给出的答案集中在一处——后训练。
3.1 优化一:把"造任务"本身变成可训练能力
技术报告 5.1.1 节揭示了一个关键思路转变 [9]:
传统上构造高质量训练任务需要大量人工。但我们观察到,模型已经开始具备构造自己训练任务的能力——尽管还远不完美。
于是把每个任务形式化成三元组:
任务 = (problem, environment, verification system)
        问题      环境              验证系统
再用两个维度评估任务质量,并把它们当作奖励信号去迭代训练模型"造更好的任务":
| 维度 | 含义 |
|---|---|
| 难度(difficulty) | 保证任务不平凡 |
| 正确性(correctness) | 保证三个组件里没有致命缺陷 |
重点:这是一个正反馈飞轮——模型造任务 → 用任务训练模型 → 模型变强 → 能造更难的任务。而且每次任务被用于新的 RL run 时,产生的轨迹又成为重新审计任务质量的新证据。
3.2 优化二:两条专门的训练环境生产线
| 生产线 | 数据来源 | 构造方式 |
|---|---|---|
| 通用 Agent | 内部员工 + 外部合作伙伴自愿回传的交互数据 | 按真实接口造大量 mock 工具(复刻输入格式、输出结构、API schema、行为约束),覆盖常用 SaaS 与企业应用;同时大规模收集负面反馈与失败案例,生成单轮/多轮环境,系统化复现失败 |
| Coding Agent | ① 内部与外部伙伴的高复杂度或模型表现差的会话(按轨迹去重)② 达到 star 阈值的公开 GitHub 仓库 | 多 Agent 协作:判定可容器化 + 可自动验证 → 选定 commit 作为起点 → 设计实现方向与评测点(fail-to-pass + pass-to-pass)→ 独立 Agent 搭环境并自测 → 清除泄漏答案的痕迹 → 打包镜像层 → 多 Agent 试解 → 质检 Agent 审查 → 不合格由修复 Agent 修完再验 |
注意:这套流程里"质检"和"修复"是独立 Agent,且明确要检查四类问题:环境问题、事实错误、评测点与任务描述不匹配、可作弊风险(hackability)。最后一条尤其关键——防止模型学会"骗过测试"而不是"真正解决问题"。
3.3 优化三:可连续控制的推理力度(1~100)
这是 1017 最有实用价值的能力,它把"效果"与"成本"变成一根连续的旋钮。
API 暴露三档预设,对应内部数值:
| API 预设 | 内部力度值 |
|---|---|
low |
50 |
high |
75(默认) |
max |
100 |
官方实测的力度-收益曲线 [9]:
| 力度 25 → 100 | 成绩变化 | 输出 token 变化 |
|---|---|---|
| 8 项推理基准平均 | 67.1% → 76.3% | 约 2.5× |
| DeepSWE v1.1 | 66.0% → 74.2% | 约 2.5× |
| Terminal-Bench 2.1 | 82.4% → 90.6% | 约 2.5× |
重点结论(能直接省钱的那句话):收益前重后轻。官方原文——"60~80 区间已经能拿到接近最大档的大部分精度,而只花不到一半的 token 预算;最后冲到 100 会让 Agent 轨迹拉长 1.6~1.8 倍,却只换来边际提升"。
所以日常用 high(75),只有最硬的骨头才开 max(100)。
技术报告还特别指出,单轮推理上学到的力度控制能忠实迁移到长程 Agent 轨迹上——它控制的是跨轮次的探索量与验证量。这说明它不是"多想想"的 prompt 技巧,而是训练进权重里的能力。
3.4 优化四:更短的任务时间与输出长度
官宣里有一句容易被忽略的话:"在提升性能的同时,我们还缩短了模型的任务运行时间与输出长度" [1]。
这句话为什么重要?它直接反驳了一个常见质疑:"提升是不是靠多想、多写、多试出来的?"——官方明确说不是,性能上升的同时,时间与输出长度是下降的。
这也是"帕累托改进"这个说法的由来:不是拿成本换性能,而是两个维度同时变好。
3.5 优化五:Harness 协同优化
官宣明确写了:
"本次我们着重针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等平台框架进行了优化。请升级到 DeepSeek Harness 0.2.1-rc.1 及以上版本,以获得适配新版模型的最优体验。" [1]
DeepSeek Harness 的 Release 记录也印证了这一点——v0.2.1-rc.1 更新日志第一条就是"适配 DeepSeek-V4.1-Flash-1017 上线",同时"适配 DeepSeek Search 与 Fetch API" [10]。
注意:Harness 版本低于 0.2.1-rc.1,拿到的可能不是完整收益。
3.6 优化六:"许愿式编程"——从零构建完整项目
官宣单独用一节讲这个能力,案例是"示例 4:Valley of Ages——以 3D 场景动态展现从史前时代到现代的发展历程"。
官方描述:通过基于自反馈的强化学习,提升游戏开发、3D 建模等方面从零开始构建完整项目的能力,能在"较少的提示词与素材参考条件下,通过极短的交互轮次直接实现项目效果" [1]。
我的判断:这是从"补全代码"到"交付项目"的能力跃迁。意义不在于"能生成一个 3D 场景",而在于模型开始具备长程自我验证能力——先建、再看、再修,这个循环跑得通,才可能一次交付一个完整项目。
四、核心能力效果:评测全景
4.1 官方横向对比(1017 版本)

图 2:DeepSeek-V4.1-Flash-1017 官方评测对比表。来源:官方发布材料 [1] [2]
文字版,方便查阅与二次计算:
| Benchmark | V4.1-Flash-1017 | V4.1-Flash | Kimi K3 | GLM-5.3 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|---|---|
| HLE(无工具) | 42.6 / 44.0† | 36.8 / 39.1† | 43.5 | 42.0† | 44.5 | 56.3 |
| Terminal-Bench 4.0 | 42.3 | 31.2 | 12.6 | 37.9 | 39.9 | 51.8 |
| DeepSWE v1.1 | 77.0 | 74.2 | 67.5 | 66.9 | 73.0 | 74.0 |
| ProgramBench | 29.1 | 20.3 | 17.5 | 19.0 | 23.0 | 37.0 |
| NL2Repo-Bench | 68.2 | 65.4 | 58.0 | 58.0 | 56.8 | 75.3 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | 46.7 | 48.8 | 45.8 | 50.3 |
| Agents' Last Exam | 35.4 | 31.8 | 27.6 | 28.5 | 26.7 | 28.6 |
| Apex Bench v1.1 | 72.1 | 64.6 | 47.8 | 56.6 | 54.3 | 65.8 |
| Chartography(带工具) | 83.0 | 78.9 | 68.1 | — | 79.9 | 84.0 |
| BabyVision(带工具) | 92.5 | 89.6 | 85.7 | — | 88.9 | 94.1 |
| ZeroBench-main(带工具) | 51.0 | 49.0 | 41.0 | — | 53.0 | 52.0 |
† 表示仅测试 HLE 的文本子集。Terminal-Bench 4.0 用 [CC] 框架,DeepSWE 用 Mini-SWE-V2 框架,ZeroBench-main 用 Pass@5 评测。数据来源:[2]
重点解读:
- Agent / 终端类任务全面反超闭源旗舰:Terminal-Bench 4.0 的 42.3 超过 GPT-5.6 Sol(39.9),DeepSWE v1.1 的 77.0 超过 Opus 5(74.0)与 GPT-5.6 Sol(73.0)。
- 纯知识型推理仍是短板:HLE 42.6 落后 Opus 5 的 56.3 整整 13.7 分;ProgramBench 29.1 vs Opus 5 的 37.0,差 7.9 分。
- 视觉 Agent 追得很紧:Chartography 83.0、BabyVision 92.5,与 Opus 5 只差 1 分左右,但 ZeroBench 被 GPT-5.6 Sol 反超。
4.2 相比上一版的进步幅度(1017 的价值所在)
| Benchmark | V4.1-Flash | 1017 | 提升 |
|---|---|---|---|
| HLE(无工具) | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| Automation-Bench | 54.8 | 60.5 | +5.7 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Agents' Last Exam | 31.8 | 35.4 | +3.6 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
注意:同一个架构、间隔一个月,Terminal-Bench 4.0 涨了 11.1 分。这在传统认知里属于"换模型"级别的提升。这反过来验证了第三章的判断:后训练与数据管线的杠杆,比很多人以为的大得多。
4.3 技术报告里的完整评测(V4.1-Flash 基线)
重要提示:下表来自 51 页技术报告,评测对象是 V4.1-Flash(9 月版),不是 1017。列出它是为了补全 1017 发布页未覆盖的维度(安全、竞赛编程等)。1017 在这些维度上按 4.2 节的规律,只会更好不会更差 [9]。
| Benchmark | Opus-5 | GPT-5.6 Sol | K3 | GLM-5.3 | V4-Pro | V4-Flash | V4.1-Flash |
|---|---|---|---|---|---|---|---|
| GPQA Diamond | 93.4 | 94.1 | 92.9 | 88.1 | 92.4 | 89.9 | 90.9 |
| Codeforces(Rating) | — | — | — | — | 3348 | 3289 | 3471 |
| MathArena Apex | — | — | 65.6 | — | 65.3 | 58.6 | 65.6 |
| Terminal-Bench 2.1 | 89.1 | 88.8 | 88.3 | 88.2 | 87.9 | 82.7 | 90.6 |
| Terminal-Bench 3.0 | 43.3 | 34.4 | 17.7 | 28.3 | 11.8 | 7.6 | 30.0 |
| CyberGym | — | 84.5 | 80.0 | 84.5 | 83.3 | 76.7 | 88.1 |
| SEC-Bench Pro | — | 74.3 | — | — | 56.4 | 30.9 | 62.8 |
| ExploitGym | 22.1 | 33.7 | — | 15.0 | 5.4 | 1.8 | 15.3 |
| HLE(带工具) | 63.6 | — | 59.8 | 62.5 | 60.0 | 51.5 | 63.9 |
技术报告 Figure 1(a) 把 Agent 类指标画成了对比图,可以直观看清"哪几项超了、哪几项还差":
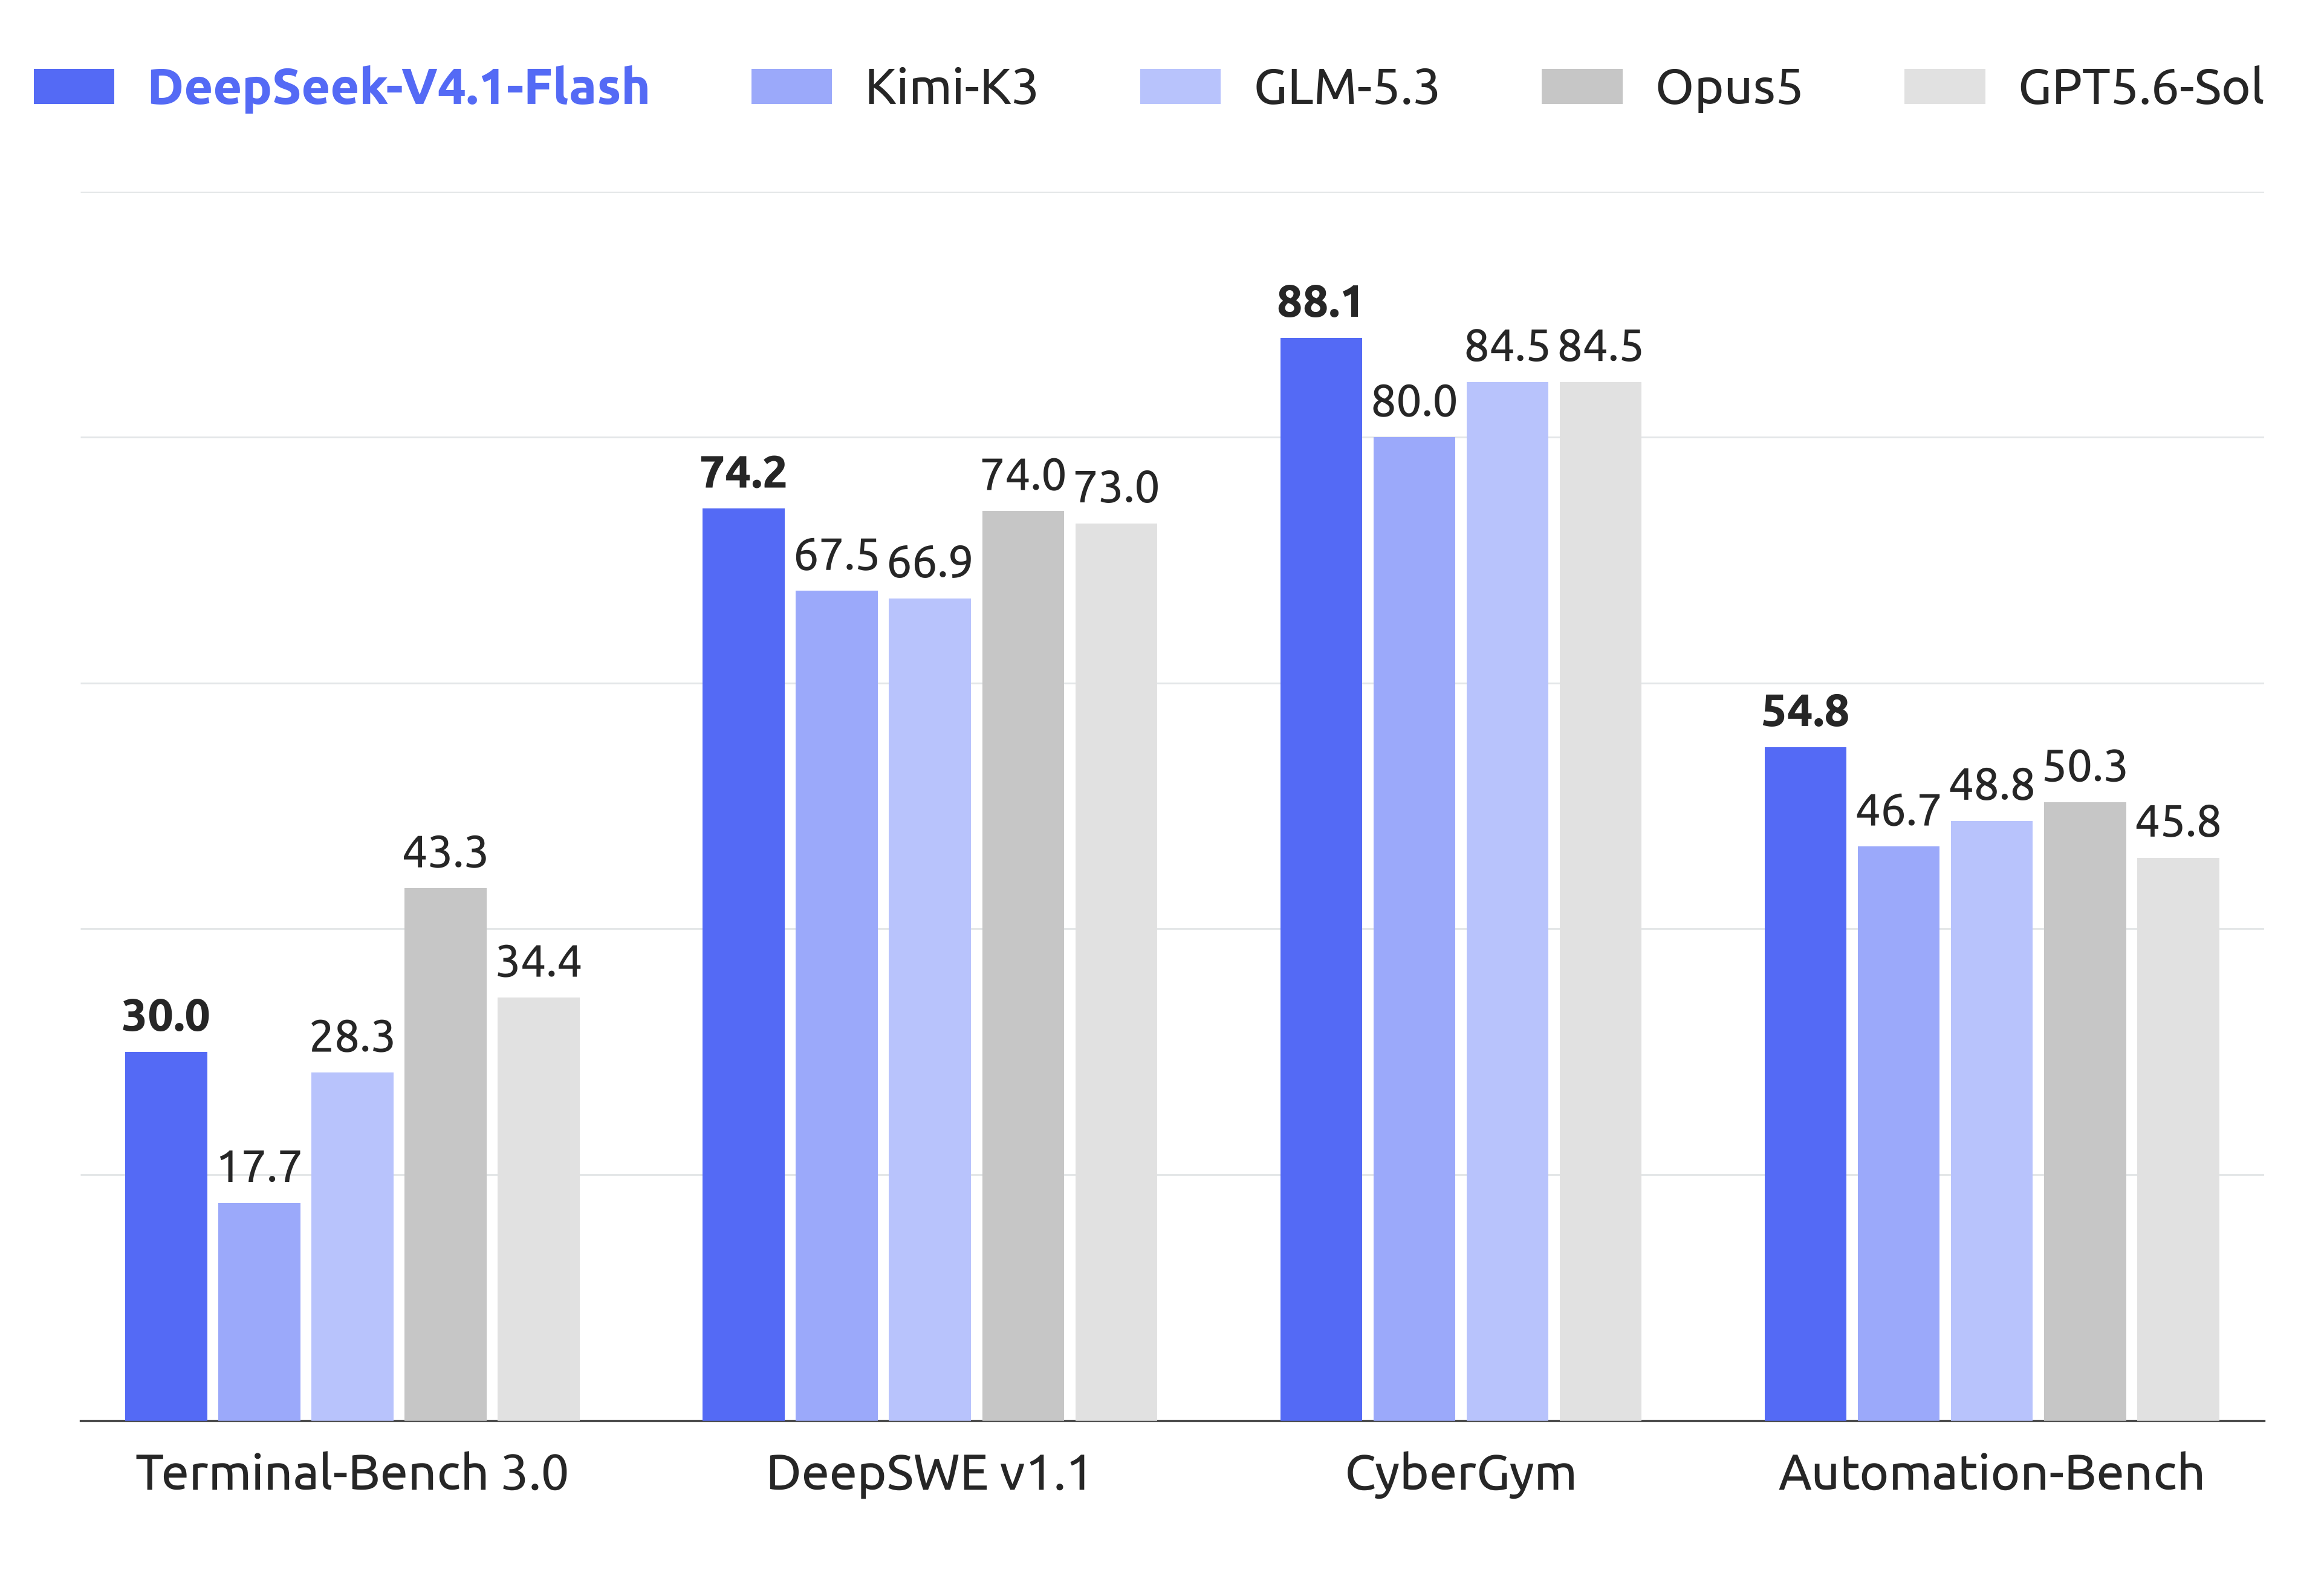
图 3:DeepSeek-V4.1-Flash 与同类模型在 Agentic 基准上的表现对比。来源:官方技术报告 Figure 1(a) [9]
两个值得单独拎出来的点:
- Codeforces 3471:超过 V4-Pro(3348)和 V4-Flash(3289),是 DeepSeek 家族最强竞赛编程成绩。一个 552B 的 Flash 模型打赢 1.6T 的 Pro 模型,在 MoE 效率上是很有说服力的证据。
- CyberGym 88.1 / SEC-Bench Pro 62.8:开源模型里的 SOTA 级安全能力。官方特别提示这是双用途能力,请用于防御性安全研究、漏洞修复等负责任场景。
4.4 换 Harness 会不会掉点?(落地最关键的一张表)
同一份权重,只换外层 Agent 框架,结果差异巨大:
| Harness | DeepSWE v1.1 | Terminal-Bench 2.1 |
|---|---|---|
| [CC]([CC]) | 69.8 | 88.0 |
| Codex | 65.6 | 84.1 |
| OpenCode | 65.5 | 85.0 |
| Pi | 66.2 | 86.1 |
| mini-SWE | 74.2 | 90.3 |
| DeepSeek Harness Minimal | 72.6 | 90.6 |
| DeepSeek Harness Standard | 70.5 | 85.8 |
| DeepSeek Harness PTC | 67.6 | 85.8 |
数据来源:技术报告 Table 4。所有 scaffold 均用 N=8(DeepSWE)/ N=3(TB2.1)采样,Linux 容器,temperature=1.0,top_p=0.95,1M 上下文,max_steps=500,TB2.1 无网络。 [9]
重点:跨 6 个框架家族、8 种配置,DeepSWE 波动区间 65.5~74.2(9 分),Terminal-Bench 84.1~90.6(6.5 分)。没有出现"换框架就崩"的情况,但框架选择确实值 8 分以上。
实战含义:如果用 [CC] 或 Codex,别直接拿官方 1017 的 77.0 做预期,按 69.8 / 65.6 打折更真实;想拿峰值,得配 mini-SWE 或 DeepSeek Harness Minimal。
4.5 第三方机构的口径(与官方的温差)
这是本章最需要留意的部分。官方说"多项第一",第三方说"中上游"。
| 机构 | 指标 | DeepSeek-V4.1-Flash 表现 | 来源 |
|---|---|---|---|
| Artificial Analysis | Intelligence Index v4.3.2 | 39 分(同类中位数 19,明显高于平均,但远非榜首) | [11] |
| Artificial Analysis | 单任务成本 | $0.27 / 任务(跑完整套 Intelligence Index) | [11] |
| Artificial Analysis | 输出速度 | 176 tokens/s(评价 "notably fast") | [11] |
| Artificial Analysis | 冗长度 | 250M tokens / 整套评测(中位数 130M,评价 "very verbose") | [11] |
| LMArena(文本竞技场) | Elo | 1475 ± 6,排名 第 38(12,793 票) | [12] |
| OpenRouter | 实际报价 | $0.15 输入 / $0.60 输出,cache read $0.003 | [13] |
| OpenRouter | 延迟 / 吞吐 | 1.21s TTFT / 152 tps | [13] |
| OpenRouter | 可用性 | 过去 3 天 100% | [13] |
| Hugging Face | 社区热度 | 251 likes,trending score 250(发布当天) | [2] |
重点(必读):三套口径的温差说明什么?
官方口径:Agent / SWE 类任务 → 反超 Opus 5、GPT-5.6 Sol(第一梯队)
AA 口径:综合智能指数 39 分 → 同类模型中的"优秀但不顶尖"
LMArena:人类偏好 Elo 1475 → 全球第 38 名
         落后于 Gemini 4 Argon(1524)、Claude 系列(1500+)、Kimi K3(1487)
合理解释有三条:
- 评测维度不同。LMArena 测的是"人类对话偏好"(写作、闲聊、通用问答),AA 的 Index 混合了知识、长上下文、专业文档推理。而 1017 的优化重心全在 Agent / 终端 / 代码 上。它是一把专用的螺丝刀,不是万能瑞士军刀。
- HLE 这类硬知识题确实是短板(42.6 vs Opus 5 的 56.3),AA 指数里这类权重不低。
- 冗长度惩罚。AA 明确说它 250M tokens 的消耗是 "very verbose",这在按 token 计费的综合评分里会拉低成本效率评分。
结论:Coding Agent / 终端自动化 / 长程任务场景,官方数据可信度高;通用对话、写作、知识问答场景,请以 LMArena 第 38 名为参考。
五、价格情况
5.1 官方定价(人民币 / 百万 tokens)
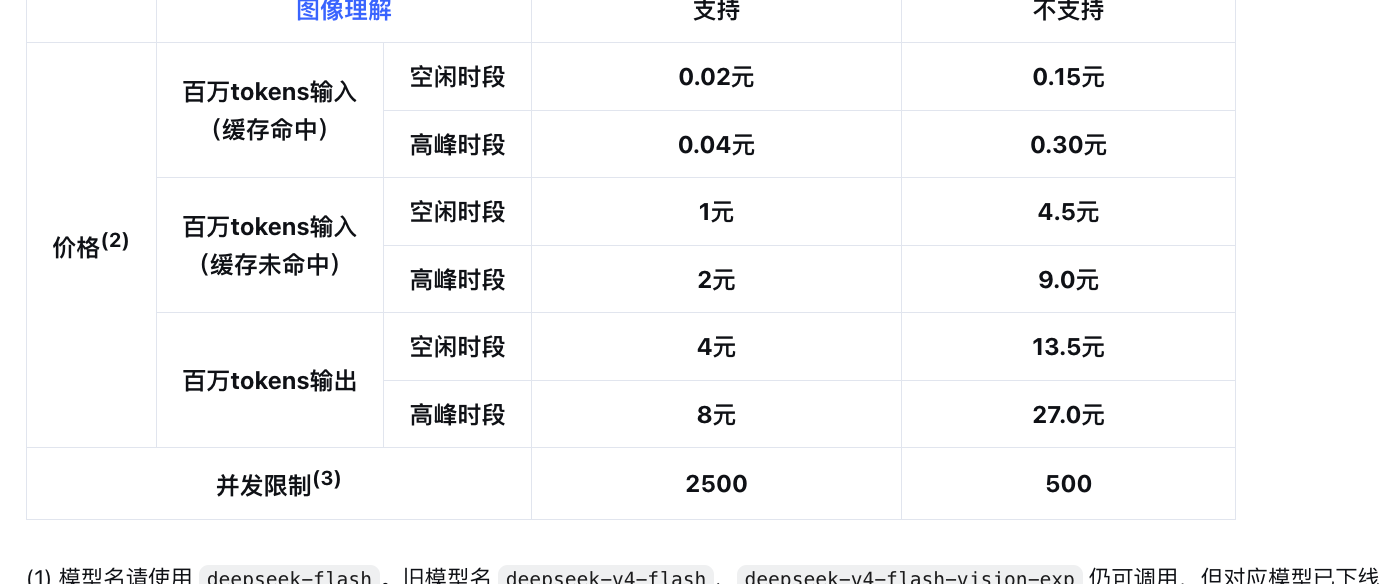
图 4:DeepSeek 官方定价表。左列为 deepseek-flash(支持图像理解,即 V4.1-Flash-1017),右列为 deepseek-v4-pro(不支持图像理解)。来源:官方 API 文档 [14]
| 项目 | 时段 | deepseek-flash(1017,支持图像) |
deepseek-v4-pro(不支持图像) |
|---|---|---|---|
| 输入(缓存命中) | 空闲 | 0.02 元 | 0.15 元 |
| 输入(缓存命中) | 高峰 | 0.04 元 | 0.30 元 |
| 输入(缓存未命中) | 空闲 | 1 元 | 4.5 元 |
| 输入(缓存未命中) | 高峰 | 2 元 | 9.0 元 |
| 输出 | 空闲 | 4 元 | 13.5 元 |
| 输出 | 高峰 | 8 元 | 27.0 元 |
| 并发限制 | — | 2500 | 500 |
重点:高峰 / 空闲的定义(直接影响账单)
高峰:北京时间 周一至周五 9:00-12:00、14:00-18:00(不含中国法定节假日)
空闲:其余所有时段,含周末全天、法定节假日全天
空闲价 = 高峰价的 50%
也就是说:把批处理任务挪到晚上跑,成本直接砍半。
5.2 官方定价(美元 / 百万 tokens)
| 项目 | 时段 | deepseek-flash |
deepseek-v4-pro |
|---|---|---|---|
| 输入(缓存命中) | 空闲 | $0.003 | $0.022 |
| 输入(缓存命中) | 高峰 | $0.006 | $0.044 |
| 输入(缓存未命中) | 空闲 | $0.15 | $0.66 |
| 输入(缓存未命中) | 高峰 | $0.30 | $1.32 |
| 输出 | 空闲 | $0.60 | $1.98 |
| 输出 | 高峰 | $1.20 | $3.96 |
来源:官方英文文档 [3]
5.3 新增的 Search / Fetch 计费
这次 1017 发布同时开放了自研搜索 API:
| API | 端点 | 计费单位 | 价格 |
|---|---|---|---|
| Search | POST /v1/tools/search |
每 1,000 次成功请求 | 5 元($0.75) |
| Fetch | POST /v1/tools/fetch |
每 1,000 次成功请求 | 5 元($0.75) |
来源:官方 Search & Fetch 文档 [15]
注意(重要时间点):在 DeepSeek Harness / [CC] / Codex 里使用 DeepSeek API 时,Server 端工具调用已经会走 Search / Fetch,目前免费;但从 北京时间 2026 年 11 月 1 日 00:00 起开始按次计费 [3]。
一个重度 Agent 任务若触发 30 次搜索,就是 0.15 元——单看不多,但搜索密集型 Agent(如调研类)这块成本可能超过模型本身。
六、性价比分析
6.1 帕累托前沿:SWE 场景的性价比位置
这是最能说明问题的一张图——横轴是"每任务平均费用(人民币,对数刻度)",纵轴是通过率:

图 5:DeepSWE v1.1 通过率 vs 每任务平均费用(人民币,对数刻度)。评测框架 mini_swe_v2,数据日期 2026-09-22。来源:官方发布材料 [1]
读图要点:
- V4.1-Flash-1017 的 max 档:77.0% 通过率,成本约 1.5~2 元/任务,位于整张图的左上角"性价比拐点";
- the model 5 的 max 档:约 70% 通过率,成本约 90~100 元/任务;
- 也就是说,在 SWE 这个维度上,它用 1/50 的钱做到了更高的通过率;
- 但注意右侧的 GPT-6 Astra / the model 5 在 >100 元/任务 区间仍有 73% 以上的表现——说明在"极限难度"上,贵模型依然有存在意义。
弊端说明:这张图是官方用 mini_swe_v2 框架跑出来的,而 DeepSeek 恰好在该框架上是最高分(74.2 / 77.0)。换成 [CC] 框架,绝对值要按 4.4 节的表打折,但量级差距(1/50 成本)不会变。
6.2 实际账单算一遍
场景 A:单次仓库级 Code Review(缓存未命中,输入 1M,输出 50K)
| 模型 | 空闲时段 | 高峰时段 |
|---|---|---|
| V4.1-Flash-1017 | 1 + 0.2 = 1.2 元 | 2 + 0.4 = 2.4 元 |
| V4-Pro-0813 | 4.5 + 0.675 = 5.18 元 | 9 + 1.35 = 10.35 元 |
场景 B:多轮 Agent 会话(第 2 轮起输入全部缓存命中,1M 输入 + 50K 输出)
| 模型 | 空闲时段 | 高峰时段 |
|---|---|---|
| V4.1-Flash-1017 | 0.02 + 0.2 = 0.22 元 | 0.04 + 0.4 = 0.44 元 |
| V4-Pro-0813 | 0.15 + 0.675 = 0.83 元 | 0.30 + 1.35 = 1.65 元 |
重点:缓存命中价 0.02 元/百万 token 是什么概念?1M token 的输入只要 2 分钱。这是 Agent 多轮对话成本能压下来的根本原因——前提是 prompt 前缀保持稳定(system prompt + 仓库内容放在前面,动态内容放后面)。
弊端说明:缓存命中要求前缀完全一致。如果每轮都在 system prompt 里塞当前时间戳,缓存会全部失效,账单直接涨 50 倍。
6.3 成本优势的三个来源
把性价比拆开看,它便宜不是靠"参数小",而是三个独立机制叠加:
| 来源 | 机制 | 贡献 |
|---|---|---|
| 算力 | CED 让 Prefill 只跑 20 层、只激活 8B | Prefill 计算减半 |
| 显存 | CSA2 跨层复用 + FP4 主 KV | 全局 KV 降到 890 bytes/token(1/4) |
| 存储与带宽 | SWA Bounded Replay 让 SWA KV 不必持久化 | 持久化 KV 降到 1/8 |
| 多轮对话 | 缓存命中价 0.02 元 / 1M token | 第二轮起成本趋近于零 |
| 推理控制 | reasoning_effort 前重后轻的收益曲线 |
60~80 档拿到大部分精度、不到一半 token |
重点:这五个机制是乘性叠加的,不是加性。这也是为什么它能做到 1/50 的量级差,而单纯的"小模型降价"做不到。
6.4 与竞品的性价比对照
| 维度 | V4.1-Flash-1017 | Opus 5 / GPT-5.6 Sol | Kimi K3 / GLM-5.3 |
|---|---|---|---|
| SWE 能力(DeepSWE v1.1) | 77.0 | 74.0 / 73.0 | 67.5 / 66.9 |
| 终端能力(TB 2.1) | 90.6 | 89.1 / 88.8 | 88.3 / 88.2 |
| 硬知识(HLE) | 42.6 | 56.3 / 44.5 | 43.5 / 42.0 |
| SWE 单任务成本 | 约 2 元 | 90~100 元 | 数十元量级 |
| 输入价 / 1M | $0.15 | 高一个数量级 | 居中 |
| 上下文 | 1M | 1M / 1M | 更短 |
| 许可 | MIT | 闭源 | 宽松 |
| 可私有化 | 可以 | 不可以 | 可以 |
重点:这张表说明它是一个结构性优势而非全面优势——在 Agent 类指标上领先、在硬知识上落后、在价格上降维。选型时应该按"任务类型"而不是"综合分数"来决策。
七、短板与风险
7.1 六个必须注意的点
| # | 问题 | 具体表现 | 应对 |
|---|---|---|---|
| 1 | Harness 打折 | 官方 77.0 是 mini_swe_v2 跑出来的,[CC] 只有 69.8 | 按实际框架实测,别直接引用官方峰值 |
| 2 | Harness 版本 | 低于 0.2.1-rc.1 拿不到完整收益 | 升级 DeepSeek Harness,或确认所用框架已适配 |
| 3 | 输出冗长 | AA 测出 250M tokens/套评测(中位数 130M) | 用 reasoning_effort=high 而非 max;prompt 里约束输出长度 |
| 4 | 缓存易失效 | 前缀一动,成本涨 50 倍 | system prompt 与仓库内容固定在前,动态内容放最后 |
| 5 | Search/Fetch 开始收费 | 2026-11-01 00:00 起按次计费 | 搜索密集型 Agent 提前做成本测算 |
| 6 | 边界鲁棒性未知 | 官方承认 CSA2 选择误差、SWA 重建近似 | 接近 1M 上下文的场景必须自建压测集 |
7.2 官方自己划的能力边界
技术报告结论章节有一段很坦诚的话,值得原文引用 [9]:
虽然 benchmark 分数差距很小,但这种接近并不意味着模型在复杂、高难度推理和边界场景上达到了领先闭源系统的前沿能力。
这句话很重要。它提醒我们:benchmark 接近 ≠ 能力接近。在 Agent 类标准化任务上它确实追平甚至反超了,但在"没人测过的怪问题"上,差距依然存在。
7.3 一句话定位
它是给"跑得多"的场景准备的,不是给"问得刁"的场景准备的。
- Agent / SWE / 终端 / 视觉 Agent → 第一梯队,且便宜 1~2 个数量级
- 通用对话 / 写作 / 知识问答 → 中上游(AA 39 分、LMArena 第 38)
- 硬核推理 / 科研 / 法务 → 仍是闭源旗舰的地盘
八、总结
8.1 四点结论
- 1017 是"架构不变、后训练发力"的更新。
config.json逐项一致,涨分全靠自反馈 RL + 大规模 Agent 任务合成。 - 架构创新的核心是 KV Cache 压缩。CED 让 Prefill 计算减半,CSA2 + FP4 让全局 KV 降到 890 bytes/token(V4-Flash 的 1/4、V1 的 1/437),SWA Bounded Replay 让持久化 KV 降到 1/8。
- 能力是结构性的,不是全面的。Agent 类指标第一梯队甚至第一,硬知识推理仍是明显短板。
- 性价比是乘性叠加的结果。算力、显存、存储、缓存、推理控制五个机制同时作用,才有 1/50 的量级差。
8.2 数字速记
参数:      552B backbone / Prefill 8B / Decode 16B
上下文:    1M 输入 / 384K 输出
KV:        890 bytes/token(V4-Flash 的 1/4,V1 的 1/437)
Prefill:   计算量减半
价格:      输入 1 元 / 输出 4 元 / 缓存命中 0.02 元(每百万 token,空闲时段)
SWE:       DeepSWE 77.0、Terminal-Bench 4.0 42.3、TB 2.1 90.6
成本:      约 2 元 / SWE 任务
第三方:    AA 智能指数 39、LMArena 第 38
许可:      MIT
参考资料
[1]. DeepSeek 官方公众号 - DeepSeek V4.1 Flash 新版本:许愿式编程一键成真
[2]. Hugging Face - deepseek-ai/DeepSeek-V4.1-Flash-1017(模型卡)
[3]. DeepSeek API Docs - Models & Pricing(英文版)
[4]. Hugging Face - DeepSeek-V4.1-Flash config.json(架构参数)
[5]. Hugging Face - DeepSeek-V4.1-Flash-1017 config.json(与 V4.1-Flash 逐项一致)
[6]. Hugging Face - deepseek-ai/DeepSeek-V4.1-Flash(模型卡,含技术报告入口)
[7]. DeepSeek API Docs - Vision(图像理解)
[8]. DeepSeek API Docs - Thinking Mode(思考模式与力度控制)
[9]. DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression(51 页技术报告 PDF)
[10]. GitHub - deepseek-ai/deepseek-harness Releases(v0.2.1-rc.1 适配 1017)
[11]. Artificial Analysis - DeepSeek V4.1 Flash 评测
[12]. LMArena - Text Arena Leaderboard
[13]. OpenRouter - DeepSeek V4.1 Flash 1017 价格与可用性
[14]. DeepSeek API Docs - 模型 & 价格(中文版)
[15]. DeepSeek API Docs - Search & Fetch(网页搜索与抓取)
[16]. DeepSeek API Docs - Your First API Call
[17]. Terminal-Bench 4.0 官方排行榜
[18]. ModelScope - deepseek-ai/DeepSeek-V4.1-Flash-1017
[19]. GitHub - deepseek-ai/deepseek-recipe(Prompt 编码工具链)
整理者:长路 创建时间:2026.10.17 更新时间:2026.10.17
评论区请在客户端页面查看