源码
gitee:https://gitee.com/changluJava/demo-exer/tree/master/java-dagscheduler/java-dag
github:https://github.com/changluya/Java-Demos/tree/master/java-dagscheduler/java-dag
理论
**图的表示:**邻接表(数组链表)或者邻接矩阵(二维数组)来表示图。每个节点包含一个值和一个指向其邻居节点的列表。
**拓扑排序:**拓扑排序是对DAG进行线性排序,使得对于图中的每一条有向边 (u, v),u 在排序中总是位于 v 的前面。
实现思路(数组链表)
初步实现1:实现最基本的dag有向无环图
思路设计
案例dag如下图:
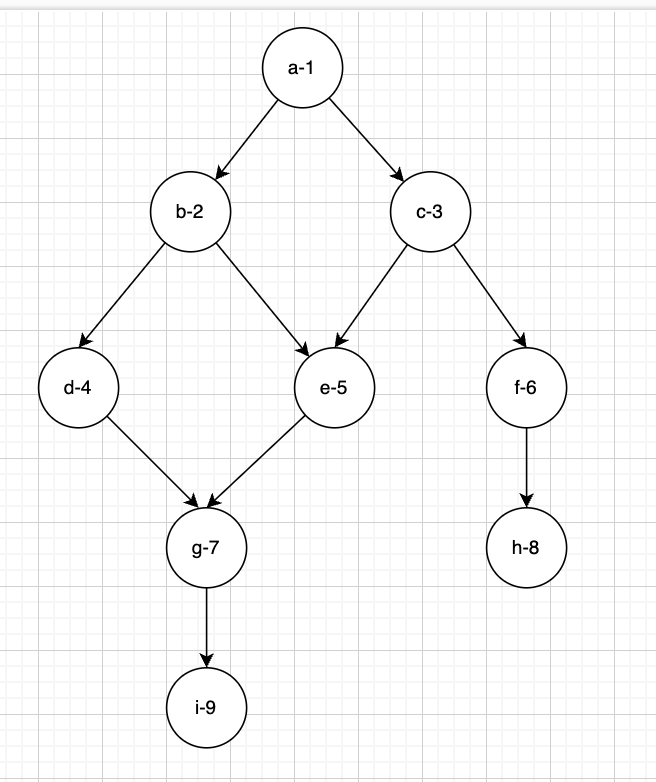
核心dag的数据结构实现使用邻接表 数组链表来实现:
1)初始化:指定dag图的大小(任务数),根据任务数来进行初始化多个链表。
2)添加节点边:add(v, w) v指的是某个任务,w则是添加任务w作为v的下游任务(这种关系就是边的逻辑)
3)指定起始任务位置,TopologicalSort初始化参数传入startNode。
局限性:
1、目前添加任务形式,任务标识使用的是数字来作为坐标标识。
实现代码
Graph.java:图邻接表数据结构设计,数组+链表实现
package com.changlu.demo1;

import java.util.LinkedList;

/**
 * 该类表示一个有向图,使用邻接表进行存储。
 */
public class Graph {

    private int V; // 顶点数(节点数量)
    private LinkedList<Integer> adj[]; // 邻接表

    /**
     * 构造函数,初始化图。
     *
     * @param v 图的顶点数
     */
    public Graph(int v) {
        this.V = v;
        this.adj = new LinkedList[v]; // 初始化邻接表
        for (int i = 0; i < v; i++) {
            this.adj[i] = new LinkedList<>(); // 为每个顶点创建一个空的邻接表
        }
    }

    /**
     * 添加一条从顶点 v 到顶点 w 的边。
     *
     * @param v 边的起始顶点
     * @param w 边的目标顶点
     */
    public void addEdge(int v, int w) {
        this.adj[v].add(w); // 将顶点 w 添加到顶点 v 的邻接表中
    }

    /**
     * 获取图的顶点数。
     *
     * @return 图的顶点数
     */
    public int getV() {
        return V;
    }

    /**
     * 获取图的邻接表。
     *
     * @return 图的邻接表
     */
    public LinkedList<Integer>[] getAdj() {
        return adj;
    }
}
TopologicalSort:实现拓扑排序工具类
package com.changlu.demo1;

import java.util.Stack;

/**
 * 该类负责对有向图进行拓扑排序。
 */
public class TopologicalSort {

    private Graph graph;
    private int startNode;

    /**
     * 构造函数,初始化拓扑排序。
     *
     * @param graph 要进行拓扑排序的图
     * @param startNode 拓扑排序的起始节点
     */
    public TopologicalSort(Graph graph, int startNode) {
        this.graph = graph;
        this.startNode = startNode;
    }

    /**
     * 拓扑排序的递归辅助函数。
     *
     * @param v 当前顶点
     * @param visited 记录顶点是否被访问过的数组
     * @param stack 用于存储拓扑排序结果的栈(递归到最后一个任务,依次入栈)
     */
    private void topologicalSortUtil(int v, boolean visited[], Stack<Integer> stack) {
        // 标记当前节点为已访问
        visited[v] = true;

        // 递归访问所有邻接节点
        for (Integer i : graph.getAdj()[v]) {
            if (!visited[i])
                topologicalSortUtil(i, visited, stack);
        }

        // 将当前节点压入栈中
        stack.push(v);
    }

    /**
     * 执行拓扑排序,并打印排序结果。
     */
    public void topologicalSort() {
        Stack<Integer> stack = new Stack<>(); // 用于存储拓扑排序结果的栈
        boolean visited[] = new boolean[graph.getV()]; // 记录顶点是否被访问过的数组
        for (int i = 0; i < graph.getV(); i++)
            visited[i] = false; // 初始化所有顶点为未访问

        // 对每个未访问的节点调用递归辅助函数
        // 优先从指定的起始节点开始访问
        if (!visited[startNode])
            topologicalSortUtil(startNode, visited, stack);

        // 打印栈中的内容,即拓扑排序结果
        while (!stack.isEmpty())
            System.out.print(stack.pop() + " ");
    }
}
Main:测试方法
package com.changlu.demo1;

/**
 * 主函数,用于测试拓扑排序。
 */
public class Main {

    public static void main(String args[]) {
        // 创建一个图
        Graph g = new Graph(10);
        // 1 -> 2,3
        g.addEdge(1, 2);
        g.addEdge(1, 3);
        // 2 -> 4,5
        g.addEdge(2, 4);
        g.addEdge(2, 5);
        // 3 -> 5,6
        g.addEdge(3, 5);
        g.addEdge(3, 6);
        // 4 -> 7
        g.addEdge(4, 7);
        // 5 -> 7
        g.addEdge(5, 7);
        // 6 -> 8
        g.addEdge(6,8);
        // 7 -> 9
        g.addEdge(7, 9);

        // 创建拓扑排序对象,并指定起始节点为1
        TopologicalSort ts = new TopologicalSort(g, 1);

        System.out.println("拓扑排序结果:");
        ts.topologicalSort(); // 执行拓扑排序并打印结果
    }
}
测试效果
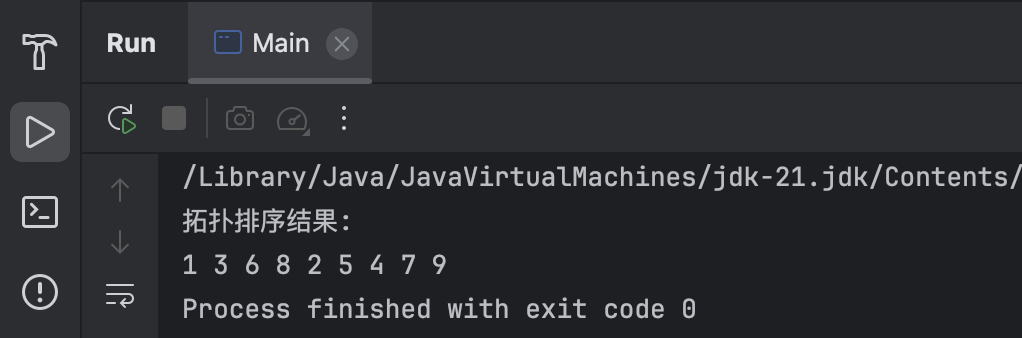
按照思路设计中的来说,没有问题,是按照dag的顺序去执行每一个任务的。
初步实现2:如何实现成环检测?
思路设计
思考1:当前场景是否需要成环检测?
实际当前简单方案中不会出现成环死循环问题?
在当前数组+链表 邻接表实现中,任务正常去跑,会按照顺序将任务入栈,其中会有一个visited数组来判断是否有访问过某个节点,如果有的话就不会递归往下。
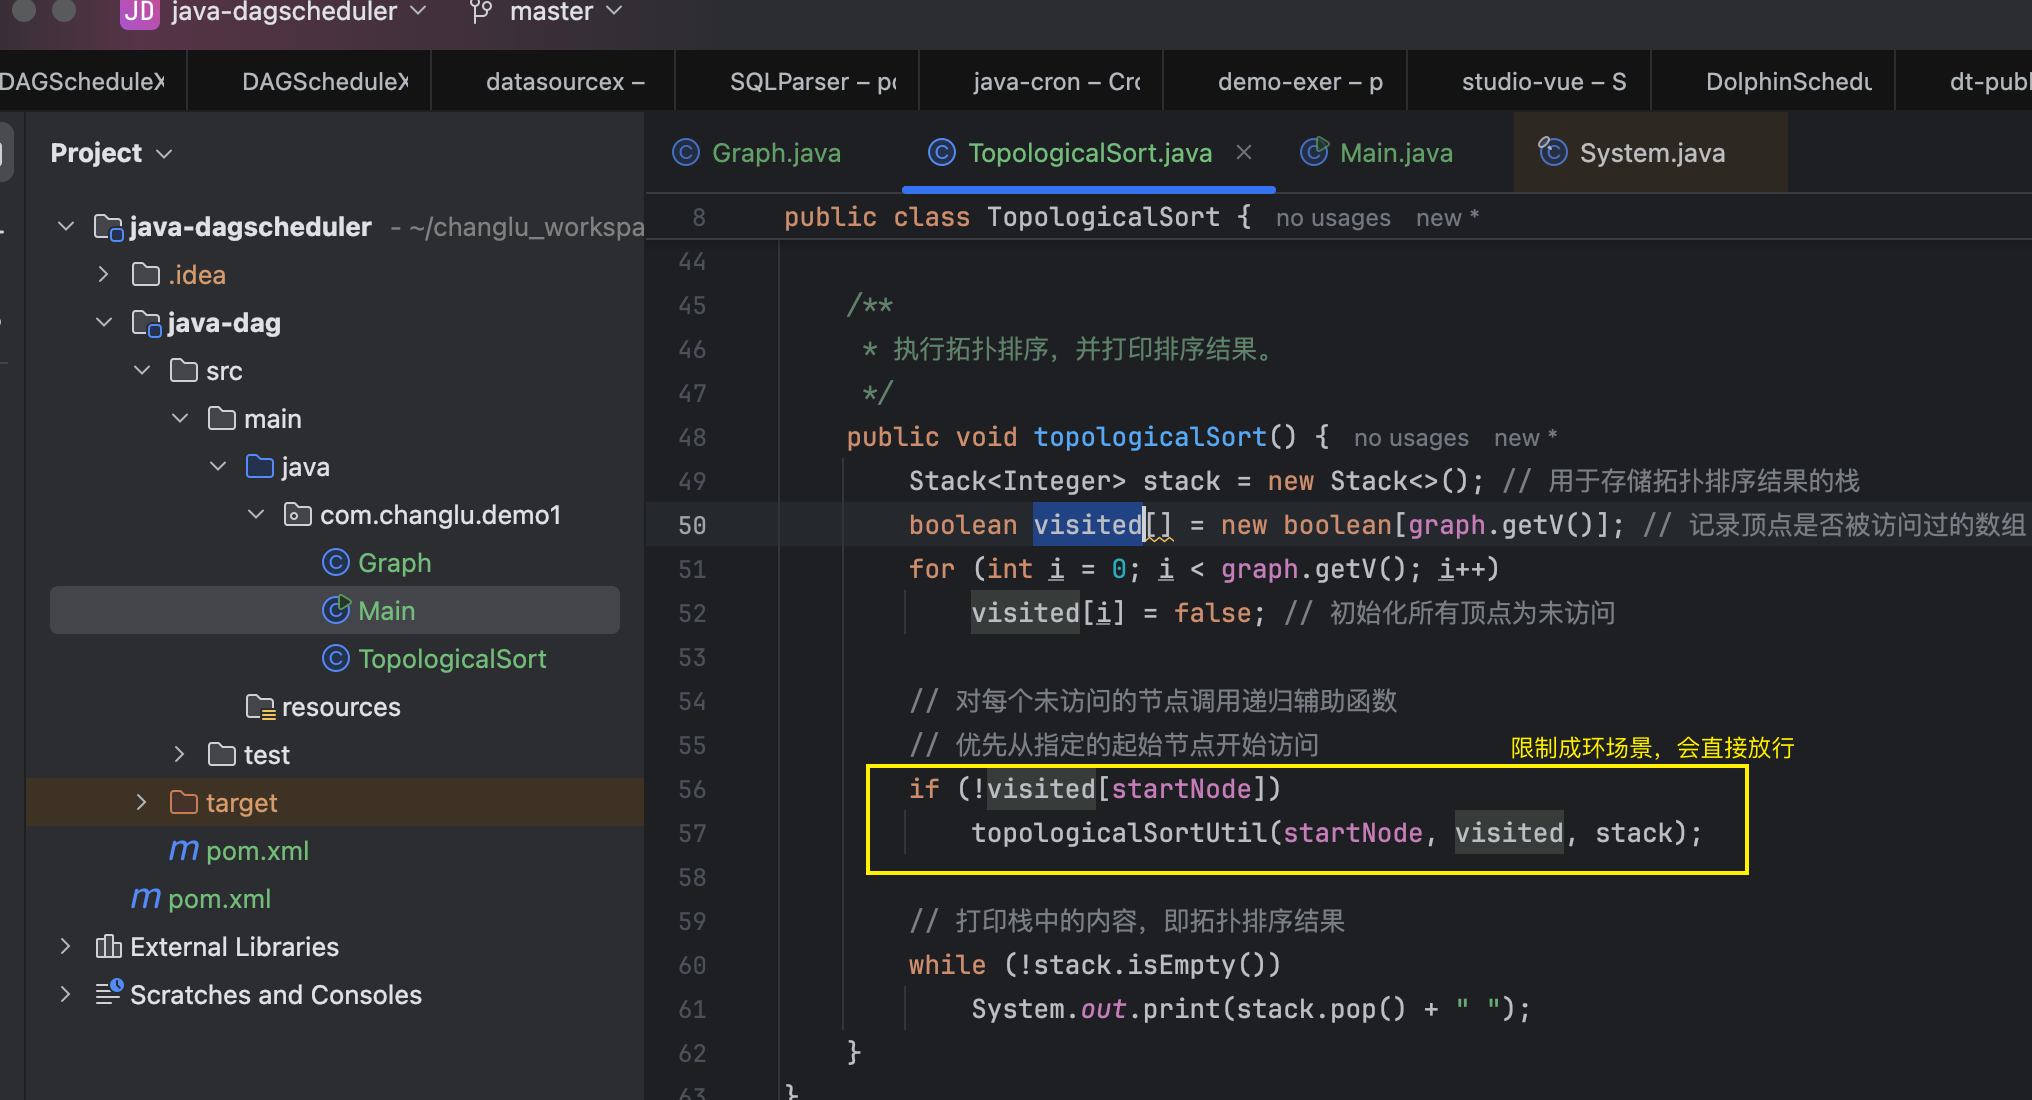
补充一个边:
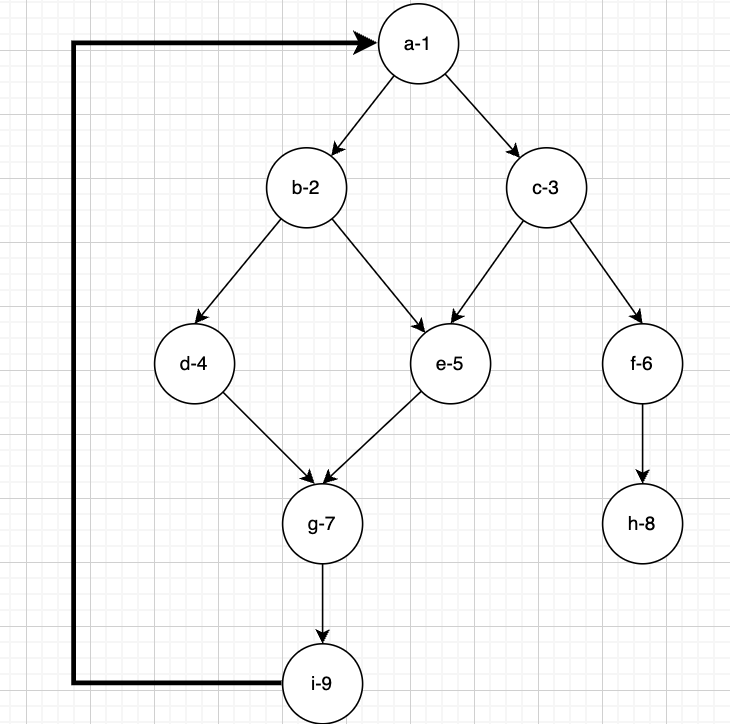
代码案例Main中补充一下:
// 成环场景
g.addEdge(9, 1);
跑出来的依旧没有问题(代码中拓扑排序自动过滤):
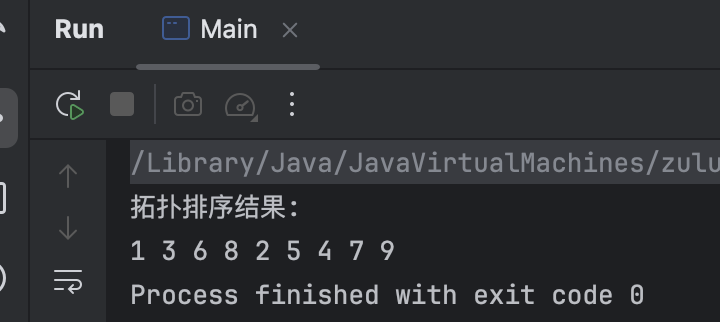
**何时生效?**有全局dag图情况下会生效,在有全局dag场景情况下可以直接过滤掉。
正常场景我们应当校验出成环情况,并且阻止任务去执行下去!提示给用户看下这个问题。
思考2:如果要实现成环检测,如何处理?
在实际的应用中,addEdge 方法通常用于动态构建图的结构,而检测环的问题需要对整个图的结构进行分析,特别是检测是否存在有向环(即图的拓扑排序是否可行)。
思路设想:
方案1:调用 addEdge 的时候实时检测整个图中是否存在环。
方案2:所有的边添加完成之后来进行环检测。
现有检测环的方法:
- **Kahn 算法:**基于入度(in-degree)的拓扑排序方法,通过逐步移除入度为 0 的节点,最终剩下的节点如果有任何节点则说明存在环。
- **DFS 的环检测:**在深度优先遍历过程中,使用递归调用栈来检测是否存在后向边(即形成环的边)。
方案1情况:在添加边addEdge时进行检测(pass)
可能会出现的问题:
- **实时性问题:**每次添加一条边后,立即检测整个图是否存在环,在动态变化的图中可能需要频繁地进行复杂的遍历操作,这会导致较高的时间复杂度。例如,传统的拓扑排序算法(如 Kahn 算法或基于深度优先搜索(DFS)的算法)的时间复杂度通常为 O(V + E),其中 V 是顶点数,E 是边数。如果每添加一条边都进行一次完整的环检测,会显著增加总的时间开销。
- **动态性问题:**图的结构可能会频繁变化,实时维护一个无环的状态需要更高效的数据结构支持,但这并不容易。
在实际应用中,通常在图结构构建完成后,再进行一次完整的环检测,而不是在每添加一条边时都进行检测。这不仅更高效,而且可以更好地控制性能和资源消耗。
方案2情况:在添加完边之后,进行统一检测是否出现成环问题
比较推荐,只需要添加完边之后,进行统一对dag图check是否有成环问题。
最终确认方式:通常不推荐在添加每一条边时都进行环检测。建议在图构建完成后,使用拓扑排序或其他环检测算法对整个图进行一次检测,以判断其是否为 DAG。
思考3:添加完边之后,全局进行成环check逻辑
思路:与拓扑排序类似,仿拓扑排序过程中,是否有检测到经过同一个任务,即可出现成环问题。
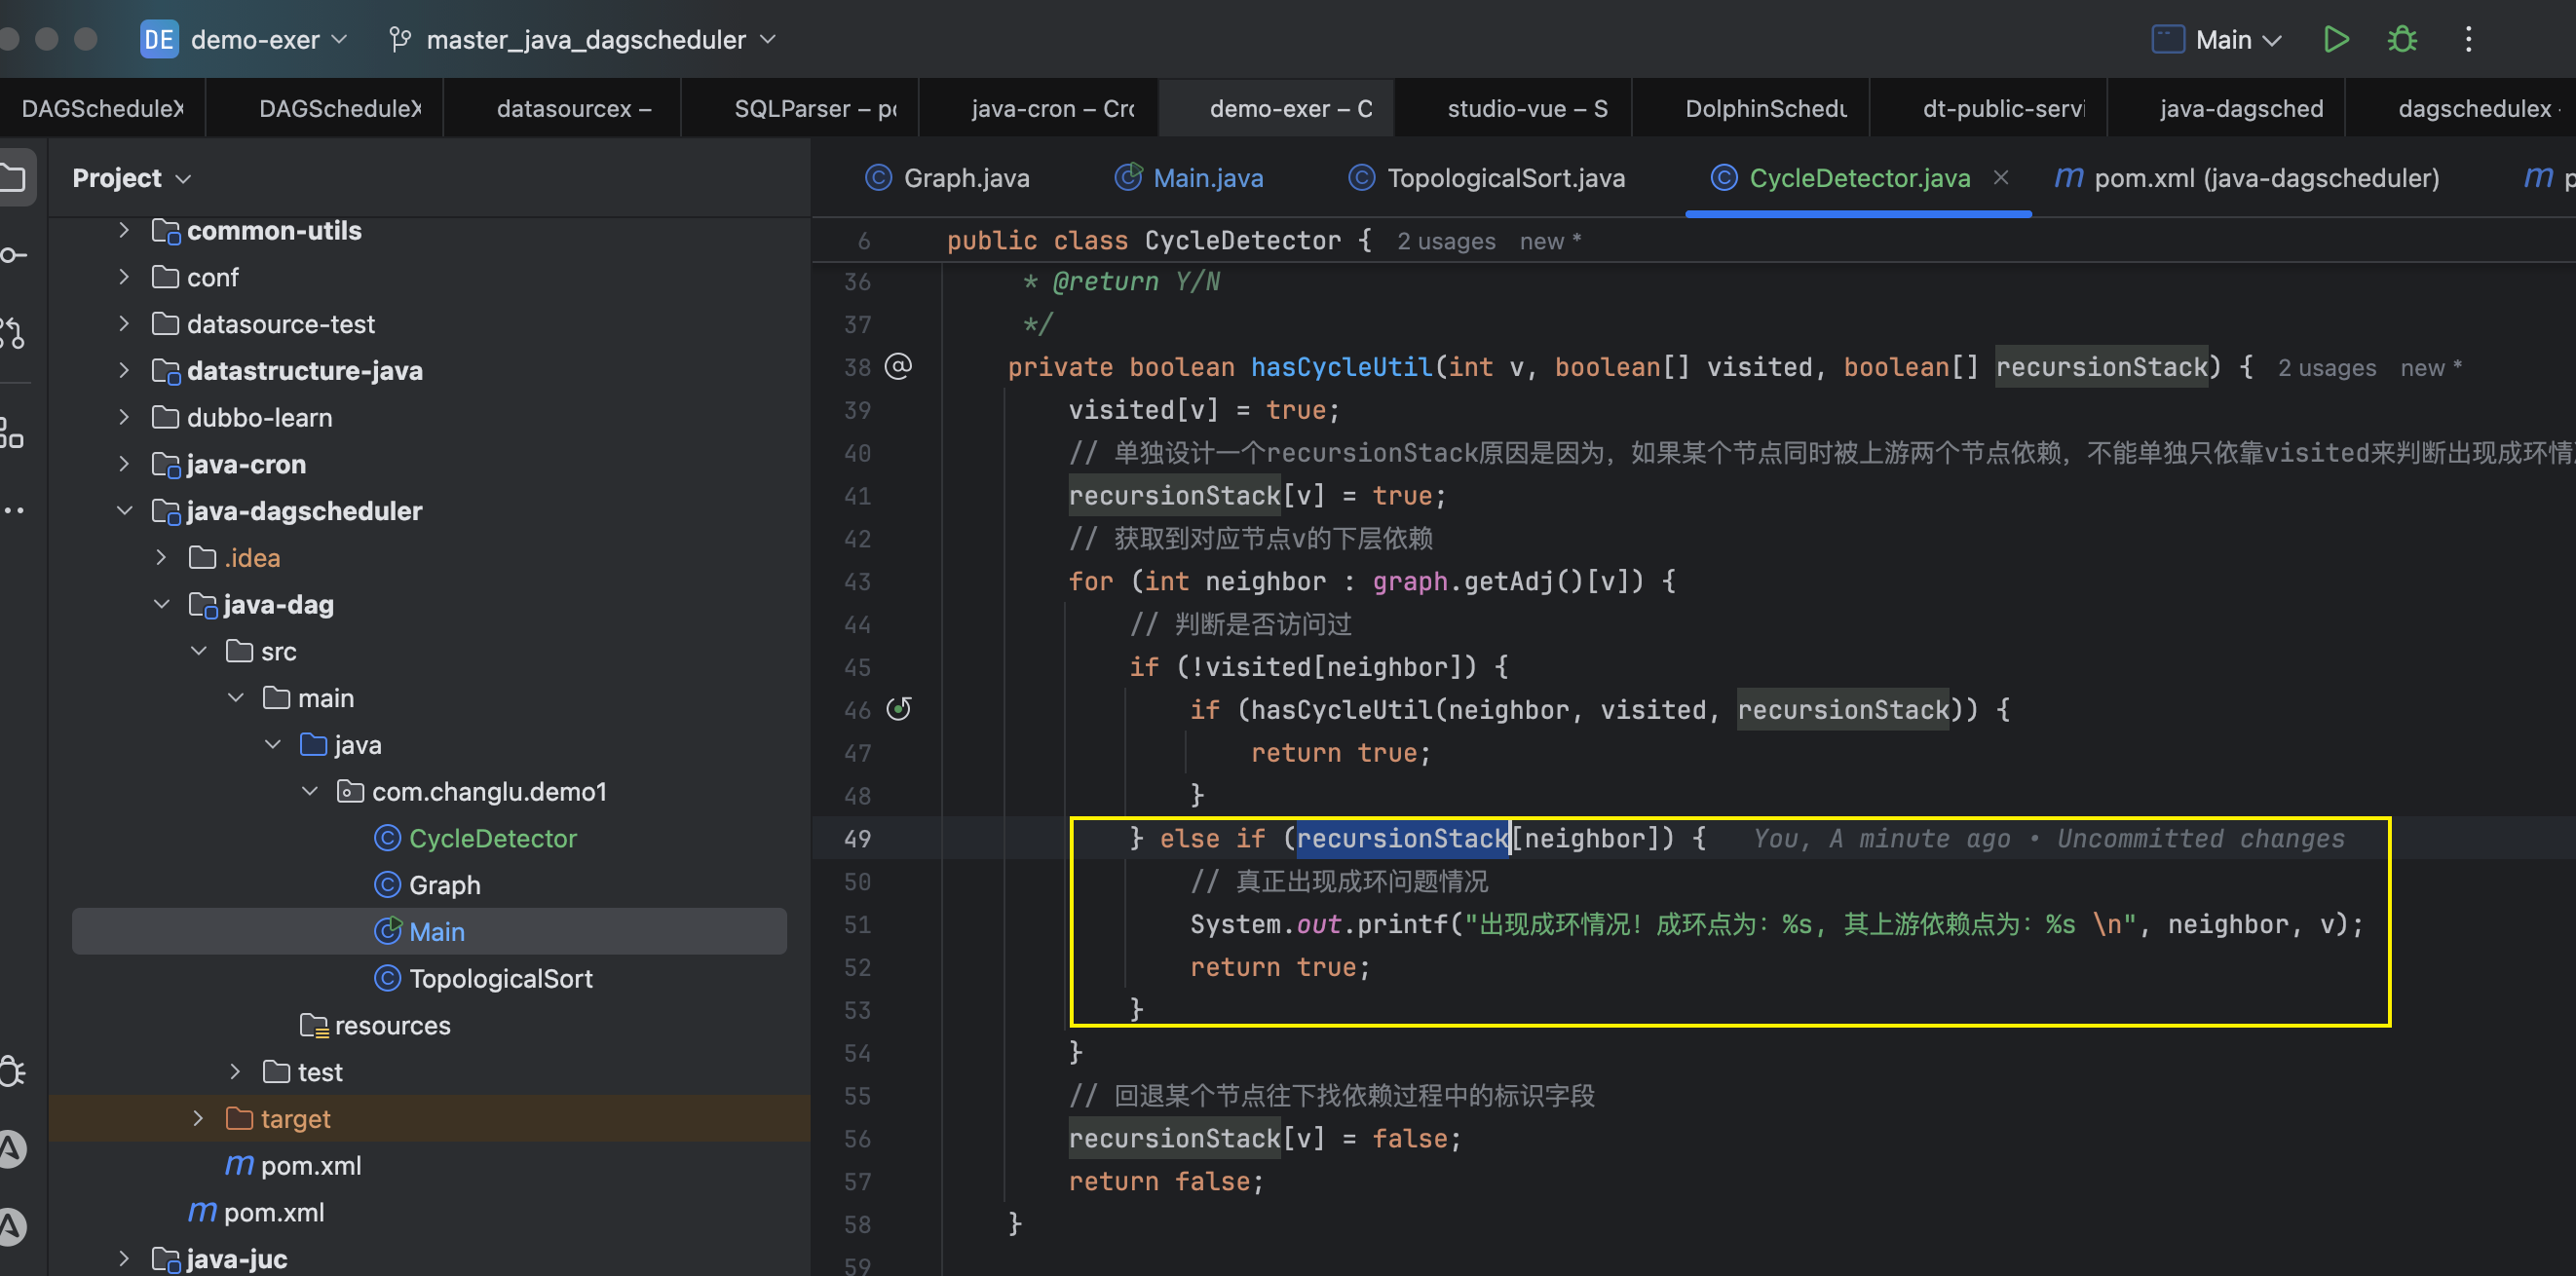
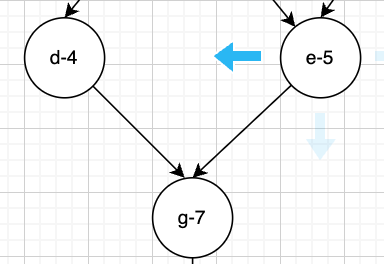
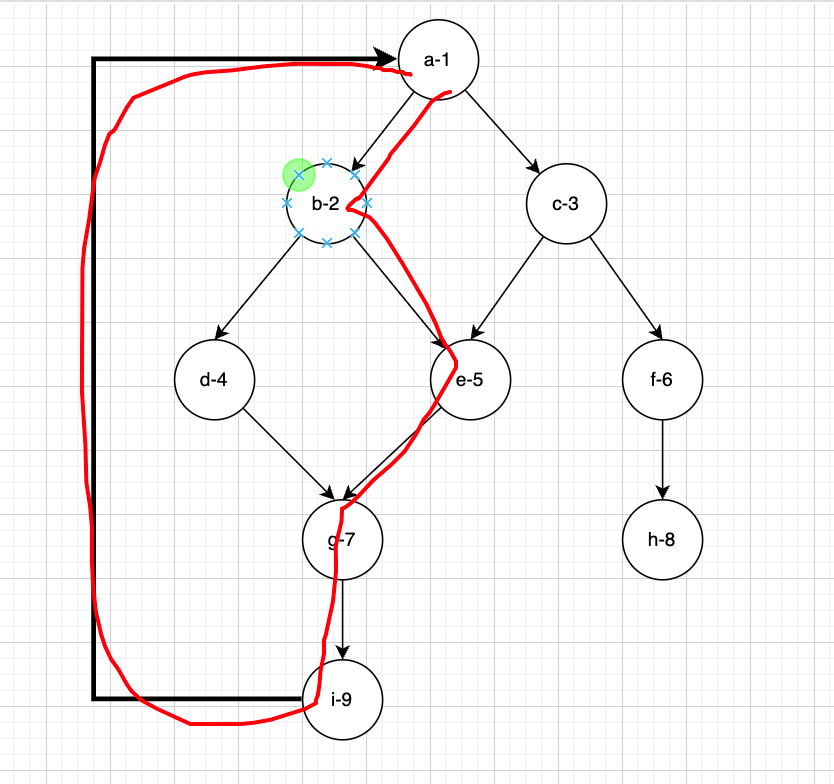
模拟拓扑排序过程,但是与拓扑排序过程不同的是,这里我们使用一个与visited[]数组类似的一个递归路径数组recursionStack[],用于检测在进行递归一条路径中,是否出现过同样的,同时递归结束没有发现一致的情况,还会有回退的逻辑,避免出现一个任务被两个上游依赖错误检测成环问题。
可能错误被判断为成环情况:
**实际应当判断为成环情况:**我们使用一个数组来记录递归过程中碰到的节点,如果一整条路径中没有发现重复节点,回退过程里要回退扫描状态。
代码实现
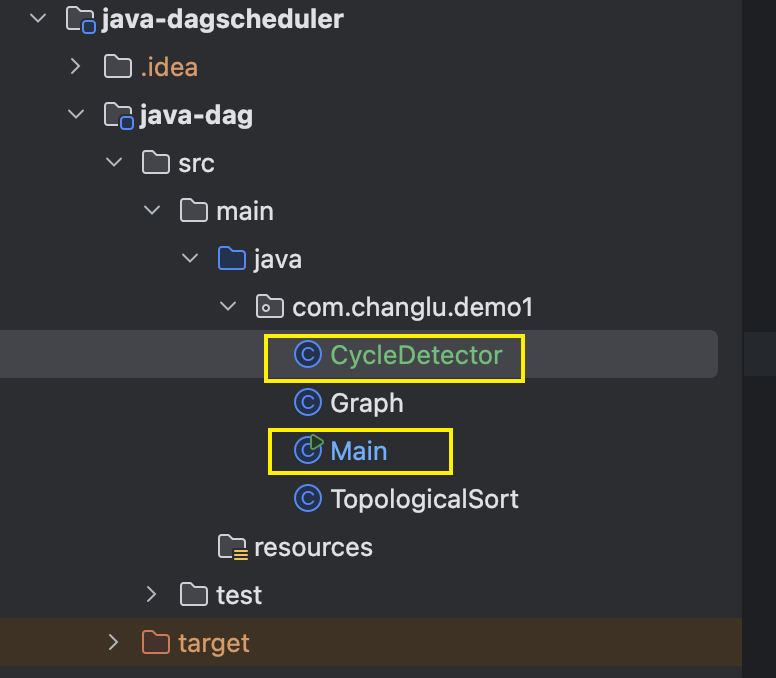
CycleDetector.java:成环检测工具类,额外补充一个recursionStack数组来记录递归过程中访问到的节点。
package com.changlu.demo1;

/**
 * 成环测试工具
 */
public class CycleDetector {

    private Graph graph;
    private int startNode;

    public CycleDetector(Graph graph, int startNode) {
        this.graph = graph;
        this.startNode = startNode;
    }

    /**
     * 是否出现成环情况
     * @return Y/N
     */
    public boolean hasCycle() {
        boolean[] visited = new boolean[graph.getV()]; // 标记节点是否被访问过
        boolean[] recursionStack = new boolean[graph.getV()]; // 标记节点是否在递归栈中
        if (!visited[startNode]) {
            if (hasCycleUtil(startNode, visited, recursionStack)) {
                return true;
            }
        }
        return false;
    }

    /**
     * 递归逻辑去判断是否出现成环
     * @param v 目标点
     * @param visited 是否真正访问过
     * @param recursionStack 递归栈(用于记录递归过程中,是否有出现重复的点,一旦某条路径访问结束后回退,相应的节点状态也会进行回退)
     * @return Y/N
     */
    private boolean hasCycleUtil(int v, boolean[] visited, boolean[] recursionStack) {
        visited[v] = true;
        // 单独设计一个recursionStack原因是因为,如果某个节点同时被上游两个节点依赖,不能单独只依靠visited来判断出现成环情况
        recursionStack[v] = true;
        // 获取到对应节点v的下层依赖
        for (int neighbor : graph.getAdj()[v]) {
            // 判断是否访问过
            if (!visited[neighbor]) {
                if (hasCycleUtil(neighbor, visited, recursionStack)) {
                    return true;
                }
            } else if (recursionStack[neighbor]) {
                // 真正出现成环问题情况
                System.out.printf("出现成环情况!成环点为:%s, 其上游依赖点为:%s \n", neighbor, v);
                return true;
            }
        }
        // 回退某个节点往下找依赖过程中的标识字段
        recursionStack[v] = false;
        return false;
    }

}
Main方法补充添加先逻辑案例:
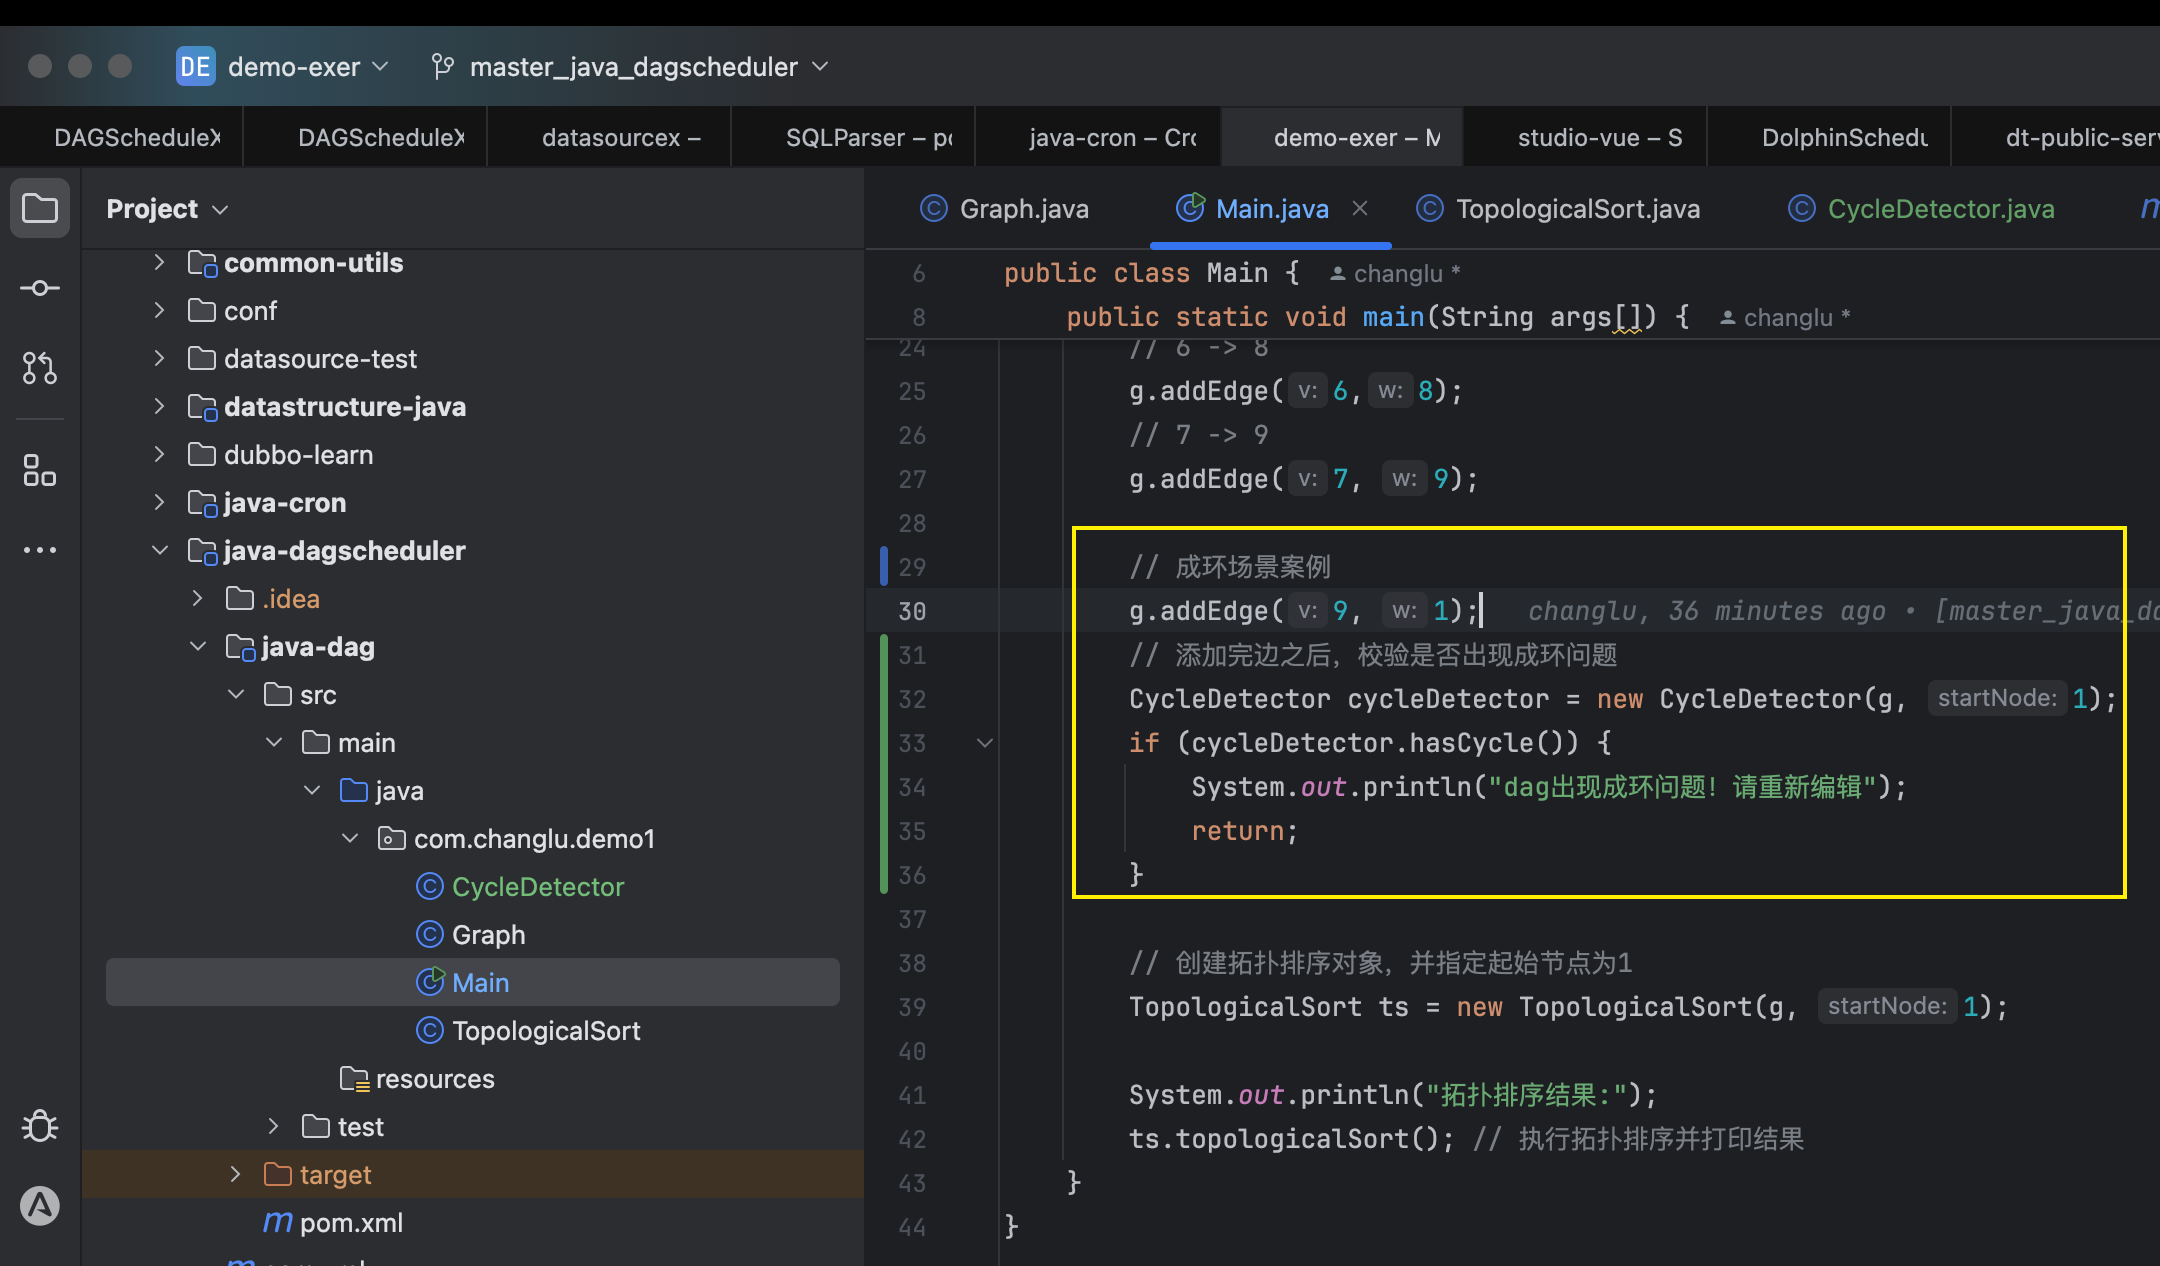
// 成环场景案例
g.addEdge(9, 1);
// 添加完边之后,校验是否出现成环问题
CycleDetector cycleDetector = new CycleDetector(g, 1);
if (cycleDetector.hasCycle()) {
    System.out.println("dag出现成环问题!请重新编辑");
    return;
}
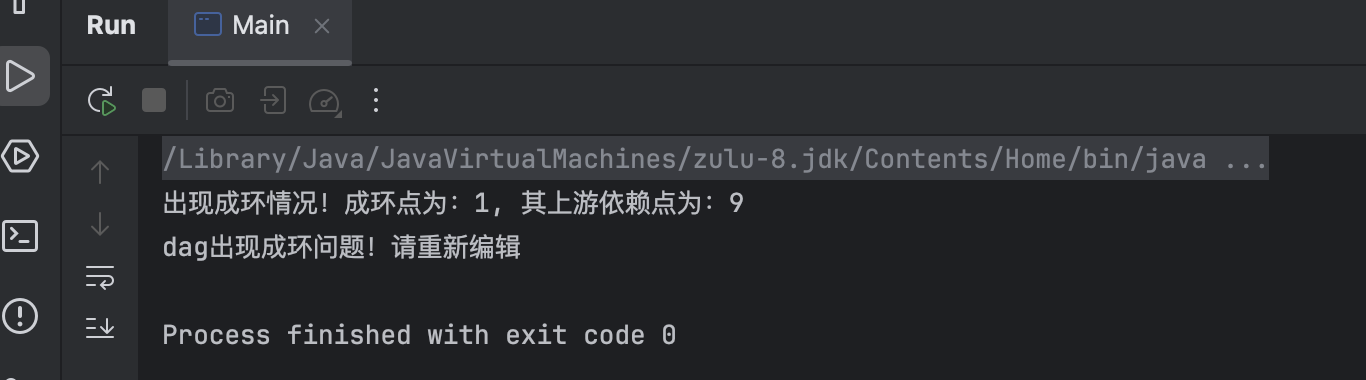
测试效果
**成环场景:**补充一个边
// 成环场景案例
g.addEdge(9, 1);
非成环场景:无需补充边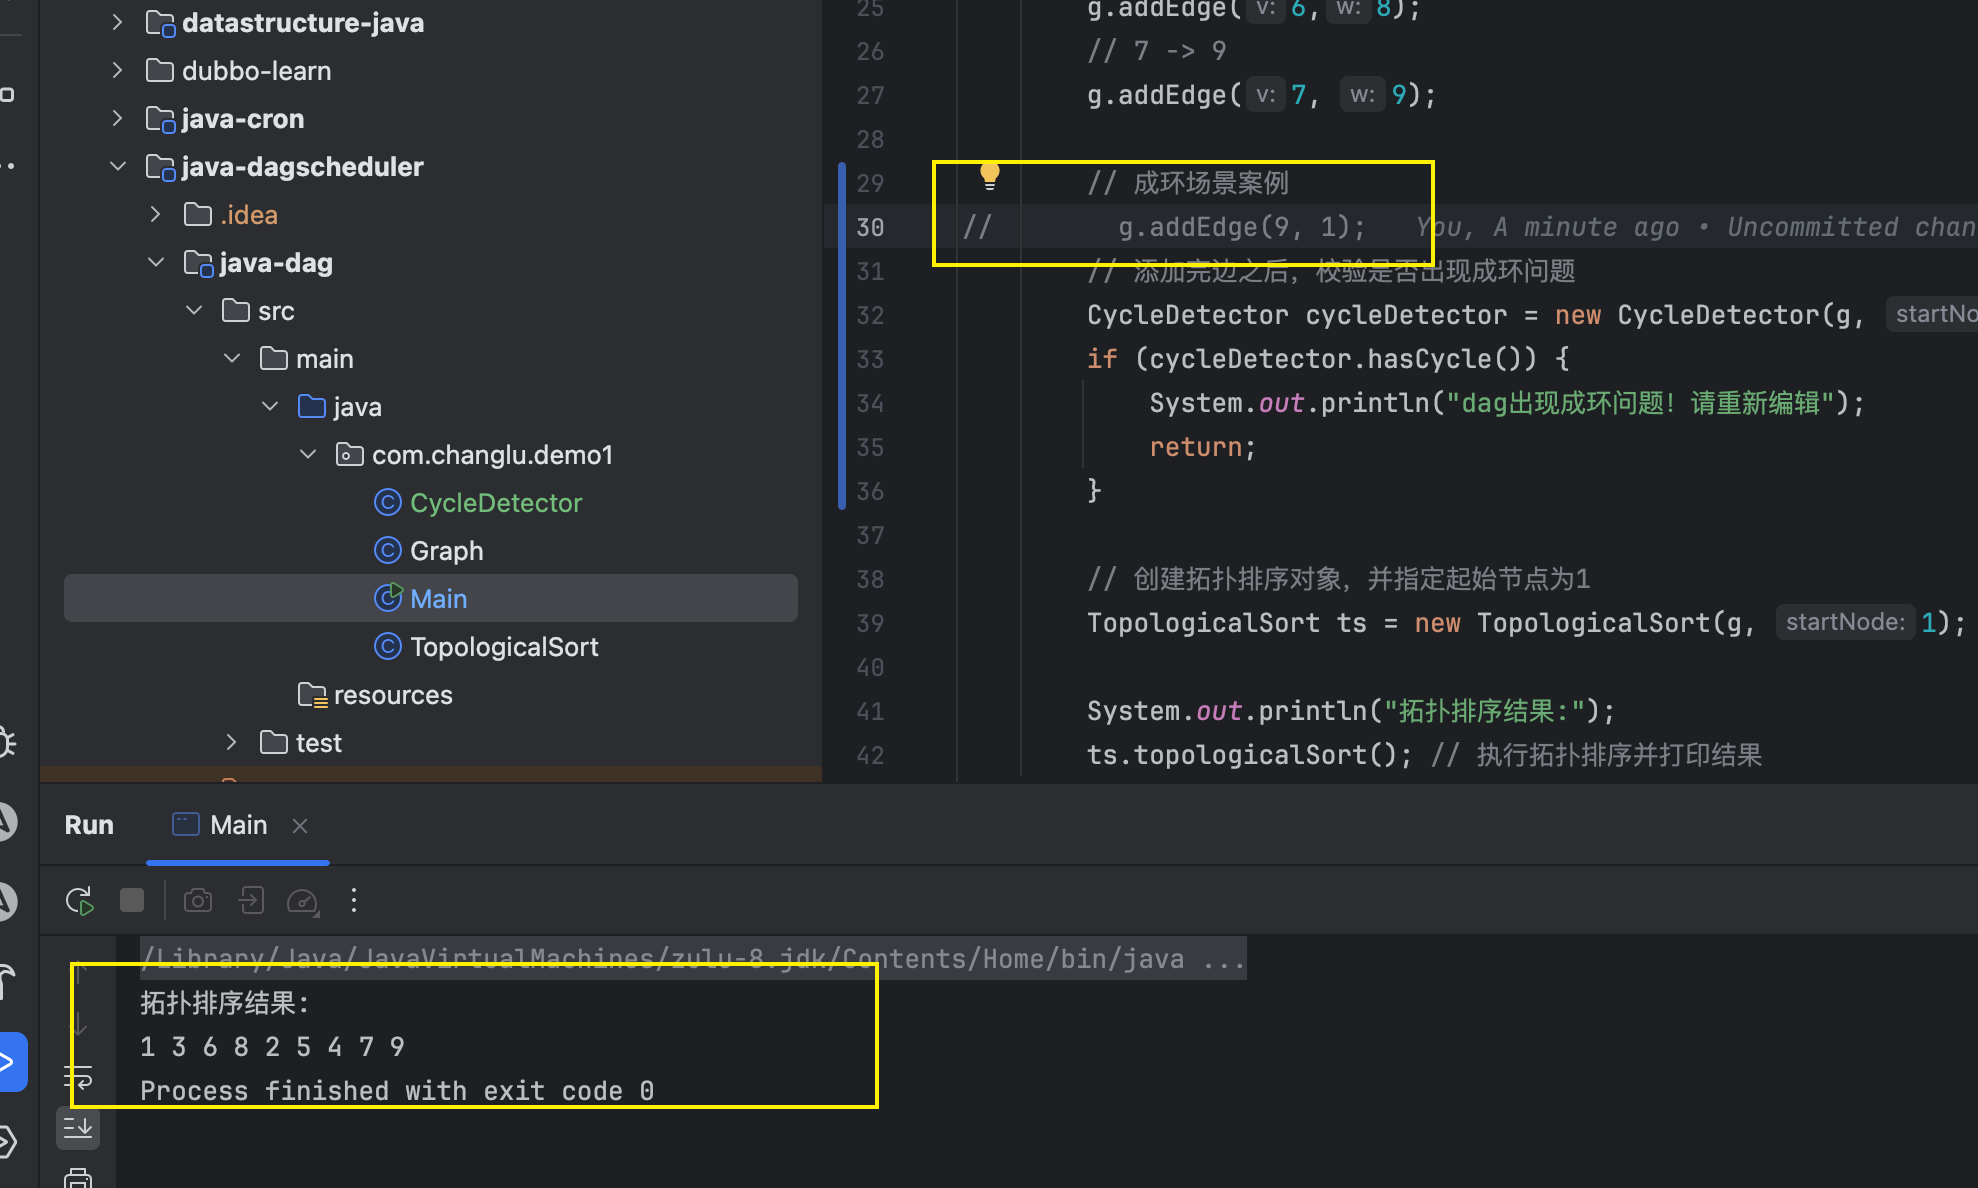
参考
[1]. 【Java项目】基于DAG的任务编排框架/平台:https://blog.csdn.net/qq_18244417/article/details/113287635
评论区请在客户端页面查看