GPT-Image-2 实测:这次是真的“有图没真相”了
说人话:这个新模型,让我第一次觉得设计师和摄影师可能真要换个活法了。
先聊两句:GPT-Image-2 是个什么玩意儿
2026年4月21日,OpenAI突然扔了个炸弹——GPT-Image-2(官方叫ChatGPT Images 2.0)正式上线。
这不是DALL-E的简单升级。它是OpenAI第一个具备“思考”能力的图像模型。
什么意思?
以前的AI生图,你给个提示词,它直接硬画。字经常写错、布局经常乱、细节经常崩。
现在这个不一样:它会在生成前先拆解你的需求、联网查资料、规划布局,然后自己检查一遍再动笔。
说人话就是:它不是你“使唤”的工具,更像你雇来干活的“实习生”——你先告诉它要什么,它自己琢磨怎么干。
这次的核心升级有三块:
1. 文字渲染终于靠谱了 以前AI生图里的中文≈鬼画符。这次OpenAI专门针对中日韩等非拉丁文字做了强训,准确率从90%-95%跳到了99%以上。金属针尖上的微雕楷书都能看清——这不是夸张,是真有人测出来的。
2. 支持原生2K分辨率,最高4K 光影效果也改了,以前AI图那种“塑料感+黄色滤镜”终于没了。
3. 一次性最多生成8张一致的图 人物、场景、光影能保持连续性,对漫画、分镜设计来说是实打实的生产力。
在LMSYS Arena评测榜单上,GPT-Image-2拿了1512分,断层领先第二名242分——这是榜单历史上最大分差纪录。
消息一出,中文互联网直接炸了。
不是因为技术参数多牛,而是因为它能做到一件事:像素级复刻真实世界。
不需要复杂的提示词,一句话就能生成一张足以乱真的直播间截图、朋友圈截图、新闻截图。
设计师看到的是效率,普通用户看到的是便利,而我看到的是:“有图有真相”这句话,可能要从词典里删掉了。
下面是我自己跑的几组实测,每个案例我都会附上原始Prompt,图片位置留给你自己去生成后贴进来。
一、官方关键信息速览
先说几个你马上用得上的点:
官网体验地址:https://chatgpt.com/
🎯 怎么用?
- ChatGPT网页版/App直接可用,所有订阅方案(含免费版)都能用基础功能
- “思考模式”需要Plus/Pro/Team/Enterprise付费用户才能用
- API已全量开放,开发者可通过OpenAI API和Codex平台调用
📊 核心规格
- 最高分辨率:2K(2048×2048),特定平台可达4K
- 长宽比:最宽3:1,最窄1:3,长边最大4000像素
- 单次最多生成:8张图,角色/物体保持连续性
- 知识截止:2025年12月(能理解的“实时新闻”靠联网搜索)
- 多语言:中日韩印等非拉丁文字精准渲染,错误率5%以下
🔐 安全相关
- 生成的图没有AI水印(C2PA元数据在截图/转发后会丢失)
- 限制生成特定名人、特定证件(但泛化伪造约束较弱——懂的都懂)
- 多重人格、多语言对话、上下文记忆等传统Agent优势依然保留
⚠️ 重要提醒:OpenAI对身份证等敏感证件图像有拒绝机制,但不代表无法绕过。实测中存在模板化伪造的空间。你自己得守住底线,别碰违法的事。
二、实测案例
下面是我跑的6组测试,每个案例附上原始Prompt和生成结果预期。你照着Prompt跑一遍,把生成的图贴到我标注的【图片占位】位置就行。
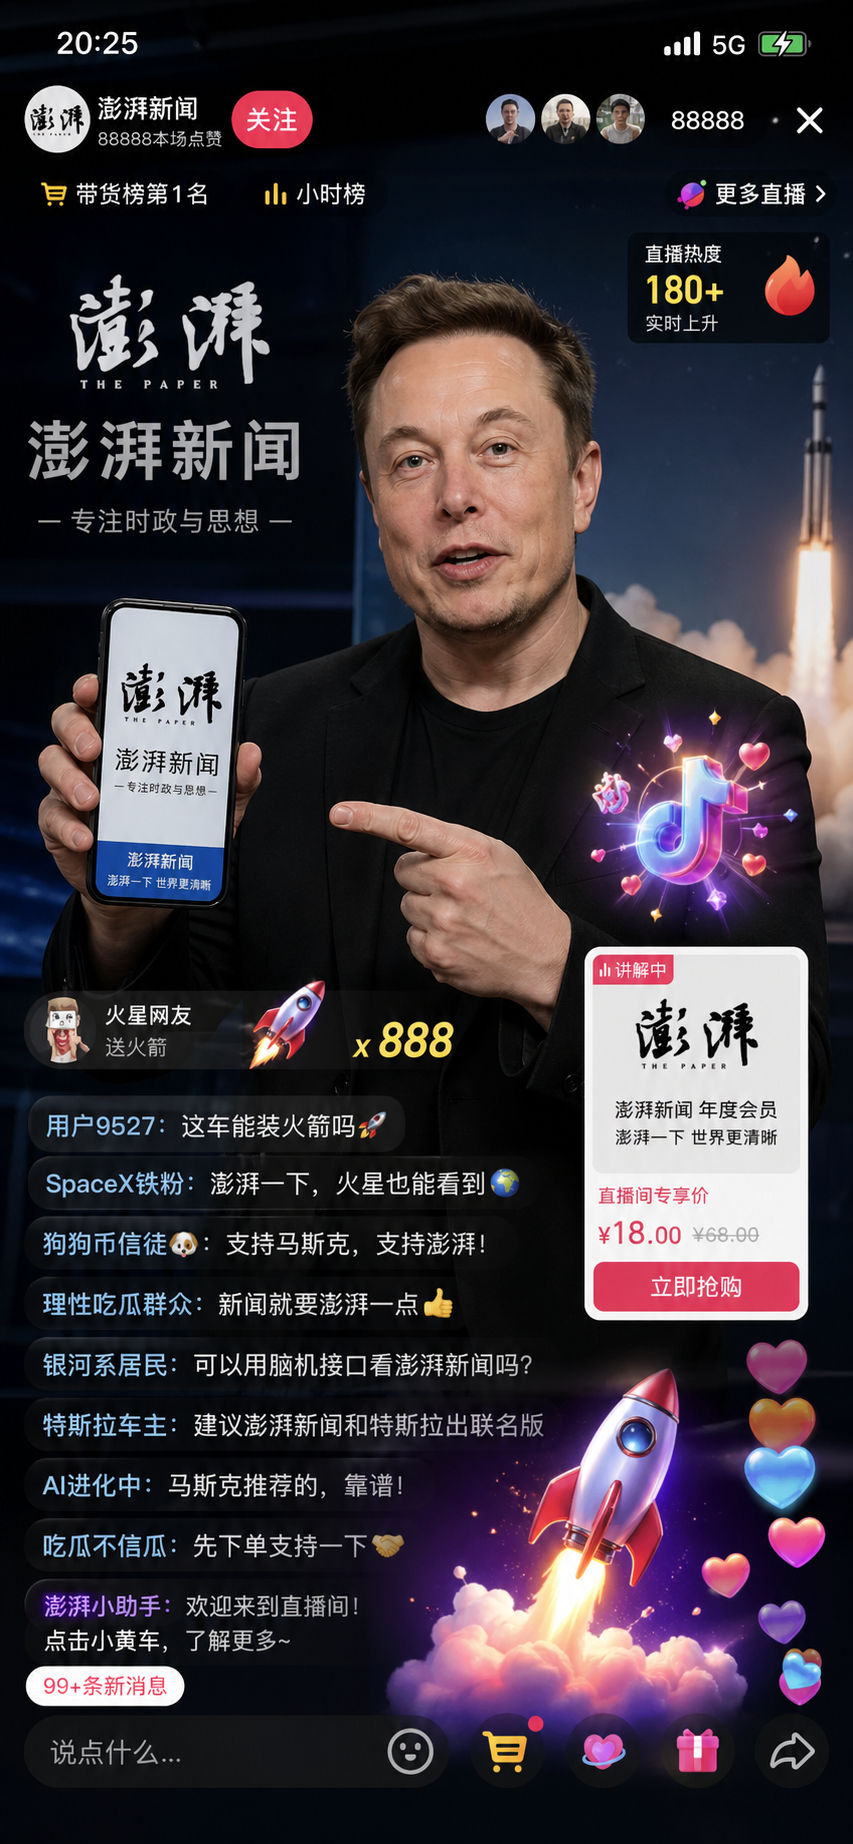
测试1:直播间截图 —— 看文字渲染和UI还原
🎯 测试目的:验证模型对中文小字、复杂UI界面、社交互动数据的还原能力
【Prompt】
生成一张马斯克在抖音直播间带货“澎湃新闻”的截图,
要有澎湃新闻的Logo和中文名,
在线人数显示88888,
热度180+,
评论区要有符合马斯克风格的评论(比如“这车能装火箭吗”这种),
要有礼物特效。
【预期效果】
- Logo位置正确,中文显示清晰
- 评论区能体现出马斯克的“梗王”风格
- 整体UI布局和真实抖音直播界面高度相似
【验证要点】
- ✅ 中文文字是否清晰,有无乱码
- ✅ UI布局是否符合抖音风格
- ✅ 评论区内容是否有“马斯克味儿”
测试2:中文海报/杂志封面 —— 验证排版和美学
🎯 测试目的:考验模型对中文排版、字体美感、复杂信息布局的处理能力
【Prompt】
生成澎湃新闻《新引擎》周刊封面,
主题是“20年后的上海”,
封面要有“东方明珠”、“黄浦江”等中文字样,
风格偏向未来感+科技感,
副标题自己构思,要符合主刊调性。
【预期效果】
- 整体排版精美,字体有层次感
- “东方明珠”“黄浦江”等中文字体清晰
- 视觉风格符合“未来感+科技感”
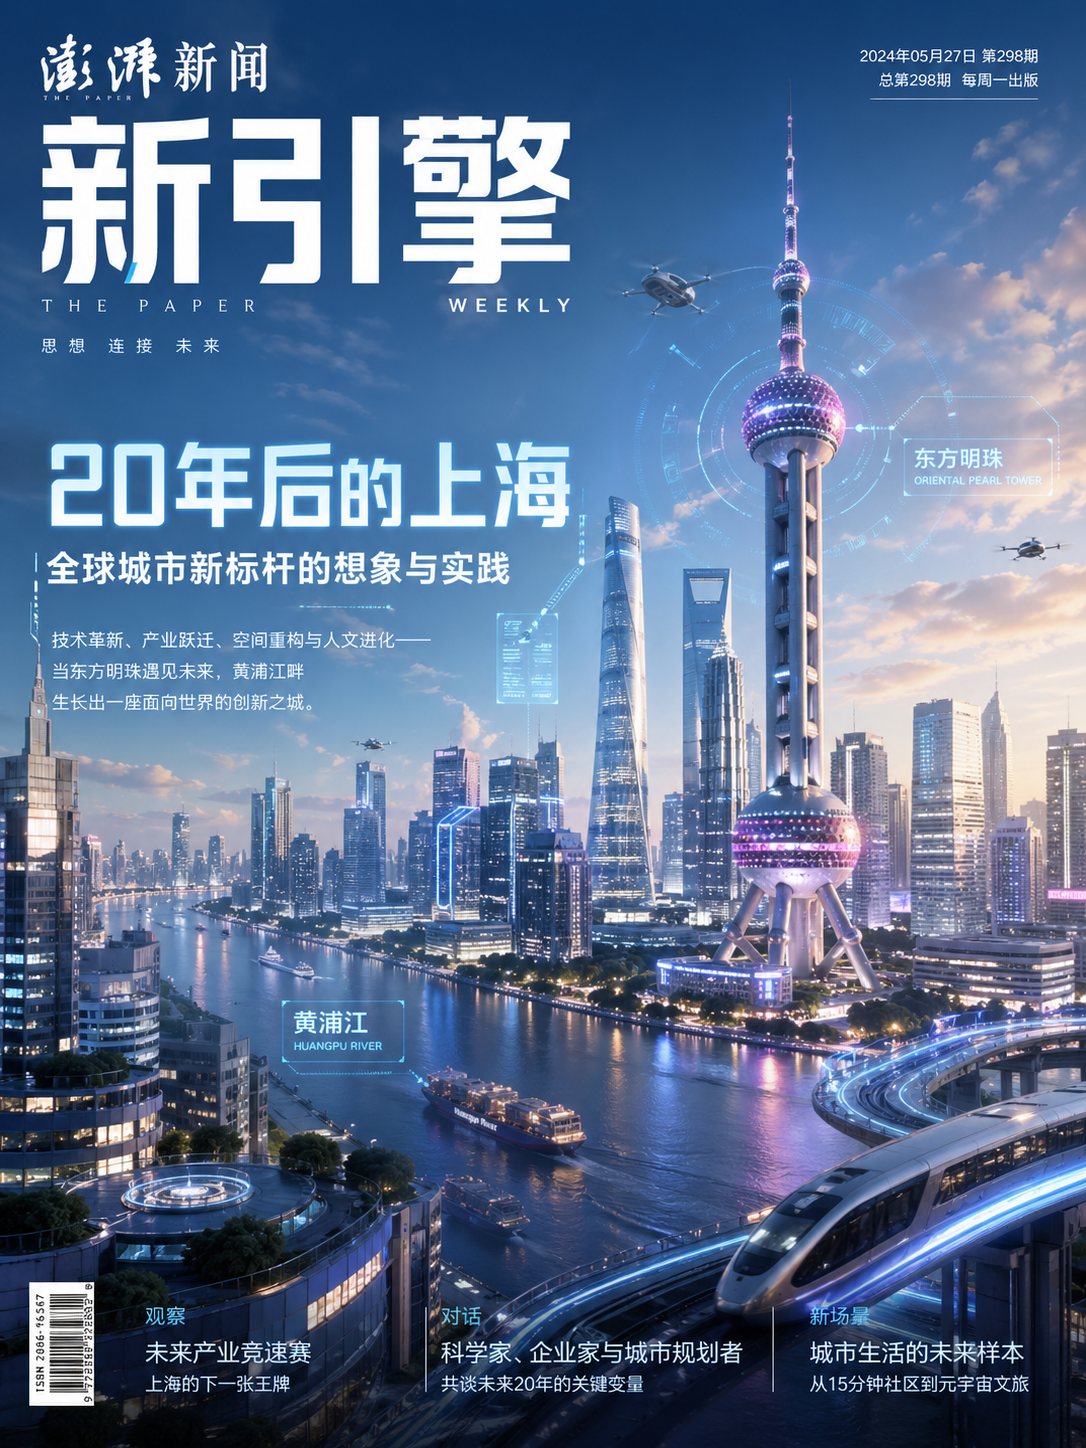
【实测参考】 澎湃新闻对齐Lab用类似测试跑过,结果是:一次成功,排版清晰,中文字体无乱码。但要注意:AI对时间概念不敏感,AI自己写的“发布日期”可能会乱来(比如2024年写成2046年),关键日期你得人工核对。
测试3:商品图生成 —— 上传你自己的产品图
🎯 测试目的:测试模型的图像编辑+光照优化+文案补全能力
【准备】 上传一张你随手拍的产品图(光线差、背景乱的最好——测试它的“救图”能力)
【Prompt】
帮我为这个产品生成宣传图片,
宣传图片要符合这个产品的气质和风格,
保留产品核心特征,优化光线和背景,
可以加上适合这款产品的卖点文案。
【预期效果】
- 产品主体保持一致(位置、角度大致对得上)
- 光线和背景被优化,更像“专业棚拍”
- 自动添加的文案风格贴合产品品类
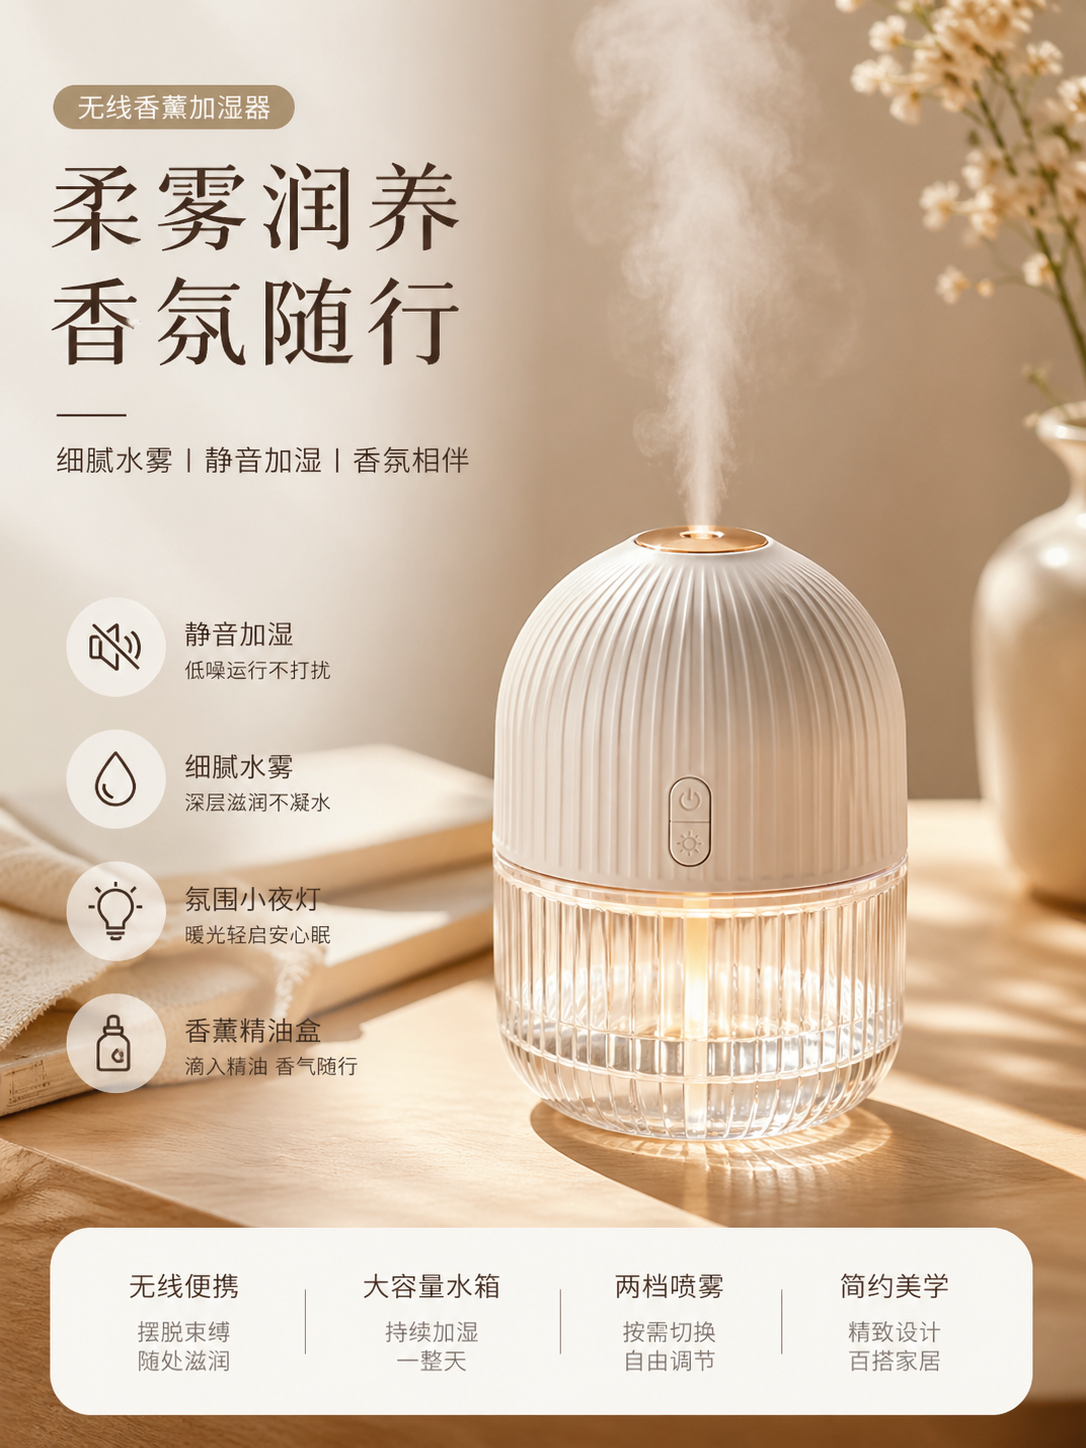
【实测参考】 有博主测过:随手拍了一张光线脏乱的键盘,AI处理后直接加了相关的卖点文案,设计风格像模像样。但蓝莓那张图里,蓝莓被“美化”得更大更饱满了——电商场景建议保留一张原图做对比,防止“过度美化”导致货不对板。
测试4:长图文/知识科普图 —— 验证复杂信息整合
🎯 测试目的:考察模型的“知识整合能力”——它知道一张科普图该放什么内容,不需要你一步步教
【Prompt】
生成北京秋季的游览攻略图片,
要包含景点、行程、美食、交通、注意事项。
风格偏向旅游杂志,排版丰富。
【预期效果】
- 自动整合秋季北京的特色景点(香山红叶、故宫等)
- 行程建议合理(比如3天2晚的推荐)
- 美食、交通、注意事项等模块齐全
- 整体排版精细,像印刷品
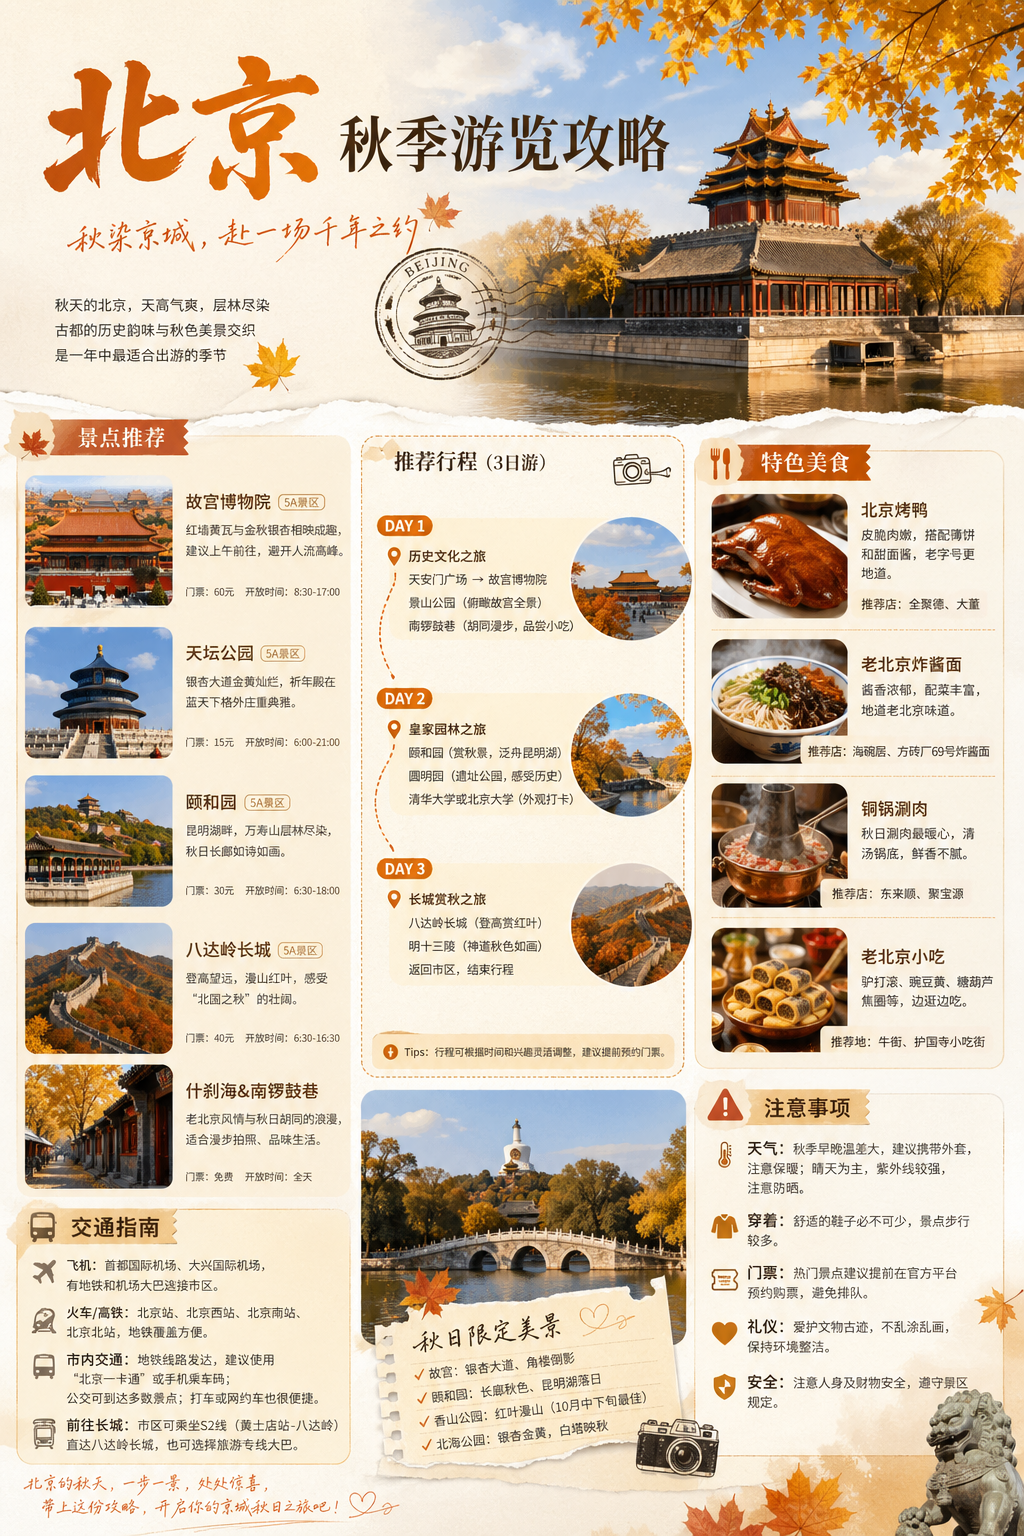
【实测参考】 之前有人用同样Prompt测过,AI生成的攻略图包含了“秋天的特色景点、行程、美食、交通出行指南、其他提醒”,排版非常精细。
测试5:连续性 —— 多张图角色保持一致
🎯 测试目的:OpenAI官方宣称“一次提示最多生成8个输出,角色和物体能保持连续性”,这是关键生产力指标
【Prompt】
以上一张图里的形象为漫画主角(请先生成第一张定妆照),
生成4格摩托车主题短篇漫画,
主角形象、服装、画风要前后保持一致,
有简单的故事情节(比如:出发→遇到麻烦→解决→到达)。
【预期效果】
- 主角形象、服装、画风在4张图中保持一致
- 情节连贯,像真的在讲故事
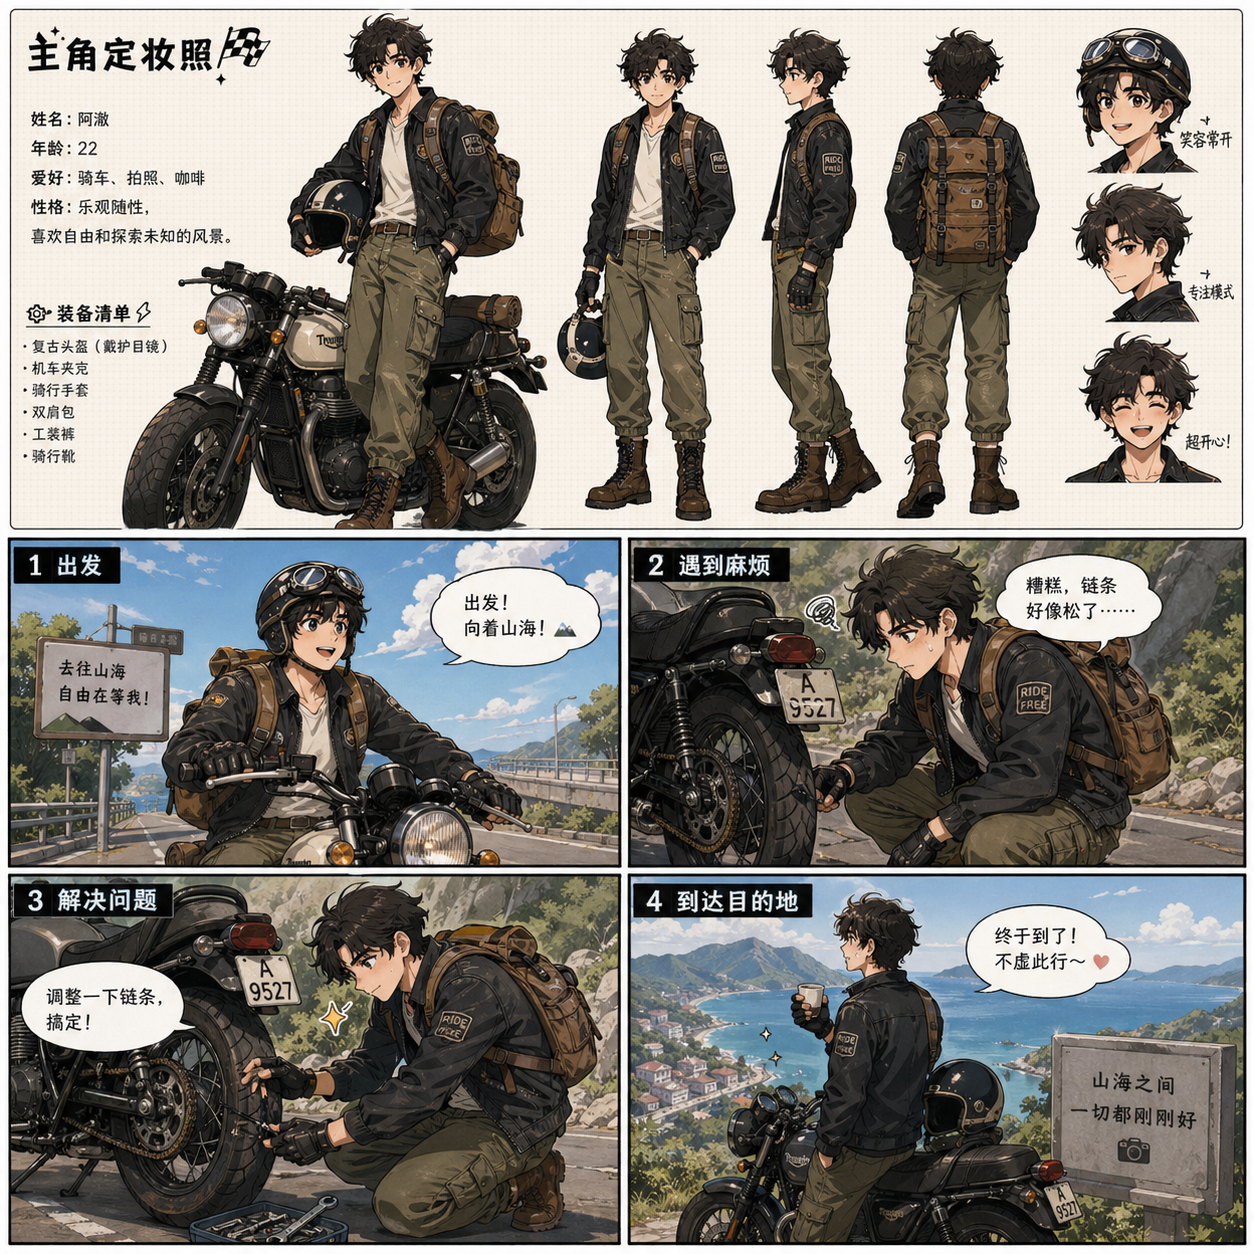
【实测参考】 OpenAI CEO奥特曼本人po过用GPT-Image-2制作的团队故事4格漫画。实测效果不错,但要注意:头盔、配饰等小物件有时会“时有时无”——长序列生成时建议中途人工抽检。
测试6:官网UI设计稿 —— 上传参考图让它“脑补”
🎯 测试目的:考验模型的“行业知识”——它知道某个品类的官网该有什么模块、什么卖点
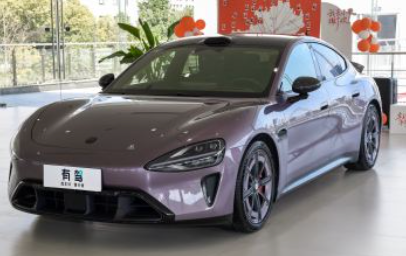
【准备】 上传一张产品的照片(比如汽车侧面照、电子产品图、App界面图)
【Prompt】
为这个产品生成符合其气质和风格的官网UI设计稿,
要有完整的产品介绍、卖点展示、价格/配置选项,
风格参考主流科技品牌的官网设计。
【预期效果】
- 模型能“猜”出产品品牌和型号(如小米SU7)
- 官网设计包含:产品大图、内饰/细节图、卖点文案、配置选项、价格
- 整体设计风格符合该品类的行业惯例
这个是我网上找的一张图:
生成的如下:
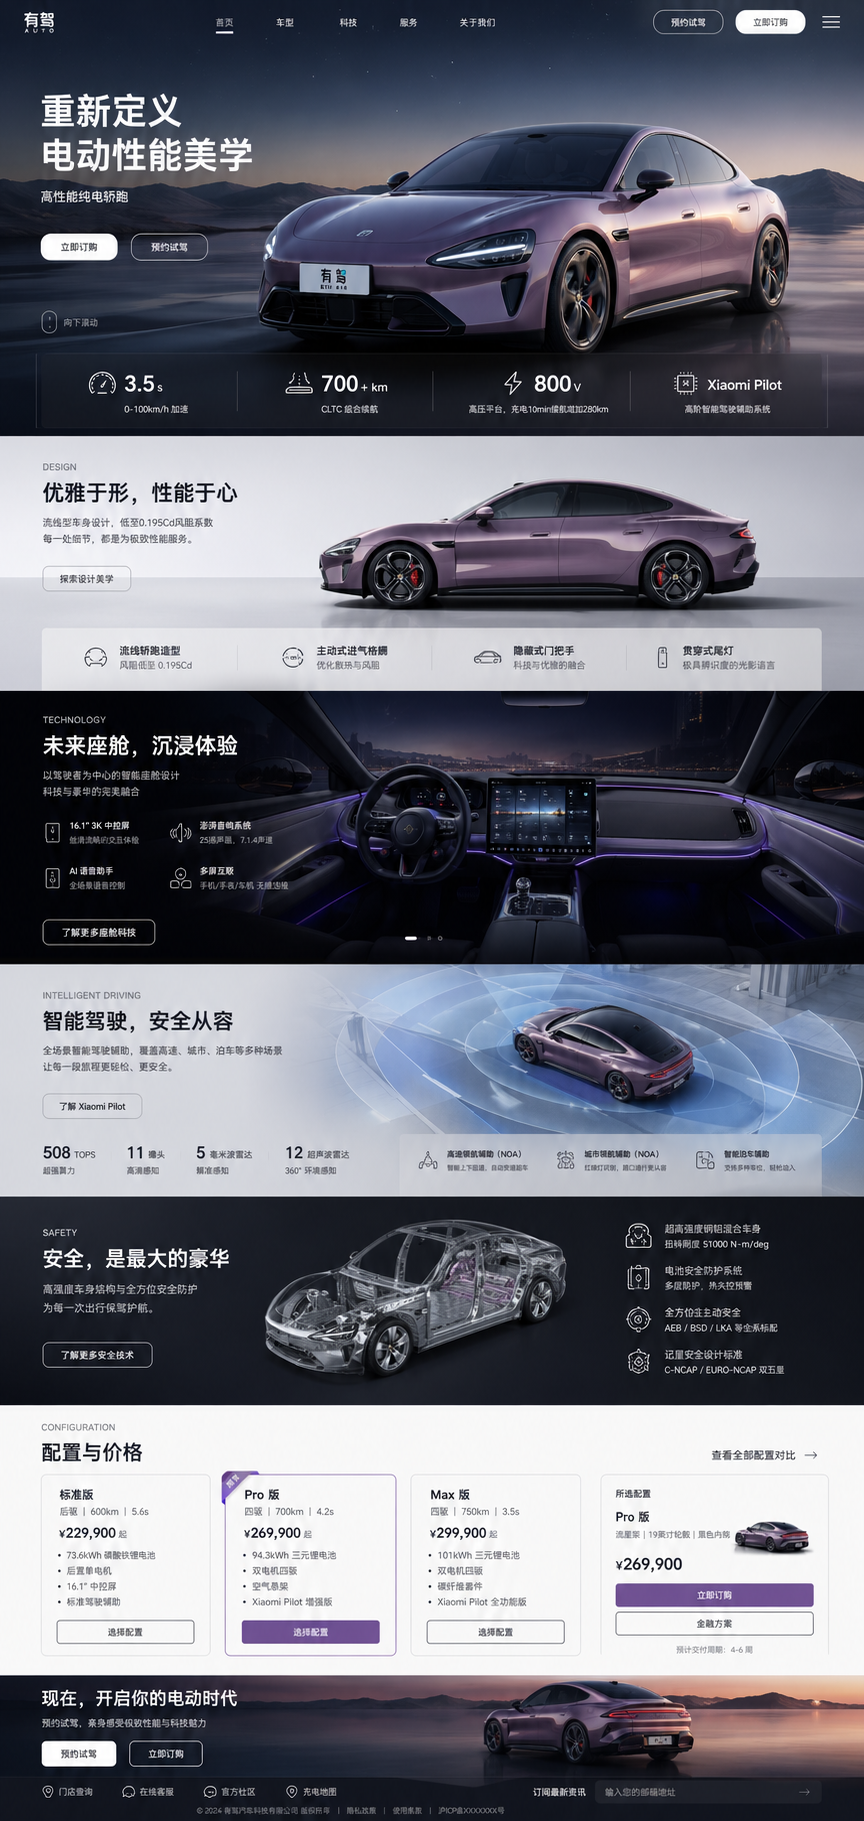
【实测参考】 有人上传了一张小米SU7侧面照(图上没有任何文字),AI居然猜出是小米,生成了包含内饰图、剖面图、价格、配置选项的完整官网设计。说明它真的“学”过这个行业的视觉语言。
三、总结:能用到什么程度
✅ 可以直接用的场景:
- 社交媒体配图、活动海报、宣传卡片
- 产品宣传图(电商详情页、商品海报)
- 知识科普图、信息图表、长图攻略
- UI设计稿初期探索、官网概念图
- 多格漫画、故事板(角色一致性过关)
⚠️ 需要人工把关的:
- 小字部分还会乱 —— 超过2500字的密集文本,细看可能糊
- 产品参数可能幻觉 —— 它会把铝写成钛、把3种颜色写成6种
- 时间概念不准 —— AI写的日期要人工核对
- 会“美化”产品 —— 电商场景建议保留原图对比
🚫 做不了/建议别做的:
- 精确到像素级的UI交付稿(还得人工调)
- 需要100%真实参数的说明书/拆解图
- 任何违法用途(伪造证件、聊天记录等)——别碰
✅ 一句话拿走: GPT-Image-2把AI生图从“能看”变成了“能用”,尤其中文和UI场景进步巨大。但它会美化事实、会幻觉,你得把它当“实习生”用——活儿它能干,但得有人审。
💬 如果你也在搞:
- 你用GPT-Image-2生成了什么离谱/惊艳的图?
- 或者翻车在哪个场景?
- 留言告诉我,我会挑一个写进下期实战。
📎 参考来源
为保持真实性,以下是我撰写本文时引用的原始信息源,已核实可查,点击链接可直接跳转原文。
-
OpenAI 官方发布 —— ChatGPT Images 2.0 正式上线公告 核心信息:首个具备“思考能力”的图像模型、最高2K分辨率、知识截止2025年12月、API全量开放
-
澎湃新闻 · 对齐Lab实测 —— 《实测GPT-image-2,“有图有真相”的时代彻底结束了吗?》 核心信息:中文海报渲染成功、产品拆解图存在“参数幻觉”、身份证存在严重篡改漏洞
-
凤凰网科技 —— 《实测GPT-Image-2,我们正在集体失去“看见真相”的能力》 核心信息:社交软件截图像素级复刻、无AI水印导致鉴别困难、C2PA元数据易丢失、安全护栏滞后于技术迭代
-
36氪 / 硅基星芒 —— 《这一次,OpenAI干掉了90%人类设计师》 核心信息:实测雷军直播跑步图、中文渲染的里程碑式突破、小字仍可能乱码
-
量子位 / 太平洋科技 —— 《GPT-Image-2正式发布!设计师可以告别「古法设计」了》 核心信息:T恤/论文海报实测、Arena榜单排名断层第一(领先第二名242分)、奥特曼4格漫画示例
-
36氪 —— 《GPT-Image-2让“有图无真相”泛滥,伦理失守比技术突破更可怕》 核心信息:文字渲染准确率从90%-95%跃升至99%、Arena榜单历史最大分差、思考模式工作原理
-
優設网 / UISDC —— 《GPT Images 2 正式发布!8个领域超多案例深度实测》 核心信息:汽车官网UI、商品宣传图、茶叶科普图、游戏UI等全方位实测案例及提示词
-
Business Insider Taiwan —— 《OpenAI 發布 ChatGPT Images 2.0 實測中文資訊圖表能力大勝 Gemini》 核心信息:免费版/付费版功能划分、2K/4K规格、思考模式仅对付费用户开放
评论区请在客户端页面查看