搜索引擎SEO优化调研学习02、第一阶段核心改造、服务端直出与站点级文件
系列文章:
- 上篇:搜索引擎SEO优化调研学习01、文章页优化、站点变现与数据监测
- 本篇:02、第一阶段核心改造、服务端直出与站点级文件(BlogLoom 落地篇)
本篇定位: 上篇(01)是"教科书 + 拆解篇",回答了**"SEO 是什么、别人怎么做、数据在哪看";本篇(02)是"落地篇",把 01 讲到的能力收敛到 BlogLoom 第一阶段的最小改造范围**,给出可执行的功能需求与工程实现方案。因此,建议先读 01 建立全局认知,再读 02 动手改造;本篇结尾也专门列出与 01 的章节对应关系。
在给开源博客平台 BlogLoom 做搜索引擎优化(SEO)改造时,我们就遇到了这样一个非常具体的问题:
辛辛苦苦写完一篇文章,发到自己的博客上,结果在 Google、百度里怎么搜都搜不到。
不是内容不好,也不是没人访问——而是搜索引擎根本读不到我们的文章。这篇文章就围绕这个问题,把 BlogLoom 第一阶段要做的 SEO 改造,从"为什么做"到"怎么做"再到"怎么验证",完整梳理一遍。
本文的目标是:初步梳理下一阶段需要优化的核心功能点需求,并逐一对照 BlogLoom 现有系统核心功能,给出可落地的改造设计方案。
一、背景引入:为什么 BlogLoom 必须做 SEO
1.1、一个真实场景:文章发布了,却搜不到
BlogLoom 是我做的一套开源博客平台:
- 开源地址:https://github.com/changluya/BlogLoom
- 技术栈:Spring Boot 2.2.7 + MyBatis + Vue 2.6 + Vite
- 定位:给个人开发者 / 内容创作者自己搭博客用,也方便二次开发
- 线上站点:https://blog.changlu.cloud/
它由三块组成:
| 模块 | 作用 |
|---|---|
blog-view-ui |
博客前台(Vue2 单页应用),读者看文章的地方 |
blog-cms-ui |
管理后台(Vue 单页应用),作者写文章的地方 |
blog-backend |
后端服务(Spring Boot 接口 + MyBatis),负责提供数据 |
功能其实已经挺全了:Markdown 写作、分类标签专栏、评论、站点配置、访问统计、Docker 一键部署……唯独"搜索引擎收录"这块,几乎是空白。
那么问题来了:明明文章内容都在数据库里,为什么搜索引擎看不到?
1.2、先搞懂:搜索引擎是怎么工作的
在动手之前,先把搜索引擎的大致工作过程理解清楚,后面每一步改造才有依据。
| 阶段 | 搜索引擎在做什么 | BlogLoom 需要解决什么 |
|---|---|---|
| 发现 | 找到你的文章网址 | 有导航、文章链接和 Sitemap |
| 抓取 | 访问网址,读取页面 | 页面可访问,正文能被读取 |
| 索引(收录) | 分析页面,决定是否放进搜索数据库 | 内容清晰、有价值,减少重复页面 |
| 排名与展示 | 用户搜索时,挑选相关页面展示 | 内容符合搜索需求,网站体验良好 |
重点:提交网址不等于一定收录,收录也不等于排名靠前。 第一阶段我们只解决最前面两环——能被发现、能被抓取。
1.3、实测现状:爬虫眼里的 BlogLoom 是个空壳
光说"没有 SEO"太虚,我们直接访问线上站看看结果。
| 请求 | 返回结果 | 说明 |
|---|---|---|
GET https://blog.changlu.cloud/ |
200,但只有一个空壳 | 源码里只有 <title>BlogLoom</title> 和一个空的 <div id="app">,正文一个字都没有 |
GET /robots.txt |
404 | 没有抓取规则文件 |
GET /sitemap.xml |
404 | 没有站点地图 |
GET /rss.xml |
404 | 没有订阅源 |
GET /blog/513(文章链接) |
404 | 直接打开文章链接,竟然是 404 |
GET /blog?id=513(接口) |
200,有完整正文 | 内容都在,只是没渲染到页面上 |
这里有两个扎心的点:
- 爬虫拿到的是空壳。 正文是浏览器执行 JS 后、再用 axios 调接口渲染出来的;爬虫不执行 JS,自然啥也读不到。
- 连直接打开文章链接都 404。 前台是 history 路由,但服务器没做 fallback——从首页点进去没问题,可一复制链接发给别人、或者刷新页面,就 404 了。
请求链路大概是这样的:
浏览器 / 爬虫
   ↓
blog-view-ui 的 index.html(空壳,<title>BlogLoom</title>)
   ↓ 浏览器执行 JS
axios 调 blog-backend 的 /blog 接口
   ↓
Vue 在浏览器里渲染正文,用 document.title 改标题
结果就是,爬虫和真实用户看到的完全是两个世界:
| 谁在看 | 看到的东西 |
|---|---|
| 爬虫(不执行 JS) | <title>BlogLoom</title> + 空 div,没有正文,也没有描述 |
| 用户(浏览器) | 正文、标题、评论,全都正常显示 |
一句话:不是内容不够好,是搜索引擎根本读不到。 这就是眼下最大的困局,也是必须第一个解决的地方。
1.4、本阶段的范围与目标
改 SEO 也得有个盼头。我们要的其实就三件事,而且有先后顺序:
| 优先级 | 目标 | 怎么判断做到了 |
|---|---|---|
| ① | 能被收录 | 在 Google / Bing / 百度搜 site:blog.changlu.cloud,能看到我的文章 |
| ② | 做好 SEO | 每篇文章有独立的标题、摘要、canonical、结构化数据;站点有 sitemap / robots / rss / 分享卡片 |
| ③ | 能看数据 | Search Console 看收录和搜索词,GA4 / Umami 看流量来源,形成每周复盘的习惯 |
围绕这个目标,本文按阶段划分范围:
| 阶段 | 主题 | 是否属于本文范围 |
|---|---|---|
| 一阶段 | 内容页服务端直出 + 页面级 meta + 站点级文件(robots / sitemap / rss)+ 收录控制 | ✅ 本文 |
| 一阶段 | 数据监测接入(Search Console / GA4 或 Umami) | ✅ 本文(偏配置,少量代码) |
| 二阶段 | 阅读页性能(Core Web Vitals)、站内互链深化、主动推送 | ⏳ 后续 |
| 三阶段 | 变现(AdSense / CPS / 赞助) | ✅ 本文预习(见 5.3,先接 Google AdSense) |
| 四阶段 | GEO(geo:* 元信息 + 可信度建设) |
⏳ 后续 |
重点:先能被抓,才谈得上收录;先被收录,数据才有得看。 所以阶段一、二的技术底座必须先做扎实。
二、核心概念讲解:一阶段要补哪些能力
2.1、八项基础能力总览
SEO 不是一个单点功能,而是一套"内容基础设施"。对博客平台来说,核心就是下面这 8 项能力:
| 能力 | 解决问题 | BlogLoom 要做什么 |
|---|---|---|
| 独立 URL | 每篇文章有稳定地址 | 后端提供 /blog/{id} 内容页 |
<title> |
告诉搜索引擎这页讲什么 | 每页唯一标题(文章标题 + 站点名) |
description |
页面摘要 | 输出 <meta name="description"> |
| canonical | 同一内容多网址时声明首选 | 输出无参数的标准 URL |
| 结构化数据 | 让搜索理解内容类型、作者、时间 | 输出 BlogPosting JSON-LD |
| Open Graph | 分享到社交平台的卡片 | 输出 og:title/description/image/url |
| Sitemap / robots / RSS | 发现、抓取、订阅 | 提供三个站点级文件 |
| 正文直出 | 爬虫能读到正文 | 服务端渲染进首屏 HTML |
2.2、能力与现状对照
那么,BlogLoom 现在到底有哪些、缺哪些?我们对照真实代码看一遍。
| 调研文档要求的能力 | BlogLoom 现状 | 关键代码位置 | 缺口 |
|---|---|---|---|
| 独立 URL | 有 /blog/:id(前端路由),后端无同名内容页 |
blog-view-ui/src/router/index.js:30-35 |
后端无服务端直出页面 |
独立 <title> |
仅靠 JS 改 document.title |
views/blog/Blog.vue:180、views/Index.vue:134 |
首屏 HTML 固定为 BlogLoom |
description |
详情接口已返回,空值时由正文生成摘要 | model/vo/BlogDetail.java;BlogMapper.xml:293-323 |
已补齐详情字段映射 |
| canonical | 无 | — | 全缺 |
| 结构化数据 | 无 | — | 全缺 |
| Open Graph | 无 | — | 全缺 |
| robots / sitemap / rss | 无(均 404) | — | 全缺 |
| 正文直出 | 否(v-html 客户端渲染) |
views/blog/Blog.vue:34 |
首屏无正文 |
| 聚合页可抓取 | 标签/分类/归档均为 SPA | views/tag/Tag.vue 等 |
爬虫读不到 |
| 收录控制 | /cms/、/admin/ 无 noindex |
— | 可能被误收录 |
2.3、核心技术约束(改造前必须知道)
**注意:**下面几条约束会直接决定改造方案,务必先看清楚。
| 序号 | 约束 | 说明 |
|---|---|---|
| 1 | SPA 回退过滤器会"抢"请求 | SpaForwardFilter 以 Integer.MIN_VALUE 顺序拦截所有请求,/blog/1 这类无扩展名 GET HTML 请求会被先转发到 index.html,根本进不了后端 Controller |
| 2 | .xml / .txt 端点不受影响 |
过滤器对"最后一段带扩展名"的请求不回退(SpaForwardConfig.java:85-87),所以 /sitemap.xml、/rss.xml、/robots.txt 可直接由 Controller 提供 |
| 3 | 公开接口全部免鉴权 | SecurityConfig 中 anyRequest().permitAll()(config/SecurityConfig.java:56),新增 SEO 端点默认公开 |
| 4 | 无 slug 字段 |
blog 表及实体均无 slug,路由用数字 id,一阶段可继续用 id |
| 5 | 详情接口字段必须与 SEO 数据流同步 | BlogDetail、BlogMapper.xml:293-323 显式映射封面、摘要、作者信息,避免列表接口有数据而详情接口丢失 |
| 6 | 同源部署 | 生产环境 API 用相对路径(VITE_API_URL=/、/admin/),meta 里的 URL 需用 blog.view 配置拼接真实域名 |
**重点:**约束 1 是最容易被忽略、也最致命的坑。如果不改过滤器,后面写再多 Controller 都不会生效。
三、实现思路:方案选型与总体架构
3.1、服务端渲染的三条路线对比
既然核心问题是"爬虫读不到",那就要让页面在服务端就能输出正文。这里有三条路线,各有取舍。
| 路线 | 做法 | 优点 | 代价 | 适合 |
|---|---|---|---|---|
| 方案一:后端直出 | 后端用 Thymeleaf 渲染 /blog/{id},返回带正文与 meta 的 HTML |
最贴合现有 Spring Boot(项目已依赖 thymeleaf);收录效果最好、最稳 | 详情/列表页要从 SPA 分出来,改后端模板 | 推荐主路线 |
| 方案二:预渲染 / 动态渲染 | 部署时或对爬虫 UA 用无头浏览器渲染后返回 HTML | 前端基本不改,能当过渡 | 需额外服务;内容更新要重渲染;有 cloaking 风险 | 短期过渡 |
| 方案三:迁移 SSR 框架 | 改用 Nuxt / Next 等 SSR 框架 | 体验与 SEO 兼顾 | Vue2 迁移成本大 | 长期重构时 |
弊端说明:
- 方案二对爬虫返回一份内容、对用户返回另一份内容,属于"动态渲染"。Google 已明确表示动态渲染只是过渡方案,长期仍应使用服务端渲染或静态生成,且处理不当可能被判定为 cloaking。
- 方案三虽然最优雅,但要重写整个前端,对本项目(Vue2)来说一阶段成本过高,不划算。
3.2、为什么选后端 Thymeleaf 直出
那么,我们的选择是什么?直接采用方案一,并且不做 UA 嗅探。
理由有三:
- 零新增依赖:
spring-boot-starter-thymeleaf已经在pom.xml:120-124,目前只用来发邮件,能力现成。 - 收录最稳:内容页对读者和爬虫返回同一份服务端渲染 HTML,符合搜索引擎规范。
- 改动可控:只需把"需要被收录的页面"交给后端,后台管理(
blog-cms-ui)、登录等继续用 SPA 即可。
重点:内容页对读者和爬虫返回同一份 HTML,绝不能分成两份,否则就有 cloaking 风险。
3.3、目标请求链路
改造后,一个请求会这样流动:
浏览器 / 爬虫
   │
   ├─ GET /blog/513
   │        ↓
   │   SpaForwardFilter:命中"服务端直出放行名单" → 不转发
   │        ↓
   │   SeoPageController.getBlogPage():查库 → 注入 model
   │        ↓
   │   Thymeleaf 渲染 seo/blog.html(首屏含正文 + title/description/canonical/OG/JSON-LD)
   │        ↓
   │   爬虫拿到完整 HTML;读者看到文章(可嵌入评论等轻交互)
   │
   ├─ GET /sitemap.xml   → SeoFileController(produces=application/xml)
   ├─ GET /rss.xml       → SeoFileController
   └─ GET /robots.txt    → SeoFileController(text/plain)
3.4、新增代码结构
统一约定:后续所有 SEO 相关代码,全部放在 blog-backend/src/main/java/com/changlu/blogloom/module 下的独立 seo 模块中,与现有 module/column、module/knowledge 保持一致的 api / service / domain / support 分层,不再散落到顶层 controller、service、model 等包。
blog-backend/src/main/java/com/changlu/blogloom/module/seo/
├── api/                               # 接口层(Controller,对外提供 HTTP / 视图)
│   ├── SeoConfigController.java       # 后台 SEO 配置(GET/POST /admin/seo/config)✅ 已落地
│   ├── SeoVerificationController.java # 后台 SEO 平台关联(GET/POST /admin/seo/verification)✅ 已落地
│   ├── SpaIndexController.java        # SPA 入口注入站点验证 meta(方案 B)✅ 已落地
│   ├── SeoPageController.java         # 内容页直出(@Controller,返回 Thymeleaf 视图)
│   └── SeoFileController.java         # robots / sitemap / rss(@RestController,产出文本/XML)
├── service/                           # 业务层
│   ├── SeoMetaService.java            # 组装页面 SEO 元数据(title/description/canonical/og/ldJson)
│   ├── SitemapService.java            # 生成 sitemap.xml
│   └── RssService.java                # 生成 rss.xml
├── domain/                            # 领域模型
│   ├── SeoConfig.java                 # 后台 SEO 配置载体(seoDomain 等)✅ 已落地
│   ├── SeoVerification.java           # 站点验证载体(baidu/bing/google)✅ 已落地
│   └── SeoMeta.java                   # 公共 meta 载体(title/description/canonical/og/ldJson)
├── support/                           # 辅助工具
│   ├── SeoUrlResolver.java            # 统一 canonical / 绝对 URL 拼接(读后台 seoDomain,兜底 blog.view)
│   └── SeoMetaBuilder.java            # BlogDetail → SeoMeta
└── dao/                               # 如插件需要独立查询(可选)

blog-backend/src/main/resources/templates/seo/   # Thymeleaf 模板仍放 resources 下
├── layout.html                        # 公共骨架(header/footer)
├── blog.html                          # 文章详情页
├── list.html                          # 列表/标签/分类/归档通用页
└── fragments/
    └── seo-head.html                  # title/description/canonical/og/JSON-LD 片段
为什么这样归类:
| 原因 | 说明 |
|---|---|
| 与现有架构一致 | column、knowledge 都是 api/dao/domain/service/support,SEO 沿用同一套分层,降低理解成本 |
| 职责内聚 | SEO 的控制器、业务、模型、工具都收在 module/seo 一处,便于查找与维护 |
| 便于演进 | 后续加 SEO 后台配置(F15)、站点设置等,都继续往 module/seo 里加,不污染其它模块 |
| 模板例外 | Thymeleaf 按约定从 classpath:/templates/ 解析,故模板放在 resources/templates/seo/,不放 java 包内 |
一句话:Java 代码进
module/seo,模板进resources/templates/seo。
3.5、数据流:一次建模、全站复用
**重点:**所有 meta 都从文章数据这一份源头产生,模板里不写死任何标题或描述。
blog 表(已有字段)
   ├─ title        → <title> / og:title / JSON-LD headline
   ├─ description  → meta description / og:description
   ├─ first_picture→ og:image / JSON-LD image
   ├─ create_time  → article:published_time / datePublished
   ├─ update_time  → article:modified_time / dateModified / sitemap lastmod
   ├─ category     → article:section / 分类聚合页
   ├─ tags         → article:tag / 标签聚合页
   └─ id           → canonical / og:url / sitemap loc
三条原则贯穿全文:
- 数据驱动模板:文章数据 → 一个公共模板片段 → 生成全部 meta,不硬编码、不落字段。
- 服务端直出:正文和 meta 都在首屏 HTML 里,不依赖 JavaScript。
- 一次建模、全站复用:
title / summary / cover / 时间 / 标签在数据库定一次,详情页、Sitemap、RSS、OG 共用。
四、核心功能点需求梳理
4.1、优先级总表
改造不能一锅端,要有优先级。下面把 14 项功能点按"优化类型"拆成 6 组,逐组列出核心优化点(核心改在哪里)、目标与验收标准。
第一组:内容直出与数据地基(P0)
| 编号 | 功能点 | 优先级 | 核心优化点(改在哪里) | 目标 | 验收标准 |
|---|---|---|---|---|---|
| F1 | 数据层补齐 | P0 | BlogDetail VO 增加字段 + BlogMapper.xml 详情查询补列并 join 作者 |
让详情数据能支撑全部 meta | BlogDetail 返回 firstPicture、description、作者 |
| F2 | 文章详情页服务端直出 | P0 | 新增 SeoPageController + 修改 SpaForwardConfig 放行 + Thymeleaf 模板 seo/blog.html |
curl /blog/{id} 拿到正文 + 正确 title |
禁用 JS 后正文与 meta 仍在源码中 |
第二组:页面级 SEO 元信息(P0)
| 编号 | 功能点 | 优先级 | 核心优化点(改在哪里) | 目标 | 验收标准 |
|---|---|---|---|---|---|
| F3 | 页面级 SEO meta | P0 | 公共片段 templates/seo/fragments/seo-head.html 输出 title / description |
title / description | 每页唯一 title;description 非空 |
| F4 | canonical 与 URL 策略 | P0 | SeoUrlResolver 统一拼接绝对 URL(读 blog.view) |
同一内容声明首选网址 | canonical 指向无参数标准 URL |
| F5 | 结构化数据 JSON-LD | P0 | SeoMetaBuilder 生成 BlogPosting,在 seo-head.html 输出 |
BlogPosting 让搜索理解文章 |
富媒体测试工具校验通过 |
| F6 | Open Graph | P0 | seo-head.html 内的 og:* 与 article:* 标签 |
分享卡片正确 | 微信/QQ/Slack 分享出现标题+摘要+封面 |
第三组:站点级收录文件(P0)
| 编号 | 功能点 | 优先级 | 核心优化点(改在哪里) | 目标 | 验收标准 |
|---|---|---|---|---|---|
| F7 | robots.txt | P0 | 新增 SeoFileController.robots() |
提供抓取规则并声明 Sitemap | /robots.txt 200,含 Sitemap 行 |
| F8 | sitemap.xml | P0 | SeoFileController.sitemap() + 公开文章查询 |
列出全部公开文章 | /sitemap.xml 200,仅含公开已发布文章 |
| F9 | RSS/Atom 订阅 | P1 | SeoFileController.rss() |
读者可订阅、阅读器可发现 | /rss.xml 200,HTML 中有 <link rel="alternate"> |
第四组:聚合页可抓取(P1)
| 编号 | 功能点 | 优先级 | 核心优化点(改在哪里) | 目标 | 验收标准 |
|---|---|---|---|---|---|
| F10 | 聚合页可抓取 | P1 | SeoPageController 复用通用模板 seo/list.html |
列表/标签/分类/归档页直出 | curl /tag/{name} 能看到文章列表 |
第五组:收录控制与数据监测(P1)
| 编号 | 功能点 | 优先级 | 核心优化点(改在哪里) | 目标 | 验收标准 |
|---|---|---|---|---|---|
| F11 | 收录控制 | P1 | blog-cms-ui/index.html 加 noindex + /cms、/admin 响应头 X-Robots-Tag |
防止后台被收录 | /cms/ 与 /admin/ 输出 noindex |
| F12 | 数据监测接入 | P1 | Search Console + GA4 统计脚本注入公共片段 | 能看收录与流量 | Search Console 验证成功;GA4 有数据 |
| F15 | SEO 后台配置支持 | P1 | 后台站点设置新增 SEO 域名(seoDomain)、GA4 统计脚本、事件上报开关;后端按配置注入;(5.3 扩展) AdSense 发布商 ID 与广告位配置 |
SEO 域名 / 统计脚本 / 事件上报 / 广告配置均可后台配置 | 后台填 SEO 域名即用于 canonical/sitemap;填 GA4 ID 即生效;填 AdSense ID 即注入广告;开关控制事件上报 |
第六组:加速与性能优化(P2)
| 编号 | 功能点 | 优先级 | 核心优化点(改在哪里) | 目标 | 验收标准 |
|---|---|---|---|---|---|
| F13 | 主动推送(可选) | P2 | 接入百度 push.js / 必应 IndexNow |
加速收录 | 百度/必应推送有成功记录 |
| F14 | 阅读页性能 | P2 | 正文图片懒加载 + index.html 第三方脚本异步 |
LCP/CLS 达标 | 图片懒加载、第三方脚本异步 |
4.2、一阶段最小闭环
那么,哪些是必须先做的?答案是:
F1 + F2 + F3 + F4 + F5 + F6 + F7 + F8
做完这八项,就能让爬虫读到内容并提交收录。F9~F12、F15 紧随其后,F13、F14 作为收尾优化。
4.3、核心功能实现原理与改造要点
前面 4.1、4.2 讲的是"要做什么",这一节讲"为什么这么做、底层到底怎么跑、真正动手时重点在哪"。理解了原理,第五章的代码才不是照抄——遇到问题时也知道该改哪一环。
4.3.1、爬虫读不到的本质:CSR 与 SSR 的渲染差异
实现原理:
网页正文有两条产出路径:
| 渲染方式 | 正文在哪里生成 | 爬虫何时能看到 |
|---|---|---|
| CSR(客户端渲染) | 浏览器下载 JS 后,由 JS 调接口、再把数据塞进 DOM | 必须执行完 JS 才看得到 |
| SSR(服务端渲染) | 服务器直接把数据和模板拼成完整 HTML 返回 | 打开响应源码就能看到 |
BlogLoom 是典型的 CSR。真实流程如下:
爬虫 GET /blog/513
   ↓
到时返回 static/view/index.html(空壳,<title>BlogLoom</title>,<div id="app"></div>)
   ↓
(爬虫通常不执行 JS,流程到此为止 → 空壳)
   ↓ 若是浏览器
下载并执行 JS → Vue 挂载 → axios 调 GET /blog?id=513 → 拿到 JSON → v-html 渲染 → document.title 改标题
重点:问题不在数据,而在数据出现在哪一层。接口 GET /blog?id=513 返回的 JSON 里正文是完整的(BlogController.java:62-97 返回 Result(BlogDetail)),只是它没被拼进首屏 HTML。
如何优化改造:
把"需要被收录的页面"从 CSR 切成 SSR——由后端 @Controller + Thymeleaf 把 BlogDetail 直接渲染进 HTML 首屏。这样爬虫拿到的就是完整正文,与是否执行 JS 无关。
用例对比(输入相同,输出不同):
- 输入:
GET /blog/513,请求头Accept: text/html - 改造前输出(CSR 空壳):
<head><title>BlogLoom</title></head>
<body><div id="app"></div></body>
- 改造后输出(SSR 直出):
<head>
  <title>Java基础学习笔记 09、IO流 - BlogLoom</title>
  <meta name="description" content="从 File 类入手,系统讲解 IO 流……">
</head>
<body>
  <h1>Java基础学习笔记 09、IO流</h1>
  <div class="content">……完整正文……</div>
</body>
同一个输入,一个输出里没有正文,一个首屏就是完整文章——这就是收录成败的分水岭。
4.3.2、服务端直出:请求生命周期与 SPA 回退冲突
实现原理:
同一个请求在 Spring Boot 里可能经过三道关,顺序决定成败:
HTTP 请求
   ↓ ① Servlet Filter(顺序 = Integer.MIN_VALUE,最先执行)
SpaForwardFilter:命中规则则 forward 到 /index.html
   ↓ ② DispatcherServlet 路由
@Controller 映射(SeoPageController)
   ↓ ③ 视图解析
ThymeleafViewResolver → 渲染 templates/seo/blog.html
关键冲突(必须理解):
SpaForwardConfig 的过滤器先于 Controller 执行,它对"GET + Accept 含 text/html + 路径无扩展名"的请求一律转发到 index.html(SpaForwardConfig.java:71-88)。也就是说——如果不动它,/blog/513 永远到不了我们新写的 Controller,SeoPageController 只是摆设。
改造要点(三点):
- 增加"服务端直出放行名单"(
SSR_PREFIXES),命中即return false不转发,把请求交回 Controller。 - 放行判定仍要保留"仅 HTML 导航"的约束:只放行
Accept: text/html、无扩展名的 GET,避免误伤/blogs、/blog?id=等 JSON 接口。 - 带扩展名的路径(
sitemap.xml/rss.xml/robots.txt)本身就不会被回退,可直接由 Controller 命中,无需进放行名单。
**重点:**这是整个改造的"总闸"。顺序错了,后面所有页面直出都不会生效。
用例对比(三类请求的输入 → 输出):
| 输入请求 | 改造前输出 | 改造后输出 |
|---|---|---|
GET /blog/513(Accept: text/html) |
被 forward 到 index.html 空壳 |
SeoPageController 渲染的完整文章 HTML |
GET /blog?id=513(Accept: application/json) |
Result(BlogDetail) JSON |
不变,仍是 JSON(接口不受影响) |
GET /sitemap.xml(带扩展名) |
不由过滤器处理 | 直接命中 SeoFileController 输出 XML |
关键点:放行名单只接管"HTML 导航"这一类请求,接口 JSON 与站点级文件都不受影响。
4.3.3、元信息数据流:从数据库到 <head>
实现原理:
title / description / canonical / OG / JSON-LD 都写在 HTML 的 <head> 里,搜索引擎只解析响应的 HTML 源码,不执行 JS(尤其百度、必应对 JS 支持弱)。因此元信息必须在服务端就生成好。
数据流如下(一次建模、全站复用):
blog 表
  ├─ title / description / first_picture / create_time / update_time
  ├─ category / tags / user_id
  ↓ BlogMapper.xml(详情查询,需补列 + join 作者)
BlogDetail(VO,需补 firstPicture / description / author)
  ↓ SeoMetaBuilder(+ SeoUrlResolver 拼绝对 URL、拼 webTitleSuffix 后缀)
SeoMeta(title / description / canonicalUrl / image / publishedTime / ...)
  ↓ Thymeleaf 公共片段 seo-head.html
HTML <head>
canonical 的原理:同一篇文章可能有多个 URL(/blog/513、?utm_source=xx、?from=home)。rel="canonical" 是在告诉搜索引擎"这一堆地址对应的首选版本是哪个",从而合并重复内容的权重信号。它只是"信号",不会让浏览器跳转,也不保证引擎一定采纳。
改造要点:
- 详情接口
BlogDetail必须带齐firstPicture、description、authorName、authorAvatar。SQL 虽然查询了这些列,但blogDetailresultMap 仍要显式映射,否则可能出现“文章列表有封面、详情接口封面为 null”,进而导致og:image不输出。 - 域名不能硬编码,统一由
SeoUrlResolver取后台 SEO 域名seoDomain(兜底blog.view)拼接绝对 URL,保证 canonical /og:url/ sitemaploc三者一致。 title后缀复用站点配置webTitleSuffix,与现有document.title逻辑保持同源。
用例(输入一篇文章数据 → 输出 head 元信息):
输入(blog 表一行):
id=513
title=Java基础学习笔记 09、IO流
description=从 File 类入手,系统讲解 IO 流……
first_picture=https://pictured-bed.oss-cn-beijing.aliyuncs.com/cover/513.png
create_time=2026-10-01 10:00:00
update_time=2026-10-02 12:00:00
category=Java
tags=[Java, IO流]
author=长路
输出(渲染进 <head>):
<title>Java基础学习笔记 09、IO流 - BlogLoom</title>
<meta name="description" content="从 File 类入手,系统讲解 IO 流……">
<link rel="canonical" href="https://blog.changlu.cloud/blog/513">
<meta property="og:image" content="https://pictured-bed.oss-cn-beijing.aliyuncs.com/cover/513.png">
<meta property="og:url" content="https://blog.changlu.cloud/blog/513">
**canonical 用例:**访问 /blog/513?utm_source=csdn&from=home,输出里的 canonical 仍是干净的 https://blog.changlu.cloud/blog/513。
4.3.4、结构化数据(JSON-LD)的生成原理
实现原理:
结构化数据 = 用搜索引擎能懂的统一词汇(Schema.org)描述内容。JSON-LD 是最被推荐的承载格式,放在 <script type="application/ld+json"> 里。搜索引擎解析后,知道"这是一篇 BlogPosting,作者是谁、什么时候发布/修改、讲什么",从而更好地理解内容、并可能展示富媒体结果。
生成流程:
BlogDetail
  ↓ SeoMetaBuilder 用 Jackson ObjectMapper 组装 ObjectNode
{ "@context": "...", "@type": "BlogPosting", "headline": ..., "author": ..., "datePublished": ... }
  ↓ ObjectMapper.writeValueAsString 序列化(避免手拼转义)
  ↓ 注入 seo-head.html 的 <script type="application/ld+json">
重点:
- 用
ObjectMapper序列化,不要手工字符串拼接 JSON(引号/中文/HTML 转义极易出错)。 dateModified必须取真实的update_time,不能每次刷新时间假装有更新;信息也要与页面可见内容一致。@type选BlogPosting(schema.org里BlogPosting是Article的子类型)。
用例(输入 BlogDetail → 输出 JSON-LD):
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Java基础学习笔记 09、IO流",
  "description": "从 File 类入手,系统讲解 IO 流……",
  "image": "https://pictured-bed.oss-cn-beijing.aliyuncs.com/cover/513.png",
  "datePublished": "2026-10-01T10:00:00+08:00",
  "dateModified": "2026-10-02T12:00:00+08:00",
  "inLanguage": "zh-CN",
  "keywords": ["Java", "IO流"],
  "author": { "@type": "Person", "name": "长路" },
  "mainEntityOfPage": "https://blog.changlu.cloud/blog/513"
}
</script>
校验方式:把这段贴进 Google 富媒体结果测试工具 / Schema 校验器,应无错误。
4.3.5、站点级文件(robots / sitemap / rss)的协议原理
实现原理与流程:
| 文件 | 依据协议 | 作用 | 生成/更新时机 |
|---|---|---|---|
robots.txt |
RFC 9309 | 告诉爬虫哪些路径可抓 | 站点级,基本固定 |
sitemap.xml |
Sitemaps.org 协议 | 列出公开页面,辅助发现抓取 | 发布/修改/删除文章后应同步 |
rss.xml |
RSS 2.0 | 供读者/聚合器订阅 | 发布新文章时更新(输出最近约 20 篇) |
BlogLoom 侧的关键机制:
- 三者都是带扩展名的路径,
SpaForwardFilter不会回退它们,所以可由SeoFileController直接产出(produces分别设text/plain/application/xml/application/rss+xml)。 sitemap.xml必须动态生成:从blog表查is_published=1 and is_deleted=0 and password 为空,与 canonical 用同一套 URL 规则。rss.xml由文章页<link rel="alternate" type="application/rss+xml">声明自动发现(写进公共片段即可)。
改造要点:
- 不要在 robots 里
Disallow: /blog——BlogLoom 接口与内容页都在根路径,会误屏蔽文章。 - 私密/草稿/密码文章一律不进 sitemap 与 rss,但这只是"不主动暴露",真正的保护仍靠鉴权。
lastmod用真实update_time;sitemaploc与 canonical 完全一致。
用例(三个端点各自的输入 → 输出):
GET /sitemap.xml(输入:无参):
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://blog.changlu.cloud/blog/513</loc>
    <lastmod>2026-10-02</lastmod>
  </url>
  <!-- ……其余公开文章,草稿/私密/密码文章不出现 …… -->
</urlset>
GET /robots.txt(输入:无参):
User-agent: *
Disallow: /admin/
Disallow: /cms/
Disallow: /login
Allow: /

Sitemap: https://blog.changlu.cloud/sitemap.xml
GET /rss.xml(输入:无参,取最近约 20 篇公开文章):
<?xml version="1.0" encoding="UTF-8"?>
<rss version="2.0">
  <channel>
    <title>长路的博客</title>
    <link>https://blog.changlu.cloud</link>
    <item>
      <title>Java基础学习笔记 09、IO流</title>
      <link>https://blog.changlu.cloud/blog/513</link>
      <guid>https://blog.changlu.cloud/blog/513</guid>
      <pubDate>Thu, 01 Oct 2026 10:00:00 +0800</pubDate>
      <description>从 File 类入手,系统讲解 IO 流……</description>
    </item>
  </channel>
</rss>
Sitemap 的规模与上限(BlogLoom 几百篇无需担心):
Sitemaps 协议对单个 sitemap 文件有两条硬限制:
| 限制 | 上限 | 未超限 | 超过时 |
|---|---|---|---|
| URL 条数 | 50,000 条 | 一个 sitemap.xml 全量列出 |
拆成多个子 sitemap,再用 sitemapindex 汇总 |
| 文件大小 | 未压缩 50MB | 同上 | 同上 |
BlogLoom 当前规模(五六百篇):
- 数量:约 500~600 条 URL,远低于 5 万上限。
- 体积:每条
<url>约 100 字节,整份约几十 KB,远低于 50MB。 - 结论:单个
sitemap.xml全量输出即可,无需分页、无需sitemapindex。
当前实现的范围(与 5.1.3.2 一致):
- 包含:
/home、/archives两个静态页 + 全部公开文章(is_published=1 and is_deleted=0 and password 为空)。 - 排除:草稿、回收站、密码保护文章。
- 暂未加入(可选增强):
/tag/{name}、/category/{name}、/column/{id}等聚合页。
**优化建议(非必须):**sitemap 实际只用到 id 与 update_time,可为它单独用一个更轻的查询(当前 SeoArticleMapper 顺带 select 了 title/description/first_picture);几百篇下可忽略,数据量上万时再考虑裁剪列或加缓存。
4.3.6、抓取与收录:收录控制的原理与搜索引擎流程
先分清两个概念(最重要):
| 指令 | 作用 | 写在哪里 | 前提 |
|---|---|---|---|
Disallow |
阻止抓取 | robots.txt |
— |
noindex |
阻止收录 | 页面 <meta name="robots"> 或响应头 X-Robots-Tag |
必须先允许抓取,引擎才读得到 |
原理:搜索引擎读不读得到 noindex,取决于它能不能抓取这个页面。所以对一个既能抓又不该被收录的页面(比如 /cms/ 后台),正确做法是"允许抓取 + 页面输出 noindex";如果又 Disallow 又指望它读 noindex,逻辑上是矛盾的。
搜索引擎收录的完整流程(以 Google 为主):
① 发现:站内链接 / 外链 / Sitemap / 手动提交 URL
   ↓
② 抓取:Googlebot 按抓取预算取回 HTML
   ↓
③ 渲染:Googlebot 用 Chromium 渲染 JS(有排队延迟,非实时)
   ↓
④ 索引:内容质量、重复度、canonical、noindex 综合判定
   ↓
⑤ 展示/排名:用户搜索时排序展示
重点:Google 会渲染 JS,但渲染是延迟的、有预算的;百度、必应对 JS 渲染支持更弱。所以依赖 CSR"等 Googlebot 渲染"并不可靠——服务端直出能让流程在第 ② 步就拿到正文,收录更快更稳。
如何推动与监测收录(按搜索引擎分开说明):
三个主流引擎的官方入口与提交方式如下:
| 搜索引擎 | 官方平台(入口网址) | 提交 / 推送方式 | 关键说明 |
|---|---|---|---|
| Search Console | ① 提交 sitemap.xml;② "网址检查 → 请求编入索引" |
无开放的主动推送 API,也不采用 IndexNow;靠 Sitemap + 内链 + 手动请求 | |
| 百度 | 百度搜索资源平台 | ① 手动提交;② API 主动推送;③ push.js 自动推送;④ 提交 Sitemap |
国内收录主战场,push.js 让访客浏览即自动推送 |
| Bing | Bing Webmaster Tools | ① 提交 sitemap.xml;② IndexNow 主动推送;③ 手动提交 URL |
IndexNow 一次提交,Bing / Yandex 等多平台共享 |
① Google:
- 在 Search Console 用 DNS TXT 验证 → 提交
sitemap.xml→ 新文章用"网址检查"请求编入索引。 - 注意:Google 已停用 sitemap ping 端点,也不支持 IndexNow,所以别指望"推送 API";Sitemap + 站内内链 + Search Console 手动请求才是正道。
② 百度:
- 在百度搜索资源平台验证站点后,可用三种提交方式:
- 手动提交:后台逐个粘贴 URL(适合少量);
- API 主动推送:发布文章时服务端 POST 到推送接口(最快、最实时);
- 自动推送
push.js:页面被访问时自动推送(接入最省事)。
<!-- 百度自动推送:放进公共 head 片段或 blog-view-ui/index.html -->
<script src="https://zz.bdstatic.com/linksubmit/push.js"></script>
③ Bing:
- 在 Bing Webmaster Tools 验证站点 → 提交
sitemap.xml。 - 接入 IndexNow:在站点根目录放一个
<你的key>.txt(内容即 key),发布文章时 POST 到 IndexNow 接口:
POST https://api.indexnow.org/indexnow
{
  "host": "blog.changlu.cloud",
  "key": "你的key",
  "keyLocation": "https://blog.changlu.cloud/你的key.txt",
  "urlList": ["https://blog.changlu.cloud/blog/513"]
}
通用建议:
- 三个引擎都先提交 Sitemap——这是覆盖面最广的"发现"入口。
- 服务端直出后,
/blog/{id}源码即有正文,收录更快更稳。 - 读懂"已发现 / 已抓取 - 尚未编入索引"等状态,多数是时效与权重问题,别盲目改代码。
用例对比(谁能被抓、谁能被收录):
| 输入 | 响应头 / HTML 输出 | 结果 |
|---|---|---|
GET /cms/ |
头:X-Robots-Tag: noindex, nofollow;HTML:<meta name="robots" content="noindex, nofollow"> |
可抓取,但不收录 |
GET /admin/... |
robots.txt 中已 Disallow;接口返回 401/JSON |
不抓取(后台本身需鉴权) |
GET /blog/513 |
无 noindex,canonical 指向自身 |
可抓取、可收录 |
记住:
Disallow挡的是"抓取",noindex挡的是"收录";想让引擎读到noindex,就必须先让它抓得到。
4.3.7、数据监测原理
实现原理:
| 平台 | 数据从哪来 | 能回答什么 |
|---|---|---|
| Search Console | Google 自己抓取/索引/搜索日志 | 收录状态、搜索词、展示/点击/CTR/排名 |
| GA4 / Umami | 页面里统计脚本上报的事件与访问 | 访客、PV、来源、热门文章、事件(GitHub 点击等) |
改造要点:
- 统计脚本要同时覆盖服务端直出页和 SPA 页(两处各一份,否则会漏记);推荐用 F15 后台配置统一注入(见 4.3.8)。
- 脚本一律
async,不阻塞首屏。 - 业务动作(GitHub 入口、订阅入口点击)需要显式埋点事件,GA4 不会自动识别。
用例(输入事件 → 输出报表):
| 用户动作(输入) | 埋点代码 | GA4 中的输出 |
|---|---|---|
访问 /blog/513 |
页面加载自动上报 | 实时报表出现 1 次网页浏览,热门文章 +1 |
| 点击 GitHub 入口 | gtag('event','click_github',{...}) |
事件 click_github 计数 +1,可按来源拆分 |
| 点击 RSS 订阅 | gtag('event','click_rss',{...}) |
事件 click_rss 计数 +1 |
4.3.8、SEO 后台配置(统计脚本 / 事件上报)的实现原理
实现原理:
把"注入统计脚本""开启事件上报"从硬编码改为配置驱动:后台把 GA4 ID、开关等存进站点配置(复用现有 SiteSetting),后端渲染时按配置决定要不要输出脚本,前端按开关决定要不要上报事件。本质和 4.3.3 一样——配置即数据,模板按数据决策。
数据流:
后台站点设置页
  ├─ gaMeasurementId = G-XXXXXXX
  └─ enableEventTracking = true
        ↓ 保存到 site_setting 表
后端 SiteSettingService / SeoMetaBuilder 读取
        ↓ 注入 model / GET /site 返回 siteInfo
  ├─ 服务端直出页:seo-head.html 用 th:if 条件渲染 <script>
  └─ SPA:main.js 读 siteInfo 动态注入 <script>
        ↓
enableEventTracking 决定 trackEvent() 是否真正上报
改造要点:
- 新增配置项尽量复用现有
SiteSetting机制,不必新建表。 - 服务端直出页用
th:if判断:ID 为空则不输出,避免注入空 ID 的无效脚本。 - SPA 不要把脚本写死进静态
index.html,改为运行时读GET /site动态注入,才能做到"改配置不重新构建"。 - 事件上报统一走
trackEvent()入口,受开关控制。
用例(后台配置 → 前台行为):
| 后台配置(输入) | 前台输出(结果) |
|---|---|
GA4 ID = G-XXXXXXX,开关 = true |
页面源码出现 GA4 脚本;点击 GitHub / RSS 上报事件 |
| GA4 ID = 空 | 不输出任何统计脚本 |
开关 = false |
脚本仍在,但 trackEvent() 直接 return,不上报事件 |
4.3.9、阅读页性能优化的原理
实现原理:
Core Web Vitals 的三大指标,各自对应一类浏览器行为:
| 指标 | 衡量什么 | 主要受什么影响 |
|---|---|---|
| LCP | 首屏主内容出现时间 | 首屏资源是否阻塞、封面图是否过大 |
| INP | 交互响应是否及时 | 同步长脚本是否占满主线程 |
| CLS | 布局是否意外偏移 | 图片/广告是否预留了尺寸 |
优化手法与原理:
- 图片懒加载(
loading="lazy"):非首屏图片延后加载,减少首屏带宽竞争;而首屏封面反而要fetchpriority="high"提前加载。 - 预留尺寸(
width/height或aspect-ratio):浏览器提前知道占位,加载后不回顶,降低 CLS。 - 脚本异步(
defer/async/ 按需import()):不阻塞 HTML 解析与首屏渲染,改善 LCP / INP。
用例(写法 → 指标表现):
| 输入(写法) | 输出(体验 / 指标) |
|---|---|
正文 <img loading="lazy" width height> |
不抢首屏带宽,加载后不抖动(CLS 低) |
首屏封面 <img fetchpriority="high"> |
主内容更快出现(LCP 低) |
<script defer src="tocbot"> |
不阻塞首屏(LCP / INP 改善) |
**一句话理解本节:SEO 的所有工作,本质是让内容在爬虫不经 JS 就能理解的层(HTML 源码 + 站点级文件 + 协议信号)**里完整呈现;BlogLoom 的改造重点,就是打通"数据库 → 服务端直出 → head/站点文件"这条链路,并绕开 SPA 回退这个总闸。
4.4、广告接入需求与原理分析(Google AdSense)
本节定位:广告属于 1.4 提到的三阶段(变现),不在"收录最小闭环"里,但 AdSense 审核依赖一阶段产出的"可抓取内容 + sitemap + 隐私政策 + 清晰结构",所以在此做需求与原理分析。本节只讲"为什么、是什么、有哪些规范与红线";具体代码与申请步骤见 5.3。
4.4.1、为什么先接 Google AdSense
广告平台有很多:Google AdSense、国内联盟(如百度联盟)、CPS 带货、品牌赞助……为什么第一阶段只选 Google AdSense?
| 选择 | 门槛 | 与博客的匹配度 | 结算 | 结论 |
|---|---|---|---|---|
| Google AdSense | 有网站即可申请,需内容审核 | 与"原创技术博客"高度契合,自动匹配技术/工具类广告 | 满 100 美元电汇,国内可用 | 首选 |
| 国内广告联盟 | 多要求备案、流量门槛高 | 个人站一般达不到 | 人民币,门槛不一 | 后续可选 |
| CPS / 带货 | 需选品、写推广文 | 会稀释内容调性 | 佣金制 | 不强求 |
| 品牌赞助 | 需议价、接洽 | 依赖流量 | 一单一议 | 有流量后再说 |
**核心判断:**AdSense 是"接入成本最低、对内容破坏最小、又能覆盖全球技术流量"的起步方案。先把 AdSense 跑通,就等于验证了"内容 → 流量 → 收益"这条路是通的。
重点:AdSense 不是"申请了就批"。它有一套内容与合规红线(见 4.4.6),其中很大一部分(隐私政策、可抓取、sitemap、站点结构清晰)正是本阶段 5.1 已经做完的事。换句话说:SEO 改造做扎实,AdSense 过审会顺很多。
4.4.2、AdSense 工作原理与关键概念
在写代码前,先把概念理清,否则会"代码贴了,广告却不显示"。
① 三样东西:AdSense 代码、广告单元、自动广告。
| 概念 | 英文 | 作用 | 放在哪 |
|---|---|---|---|
| AdSense 代码(加载器) | AdSense code / adsbygoogle.js | 加载 AdSense SDK,是所有广告的基础脚本 | 每个页面的 <head> |
| 广告单元 | Ad unit | 一个具体的广告位,带唯一 data-ad-slot |
页面正文里,用 <ins class="adsbygoogle"> 占位 |
| 自动广告 | Auto ads | 由 Google 自动决定在页面哪里插广告 | 只要加载器在,Google 自己插 |
官方说明:"要把 AdSense 代码放在每个页面的 <head> 和 </head> 之间",才能覆盖全站、让 Auto ads 生效(About the AdSense code)。
**关键更新:**官方已说明 Auto ads 现在可以通过任意 AdSense 广告单元代码生效,不再强制要求单独粘贴 Auto ads 代码——只放一个"广告单元"代码,也能吃到 Auto ads 的自动投放。
② 加载器与广告单元的代码形态。
<!-- 加载器:放在 <head> 里,ca-pub-XXXXXXXXXXXXXXXX 换成你的发布商 ID -->
<script async
  src="https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=ca-pub-XXXXXXXXXXXXXXXX"
  crossorigin="anonymous"></script>
<!-- 自适应广告单元:data-ad-client 是发布商 ID,data-ad-slot 是该广告位 ID -->
<ins class="adsbygoogle"
     style="display:block"
     data-ad-client="ca-pub-XXXXXXXXXXXXXXXX"
     data-ad-slot="1234567890"
     data-ad-format="auto"
     data-full-width-responsive="true"></ins>
<script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
参数含义(官方 自适应广告代码参数):
| 参数 | 含义 | 取值 |
|---|---|---|
data-ad-client |
发布商 ID | ca-pub-… |
data-ad-slot |
广告单元 ID | 数字串 |
data-ad-format |
大体形状(桌面) | auto / rectangle / horizontal / vertical |
data-full-width-responsive |
移动端是否全宽展开 | true(官方推荐)/ false |
重点:
- 加载器只需一次(
<head>),每出现一个<ins>广告位,就要紧跟一次push({});少 push 不显示,多 push 会报错。 - 自适应广告的父容器要有稳定宽度;父容器为
width:auto或运行时才算宽,可能出现移动端布局异常。
⑤ 到底配几个 slot?只配 1 个行不行?和 Auto ads 是什么关系?
这是接入时最常问的问题,先把三者关系理清:
| 东西 | 作用 | 是否必需 |
|---|---|---|
加载器(client) |
总开关;Auto ads 靠它生效 | 必需(配了才有广告) |
slot(<ins>) |
你指定"这里放一个广告单元"(手动位) | 可选,0~N 个 |
| Auto ads | Google 自动在页面插入广告 | 由加载器决定,可开关 |
结论:
- 可以只配 1 个 slot,也可以配多个,甚至 0 个。数量完全由你定。
- 只配 1 个 slot 不影响 Auto ads:官方已说明 Auto ads 通过任意一个广告单元代码即可生效,不强制多配。
- 因此"只配 1 个"的实际效果 = 1 个你指定的手动位 + Google 自动补位;"0 个"则 = 纯靠 Auto ads。
| 你的配置 | 页面效果 |
|---|---|
| 0 个 slot + 开 Auto ads | 没有任何手动位,全由 Google 自动插广告 |
| 1 个 slot + 开 Auto ads | 1 个手动位(如文章顶部)+ Google 自动补位(推荐起步) |
| 多个 slot | 每个想精确控制的位置各配一个手动位 + Auto ads 补位 |
建议:起步就只配 1 个(文章顶部
articleTop),把加载器(client)放上去、其余交给 Auto ads。等有数据、想精确调 CTR 时,再往slots里加第二条——不用改代码、不用重新部署。
③ ads.txt:站点级"授权售卖"文件。
ads.txt 是 IAB Tech Lab 规范(官方说明):非强制,但不放会损失部分预算——很多广告主只对"已验证 ads.txt"的广告请求出价。文件放域名根目录,内容一行:
google.com, pub-0000000000000000, DIRECT, f08c47fec0942fa0
pub-0000000000000000是发布商 ID(去掉ca-前缀);f08c47fec0942fa0是 Google 固定认证标识。这与本项目robots/sitemap/rss的站点级文件机制同构(见 5.1.3)。
④ 站点验证:代码 或 meta 标签 二选一。
| 方式 | 做法 | 适用 |
|---|---|---|
| AdSense 代码 | 把加载器代码放进首页 <head> |
首页就要展示广告的常规站 |
| meta 标签 | 在首页 <head> 放一段验证 meta |
不想在首页放广告时(官方新增) |
官方(站点管理改进):新增 meta tag 验证,"不想在首页展示广告时,可用 meta 标签替代 AdSense 代码片段验证"。BlogLoom 首页是 SPA,已有 SpaIndexController(见 5.1.5.4)向 SPA 入口注入 meta 的能力,可直接沿用方案 B。
4.4.3、一个发布商 ID,可以有 N 个广告位
这是最容易搞混、也最该先搞清的一点。AdSense 里的标识分两级:
| 标识 | 数量 | 是什么 | 出现在哪 |
|---|---|---|---|
发布商 ID(ca-pub-XXXX) |
全站唯一 | 整个 AdSense 账号的 ID | 加载器脚本、每个广告位的 data-ad-client |
广告位 ID(data-ad-slot) |
可以有多个 | 一个"广告单元"一个 ID | 每个 <ins> 广告位 |
"是否有多个"要分开看:
| 参数 | 单/多 | 说明 |
|---|---|---|
client(发布商 ID) |
单 | 一个账号一个,全站所有广告位共用同一个 |
slots[].slot(广告位 ID) |
多 | 顶部、文内、底部各放一个 → 建 3 个"广告单元" → 拿 3 个 slot ID |
adsTxt |
单文件、多行 | 只接 Google 通常 1 行;接多家联盟才多行 |
结论:
- 发布商 ID 永远只配一个,它是总开关。
- 广告位想放几个就建几个,不写死"顶部/文内/底部"三个字段——增删位置不应改代码。
- 三个 slot 不是"同一广告单元的多个参数",而是三个互相独立的广告单元(各自独立报表、独立样式)。
因此后台只保留「一个配置项」,值是一组 JSON(而不是拆成发布商 ID、广告位列表、ads.txt 多个字段):
| 配置键(nameEn) | 中文名 | 类型 | 说明 |
|---|---|---|---|
adsense |
AdSense 广告配置 | JSON(字符串) | 后台唯一入口;发布商 ID、广告位列表、ads.txt 全在这一个 JSON 里 |
{
  "enabled": true,
  "client": "ca-pub-1234567890123456",
  "adsTxt": "",
  "slots": [
    { "slot": "1234567890", "position": "articleTop",       "enabled": true },
    { "slot": "2345678901", "position": "articleInArticle", "enabled": true },
    { "slot": "3456789012", "position": "articleBottom",    "enabled": false }
  ]
}
字段含义:
| 字段 | 必填 | 说明 |
|---|---|---|
enabled |
否(默认 true) | 全站广告总开关;false 则整块忽略 |
client |
是 | AdSense 发布商 ID(ca-pub-…),全站唯一;为空 = 全站不注入 |
adsTxt |
否 | ads.txt 自定义内容;为空时按 client 自动生成一行 |
slots[] |
否 | 广告位列表;slot=广告位 ID,position=位置枚举,enabled=单个开关 |
这组 JSON 最终落到页面上是什么样? 以文章 513 为例,同一份配置会变成两处产物:
产物 1:<head> 里的加载器(来自 client)。 只要 client 非空就输出,全站每个页面一份:
<!-- 由 seo-head.html 注入(SSR 页)或 main.js 注入(SPA 页) -->
<script async
  src="https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=ca-pub-1234567890123456"
  crossorigin="anonymous"></script>
产物 2:<body> 里按 slots[] 渲染的广告位。 模板 adslot 片段按 position 取 slot,取到才渲染:
<body>
  <!-- slots[0]:position=articleTop → slot=1234567890 → 渲染 -->
  <div class="article-ad">
    <ins class="adsbygoogle" style="display:block"
         data-ad-client="ca-pub-1234567890123456" data-ad-slot="1234567890"
         data-ad-format="auto" data-full-width-responsive="true"></ins>
    <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
  </div>

  <article>
    <h1 th:text="${article.title}">文章标题</h1>

    <!-- slots[1]:position=articleInArticle → slot=2345678901 → 渲染(正文第 2~3 段后) -->
    <div class="article-ad">
      <ins class="adsbygoogle" style="display:block"
           data-ad-client="ca-pub-1234567890123456" data-ad-slot="2345678901"
           data-ad-format="auto" data-full-width-responsive="true"></ins>
      <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
    </div>

    <div class="content" th:utext="${article.content}">正文</div>

    <!-- slots[2]:position=articleBottom 且 enabled=false → 不渲染,这里什么都不输出 -->
  </article>
</body>
字段 ↔ 页面产物对照:
| JSON 字段 | 页面产物 | 说明 |
|---|---|---|
client |
<head> 的 adsbygoogle.js 加载器 |
全站一份,Auto ads 也靠它 |
slots[] 里 enabled=true |
<body> 里对应位置的一段 <ins> + push |
有几个生效位就有几段 |
slots[] 里 enabled=false |
不出现(被过滤) | 上面 articleBottom 即此例 |
adsTxt="" |
/ads.txt 自动生成一行 |
google.com, pub-1234567890123456, DIRECT, … |
想加/去广告位、临时开关某一位、换发布商 ID,都只改这一组 JSON:加一条
slots就多一段<ins>,把enabled改false就少一段,client清空就整站无广告——模板与代码都不用动。
**设计理由:**后台只维护一个 JSON,前端表单本质是"一个文本框 + 一段校验",后端只当字符串存取、解析时做兜底;新增/删除位置、临时关广告、改发布商 ID 都只动这一处,不新增表、不新增字段、不改代码。
4.4.4、广告位规划与布局原则
广告放哪,直接决定"体验"和"收益"。参考眼动 F 型浏览路径,放在读者自然经过的阅读动线上,比"多塞几个格子"有效得多。
| 位置 | 说明 | BlogLoom 落点 | 建议 |
|---|---|---|---|
| 首屏之下 | 所有人进门都会经过 | 文章标题后 / 正文前 | 响应式横幅,控制高度,别让首屏只有广告没正文 |
| 文内第一条 | 第 2~3 段之后,读者已确认"值得读" | 正文中部 | CTR 通常最高;二阶段做 |
| 正文结束处 | 读者处于"接下来看什么"的过渡期 | 正文末尾、相关推荐前 | 矩形 / 信息流样式 |
| 桌面侧栏 | 宽屏才有,可 sticky | 文章页左右栏 | 仅桌面;移动端隐藏 |
| 页脚 / 侧栏最底 | 长期 CTR 极低还伤体验 | — | 果断砍掉 |
布局原则:
- **数量克制:**3~4 个高质量位置,通常优于 6~7 个鸡肋位。
- **预留尺寸防 CLS:**广告容器给
min-height或aspect-ratio,避免加载后正文乱跳(呼应 4.3.9)。 - **融入而非伪装:**配色接近站点主题可以;绝不能做成"下载按钮""播放键"或伪装成正文(见 4.4.6)。
- **移动端优先:**用自适应单元(
data-full-width-responsive="true"),少用手动固定大尺寸撑爆首屏。
4.4.5、广告位与页面的对应关系(需求视角)
| 页面 | 渲染方式 | 适合的广告位 | 接入方式 |
|---|---|---|---|
文章详情页 /blog/{id} |
SSR 直出 | articleTop / articleInArticle / articleBottom |
后端模板输出 <ins>(5.3.1.2) |
| 首页 / 列表 / 归档 | Vue SPA | listTop(可选) |
前端注入 + 路由 push(5.3.1.3) |
后台 /cms、/admin |
SPA | 不投 | 后台不对外开放,无需广告 |
核心场景是文章页:它既是收录主体,也是读者停留最久的地方;SPA 页广告属于锦上添花。
4.4.6、合规与审核要点
AdSense 审核的本质是判断"你是不是在做对用户有用的网站"。与 BlogLoom 直接相关的要点如下。
① 申请前的站点条件(与 SEO 改造强相关):
| 要求 | BlogLoom 现状 | 对应章节 |
|---|---|---|
| 内容可抓取(非空壳) | 已完成服务端直出 | 5.1.1.2 |
| 有 sitemap 并提交 Search Console | 已完成 | 5.1.3.2、5.2.1 |
| 有隐私政策页(含 Cookie / 第三方说明) | 需确认/补齐 | 新增 |
| 有关于 / 联系页面 | 站点已有 About | 现有 |
| 全站 HTTPS + 自有顶级域名 | 已满足(blog.changlu.cloud) | 现有 |
| 导航清晰、无死链、移动端可用 | 基本满足 | 现有 + 5.1.6 |
**注意:**隐私政策页是审核里最容易漏的一项,需写明:使用了 Cookie、接入了 Google AdSense 等第三方、第三方可能基于用户兴趣投放广告。
② 广告实现红线(官方 广告投放政策):
| 红线 | 说明 | 对 BlogLoom 的约束 |
|---|---|---|
| 诱导点击 | 禁止"点广告支持本站"等文案或布局 | 广告旁不放诱导性文字/箭头 |
| 伪装成内容 | 禁止做成导航、下载按钮、正文样式 | 广告位有清晰边界与留白 |
| 误导性标题 | 禁止用"资源""有用链接"等标题盖在广告上 | 广告上方不放大标题 |
| 未经请求的自动刷新 | 禁止定时器自动刷新广告"刷曝光" | SPA 只允许"用户切路由后 push 新广告位" |
| 图片与广告对齐 | 禁止让站内图片像广告配图 | 广告与正文图片保持视觉区隔 |
| 放在登录墙后 | Google 无法评估的内容不投放 | 私密/密码文章页不投广告(与 sitemap 排除一致,见 5.1.3.2) |
③ 内容质量(决定能不能过审):
- 原创、垂直、有信息量:同一细分领域 8~15 篇能解决具体问题的原创长文,比"50 篇模板短文"更稳。
- 不是机翻/洗稿:多平台搬运、机翻当原创,属于高危重复内容。
- 有稳定更新节奏:几周内持续更新,比"同一天批量发完"更像认真运营。
- 被拒后:读懂拒信关键词 → 做可见的整改(补隐私政策、删违规、修 404、改导航)→ 等 7~14 天再申请,不要连续刷申请。
④ 与 SEO 阶段的正向循环:
SEO 改造(可抓取 + sitemap + 隐私政策 + 清晰结构)
        ↓
通过 Search Console 被收录、有自然流量
        ↓
AdSense 申请时"看起来像认真运营的站"
        ↓
过审 → 投放 → 收益
4.4.7、收益与指标:看什么、怎么算
| 指标 | 全称 | 含义 | 用途 |
|---|---|---|---|
| Page RPM | 每千次网页浏览收益 | 1000 次页面浏览能赚多少 | 衡量页面整体变现效率 |
| Impressions RPM | 每千次广告展示收益 | 1000 次广告展示能赚多少 | 衡量广告位本身质量 |
| CTR | 点击率 | 点击 ÷ 展示 | 判断位置/样式是否"被看到" |
| CPC | 每次点击成本 | 广告主为一次点击付的钱 | 受内容主题(技术类偏高)影响 |
**经验参考(非承诺):**内容站 CTR 常见 1~3%,长期低于 0.5% 通常意味着位置或匹配有问题;RPM 波动大,看周趋势而非单日。
**结算门槛:**账户余额累计满 100 美元才触发支付;需完成身份验证(PIN 码)与收款方式(国内电汇需 SWIFT/BIC)。
重要:广告费的主要变量不是"广告位数量",而是"内容主题 × 流量质量 × 页面浏览深度"。 技术博客 CPC 通常不低,把 5.1 的性能与 5.2 的收录做扎实、让文章被更多人看到,比多塞几个广告位更划算。
4.4.8、常见问题排查(广告不显示)
| 现象 | 可能原因 | 排查/解决 |
|---|---|---|
源码里有 <ins>,但页面空白 |
加载器没注入成功 / 顺序不对 | 确认 <head> 有 adsbygoogle.js;加载器必须在 <ins> 之前 |
| 有加载器,但广告不出现 | 账号/站点还在审核中 | Sites 状态是否 Ready;审核通过前不投放 |
| 只显示一次,切路由后消失 | SPA 路由切换后没重新 push | 见 5.3.1.3 的 router.afterEach;确认是"新的 <ins>" |
控制台报 All ins elements already have ads |
同一 <ins> 被 push 多次 |
每个元素只 push 一次;SPA 切换要渲染出新的 <ins> |
控制台报 No slot size |
父容器宽度为 0 或未定义 | 给广告容器固定/最小宽度(见 4.4.4) |
| 移动端撑破布局 | 自适应父容器宽度不稳 | 用 data-full-width-responsive="true" + 容器 width:100% |
| 本机看到广告、线上看不到 | 广告拦截插件 / 地区无库存 | 换无插件浏览器、清缓存;部分地区库存本就少 |
| ads.txt 一直 Not found | 路径/内容/缓存问题 | curl 确认根目录可访问;内容格式一行;点 Check for updates |
| 被拒:"内容不足 / 低价值" | 篇数或质量不够 | 补垂直原创长文、清理模板文,7~14 天后再申 |
调试:浏览器 Network 过滤
adsbygoogle看 SDK 是否加载;Console 看push()报错。广告竞价有延迟(通常几秒内),刚打开空白属正常。
4.4.9、参考索引(广告相关的调研出处)
| 主题 | 官方/来源链接 |
|---|---|
| AdSense 代码说明 | https://support.google.com/adsense/answer/9274634 |
代码放置位置(<head>) |
https://support.google.com/adsense/answer/9274516 |
| 站点管理改进(meta 验证 / ads.txt) | https://support.google.com/adsense/answer/13996652 |
| 自适应广告代码参数 | https://support.google.com/adsense/answer/9183460 |
| 广告投放政策 | https://support.google.com/adsense/answer/1346295 |
| ads.txt 指南 | https://support.google.com/adsense/answer/12171612 |
| ads.txt 技术规范(Google for Developers) | https://developers.google.com/adsense/platforms/transparent/ads-txt |
| 广告代码(AFP 参数参考) | https://developers.google.cn/adsense/platforms/direct/ad-tags |
| SPA 接入 AdSense 实践 | https://jasonwatmore.com/add-google-adsense-to-a-single-page-app-react-angular-vue-next-etc |
| 申请与审核经验(2026) | https://eastondev.com/blog/zh/posts/media/20260108-google-adsense-approval-guide/ |
| 布局与 CTR 优化(2026) | https://eastondev.com/blog/zh/posts/media/20260108-adsense-placement-optimization/ |
五、实战代码:逐项改造
本章分两部分:
- 5.1 功能代码优化实践:把需要被收录的页面改造成"服务端直出 + 标准 meta",并补齐站点级文件、收录控制与 SEO 后台配置(F1~F11、F14、F15)。
- 5.2 搜索引擎平台收录:代码改完后,如何针对国外(Google、Bing)与国内(百度)逐步推动收录,并持续监测(F12 数据监测、F13 主动推送)。
5.1、功能代码优化实践
5.1.1、内容直出与数据地基
5.1.1.1、数据层补齐(详情接口)
**问题:**文章页的 SEO 元信息依赖详情接口;即使文章列表已经有封面,如果详情查询没有把封面映射到 BlogDetail,服务端直出页仍然无法生成 og:image。
实现状态:BlogDetail 已包含封面、摘要和作者字段,详情查询 getBlogByIdAndIsPublished 已查询并显式映射以下列:
private String firstPicture;  // 封面,用于 og:image / JSON-LD image
private String description;   // 摘要,用于 meta description / og:description
private String authorName;    // 作者名
private String authorAvatar;  // 作者头像
实现点 1:BlogDetail.java 保持 SEO 所需字段完整。
private String firstPicture;  // 封面,用于 og:image / JSON-LD image
private String description;   // 摘要,用于 meta description / og:description
private String authorName;    // 作者名
private String authorAvatar;  // 作者头像
实现点 2:BlogMapper.xml 的 blogDetail resultMap 与查询补齐列(并 join 作者)。
<result property="firstPicture" column="first_picture"/>
<result property="description" column="description"/>
<result property="authorName" column="author_name"/>
<result property="authorAvatar" column="author_avatar"/>
<select id="getBlogByIdAndIsPublished" resultMap="blogDetail">
    select b.id, b.title, b.first_picture, b.description, b.content,
           b.is_appreciation, b.is_comment_enabled, b.is_top,
           b.create_time, b.update_time, b.views, b.words, b.read_time, b.password,
           c.category_name,
           t.tag_name as tag_name, t.color,
           u.nickname as author_name, u.avatar as author_avatar
    from ((((blog as b
        left join category as c on b.category_id=c.id)
        left join blog_tag as bt on b.id=bt.blog_id)
        left join tag as t on bt.tag_id=t.id)
        left join user as u on b.user_id=u.id)
    where b.id=#{id} and b.is_published=true and b.is_deleted=0
</select>
**注意:**若 user 表无 nickname 字段,改用实际字段(如 username);也可退化为从站点配置读博主信息。作者 URL 可由 blog.view + /about 拼出,不强制。
验收:
GET /blog?id=513返回中包含firstPicture、description、authorName、authorAvatar;GET /blog/513的 HTML<head>包含以firstPicture生成的绝对地址og:image;SeoEndpointIntegrationTest覆盖封面图进入 SSR HTML 的场景。
线上问题复盘(2026-10-09):
文章 517 的列表接口已经返回封面地址,但详情接口返回 firstPicture: null,导致 /blog/517 的 HTML 中没有 og:image。正文里虽然存在 alt="coverImg" 的图片,但 QQ 分享抓取的是页面 <head> 中的 Open Graph 元信息,不应依赖正文图片或前端懒加载属性。最终定位为 blogDetail resultMap 漏掉 firstPicture、description、作者字段映射,已通过显式 <result> 修复。
5.1.1.2、文章详情页服务端直出
现状:/blog/{id} 是前端路由,后端无对应页面;且 SpaForwardFilter 会先把请求转发到 index.html。
**改造点 1:**新增 SeoPageController(注意是 @Controller 不是 @RestController),按 3.4 约定放在 module/seo/api 下。
package com.changlu.blogloom.module.seo.api;

@Controller
public class SeoPageController {

    @Autowired private BlogService blogService;
    @Autowired private SeoMetaBuilder seoMetaBuilder;

    @GetMapping("/blog/{id}")
    public String blogPage(@PathVariable Long id, Model model) {
        BlogDetail blog = blogService.getBlogByIdAndIsPublished(id);
        if (blog == null) {
            throw new ResponseStatusException(HttpStatus.NOT_FOUND);
        }
        model.addAttribute("seo", seoMetaBuilder.forArticle(blog));
        model.addAttribute("article", blog);
        return "seo/blog";
    }
}
**改造点 2:**修改 SpaForwardConfig,放行服务端直出路由。
在 RESERVED_PREFIXES(SpaForwardConfig.java:33-35)之外,增加一个"服务端直出前缀"名单,命中时不回退:
private static final List<String> SSR_PREFIXES = Arrays.asList(
        "/blog", "/tag", "/category", "/column", "/archives", "/about", "/friends"
);
在 shouldForward 内最先判断:
for (String prefix : SSR_PREFIXES) {
    if (path.equals(prefix) || path.startsWith(prefix + "/")) {
        return false;   // 交给后端 Controller 直出
    }
}
注意:/blog 前缀会同时匹配接口 /blogs(BlogController.java:47)。但接口请求的 Accept 不是 text/html、本就不会回退,/blogs 返回 JSON 不受影响;同理 /blog?id= 详情接口也不受影响。真正被接管的是浏览器导航 /blog/513 这类无扩展名 HTML 请求。
改造点 3(可选):blog-view-ui 的 /blog/:id 保留用于站内跳转;用户从首页点进文章时若被 Vue Router 拦截,则仍走 SPA;硬刷新/爬虫则拿到服务端直出 HTML。二者内容一致即可。
Thymeleaf 模板 seo/blog.html(骨架,正文直出):
<!DOCTYPE html>
<html lang="zh-CN" xmlns:th="http://www.thymeleaf.org">
<head th:replace="seo/fragments/seo-head :: head(${seo})"></head>
<body>
<article>
    <h1 th:text="${article.title}">文章标题</h1>
    <div class="meta">
        <time th:text="${#dates.format(article.createTime,'yyyy-MM-dd')}"></time>
        <span th:text="${article.category?.name}"></span>
    </div>
    <!-- 正文已是 HTML,用 utext 直出 -->
    <div class="content" th:utext="${article.content}">正文</div>
    <div class="tags">
        <a th:each="tag : ${article.tags}"
           th:href="@{'/tag/' + ${tag.name}}"
           th:text="'#' + ${tag.name}">#标签</a>
    </div>
</article>
</body>
</html>
重点:正文用 th:utext(等价于现有 v-html)。一阶段模板样式可先精简,后续再统一;关键是正文与 meta 必须在首屏 HTML 里。
**标题层级要求:**全页只有一个 <h1>(文章标题),正文内的 Markdown 标题从 <h2> 起。若原 Markdown 渲染出多个 h1,建议在 SeoMetaBuilder 或渲染阶段降级。
验收:curl -H 'Accept: text/html' https://域名/blog/513 能看到 <h1> 正文和正确 <title>。
5.1.2、页面级 SEO 元信息
5.1.2.1、页面级 SEO meta
**改造点:**所有内容页复用公共 head 片段 fragments/seo-head.html。
<head th:fragment="head(seo)" xmlns:th="http://www.thymeleaf.org">
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title th:text="${seo.title}">标题 - BlogLoom</title>
    <meta name="description" th:content="${seo.description}">
    <link rel="canonical" th:href="${seo.canonicalUrl}">

    <meta property="og:type" content="article">
    <meta property="og:title" th:content="${seo.title}">
    <meta property="og:description" th:content="${seo.description}">
    <meta property="og:image" th:content="${seo.image}">
    <meta property="og:url" th:content="${seo.canonicalUrl}">
    <meta property="og:site_name" th:content="${seo.siteName}">
    <meta property="article:published_time" th:content="${seo.publishedTime}">
    <meta property="article:modified_time" th:content="${seo.modifiedTime}">
    <meta property="article:author" th:content="${seo.authorName}">
    <meta property="article:section" th:content="${seo.category}">
    <meta property="article:tag" th:each="t : ${seo.tags}" th:content="${t}">

    <link rel="alternate" type="application/rss+xml"
          th:title="${seo.siteName}" th:href="${seo.baseUrl} + '/rss.xml'">
</head>
SeoMeta 与 SeoMetaBuilder 负责把 BlogDetail 转成上述字段:
| 字段 | 来源 | 规则 |
|---|---|---|
title |
article.title + webTitleSuffix |
复用现有 webTitleSuffix 站点配置 |
description |
article.description |
为空时截取正文纯文本前 120 字 |
canonicalUrl |
blog.view + /blog/{id} |
不带任何追踪参数 |
image |
article.firstPicture |
必须是完整绝对 URL(第三方平台要抓取) |
publishedTime / modifiedTime |
create_time / update_time |
ISO 8601 带时区 |
**验收:**查看源码只有一个 <title>;description 非空;canonical 与 sitemap、站内链接三者一致。
分享卡片抓取链路(QQ / CSDN 类平台)
文章分享到 QQ、CSDN 等平台时,平台服务端通常会先请求文章 URL,再解析响应 HTML 的 <head> 元信息生成分享卡片。这个过程不依赖用户当前浏览器是否执行 Vue,也不能依赖正文里的图片懒加载。
用户分享 https://blog.changlu.cloud/blog/517
        ↓
QQ / 分享平台服务端 GET 文章 URL
        ↓
SpaForwardFilter 放行 HTML 导航请求
        ↓
SeoPageController.blogPage(/blog/{id})
        ↓
BlogService 查询 BlogDetail(包含 firstPicture)
        ↓
SeoMetaBuilder 将 firstPicture 转成绝对 URL
        ↓
Thymeleaf seo-head.html 输出 Open Graph 标签
        ↓
平台读取 og:title / og:description / og:image / og:url
        ↓
平台请求 og:image,生成分享封面
文章详情页至少需要输出以下字段:
<meta property="og:type" content="article">
<meta property="og:title" content="文章标题 - BlogLoom">
<meta property="og:description" content="文章摘要">
<meta property="og:image" content="https://cdn.example.com/cover.png">
<meta property="og:url" content="https://blog.changlu.cloud/blog/517">
<meta property="og:site_name" content="BlogLoom">
其中 og:image 是封面能否出现的关键字段,必须使用完整的公网绝对地址。封面资源还应满足:
- 未登录即可访问,不能依赖 Cookie、JWT 或后台权限;
- 返回
200,并返回正确的Content-Type(如image/png、image/jpeg); - 图片地址不能被防盗链策略拦截;
- 建议使用接近
1200×630的横图;og:image:width、og:image:height、og:image:alt属于增强字段,不是替代og:image的必需条件。
**正文图片不能替代 og:image:**正文中的 <img> 可能只有 data-src,或者要等 JavaScript 执行后才补成 src。分享平台抓取首屏 HTML 时通常不会执行这套前端逻辑,因此必须把博客封面字段 firstPicture 直接渲染进 <head>。
RSS 与分享卡片无关:<link rel="alternate" type="application/rss+xml"> 只用于订阅源发现,不会为 QQ 分享提供封面。
线上验收方式:
curl -L -sS https://域名/blog/517 \
  | rg 'og:(title|description|image|url)'

curl -L -sS -o /dev/null -w '%{http_code} %{content_type}\n' \
  'https://图片域名/封面.png'
本次线上问题的关键对比是:文章列表接口 firstPicture 有值,但文章详情接口曾返回 firstPicture: null,所以服务端直出页没有 og:image。补齐 blogDetail resultMap 后,详情接口、SSR 页面和 QQ 分享卡片使用同一张博客封面图。
社交媒体分享规范(Open Graph / Twitter Card)
社交平台分享卡片应遵循标准化的页面元信息协议。第一阶段以 Open Graph(OG) 为主,兼容 QQ、微信、CSDN、Slack、Facebook 等平台;Twitter/X 的 Card 字段作为可选增强。
Open Graph 核心字段:
| 字段 | 必要性 | 用途 | BlogLoom 实现 |
|---|---|---|---|
og:type |
必需 | 内容类型,文章使用 article |
SeoMeta.type |
og:title |
必需 | 分享卡片标题 | article.title + webTitleSuffix |
og:description |
必需 | 分享卡片摘要 | article.description,为空时取正文摘要 |
og:url |
必需 | 当前内容的标准地址 | SeoUrlResolver.articleUrl(id) |
og:site_name |
推荐 | 站点名称 | blog.name |
og:image |
强烈推荐 | 分享封面图 | article.firstPicture 的绝对 URL |
og:image:alt |
推荐 | 封面图无障碍描述 | 可使用文章标题 |
og:image:width / og:image:height |
可选 | 提供封面尺寸,减少平台预览判断时间 | 当前不强制输出 |
article:published_time |
推荐 | 文章发布时间 | create_time,ISO 8601 |
article:modified_time |
推荐 | 文章修改时间 | update_time,ISO 8601 |
article:author / article:section / article:tag |
推荐 | 作者、分类、标签 | BlogDetail 对应字段 |
最小可用的文章分享头信息如下:
<meta property="og:type" content="article">
<meta property="og:title" content="文章标题 - BlogLoom">
<meta property="og:description" content="文章摘要">
<meta property="og:url" content="https://blog.changlu.cloud/blog/517">
<meta property="og:site_name" content="BlogLoom">
<meta property="og:image" content="https://图片域名/封面.png">
**Twitter/X Card 可选兼容:**如果后续需要覆盖 Twitter/X,可在公共 head 中补充以下字段;它们不替代 Open Graph,两个协议可以同时输出。
<meta name="twitter:card" content="summary_large_image">
<meta name="twitter:title" content="文章标题 - BlogLoom">
<meta name="twitter:description" content="文章摘要">
<meta name="twitter:image" content="https://图片域名/封面.png">
封面图规范:
- 使用
https的完整绝对地址,不能使用相对路径、data:URL 或仅在前端运行后才出现的data-src。 - 图片必须允许分享平台匿名访问,返回
200和正确的图片Content-Type。 - 推荐
1200×630横向封面,主体内容尽量位于中心安全区域,避免平台裁剪后丢失标题或主体。 - 页面没有封面时可以不输出
og:image,但不能输出失效地址、登录页地址或站点 Logo 作为文章封面。 - 分享平台可能缓存卡片。部署修复后应先用源码和图片 URL 验证,再等待平台刷新缓存;不要为了绕过缓存修改 canonical 地址。
规范验收清单:
- 首屏 HTML 源码中存在唯一的
og:title、og:description、og:url、og:image; og:url与 canonical、站内标准文章 URL 一致;og:image是当前文章的firstPicture,且匿名请求返回图片;- 禁用 JavaScript 后,上述 meta 仍存在;
- 修改文章封面后,详情接口、SSR 页面和分享卡片使用同一张图片;
- RSS 自动发现标签存在,但不把 RSS 当作分享卡片协议。
5.1.2.2、canonical 与 URL 策略
**现状:**无 canonical;前端路由参数可能带 ?spm=、?from= 等,易产生重复 URL。
改造点:
- 统一标准地址:
{SEO 域名}/blog/{id}(SEO 域名 = 后台seoDomain,兜底blog.view;一阶段沿用 id,slug 为可选增强)。 - canonical、
og:url、sitemap loc、站内文章链接全部使用同一个标准 URL。 - 所有绝对 URL 由
SeoUrlResolver统一拼接,不硬编码域名。 - 明确 canonical 只是"首选网址信号",不做跳转;若需强制去参数可另加重定向(一阶段可不做)。
域名从哪来(重点):
建议抽成后台系统配置项(可在管理后台直接改、即时生效),同时保留 blog.view 作为兜底。取值优先级如下:
| 优先级 | 来源 | 位置 | 说明 |
|---|---|---|---|
| ①(优先) | 后台站点设置 | site_setting 表,键 seoDomain |
后台可改,改完即时生效,不用重启 |
| ②(兜底) | 配置文件 | conf/application.properties 的 blog.view / 环境变量 BLOG_VIEW |
后台为空时使用,默认 http://localhost:8081 |
① 新增后台配置项(复用现有 SiteSetting 机制,与 webTitleSuffix、favicon 同类):
| 字段 | 值(示例) |
|---|---|
nameEn |
seoDomain |
nameZh |
SEO 域名 |
value |
https://blog.changlu.cloud |
type |
1(随 GET /site 的 siteInfo 返回) |
管理后台的站点设置页加一个"SEO 域名"输入框即可(沿用现有保存逻辑,无需新建表)。
② 服务层新增读取方法(与现有 getWebTitleSuffix() 同风格):
// SiteSettingService 接口新增
String getSeoDomain();   // 读取 nameEn = 'seoDomain' 的值,为空返回 null
③ SeoUrlResolver 读取:后台优先,兜底配置:
@Component
public class SeoUrlResolver {
    private final SiteSettingService siteSettingService; // 读后台配置
    private final BlogProperties blogProperties;         // 兜底配置

    public SeoUrlResolver(SiteSettingService siteSettingService, BlogProperties blogProperties) {
        this.siteSettingService = siteSettingService;
        this.blogProperties = blogProperties;
    }

    /** 站点根地址:优先后台 seoDomain,其次 blog.view(去掉结尾斜杠) */
    public String baseUrl() {
        String seoDomain = siteSettingService.getSeoDomain();
        String url = (seoDomain != null && !seoDomain.trim().isEmpty())
                ? seoDomain : blogProperties.getView();
        return trimTrailingSlash(url);
    }

    /** 文章标准 URL:{baseUrl}/blog/{id} */
    public String articleUrl(Long id) {
        return baseUrl() + "/blog/" + id;
    }
}
**统一出口(关键):**后续所有需要绝对地址的 SEO 策略,统统只认这一处「SEO 域名」配置,全部由 SeoUrlResolver.baseUrl() 派生:
| 用到的地方 | 取值 |
|---|---|
<link rel="canonical"> |
{seoDomain}/blog/{id} |
og:url |
{seoDomain}/blog/{id} |
sitemap loc |
{seoDomain}/blog/{id} |
RSS <link> / <guid> |
{seoDomain}/blog/{id} |
JSON-LD url / mainEntityOfPage |
{seoDomain}/blog/{id} |
**为什么放后台配置:**换域名、迁移、多环境部署时,只改后台这一处即可,不用改配置文件、不用重新部署;上表所有地址同步指向新域名,避免出现"有的页面指向 A 域名、有的指向 B 域名"的权重分散。
**注意(线上部署最易踩的坑):**若后台没配、配置文件也没改,会落到默认 http://localhost:8081,导致 canonical / og:url / sitemap loc / RSS 全是 localhost,被搜索引擎直接丢弃。上线前务必在后台把"SEO 域名"填成真实域名。
注意两点:
- canonical 不会让浏览器跳转;浏览器跳转需要重定向。
- 不要让所有文章都指向首页,也不要把不同内容的分页随意指向同一页。
**验收:**带 ?utm_source=xx 访问时,页面 canonical 仍指向无参数标准地址。
5.1.2.3、结构化数据 JSON-LD
**改造点:**在 seo-head.html 片段中输出 BlogPosting。
<script type="application/ld+json" th:inline="javascript">
/*[[${seo.ldJson}]]*/
</script>
由 SeoMetaBuilder 构建 JSON(推荐用 Jackson ObjectMapper 序列化,避免手拼转义问题):
ObjectNode ld = mapper.createObjectNode();
ld.put("@context", "https://schema.org");
ld.put("@type", "BlogPosting");
ld.put("headline", article.getTitle());
ld.put("description", article.getDescription());
ld.put("image", abs(article.getFirstPicture()));
ld.put("datePublished", toIso(article.getCreateTime()));
ld.put("dateModified", toIso(article.getUpdateTime()));
ld.put("inLanguage", "zh-CN");
ld.put("mainEntityOfPage", canonicalUrl);
ArrayNode kw = ld.putArray("keywords");
article.getTags().forEach(t -> kw.add(t.getName()));
ObjectNode author = ld.putObject("author");
author.put("@type", "Person");
author.put("name", article.getAuthorName());
ObjectNode publisher = ld.putObject("publisher");
publisher.put("@type", "Organization");
publisher.put("name", siteName);
ObjectNode logo = publisher.putObject("logo");
logo.put("@type", "ImageObject");
logo.put("url", abs(siteLogo));
注意:dateModified 必须取真实的实质修改时间(update_time),不能每次自动刷新伪装更新。
**验收:**用 Google 富媒体结果测试工具 / Schema 校验器无错误。
5.1.2.4、Open Graph
Open Graph 的标签已包含在 5.1.2.1 的公共片段里,这里补充几个关键点:
og:image必须完整 URL 且公开可访问(/static/**上传图是公开的,符合)。- SEO 与 OG 复用同一份
article.title/summary/cover,只维护一处数据。 - 摘要与 description 复用,不要两套文案。
弊端说明:如果什么都不配置,平台可能自行从 HTML 里"猜"标题、摘要和图片,很容易出现图片选错、标题被截断、没有封面等问题,分享出去很难看。
**验收:**把文章链接发到微信/QQ/Slack,出现封面 + 标题 + 摘要卡片。
5.1.3、站点级收录文件
5.1.3.1、robots.txt
**现状:**404。
**改造点:**新增 SeoFileController(按 3.4 约定放在 module/seo/api 下),统一承载 robots / sitemap / rss 三个端点。
@GetMapping(value = "/robots.txt", produces = "text/plain;charset=UTF-8")
public String robots() {
    return "User-agent: *\n"
         + "Disallow: /admin/\n"
         + "Disallow: /cms/\n"
         + "Disallow: /login\n"
         + "Allow: /\n\n"
         + "Sitemap: " + seoUrlResolver.baseUrl() + "/sitemap.xml\n";
}
重点(容易踩坑):
- BlogLoom 的接口不在
/api/下,而是根路径(/blog?id=、/blogs、/site…),不要写Disallow: /blog,否则会误屏蔽文章页。 robots.txt是抓取规则,不是权限控制;后台仍靠/admin的 JWT 鉴权。SpaForwardConfig对带扩展名请求不回退,/robots.txt可直接由 Controller 命中;也可放conf/static/view/robots.txt由静态资源提供,二选一。
验收:curl https://域名/robots.txt 返回规则且含 Sitemap 行。
5.1.3.2、sitemap.xml
**现状:**404。
**改造点:**新增 Sitemap 生成,只包含公开、已发布、非密码保护文章(私密文章不进 sitemap,但仍需鉴权保护)。
@GetMapping(value = "/sitemap.xml", produces = "application/xml;charset=UTF-8")
public String sitemap() {
    List<Blog> blogs = blogService.listPublishedForSitemap(); // is_published=1 and is_deleted=0 and (password is null or password='')
    StringBuilder sb = new StringBuilder();
    sb.append("<?xml version=\"1.0\" encoding=\"UTF-8\"?>\n");
    sb.append("<urlset xmlns=\"http://www.sitemaps.org/schemas/sitemap/0.9\">\n");
    for (Blog b : blogs) {
        sb.append("  <url>\n")
          .append("    <loc>").append(seoUrlResolver.articleUrl(b.getId())).append("</loc>\n")
          .append("    <lastmod>").append(toDate(b.getUpdateTime())).append("</lastmod>\n")
          .append("  </url>\n");
    }
    sb.append("</urlset>");
    return sb.toString();
}
要点:
loc必须与 canonical 完全一致。lastmod用update_time(实现上可新增一个只查id, update_time的 Mapper 查询)。- 首页、分类、标签、专栏页也可加入(各自一条
<url>),一阶段可先只放文章。 - 文章数超过 5 万或文件超 50MB 时需拆分 sitemap index(当前规模不涉及)。
- 不要包含
/admin、/cms、草稿、密码保护文章。
验收:curl https://域名/sitemap.xml 内容正确;草稿与私密文章不出现。
5.1.3.3、RSS 订阅
**现状:**404。
**改造点:**提供 /rss.xml(RSS 2.0,输出最近约 20 篇公开文章),并把 <link rel="alternate"> 放进公共 head 片段(已在 5.1.2.1)。Atom 一阶段可不做,RSS 已覆盖绝大多数阅读器。
@GetMapping(value = "/rss.xml", produces = "application/rss+xml;charset=UTF-8")
public String rss() {
    // channel: title/link/description/lastBuildDate
    // 每 item: title/link/guid/pubDate/description(摘要)
}
**重点:**只输出摘要或受控正文,不输出私密内容;发布日期用 create_time。
**验收:**用 Feedly/Inoreader 等能订阅成功;文章页源码含 RSS 自动发现链接。
5.1.4、聚合页可抓取
5.1.4.1、聚合页可抓取(列表 / 标签 / 分类 / 归档)
现状:/home、/archives、/tag/:name、/category/:name、/column/:id 全是 SPA,爬虫读不到列表。
**改造点(P1):**在 SeoPageController 增加对应服务端直出页面,复用 list.html 通用模板。
| 路由 | 对应现有接口 | 复用数据服务 |
|---|---|---|
GET /home(或 /) |
GET /blogs(BlogController.java:47) |
blogService.getBlogInfoListByIsPublished |
GET /tag/{name} |
GET /tag(TagController.java:32) |
标签服务 + 分页 |
GET /category/{name} |
GET /category(CategoryController.java:32) |
分类服务 + 分页 |
GET /archives |
GET /archives(ArchiveController.java:29) |
归档服务 |
GET /column/{id} |
GET /column/{id}/blogs(ColumnController.java:14) |
专栏服务 |
同时把对应前缀加入 SSR_PREFIXES(见 5.1.1.2)。列表页每篇文章输出指向 /blog/{id} 的 <a> 内链,形成可抓取的内链网络。标签/分类这类聚合链接建议加 rel="nofollow",避免权重被滥用。
验收:curl /tag/Java 能看到文章标题链接列表。
5.1.5、收录控制与后台配置
5.1.5.1、收录控制(防止后台被收录)
现状:/cms/(管理后台)与 /admin/ 无 noindex,可能被爬虫收录。
改造点:
blog-cms-ui/index.html的<head>增加:
<meta name="robots" content="noindex, nofollow">
- 对
/cms/**、/admin/**在响应头统一加X-Robots-Tag: noindex, nofollow(可用一个简单 Filter 或WebConfig拦截器实现),双保险。 robots.txt已 Disallow/admin/、/cms/(见 5.1.3.1)。
**注意:**Google 要能"抓取"页面才能读到 noindex。因此 robots 里 Disallow 与页面 noindex 同时用没问题(后台本就不需要收录),但概念上要分清:Disallow 阻止抓取,noindex 阻止收录。
验收:curl -I /cms/ 含 X-Robots-Tag;后台页面源码含 noindex。
5.1.5.2、SEO 优化后台配置支持(SEO 域名 / 统计脚本 / 事件上报)
问题:SEO 域名(blog.view)如果只能靠改配置文件 / 环境变量,换域名或迁移就得重新部署;GA4 脚本若写死在 seo-head.html 和 index.html 里,更换衡量 ID、临时关闭统计、新增埋点也都要改代码。更合理的做法是把它们统一抽成后台可配置项,做到"不改代码即可开关"。
改造点:
-
后台站点设置新增配置项(复用现有
SiteSetting机制):seoDomain:SEO 域名(如https://blog.changlu.cloud),供SeoUrlResolver拼绝对 URL,优先级高于blog.view(详见 5.1.2.2);gaMeasurementId:GA4 衡量 ID(如G-XXXXXXX),空则不注入脚本;enableEventTracking:事件上报开关(true/false);- (可选)
customHeadScript:自定义 head 脚本,用于扩展其它统计平台。
-
服务端直出页按配置注入(
templates/seo/fragments/seo-head.html):
<!-- 仅当后台配置了 GA4 ID 时才注入 -->
<th:block th:if="${seo.gaMeasurementId != null and !seo.gaMeasurementId.isEmpty()}">
  <script async
          th:src="'https://www.googletagmanager.com/gtag/js?id=' + ${seo.gaMeasurementId}"></script>
  <script th:inline="javascript">
    window.dataLayer = window.dataLayer || [];
    function gtag(){dataLayer.push(arguments);}
    gtag('js', new Date());
    gtag('config', /*[[${seo.gaMeasurementId}]]*/);
  </script>
</th:block>
- SPA 页动态注入(
blog-view-ui复用已有的GET /site,不要再写死进静态index.html):
// main.js:读取站点配置,动态注入 GA4;后台改了 ID 无需重新构建
fetch('/site').then(r => r.json()).then(res => {
  const id = res.data.siteInfo.gaMeasurementId;
  if (!id) return;
  const s = document.createElement('script');
  s.async = true;
  s.src = `https://www.googletagmanager.com/gtag/js?id=${id}`;
  document.head.appendChild(s);
  window.dataLayer = window.dataLayer || [];
  window.gtag = function () { window.dataLayer.push(arguments); };
  gtag('js', new Date());
  gtag('config', id);
});
- 事件上报受开关控制(
enableEventTracking关闭时不埋点):
// 统一入口:由后台开关决定是否上报
function trackEvent(name, params) {
  if (!window.__eventTrackingEnabled) return; // 来自 siteInfo.enableEventTracking
  if (typeof gtag === 'function') gtag('event', name, params);
}
// 使用
trackEvent('click_github', { event_category: 'outbound', event_label: 'github' });
trackEvent('click_rss', { event_category: 'subscribe', event_label: 'rss' });
配置项一览:
| 配置项 | 键名 | 示例 | 说明 |
|---|---|---|---|
| GA4 衡量 ID | gaMeasurementId |
G-XXXXXXX |
空则不注入统计脚本 |
| 事件上报开关 | enableEventTracking |
true / false |
控制 GitHub / 订阅点击是否上报 |
| 自定义 head 脚本(可选) | customHeadScript |
<script>…</script> |
扩展其它统计平台 |
验收:
- 后台填入
gaMeasurementId保存后,前台页面源码出现 GA 脚本;清空后脚本消失。 enableEventTracking关闭时,点击 GitHub / RSS 不再上报事件。- 全程无需改代码、无需重新部署。
5.1.5.3、SEO 配置页(后台栏目落地)
目标:在管理后台提供「SEO优化(顶级栏目)→ SEO配置」页面,用于配置 SEO 域名(seoDomain)——即 5.1.2.2 里全站绝对地址的统一出口。
**页面位置:**侧边栏顶级栏目 SEO优化 → SEO配置(与「博客管理」「图床管理」同级)。
页面字段与取值规则:
| 字段 | 配置键 | 取值规则 |
|---|---|---|
| SEO 域名 | site_setting.seoDomain |
后台有值 → 用后台值;后台为空 → 展示配置参数 blog.view |
即"默认读取配置参数展示;后台配置了就用后台的"。
接口:
| 方法 | 路径 | 说明 |
|---|---|---|
| GET | /admin/seo/config |
返回 { seoDomain, defaultSeoDomain, configured } |
| POST | /admin/seo/config |
body { seoDomain },保存;留空表示清除后台配置、回退 blog.view |
| GET | /admin/seo/file/{name}/content |
快捷查看:返回 robots/sitemap/rss 的文本内容 |
| GET | /admin/seo/file/{name} |
快捷下载:作为附件下载(Content-Disposition: attachment) |
核心文件:快捷查看 / 下载:
页面新增「核心文件」卡片,列出三个站点级文件,每个都支持查看与下载:
| 文件 | 路径 | 说明 |
|---|---|---|
robots.txt |
/robots.txt |
抓取规则,声明 Sitemap 地址 |
sitemap.xml |
/sitemap.xml |
公开文章地图,辅助搜索引擎发现 |
rss.xml |
/rss.xml |
最近公开文章的订阅源 |
- 查看:点击「查看」→
GET /admin/seo/file/{name}/content→ 弹窗(el-dialog+<pre>深色代码块)展示文件内容。 - 下载:点击「下载」→
GET /admin/seo/file/{name}(responseType: 'blob')→ 前端创建 Blob 并触发浏览器下载。 - 单一数据源:三个文件的内容统一由
module/seo/service/SeoFileService产出,公开端点(/robots.txt等)与后台查看/下载复用同一份内容,避免不一致。
数据流:
后台「SEO配置」页
   ↓ GET /admin/seo/config
SeoConfigController
   ↓ siteSettingService.getSeoDomain()(后台值) + BlogProperties.getView()(兜底)
返回 { seoDomain: 生效值, defaultSeoDomain: blog.view, configured }
   ↓ 页面展示:seoDomain(后台为空时即 blog.view 的值)
用户保存 → POST /admin/seo/config → 写入 site_setting(seoDomain) → 清理站点缓存

查看/下载 → SeoConfigController → SeoFileService(robots/sitemap/rss)
                                          ↑ 公开端点 SeoFileController 也走同一份
已落地文件清单:
| 层 | 文件 |
|---|---|
| SQL | sql/increment/1.0/20261006000000_v1.0.x.sql(seed seoDomain) |
| 常量 | constant/SiteSettingConstants.java(SEO_DOMAIN) |
| Mapper | mapper/SiteSettingMapper.java + resources/mapper/SiteSettingMapper.xml(getSeoDomain) |
| Service | service/SiteSettingService.java + impl/SiteSettingServiceImpl.java(getSeoDomain / saveSeoDomain) |
| SEO 文件服务 | module/seo/service/SeoFileService.java + impl/SeoFileServiceImpl.java(robots/sitemap/rss 内容统一出口) |
| API | module/seo/api/SeoConfigController.java、module/seo/api/SeoFileController.java、module/seo/domain/SeoConfig.java |
| CMS | blog-cms-ui/src/api/seo.js、views/blog/seo/SeoConfig.vue、icons/svg/seo.svg(自定义 SEO 图标)、router/index.js(新增"SEO优化"顶级菜单)、settings.js |
**与 F15 的关系:**本页是 F15 的第一块落地(SEO 域名 + 核心文件查看/下载);后续 gaMeasurementId、enableEventTracking 等配置项继续加在同一页即可。
验收:
- 后台顶级栏目「SEO优化 → SEO配置」可正常打开。
- 默认展示
blog.view;保存后site_setting.seoDomain有值、再次进入展示后台值;留空保存则回退展示blog.view。 - 保存后清理站点缓存,前台生成的绝对地址使用该域名。
- 「核心文件」卡片可对
robots.txt/sitemap.xml/rss.xml逐个查看(弹窗展示内容)与下载(保存到本地)。
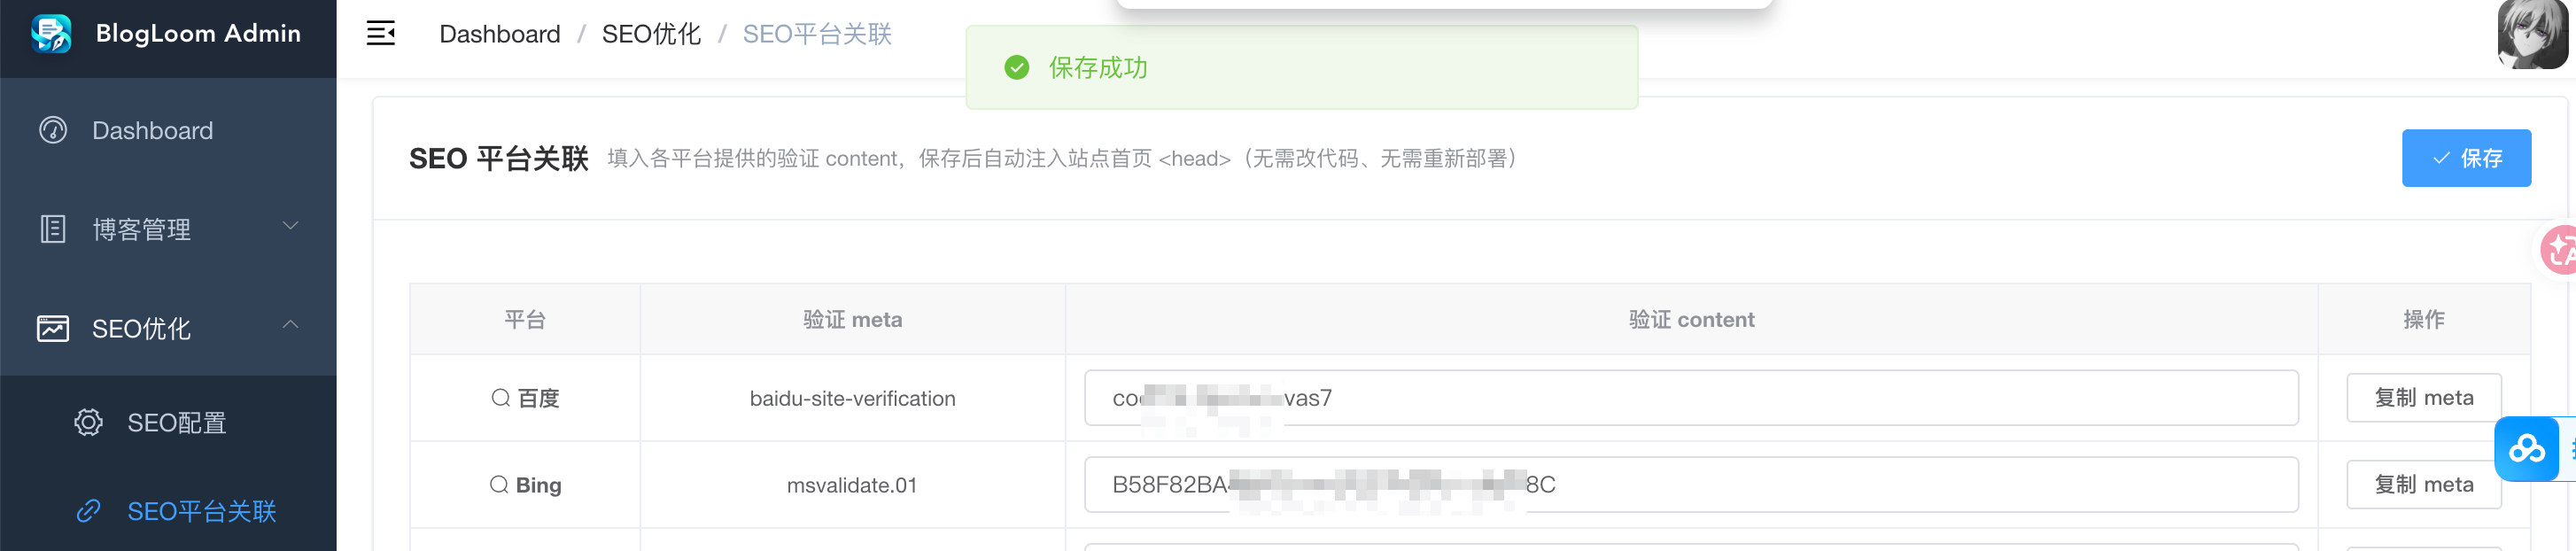
5.1.5.4、SEO 平台关联(站点验证,方案 B)
目标:在后台「SEO优化 → SEO平台关联」配置百度 / Bing / Google 的站点验证 content,保存后自动注入站点首页 <head>,无需改代码、无需重新部署。
**页面位置:**侧边栏顶级栏目 SEO优化 → SEO平台关联。
页面字段与配置键:
| 平台 | 验证 meta | 配置键(site_setting) |
|---|---|---|
| 百度 | baidu-site-verification |
baiduSiteVerification |
| Bing | msvalidate.01 |
bingSiteVerification |
google-site-verification |
googleSiteVerification |
每平台一个配置:用户从平台后台复制整段验证代码中的
content值填入即可;页面提供「复制 meta」按钮。
接口:
| 方法 | 路径 | 说明 |
|---|---|---|
| GET | /admin/seo/verification |
返回 { baidu, bing, google } |
| POST | /admin/seo/verification |
body { baidu, bing, google },保存 |
注入实现(方案 B:SPA 入口注入):
由于根路径 / 由 SPA 的 index.html 承载,而百度验证不执行 JS,必须在服务端返回的 HTML 里就有验证 meta。实现方式:
GET /  或  /index.html
   ↓ SpaForwardFilter:/ 回退到 /index.html(其它 SPA 路由同理)
SpaIndexController(@Controller)
   ↓ 读取前台构建产物 conf/static/view/index.html
   ↓ 取 site_setting 中的三个验证 content,SeoVerificationSupport 拼接 meta
   ↓ 注入 </head> 之前
返回注入后的 HTML(浏览器 URL 不变)
SpaIndexController映射/、/index.html,因此所有回退到 SPA 的页面(/moments、/friends等)都会带上验证 meta;未配置时原样返回。
已落地文件清单:
| 层 | 文件 |
|---|---|
| 常量 | constant/SiteSettingConstants.java(BAIDU_/BING_/GOOGLE_SITE_VERIFICATION) |
| Service | service/SiteSettingService.java + impl/SiteSettingServiceImpl.java(getSeoVerifications / saveSeoVerifications) |
| 支持类 | module/seo/support/SeoVerificationSupport.java(meta 拼接与注入) |
| API | module/seo/api/SeoVerificationController.java(GET/POST /admin/seo/verification)、module/seo/api/SpaIndexController.java(方案 B 注入)、module/seo/domain/SeoVerification.java |
| CMS | blog-cms-ui/src/api/seo.js、views/blog/seo/SeoVerification.vue、router/index.js(新增"SEO平台关联"菜单) |
验收:
- 后台「SEO优化 → SEO平台关联」可打开,三个平台各有一个 content 输入框与「复制 meta」按钮。
- 填入并保存后,
curl -s https://域名/ | grep 'baidu-site-verification'能命中对应 meta。 - 清空后保存,对应 meta 从首页源码消失。
5.1.6、阅读页性能优化
5.1.6.1、代码优化:阅读页性能与资源加载
**问题:**详情页正文图片未懒加载,index.html 里 Prism / APlayer / Meting / tocbot 等脚本在首屏同步加载,拖慢 LCP,还可能因图片无尺寸造成 CLS。
改造点:
- 正文图片懒加载:Thymeleaf 渲染正文后,给正文区
<img>加loading="lazy"与decoding="async";首屏封面图除外,反而给fetchpriority="high"。
<!-- 首屏封面:优先加载 -->
<img th:src="${article.firstPicture}" fetchpriority="high" width="1200" height="630" alt="封面">
<!-- 正文图片:懒加载 -->
<img loading="lazy" decoding="async" alt="">
-
给图片/广告位预留尺寸:统一设置
width/height或 CSSaspect-ratio,避免加载后把正文顶下去(CLS)。 -
第三方脚本异步化:把 Prism / APlayer / Meting / tocbot 改为
<script defer>或按需动态import(),不阻塞首屏。 -
静态资源缓存与压缩:Vite 构建产物已带 hash,配合长缓存;后端开启
server.compression.enabled=true(gzip/br)。 -
统计脚本异步:GA4 脚本一律
async(见 5.2.1)。
**验收:**PageSpeed Insights / Lighthouse 中 LCP、CLS 明显改善;Open DevTools Network 可见正文图片为懒加载。
5.2、搜索引擎平台收录
代码改完只是**"具备被收录的条件",并不等于马上被收录。下面这部分讲清楚:如何针对 blog.changlu.cloud 一步步推动国外(Google、Bing)与国内(百度)**搜索引擎真正收录文章,并持续监测。
5.3 为变现预习(Google AdSense 广告接入)。它不在"收录最小闭环"内,属于 1.4 的三阶段;但 AdSense 审核依赖一阶段产出的可抓取内容、sitemap 与合规页面,故提前规划。
三个平台的通用前提:F7/F8 已完成,
https://blog.changlu.cloud/sitemap.xml能公开访问(curl返回 200)。
5.2.1、数据监测接入
**目标:**能回答"有没有被收录""人从哪来""哪篇最受欢迎"。建议按下面顺序接入——先 Search Console(决定收录),再访问统计(本阶段用 GA4)。
接入顺序总览
| 步骤 | 做什么 | 入口网址 | 产出 |
|---|---|---|---|
| ① | 验证站点所有权 | https://search.google.com/search-console/ | 站点资源建立 |
| ② | 提交 Sitemap | 上方站点 → 左侧"站点地图" | 加速发现收录 |
| ③ | 创建访问统计 | https://analytics.google.com/ | 拿到衡量 ID |
| ④ | 安装统计脚本 | 代码:公共 head 片段 + blog-view-ui/index.html |
开始上报 |
| ⑤ | 配置事件埋点 | GA4 事件 | GitHub / 订阅点击 |
| ⑥ | 验证数据 | GA4 实时报表 / Search Console | 数据可见 |
**前置条件:**F7/F8 已完成,https://blog.changlu.cloud/sitemap.xml 能公开访问(curl 返回 200)。
Step ① 验证站点所有权(Search Console)
- 打开 https://search.google.com/search-console/ ,用 Google 账号登录。
- 左上角"添加资源",选**"网域"**方式,填
blog.changlu.cloud。 - 复制给出的 TXT 记录(形如
google-site-verification=xxxx),到你的 DNS 服务商添加一条 TXT 解析。 - 回到 Search Console 点"验证",通过后资源建立。
- 若不便改 DNS,也可选"网址前缀"方式:填
https://blog.changlu.cloud/,用 HTML 文件或<meta name="google-site-verification" content="...">验证。
- 若不便改 DNS,也可选"网址前缀"方式:填
Step ② 提交 Sitemap
- 进入该资源,左侧菜单点 "站点地图 / Sitemaps"。
- 输入框填
sitemap.xml(完整地址https://blog.changlu.cloud/sitemap.xml),点"提交"。 - 状态变为"成功"即被读取;收录需等 Google 抓取,通常几天到几周,不必反复提交。
Step ③ 创建访问统计(本阶段选定 GA4)
- 打开 https://analytics.google.com/ → "管理" → 创建媒体资源。
- 在资源下创建网站数据流(Web),网址填
https://blog.changlu.cloud。 - 记下生成的衡量 ID(Measurement ID,形如
G-XXXXXXX)。
备选:若日后希望数据自持,可改用自建 Umami(https://umami.is/),接入方式类似;本阶段先用 GA4 即可,不必两边都接。
Step ④ 安装统计脚本(两处都要放)
**推荐:**用 F15 后台配置实现(见 5.1.5.2),后台填 GA4 ID 即自动注入,无需改代码;下面为手动方式,供未做后台时参考。
- 服务端直出页:放进公共片段
templates/seo/fragments/seo-head.html(或用 F15 片段按配置注入)。 - SPA 页:由
main.js读取GET /site动态注入(或用 F15 方案,避免写死进index.html)。 - 脚本一律
async,避免阻塞首屏。
<!-- GA4 示例,G-XXXXXXX 换成你的衡量 ID -->
<script async src="https://www.googletagmanager.com/gtag/js?id=G-XXXXXXX"></script>
<script>
  window.dataLayer = window.dataLayer || [];
  function gtag(){dataLayer.push(arguments);}
  gtag('js', new Date());
  gtag('config', 'G-XXXXXXX');
</script>
Step ⑤ 配置事件埋点(GA4)
**推荐:**通过 F15 的"事件上报开关"统一控制(见 5.1.5.2);下面为直接埋点写法。
GitHub 入口、RSS/订阅入口的点击需显式上报事件(GA4 不会自动识别):
// 点击 GitHub 入口
gtag('event', 'click_github', { event_category: 'outbound', event_label: 'github' });
// 点击 RSS 订阅
gtag('event', 'click_rss', { event_category: 'subscribe', event_label: 'rss' });
Step ⑥ 验证
- GA4:打开"实时(Realtime)"报表,用手机访问博客,能看到当前访问与埋点事件。
- Search Console:确认"站点地图"状态为"成功";用"网址检查"输入一篇文章 URL,能显示是否可编入索引。
三组数据分开看
| 想看什么 | 主要看哪里 |
|---|---|
| 收录、搜索关键词、展示/点击/排名 | Search Console |
| 用户数、PV、来源、热门文章 | GA4(或 Umami) |
| ⑤ | 广告展示、收益、结算 |
官方帮助:Search Console 验证站点所有权 https://support.google.com/webmasters/answer/9008080 ;GA4 创建数据流 https://support.google.com/analytics/answer/9304153 。
**验收:**Search Console 站点地图状态为"成功"且开始抓取;GA4 实时报表能看到当前访问与埋点事件。
5.2.2、Google 平台收录(国外)
**平台入口:**https://search.google.com/search-console/
**目标:**让 blog.changlu.cloud 的文章进入 Google 索引(国外主战场)。
操作步骤:
-
验证所有权:添加资源,选"网域"方式填
blog.changlu.cloud,在 DNS 服务商加 TXT 记录后验证;或选"网址前缀"https://blog.changlu.cloud/,用 HTML 文件 /<meta name="google-site-verification" content="...">验证。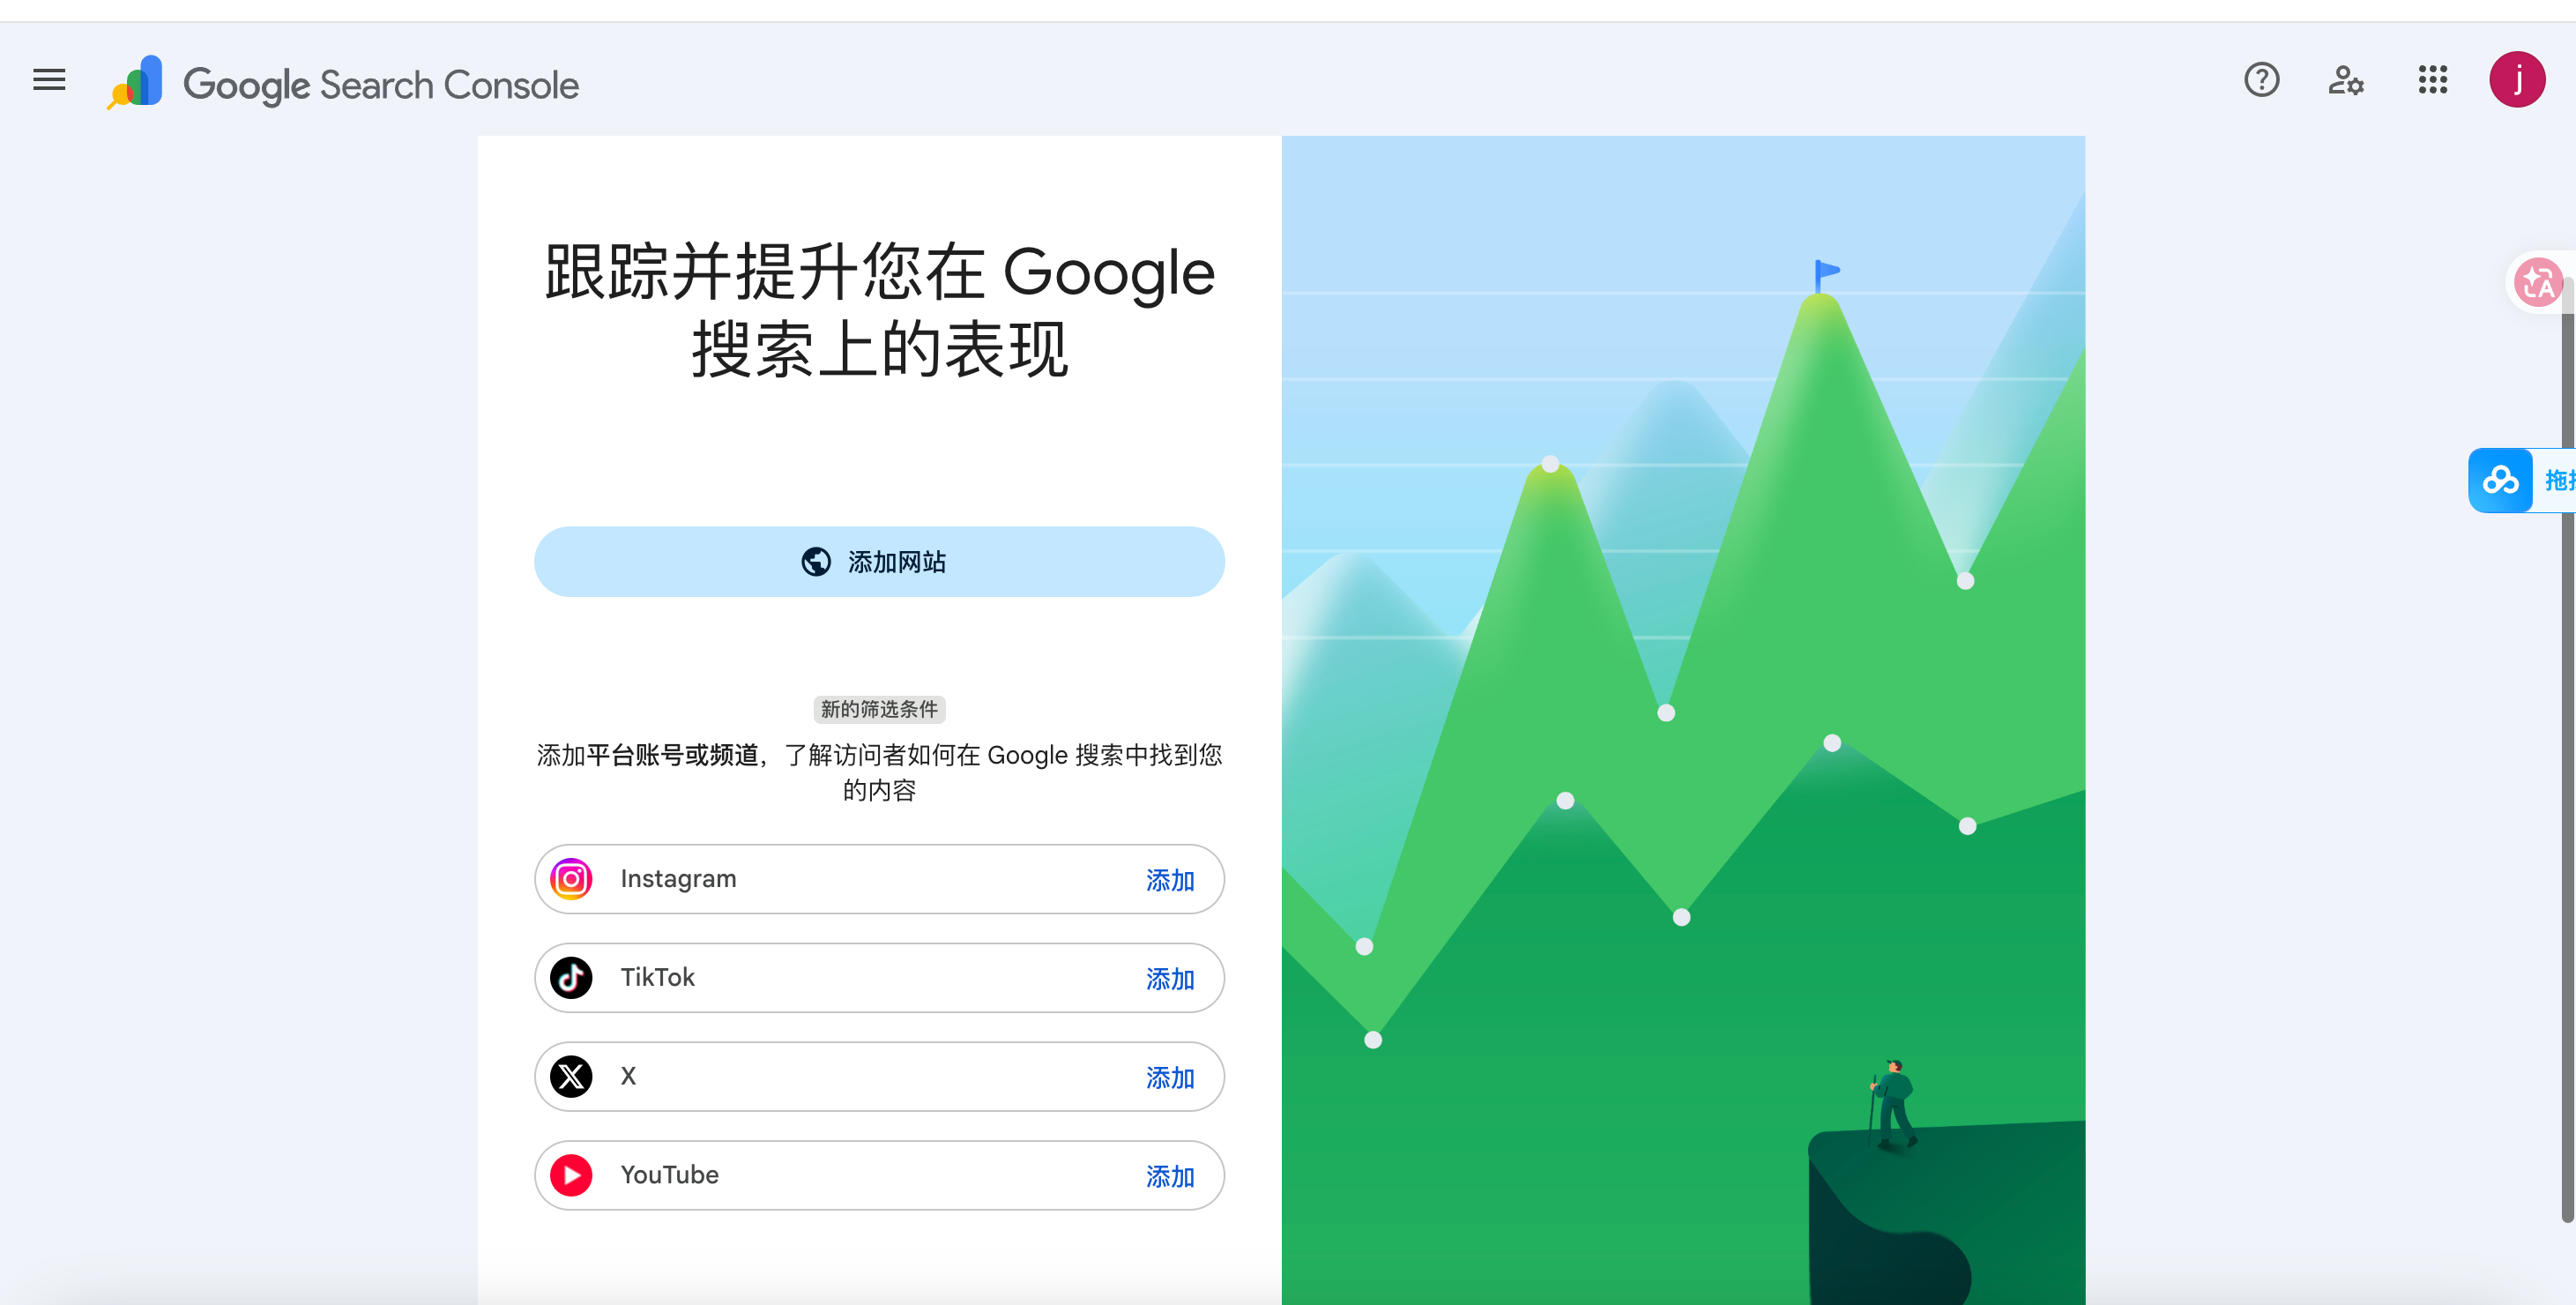
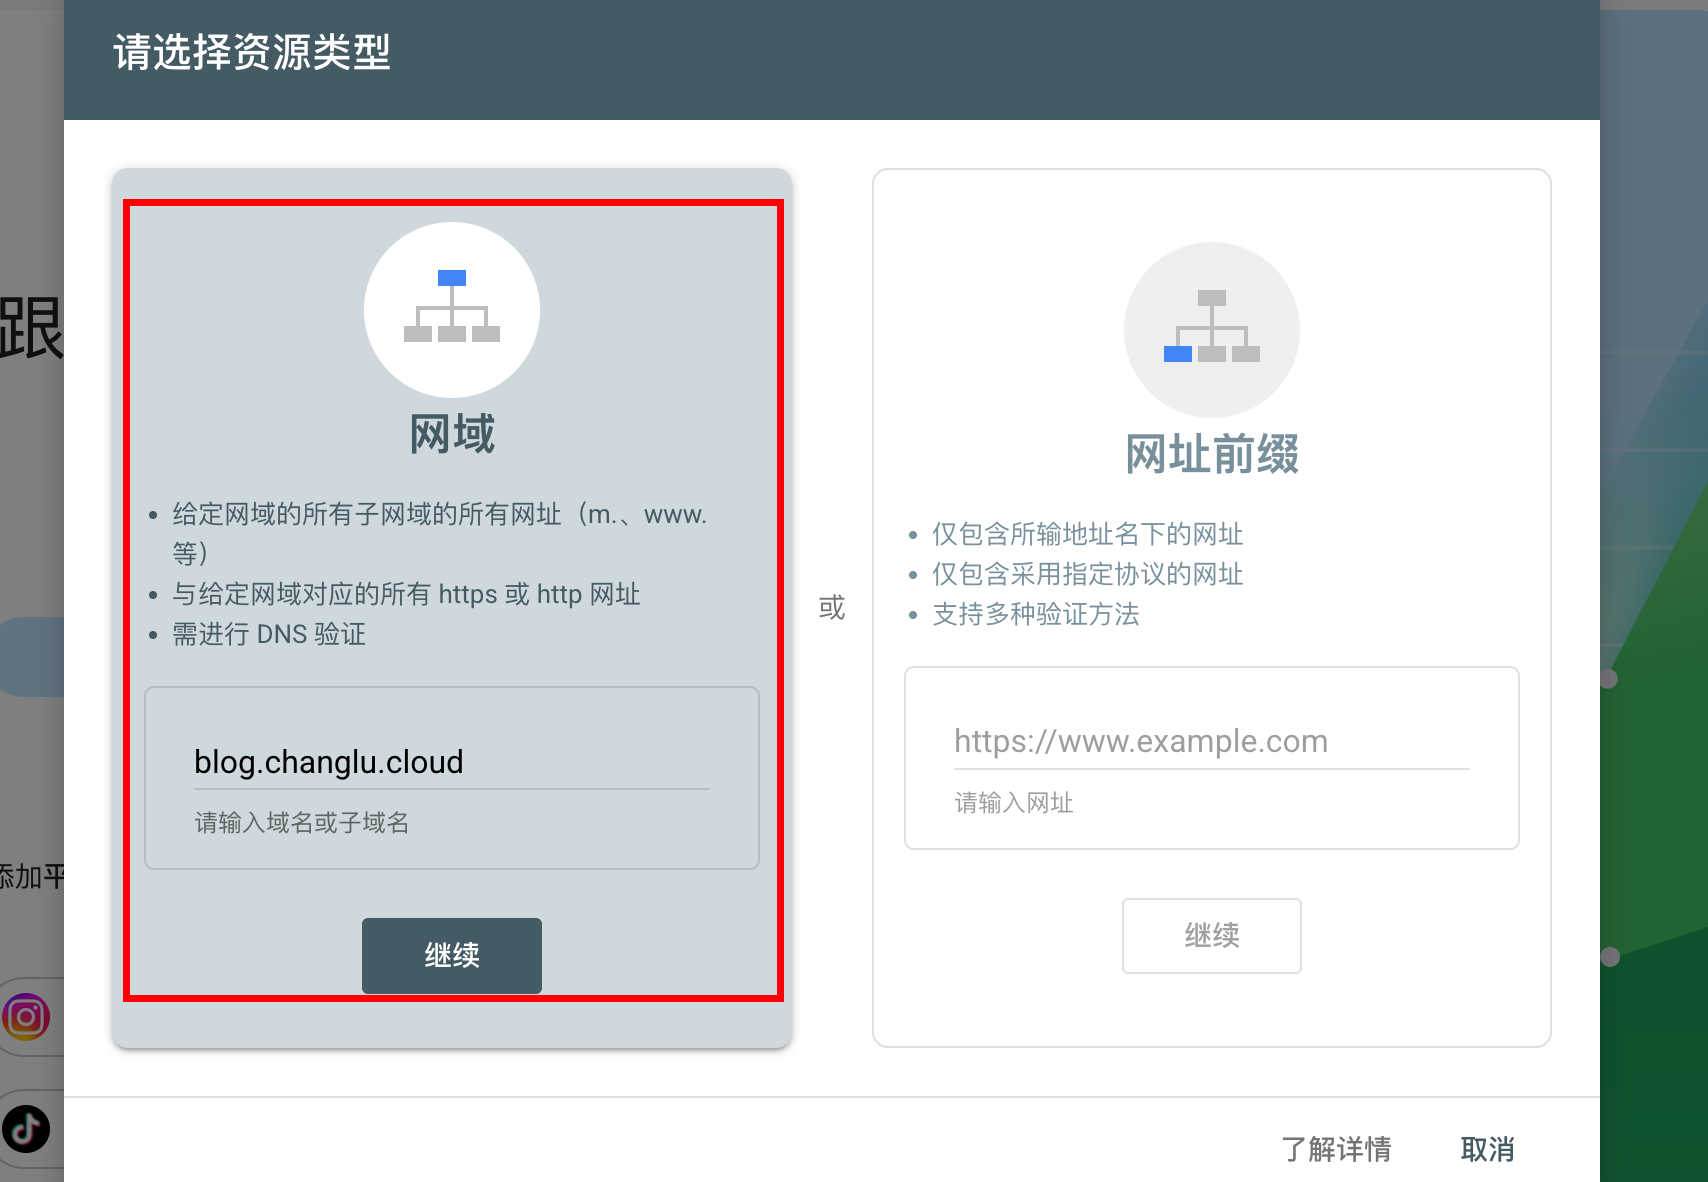
需要在dns域名映射配置中填写txt:
配置的腾讯云DNS配置如下:
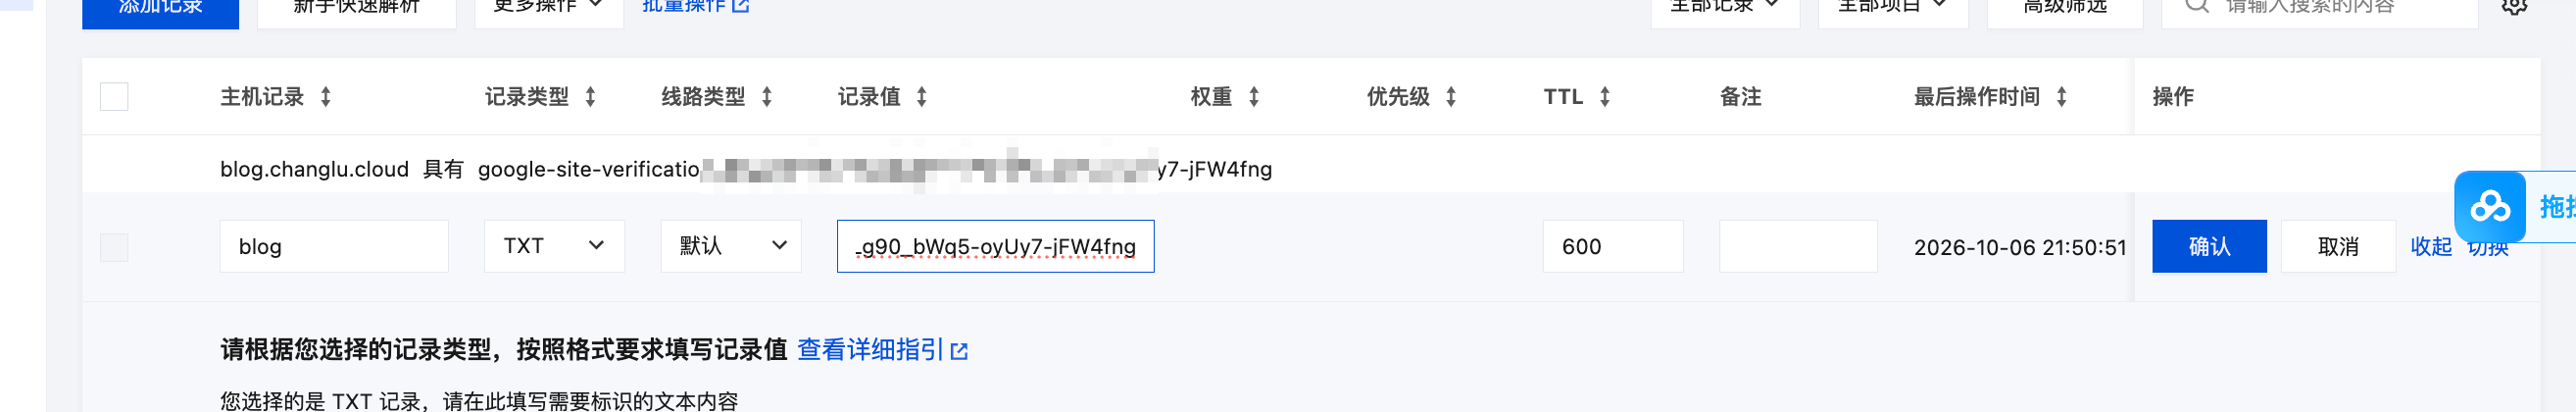
保存好进行google console验证即可,验证通过:
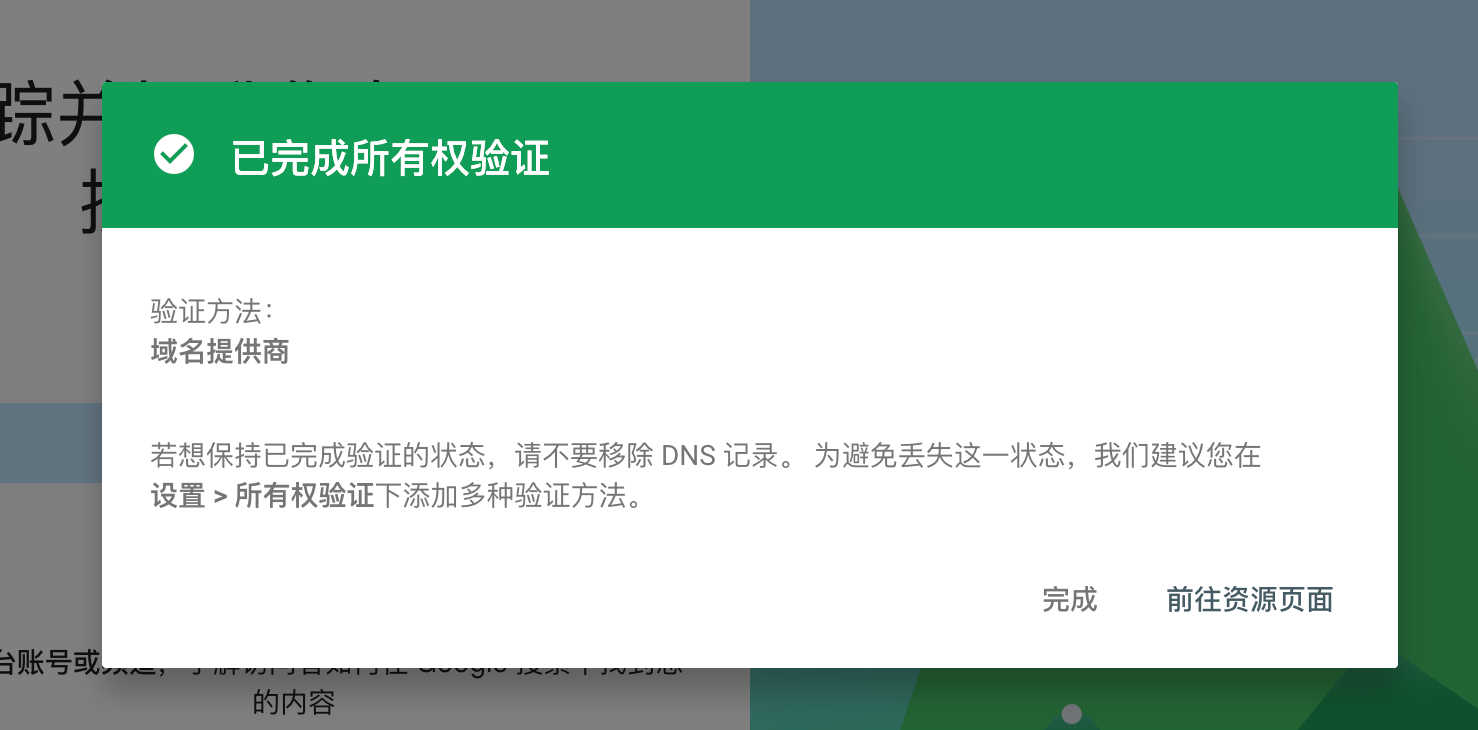
-
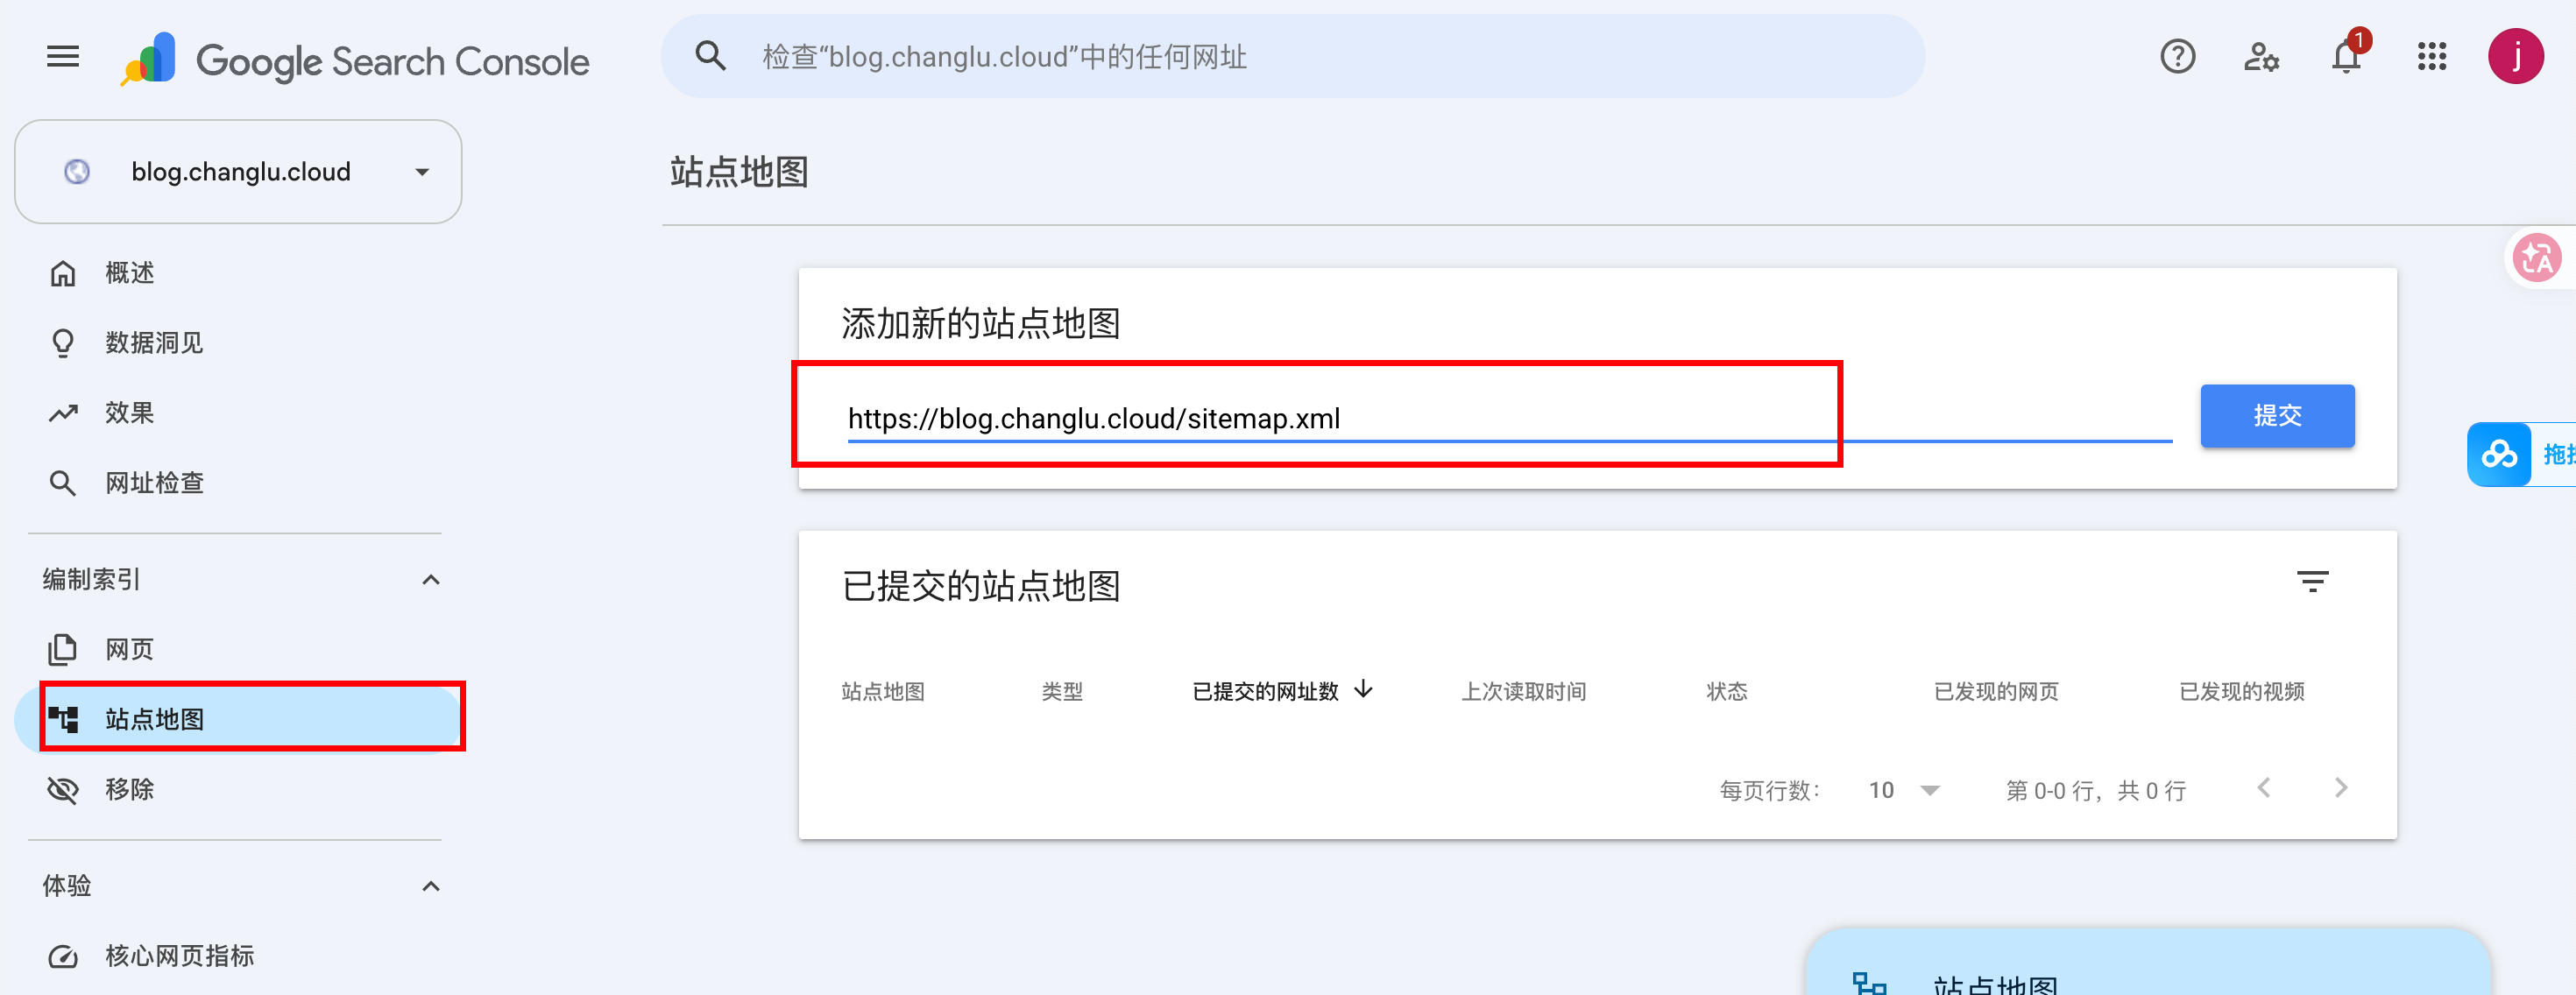
提交 Sitemap:左侧"站点地图",提交
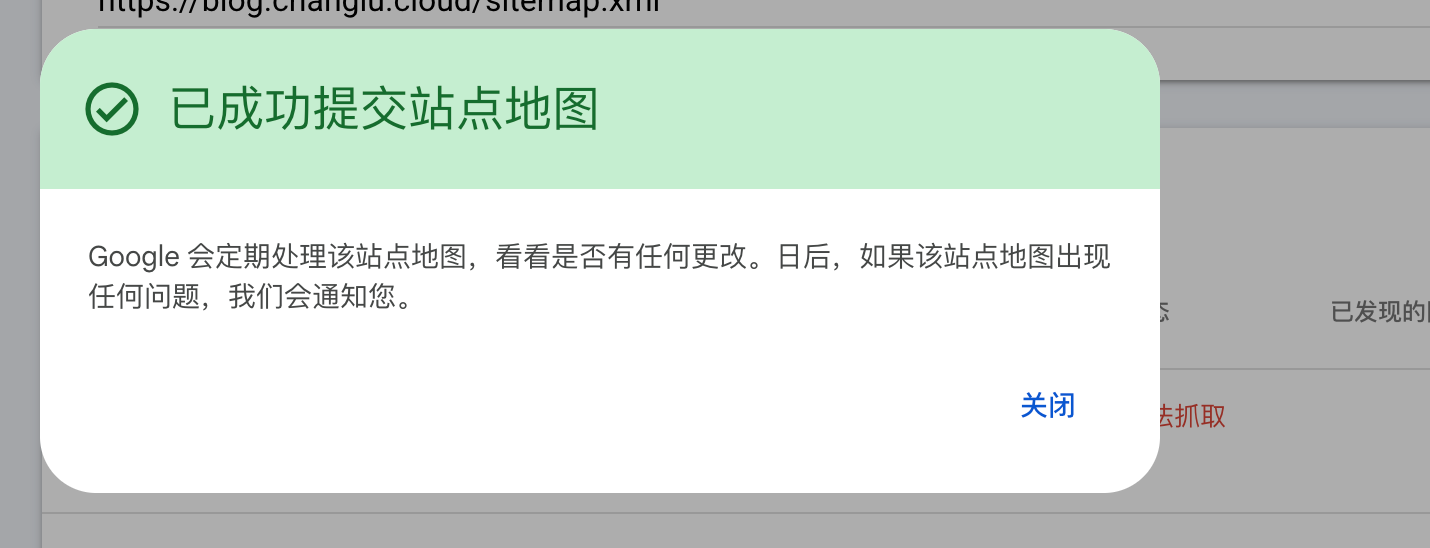
https://blog.changlu.cloud/sitemap.xml。选择对应的博客域名然后进行站点地图配置:
提交成功:
后续就是进行等待提交了:
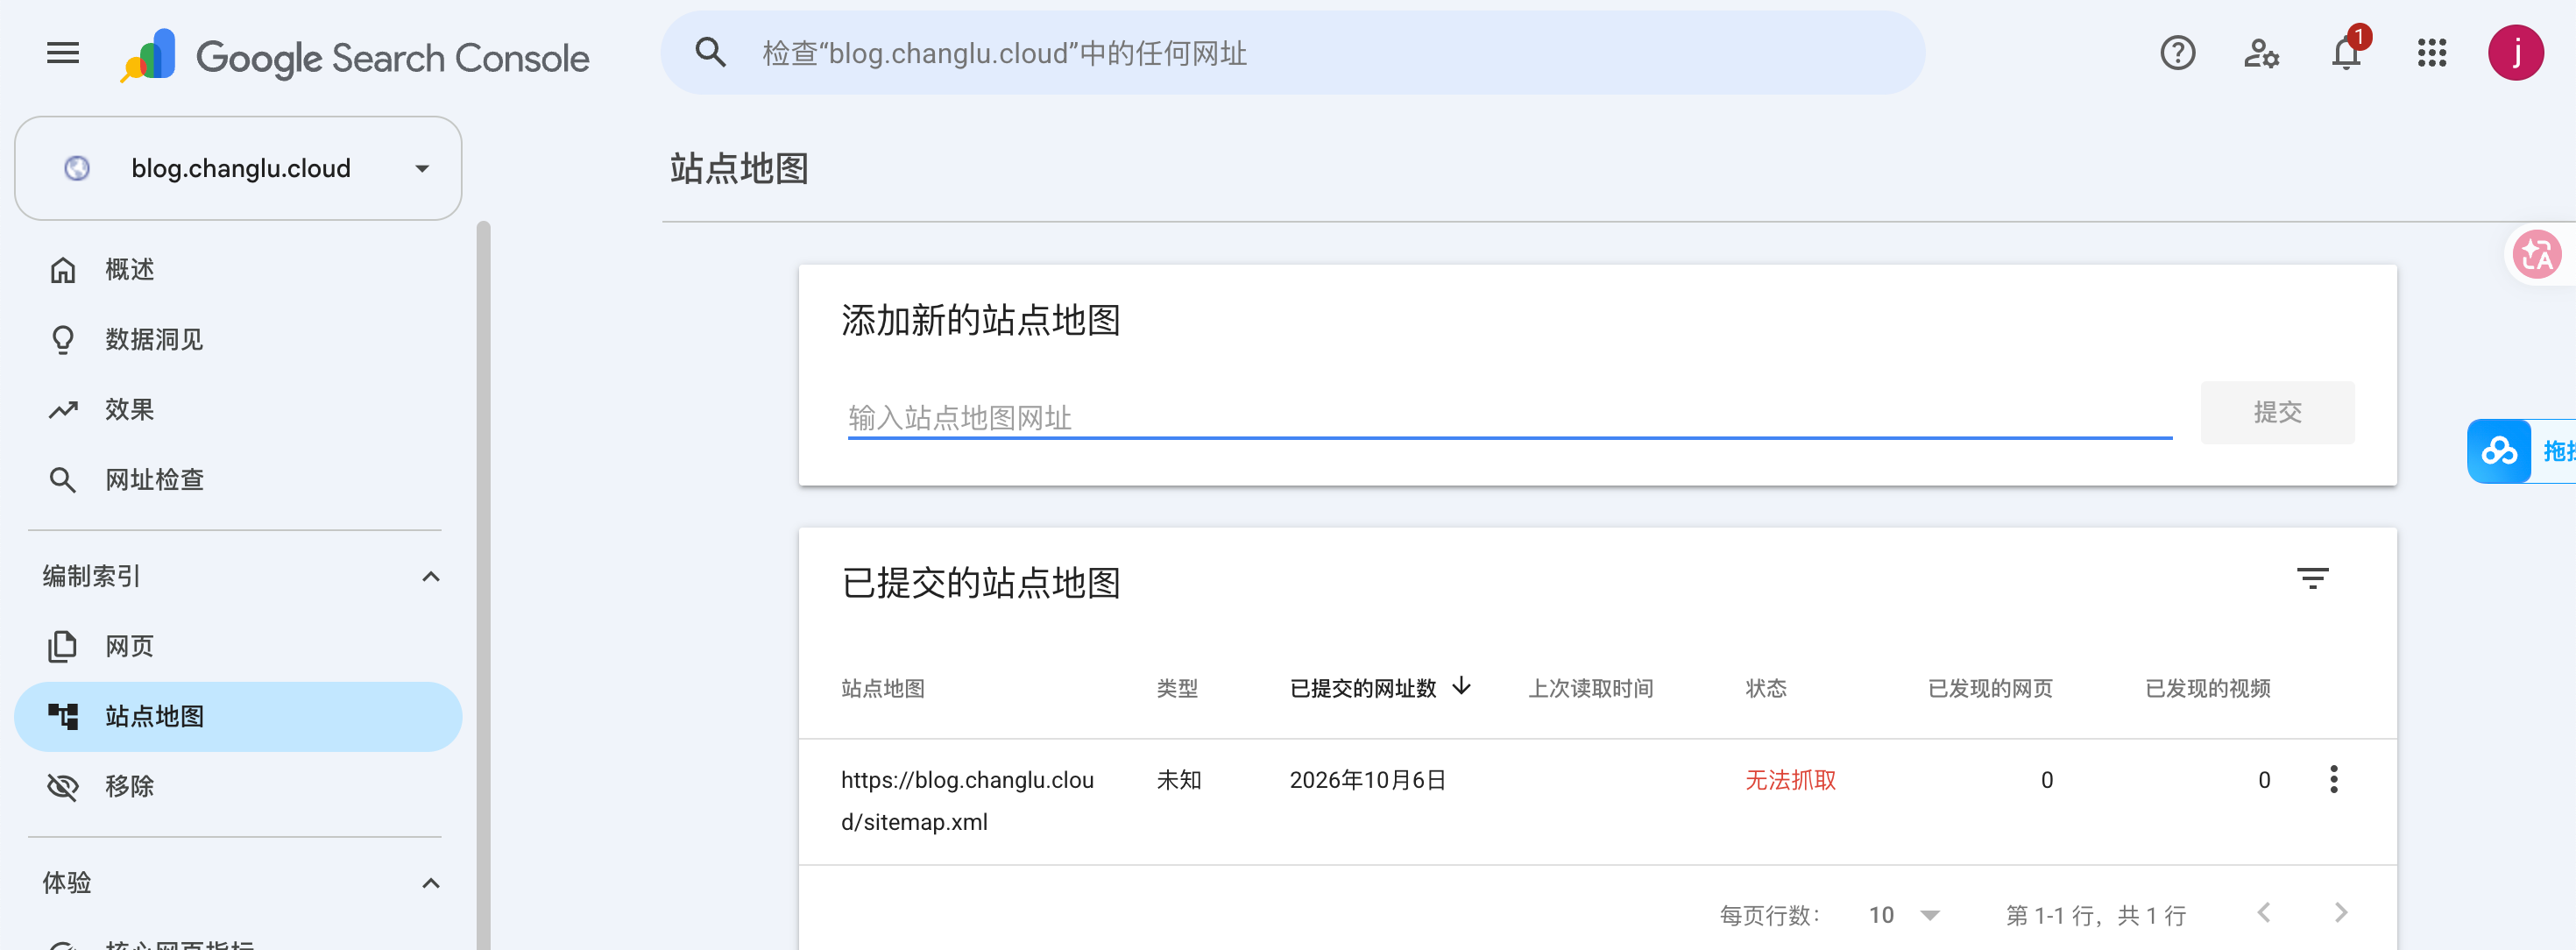
自己测试验证为:
# 测试curl
curl -A "Googlebot" \
-sS -o /dev/null \
-w "HTTP=%{http_code}\nTYPE=%{content_type}\nSIZE=%{size_download}\n" \
https://blog.changlu.cloud/sitemap.xml

# 返回值
HTTP=200
TYPE=application/xml;charset=UTF-8
SIZE=52765
Google 官方明确把
robots.txt阻止 Sitemap、404、服务器暂时不可用等列为 SitemapCouldn't fetch的主要原因。谷歌帮助,所以如果 -
请求编入索引(新文章):用"网址检查"输入
https://blog.changlu.cloud/blog/513,确认"网址可编入索引"后点"请求编入索引"。搜索对应的google search console即可:
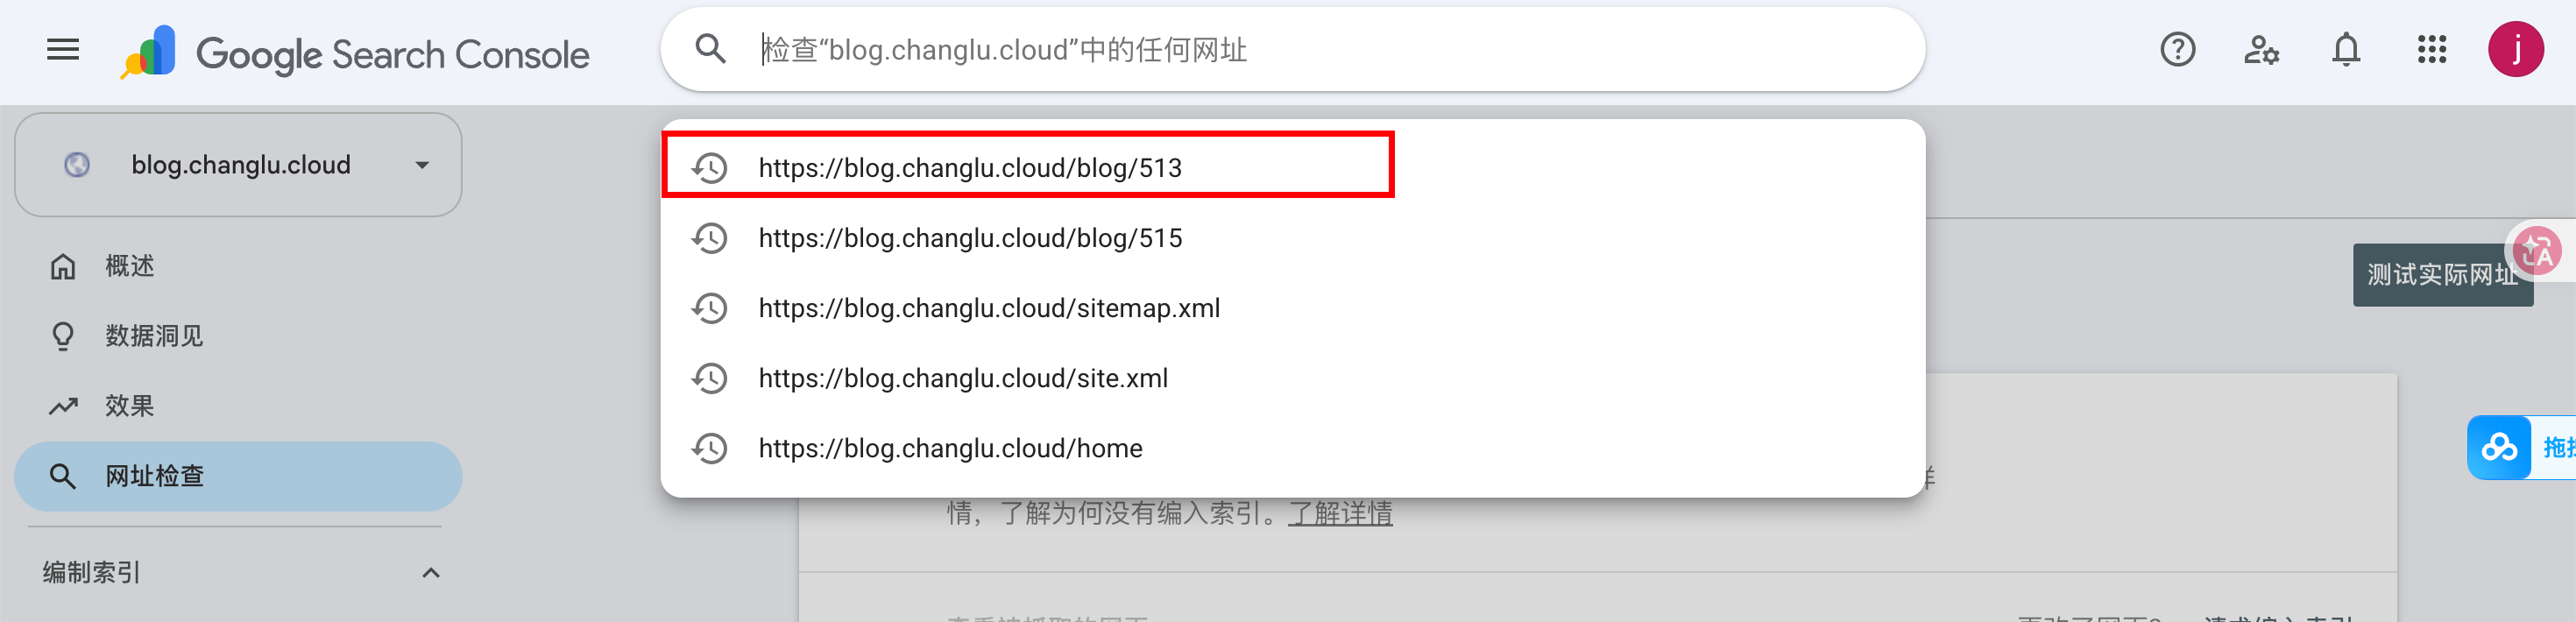
进行测试并进行请求编入索引即可:
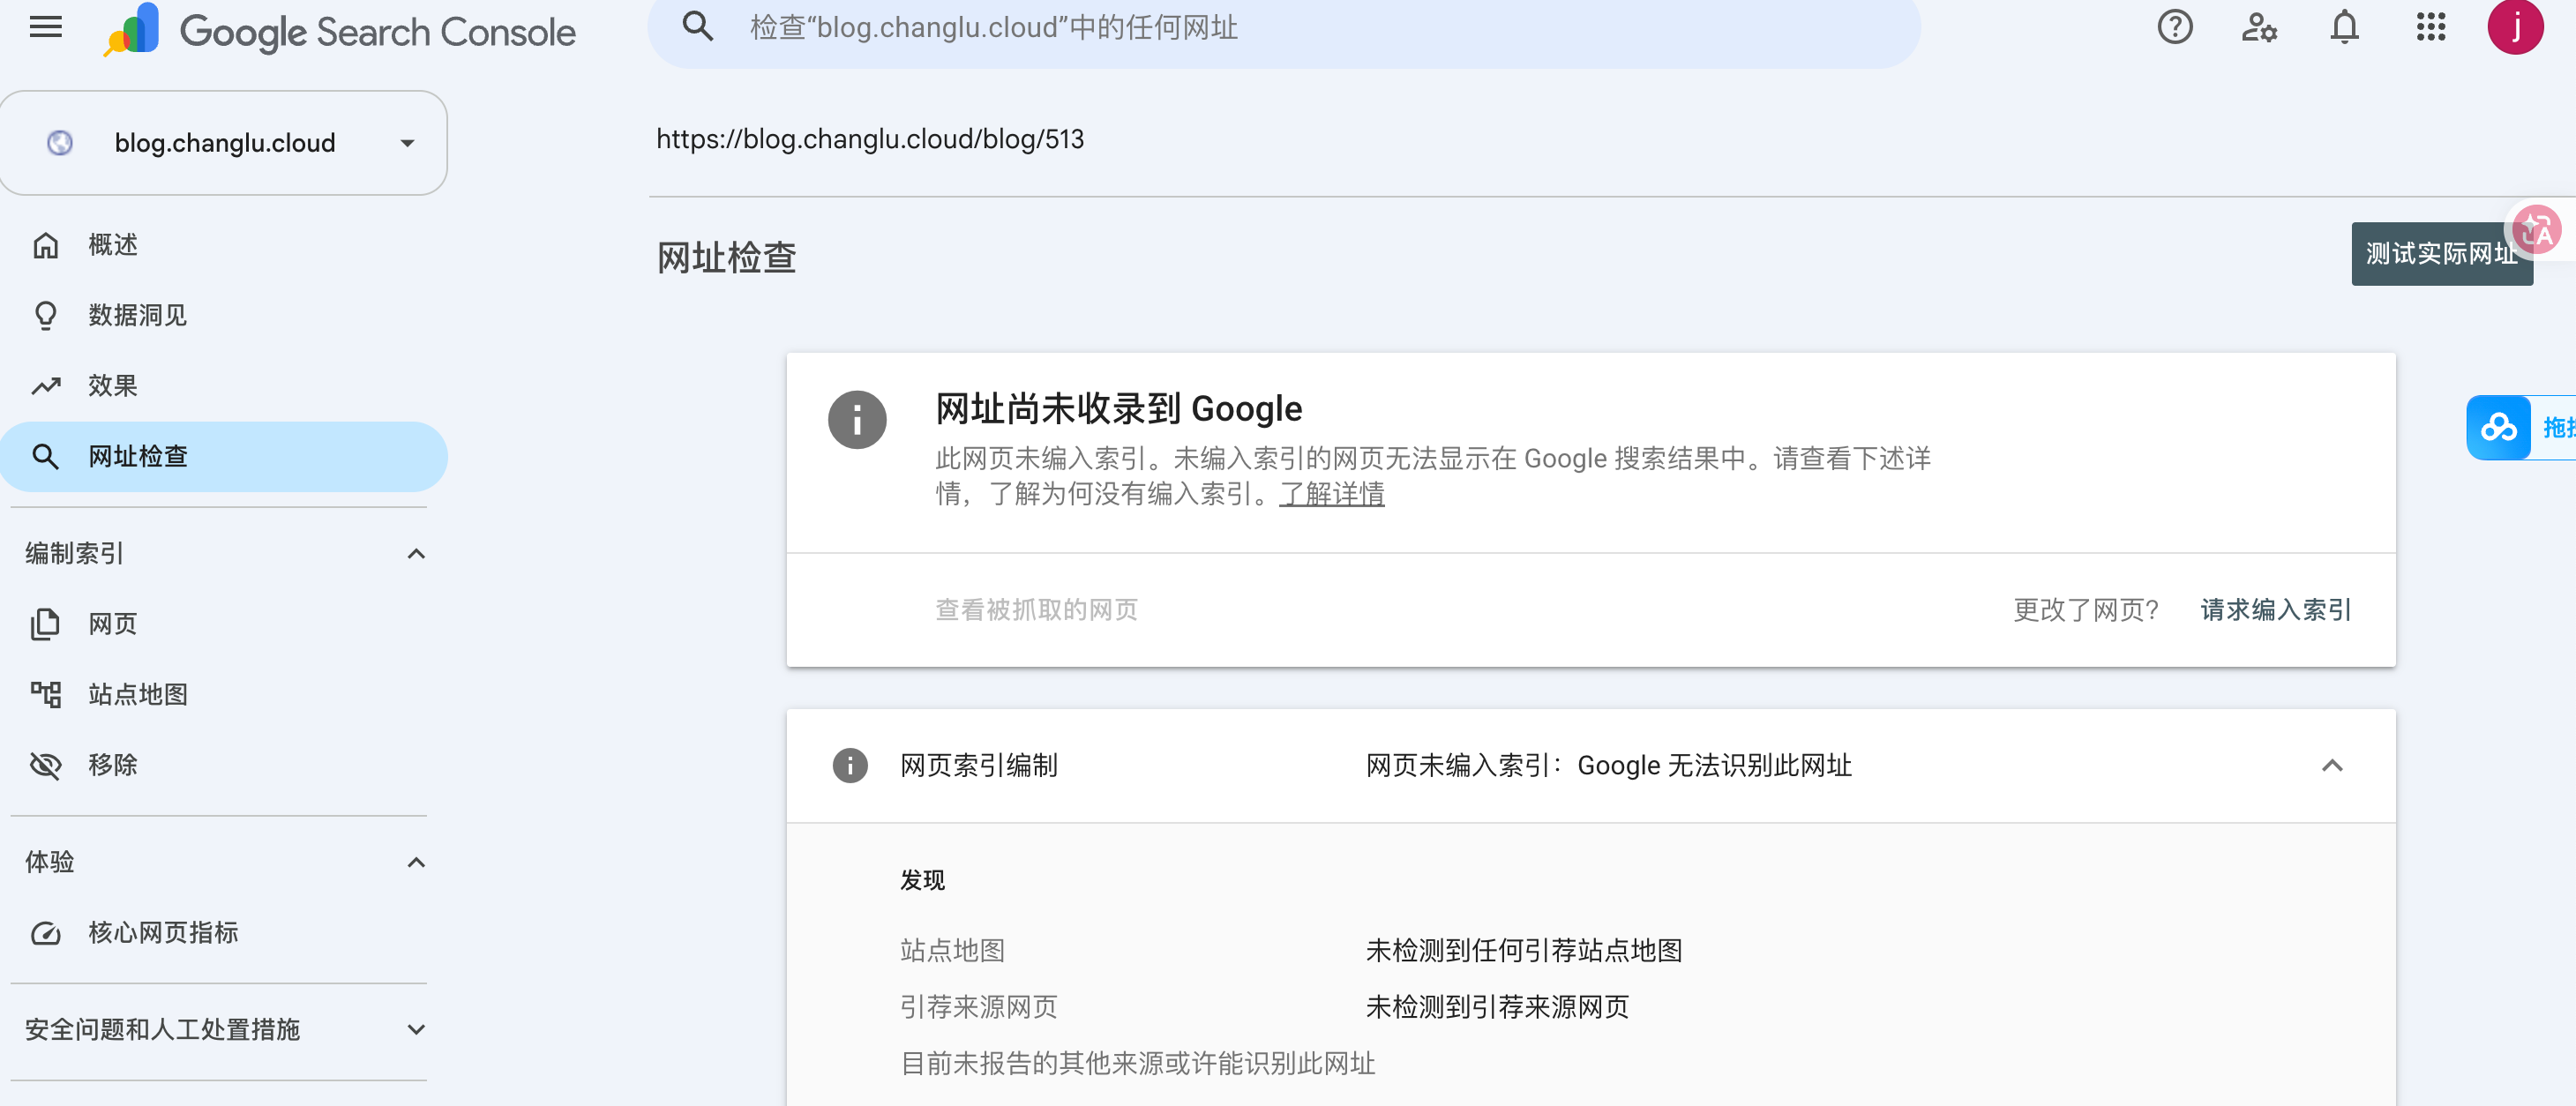
-
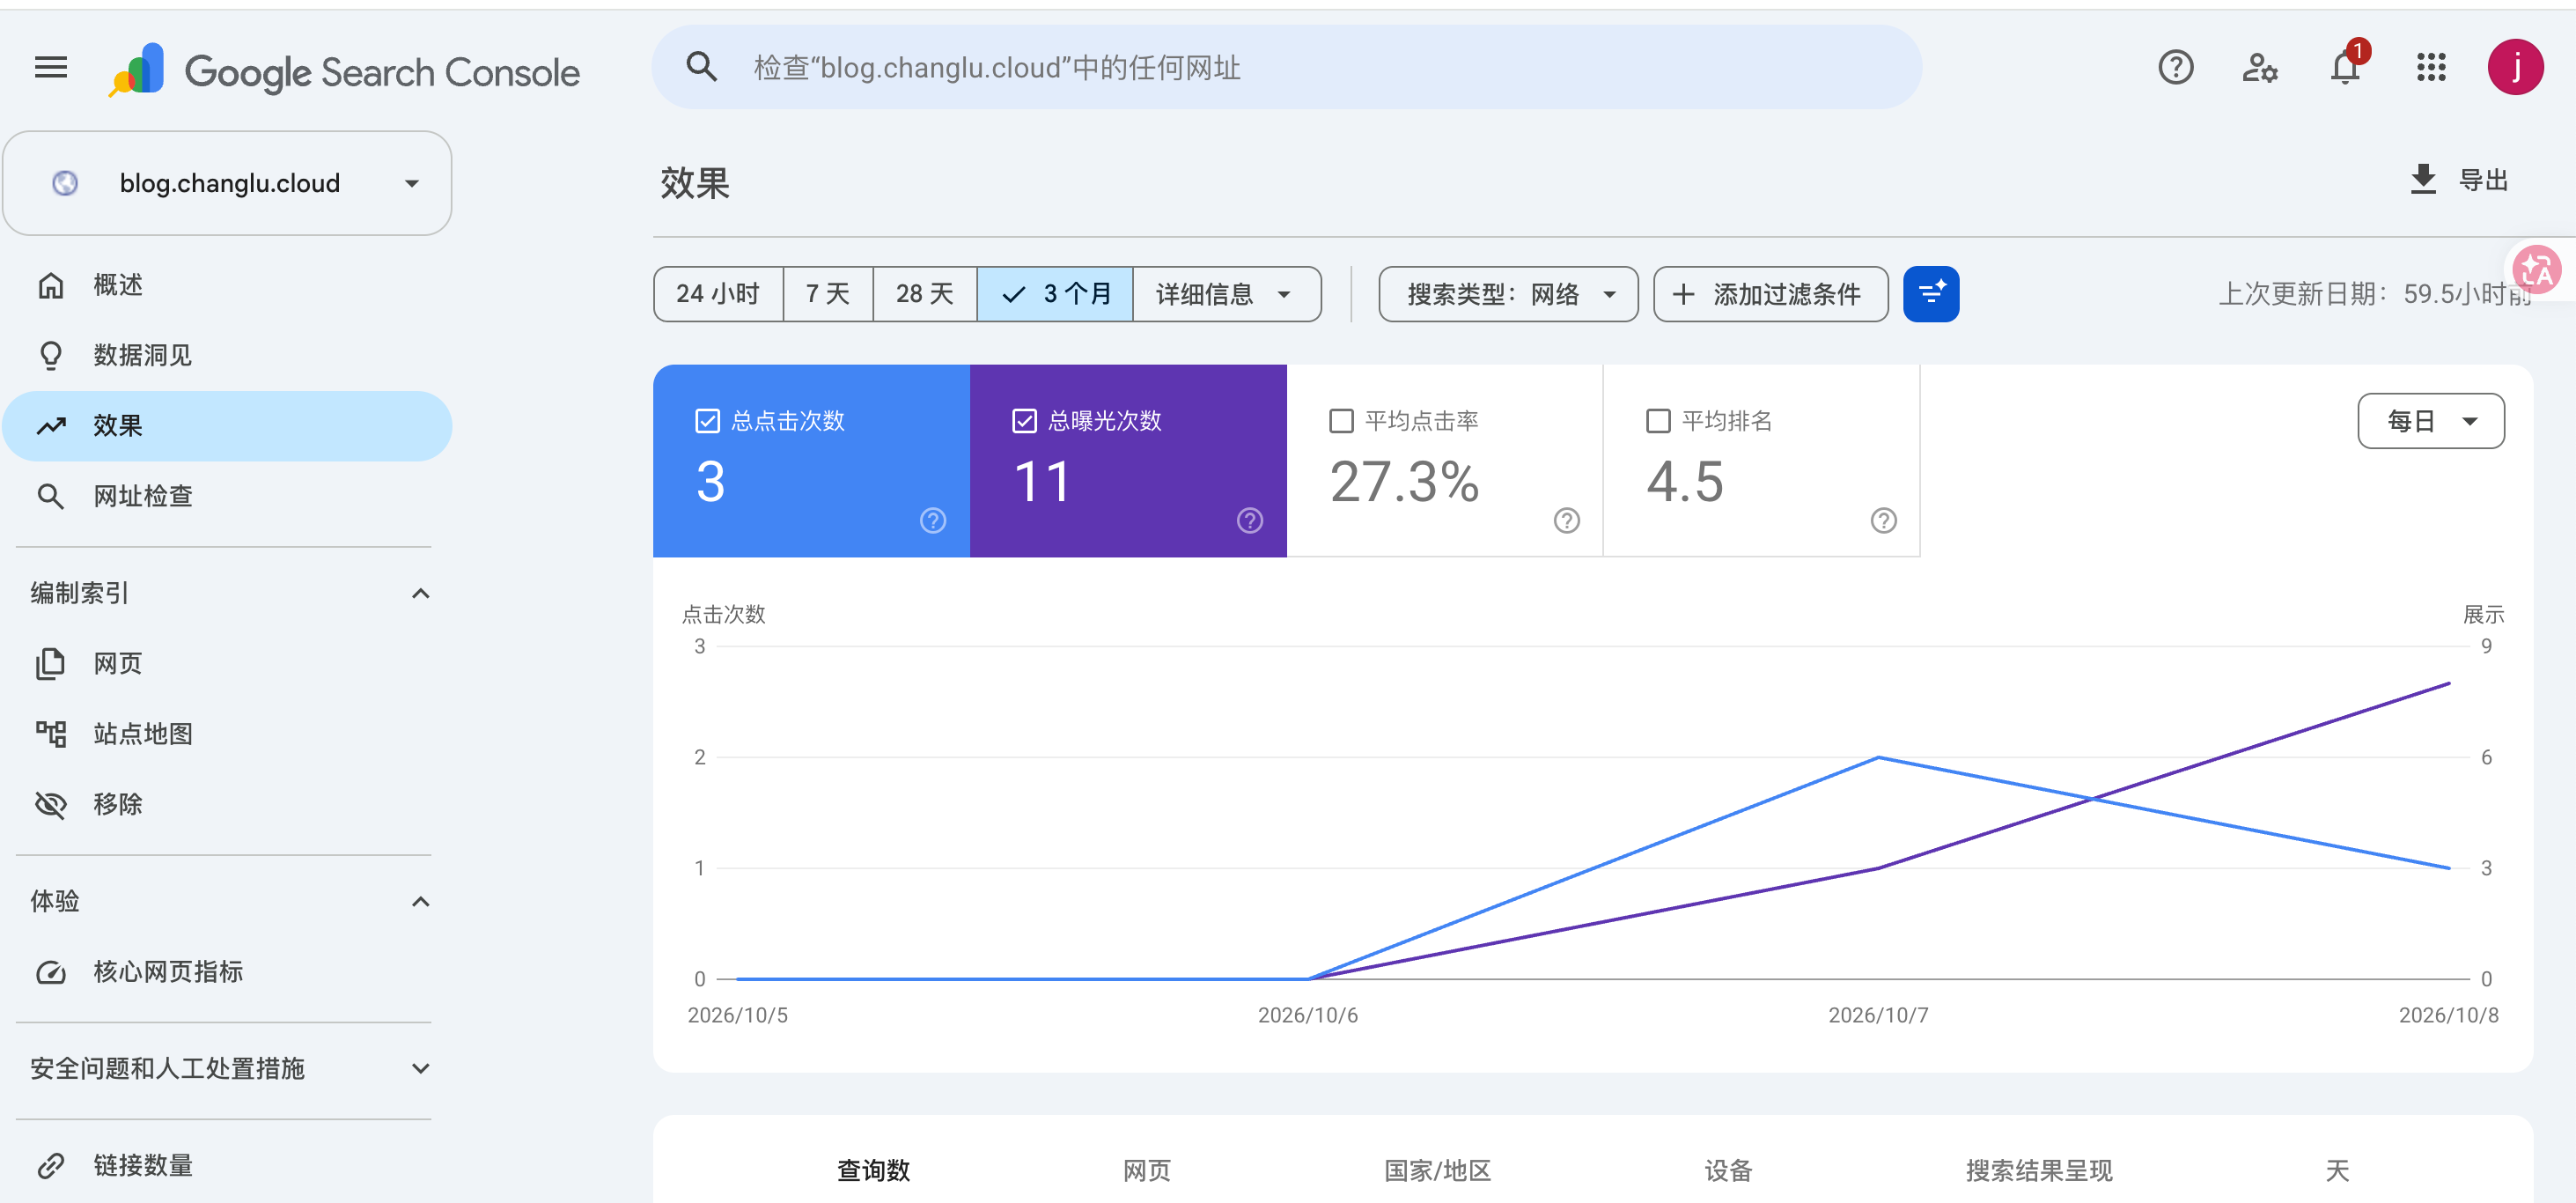
等待抓取与收录:通常数天到数周,不要反复狂点,重点是把内容与结构做好。
大概10.11日,过了一周左右就可以看到数据了:
**主动推送:**Google 没有开放的主动推送 API,也不采用 IndexNow。所以 Google 这边不用找"推送接口",做法就是 Sitemap + 站内内链 + Search Console 手动请求。
注意:提交 / 请求不等于一定收录,也不等于排名靠前——它只是"通知",最终由 Google 判断。
5.2.3、百度平台收录(国内)
说明:需要绑定微信、手机号、邮箱以及进行身份验证
**平台入口:**https://ziyuan.baidu.com/
**目标:**让 blog.changlu.cloud 的文章进入百度索引(国内主战场),点击进入到百度平台的站点管理:https://ziyuan.baidu.com/site/index。
操作步骤:
-
验证站点:添加站点
https://blog.changlu.cloud,用文件验证 / HTML 标签 / CNAME 任一种方式验证。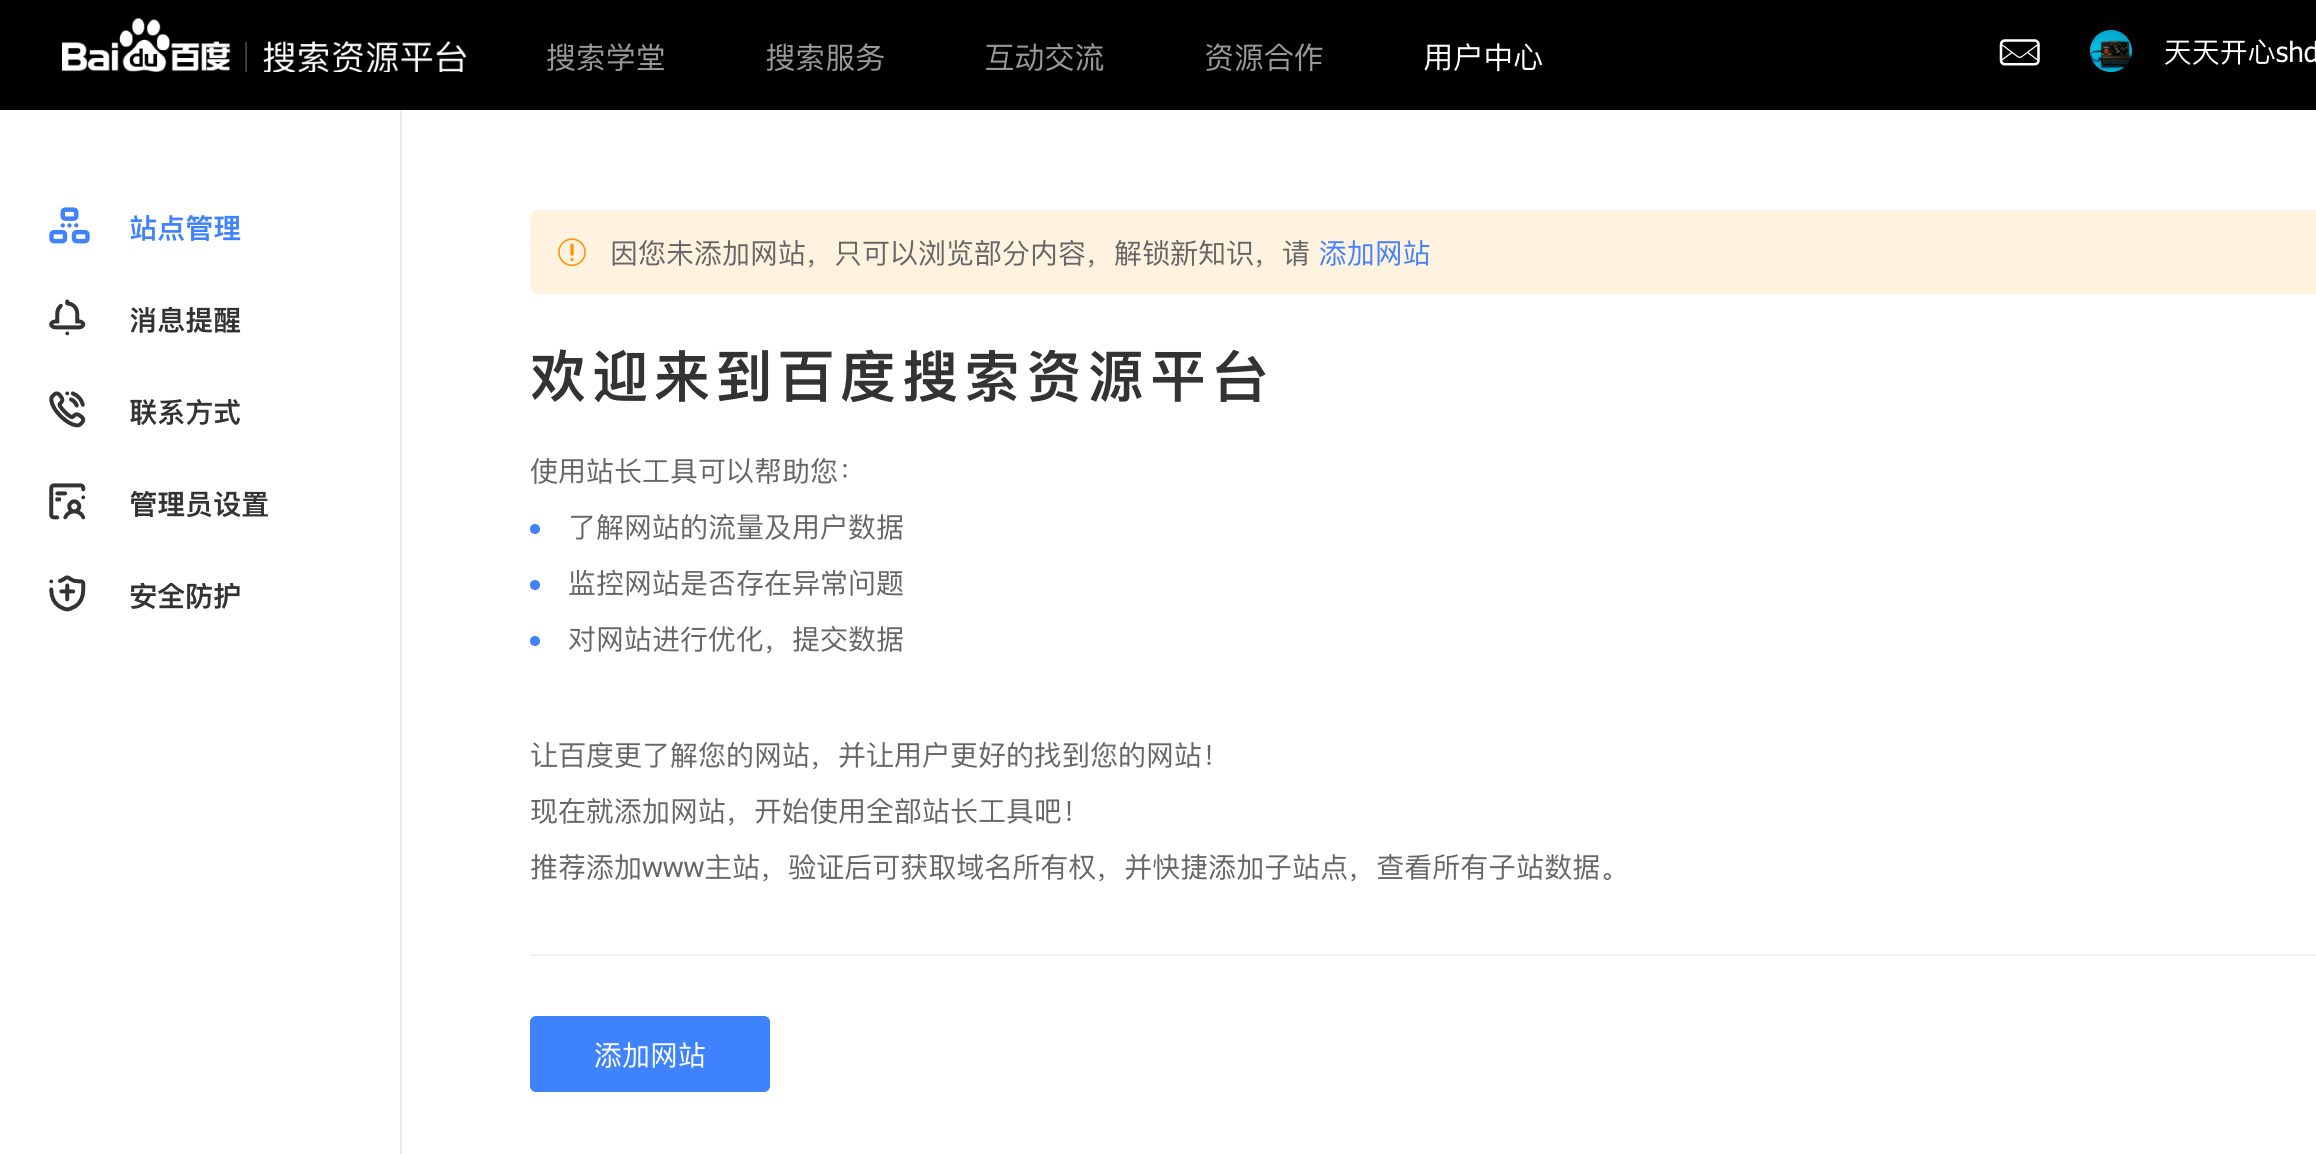
添加网站:
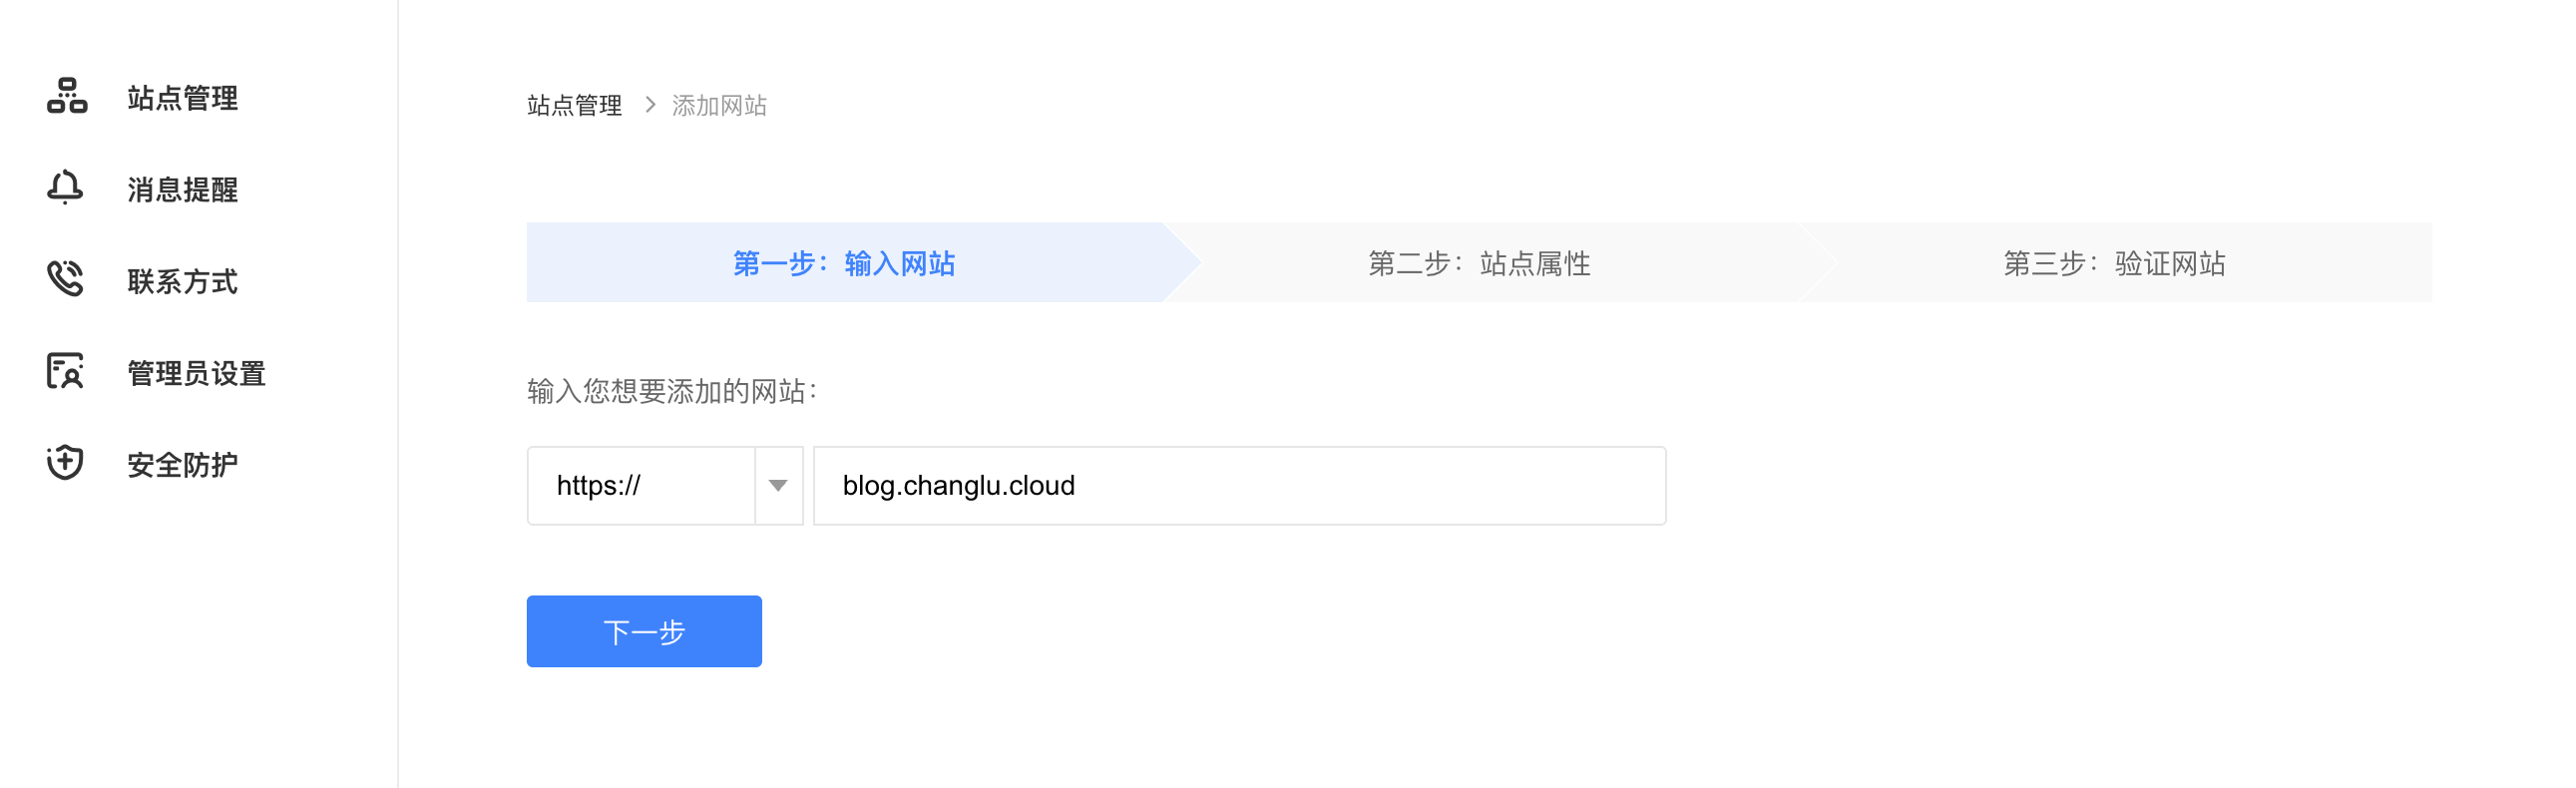
添加站点属性:
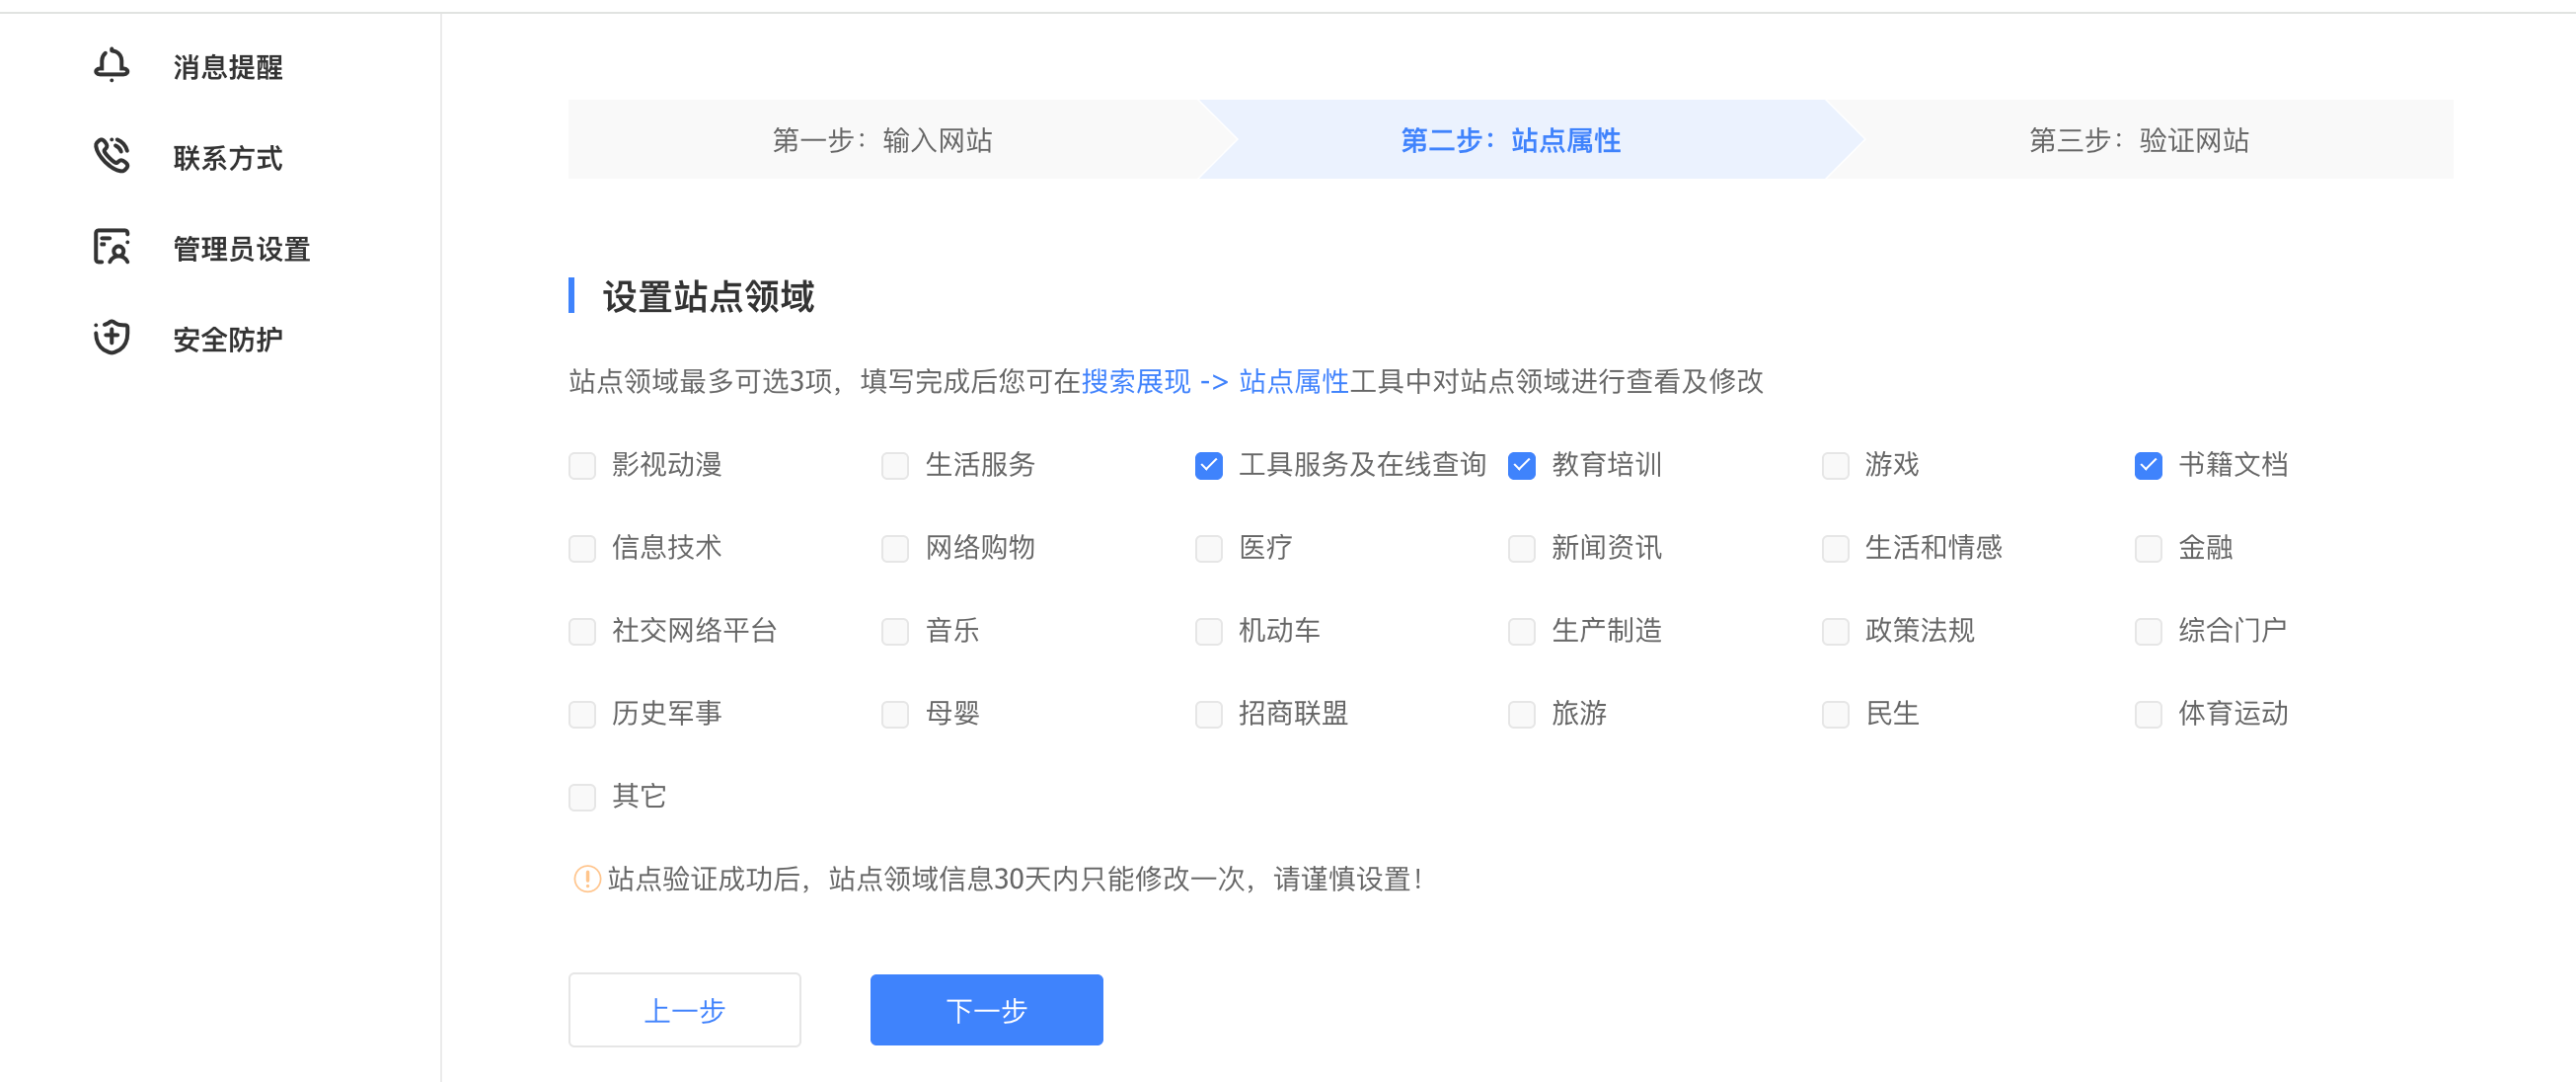
选择使用html标签验证:
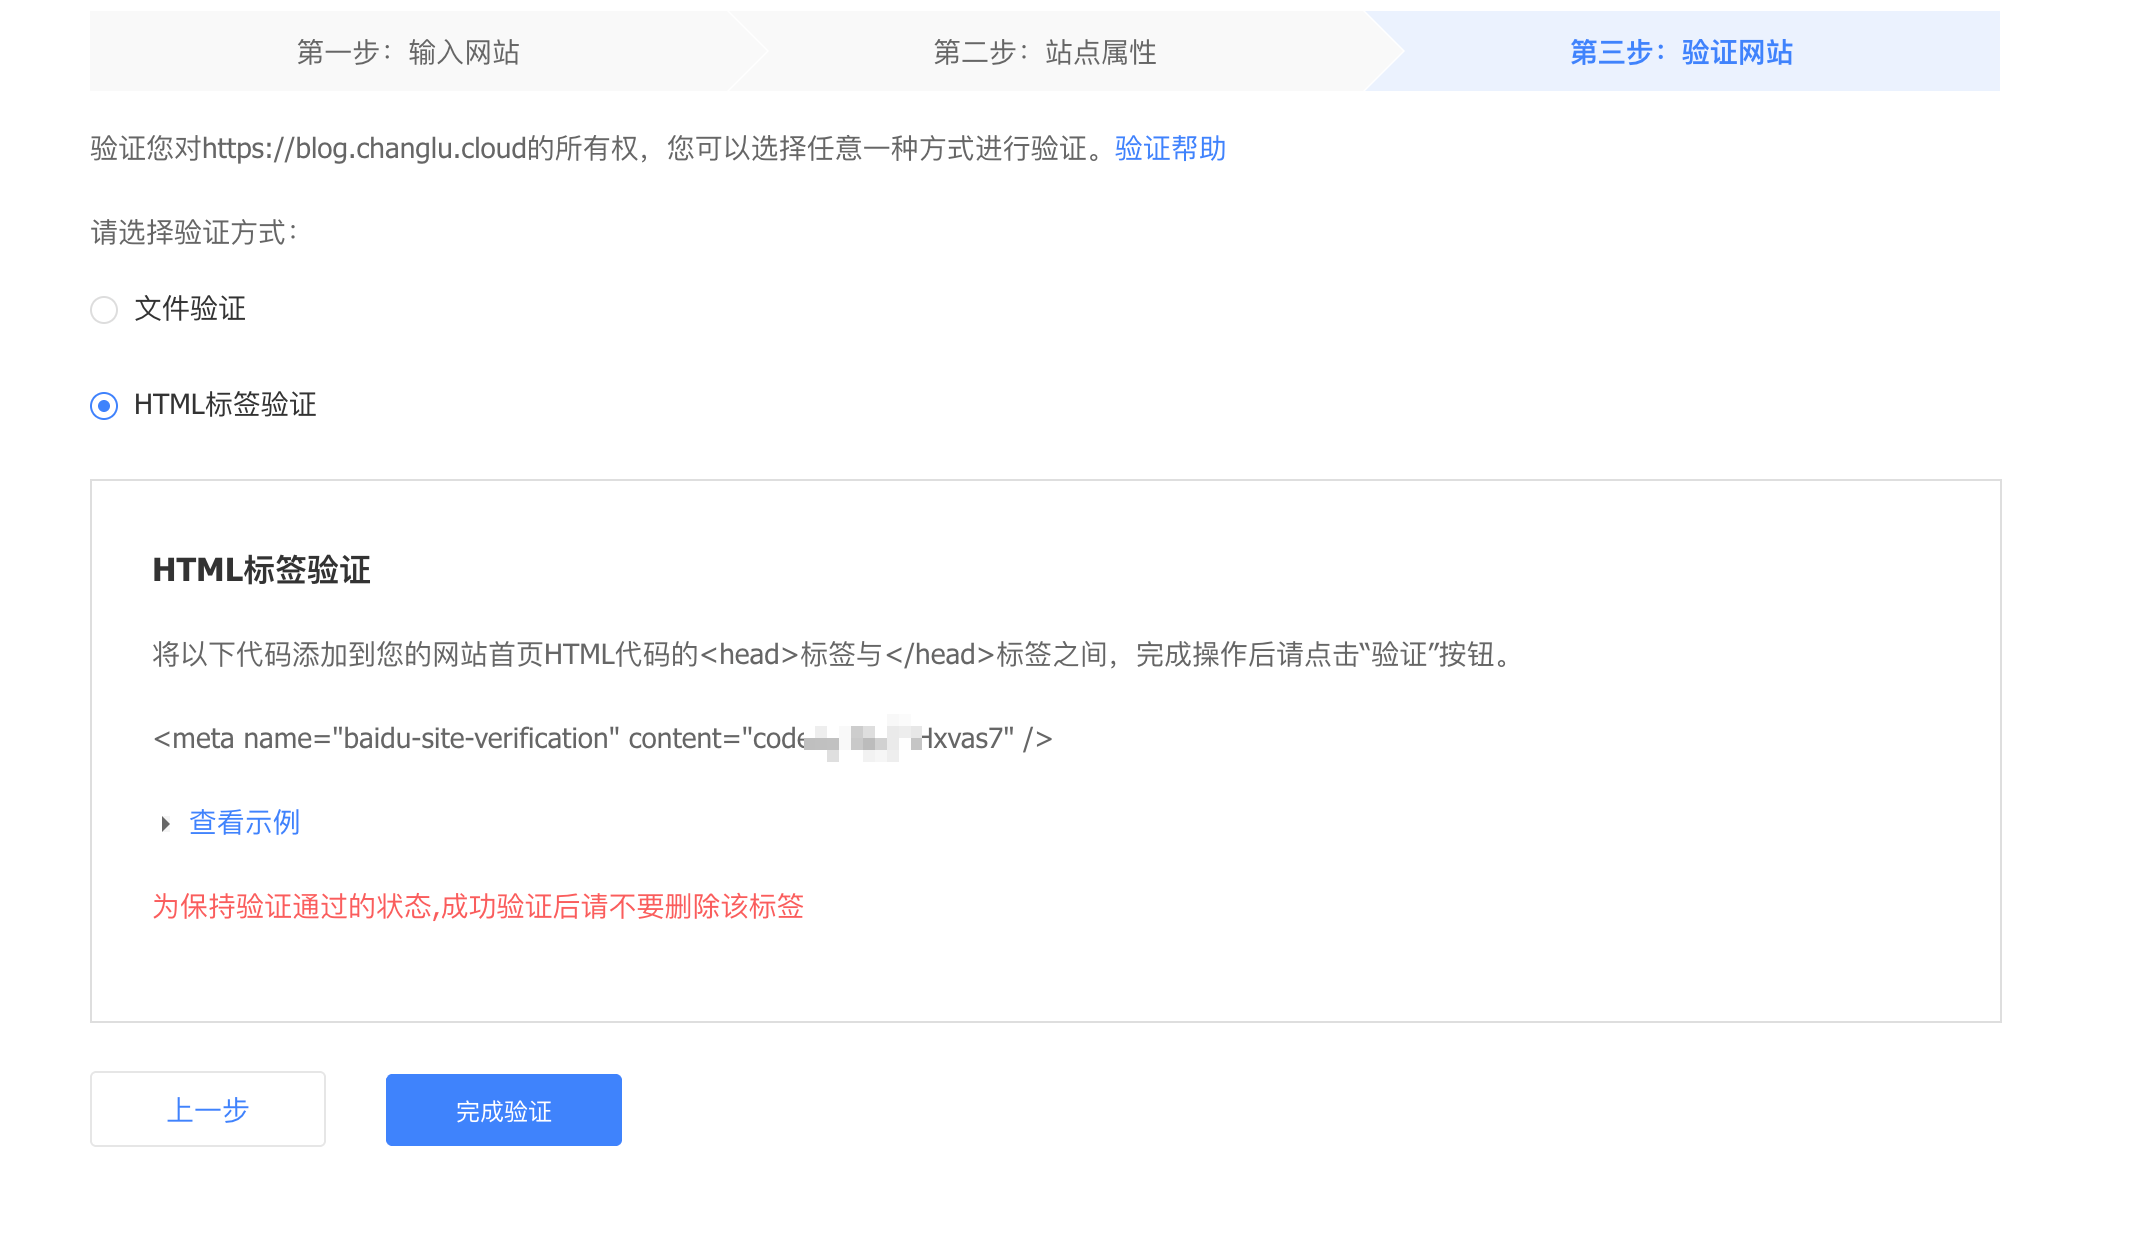 配置如下:
验证通过:
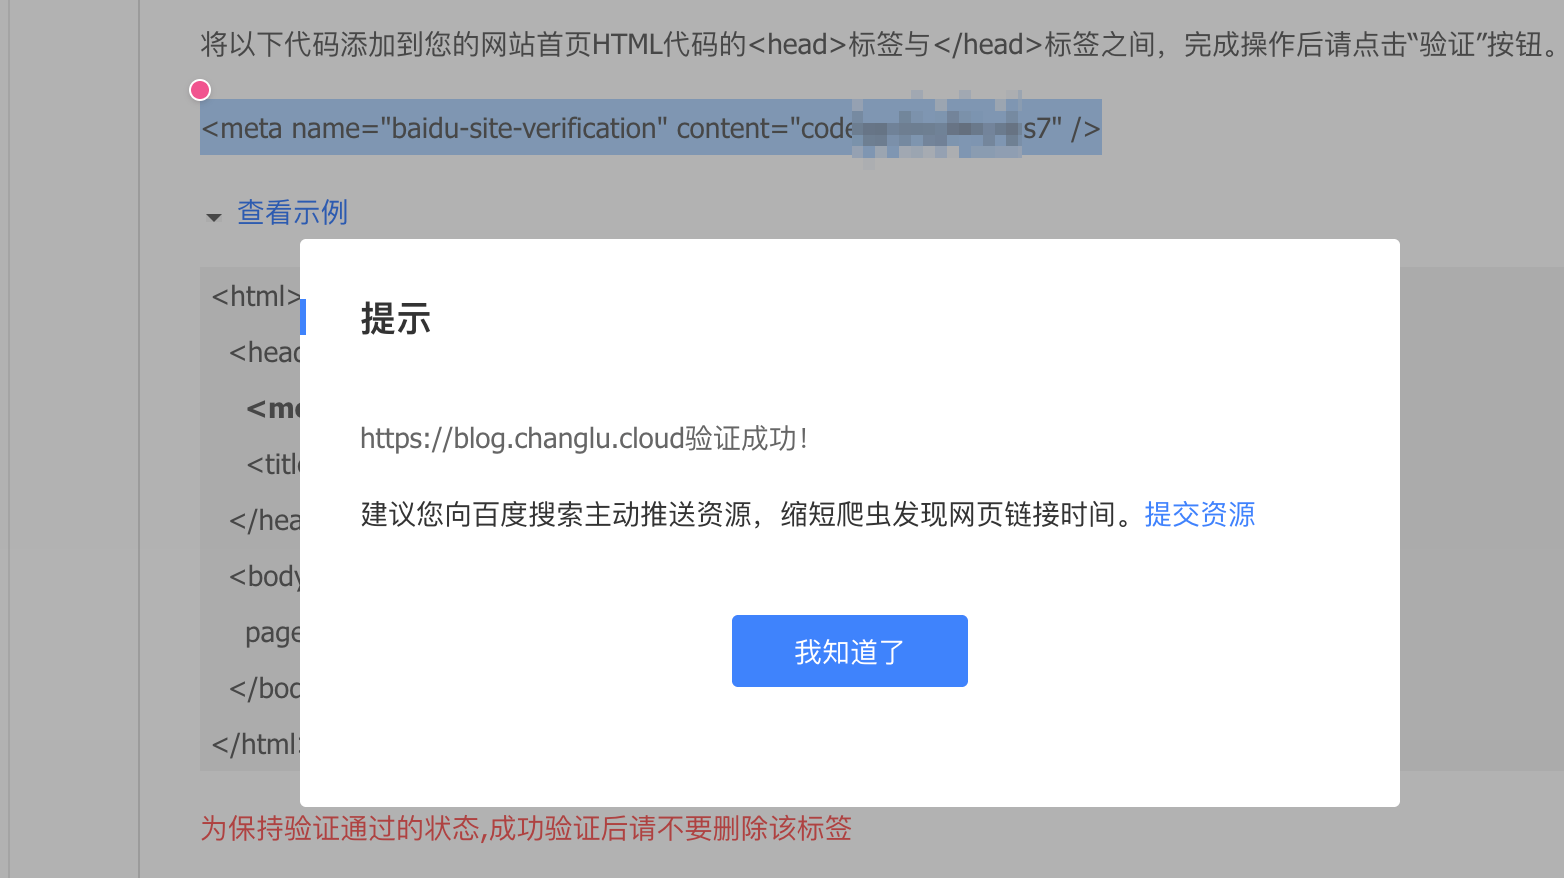
-
提交 Sitemap:在"普通收录 → sitemap"提交
https://blog.changlu.cloud/sitemap.xml。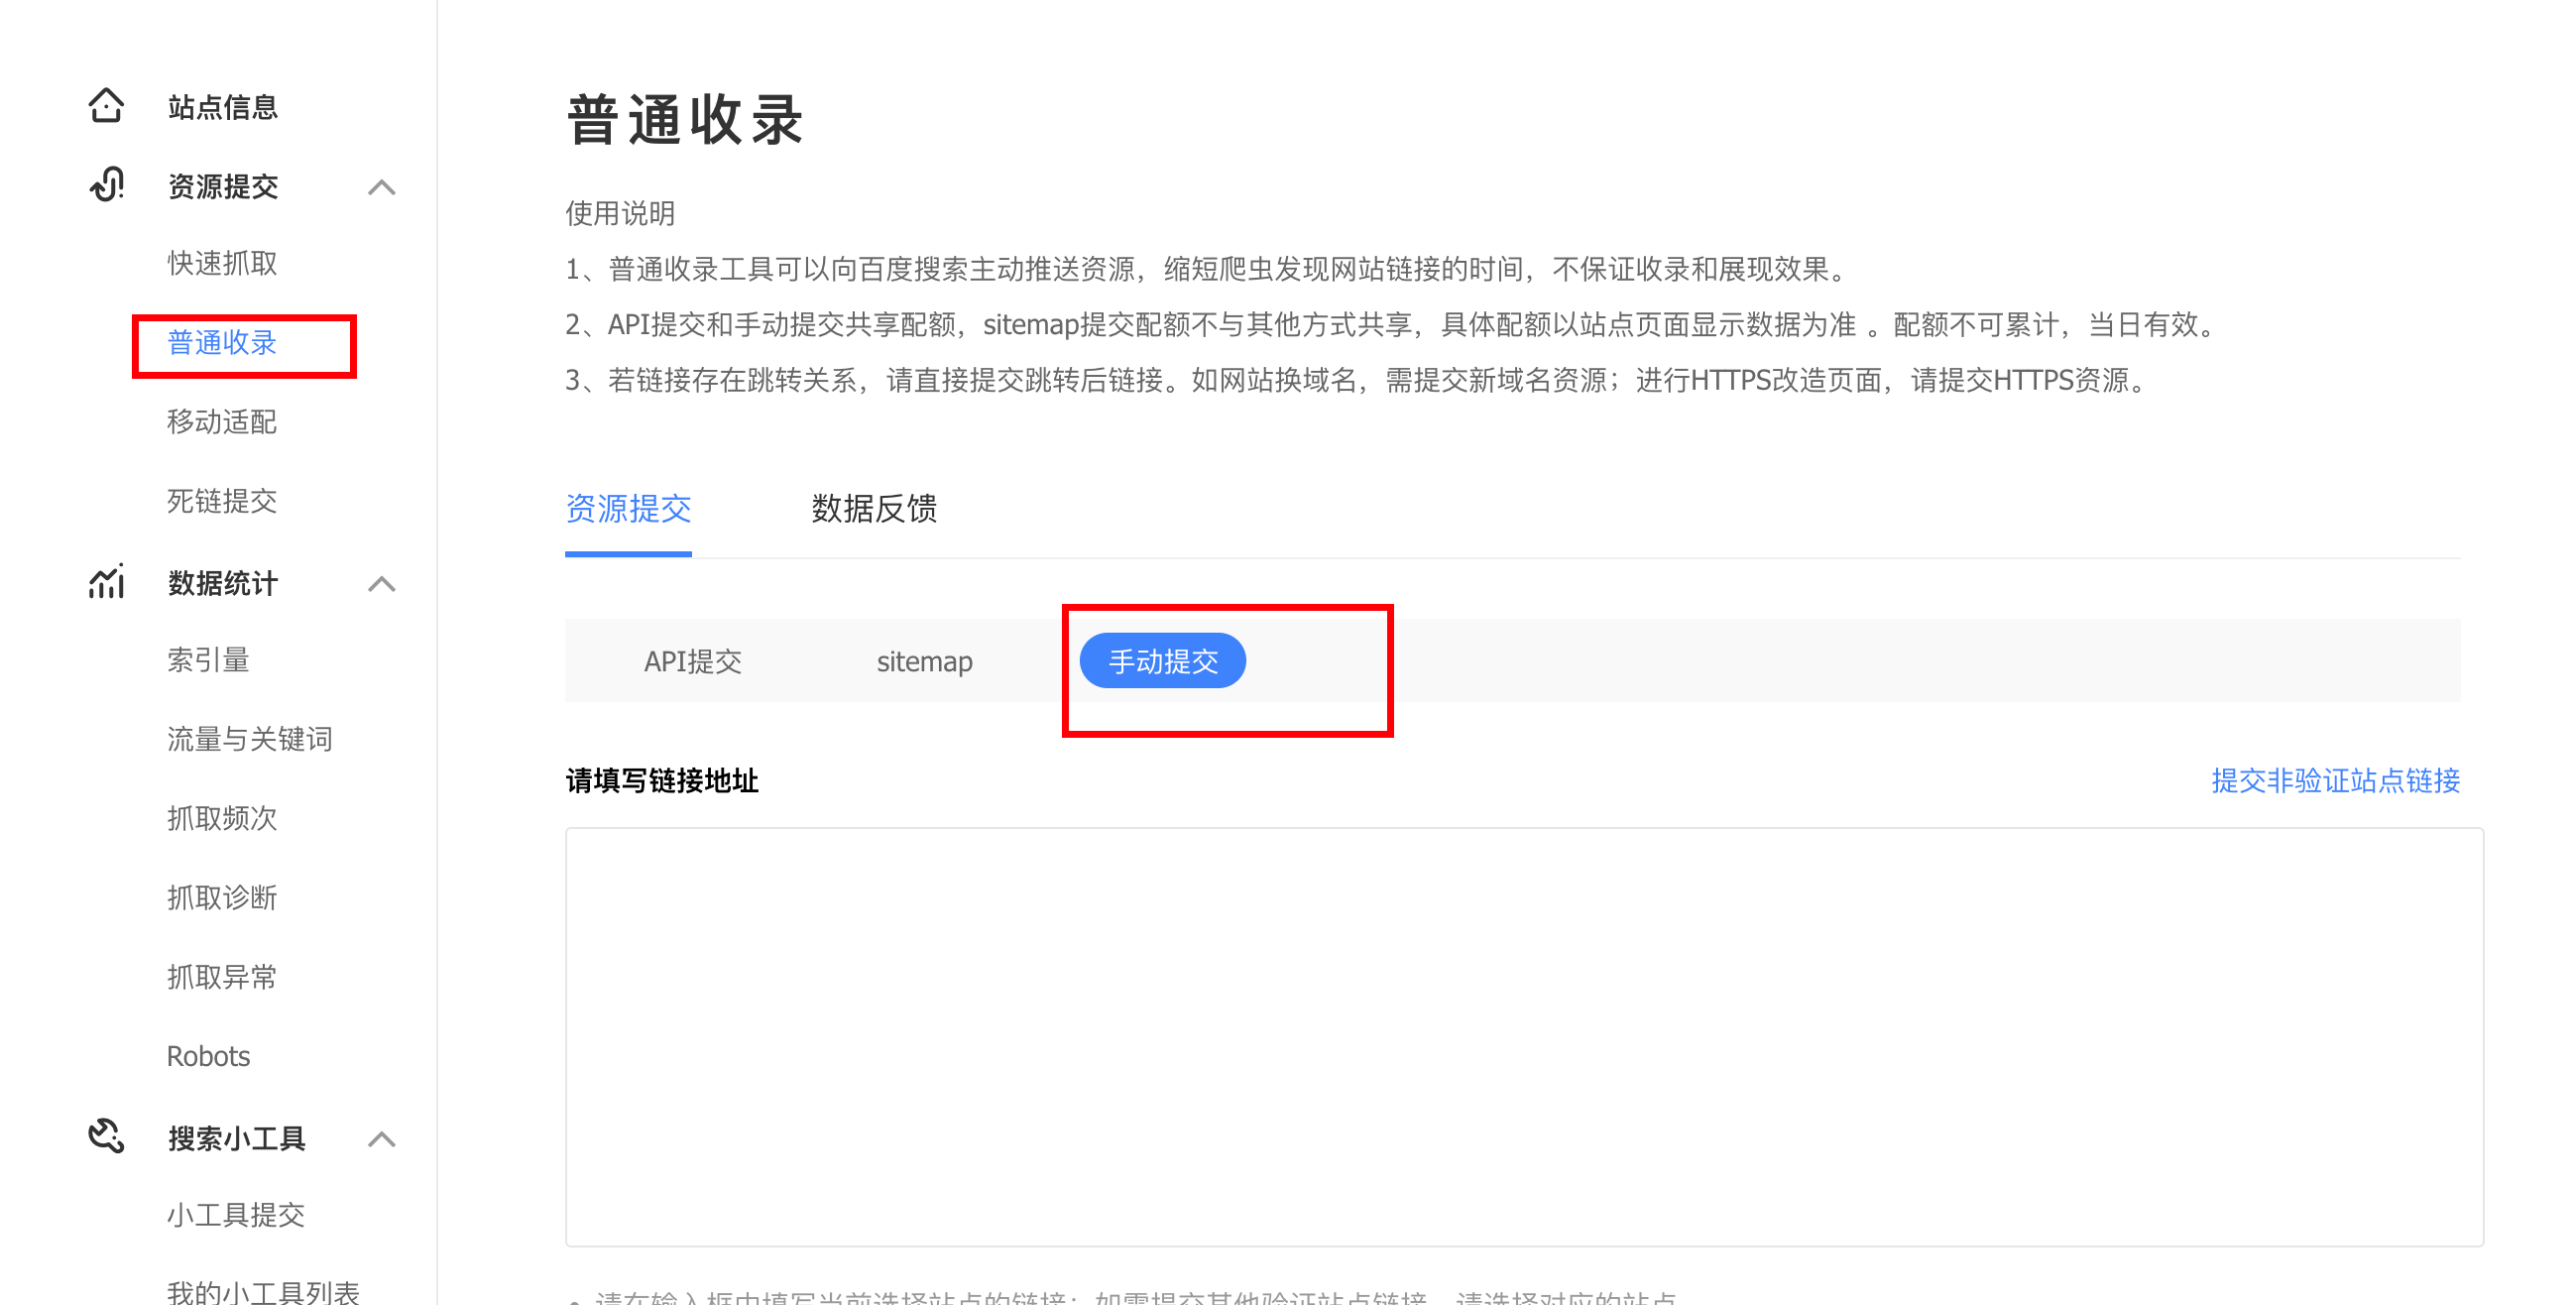
-
主动推送(F13,可三选一或组合):
- API 主动推送(推荐,最快):发布文章时服务端 POST 到推送接口;
- 自动推送
push.js(最省事):页面被访问时自动推送; - 手动提交:后台逐个粘贴 URL。
<!-- 百度自动推送:放进公共 head 片段或 blog-view-ui/index.html -->
<script src="https://zz.bdstatic.com/linksubmit/push.js"></script>
**注意:**百度对 JS 渲染支持弱,服务端直出后收录明显更稳,这也是 5.1 直出改造对国内收录的关键价值。
5.2.4、Bing 平台收录(国外)
**平台入口:**https://www.bing.com/webmasters/
**目标:**让文章进入 Bing(以及共享 IndexNow 的 Yandex 等)索引。
操作步骤:
-
验证站点:添加
blog.changlu.cloud,可直接从 Google Search Console 导入,或用 DNS / meta 验证。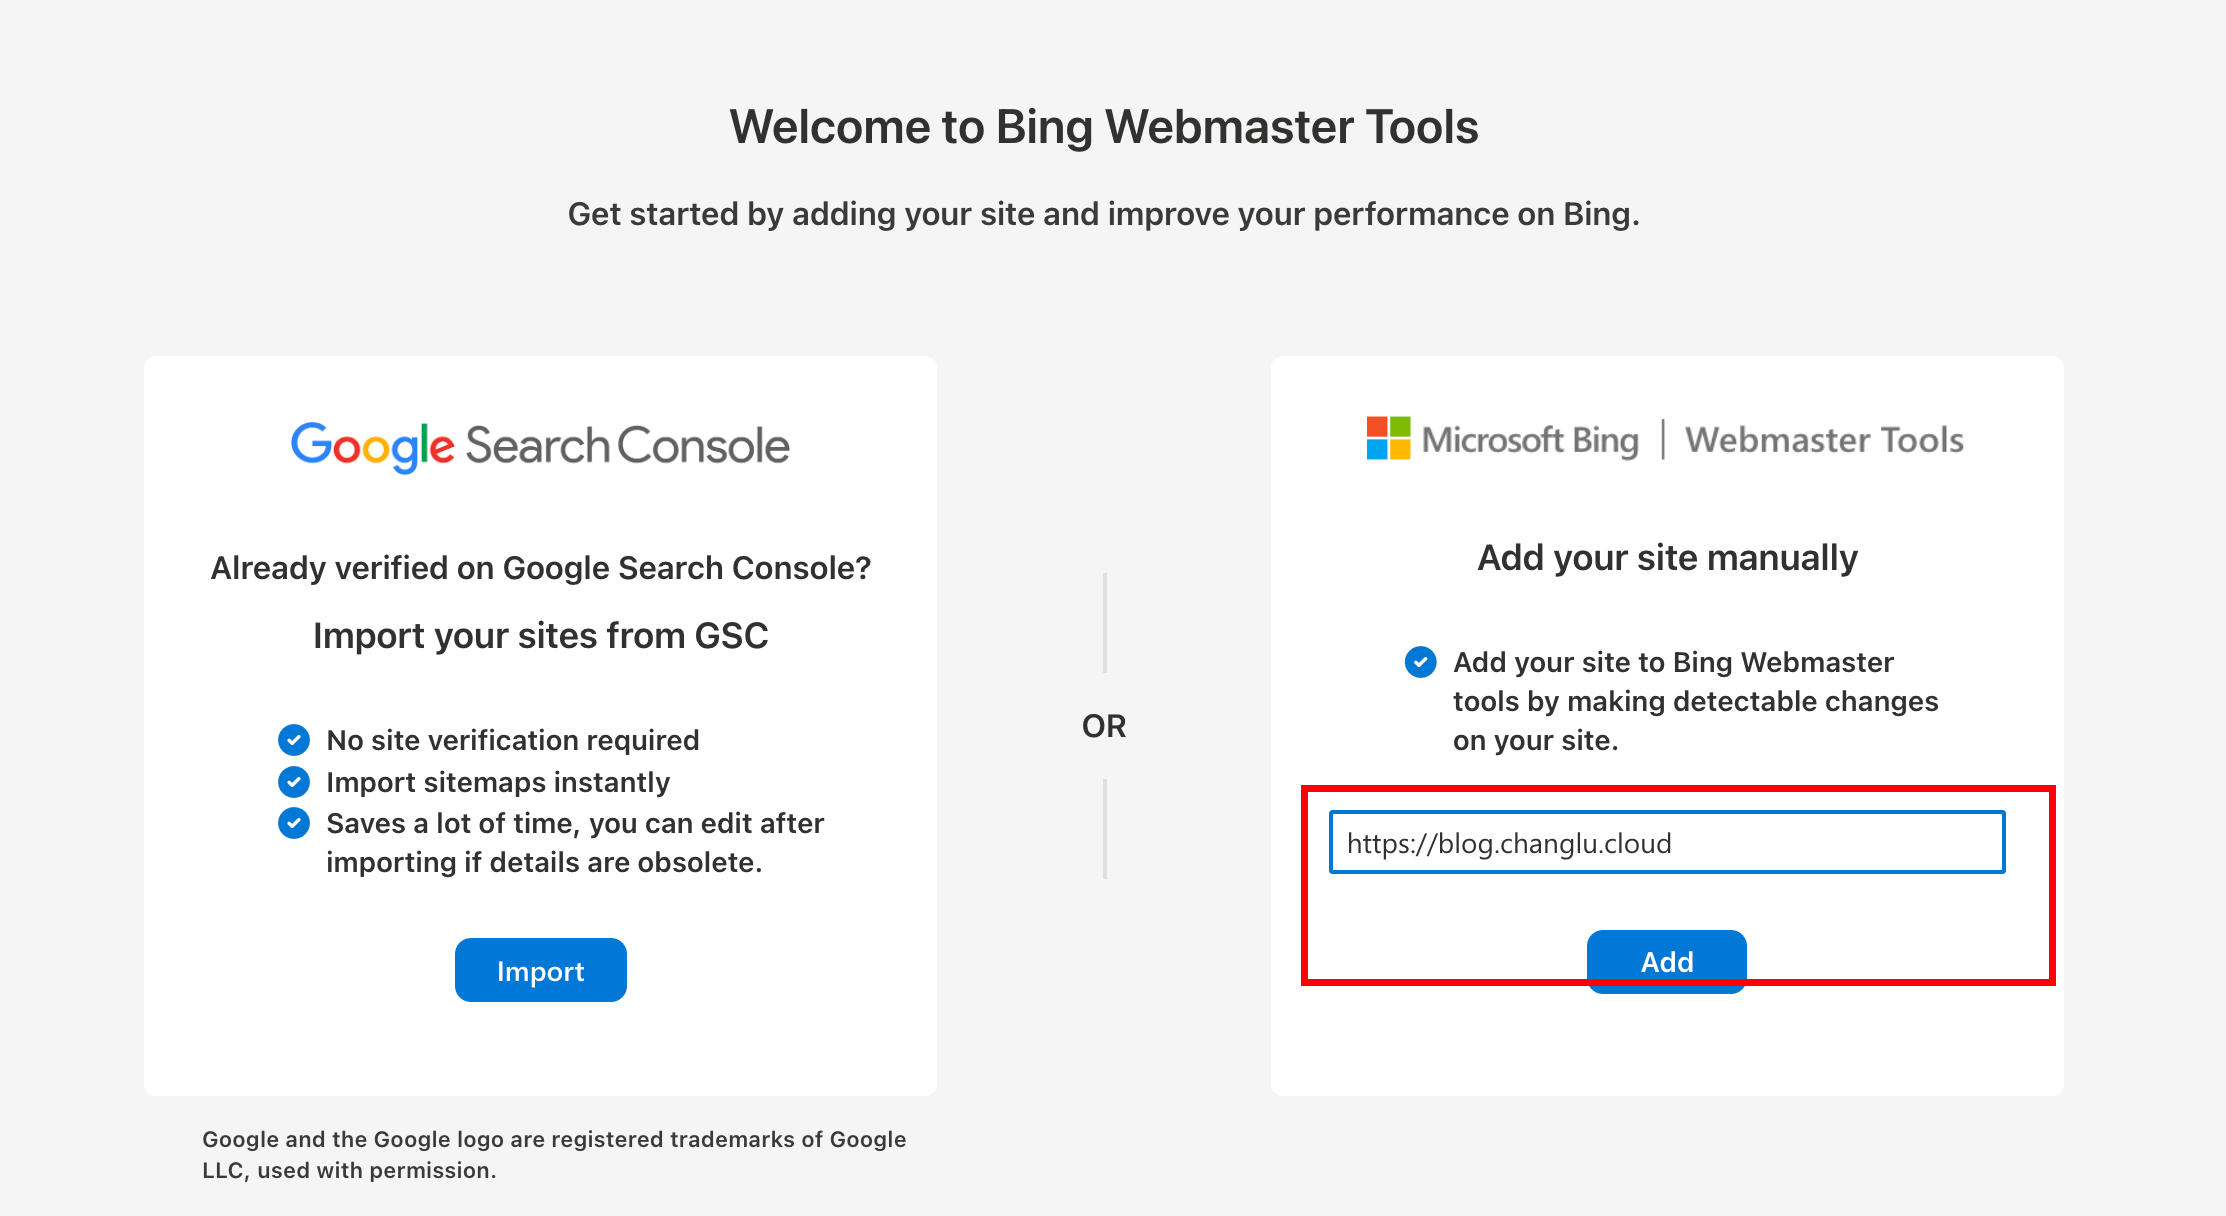
验证方式选择html验证即可:
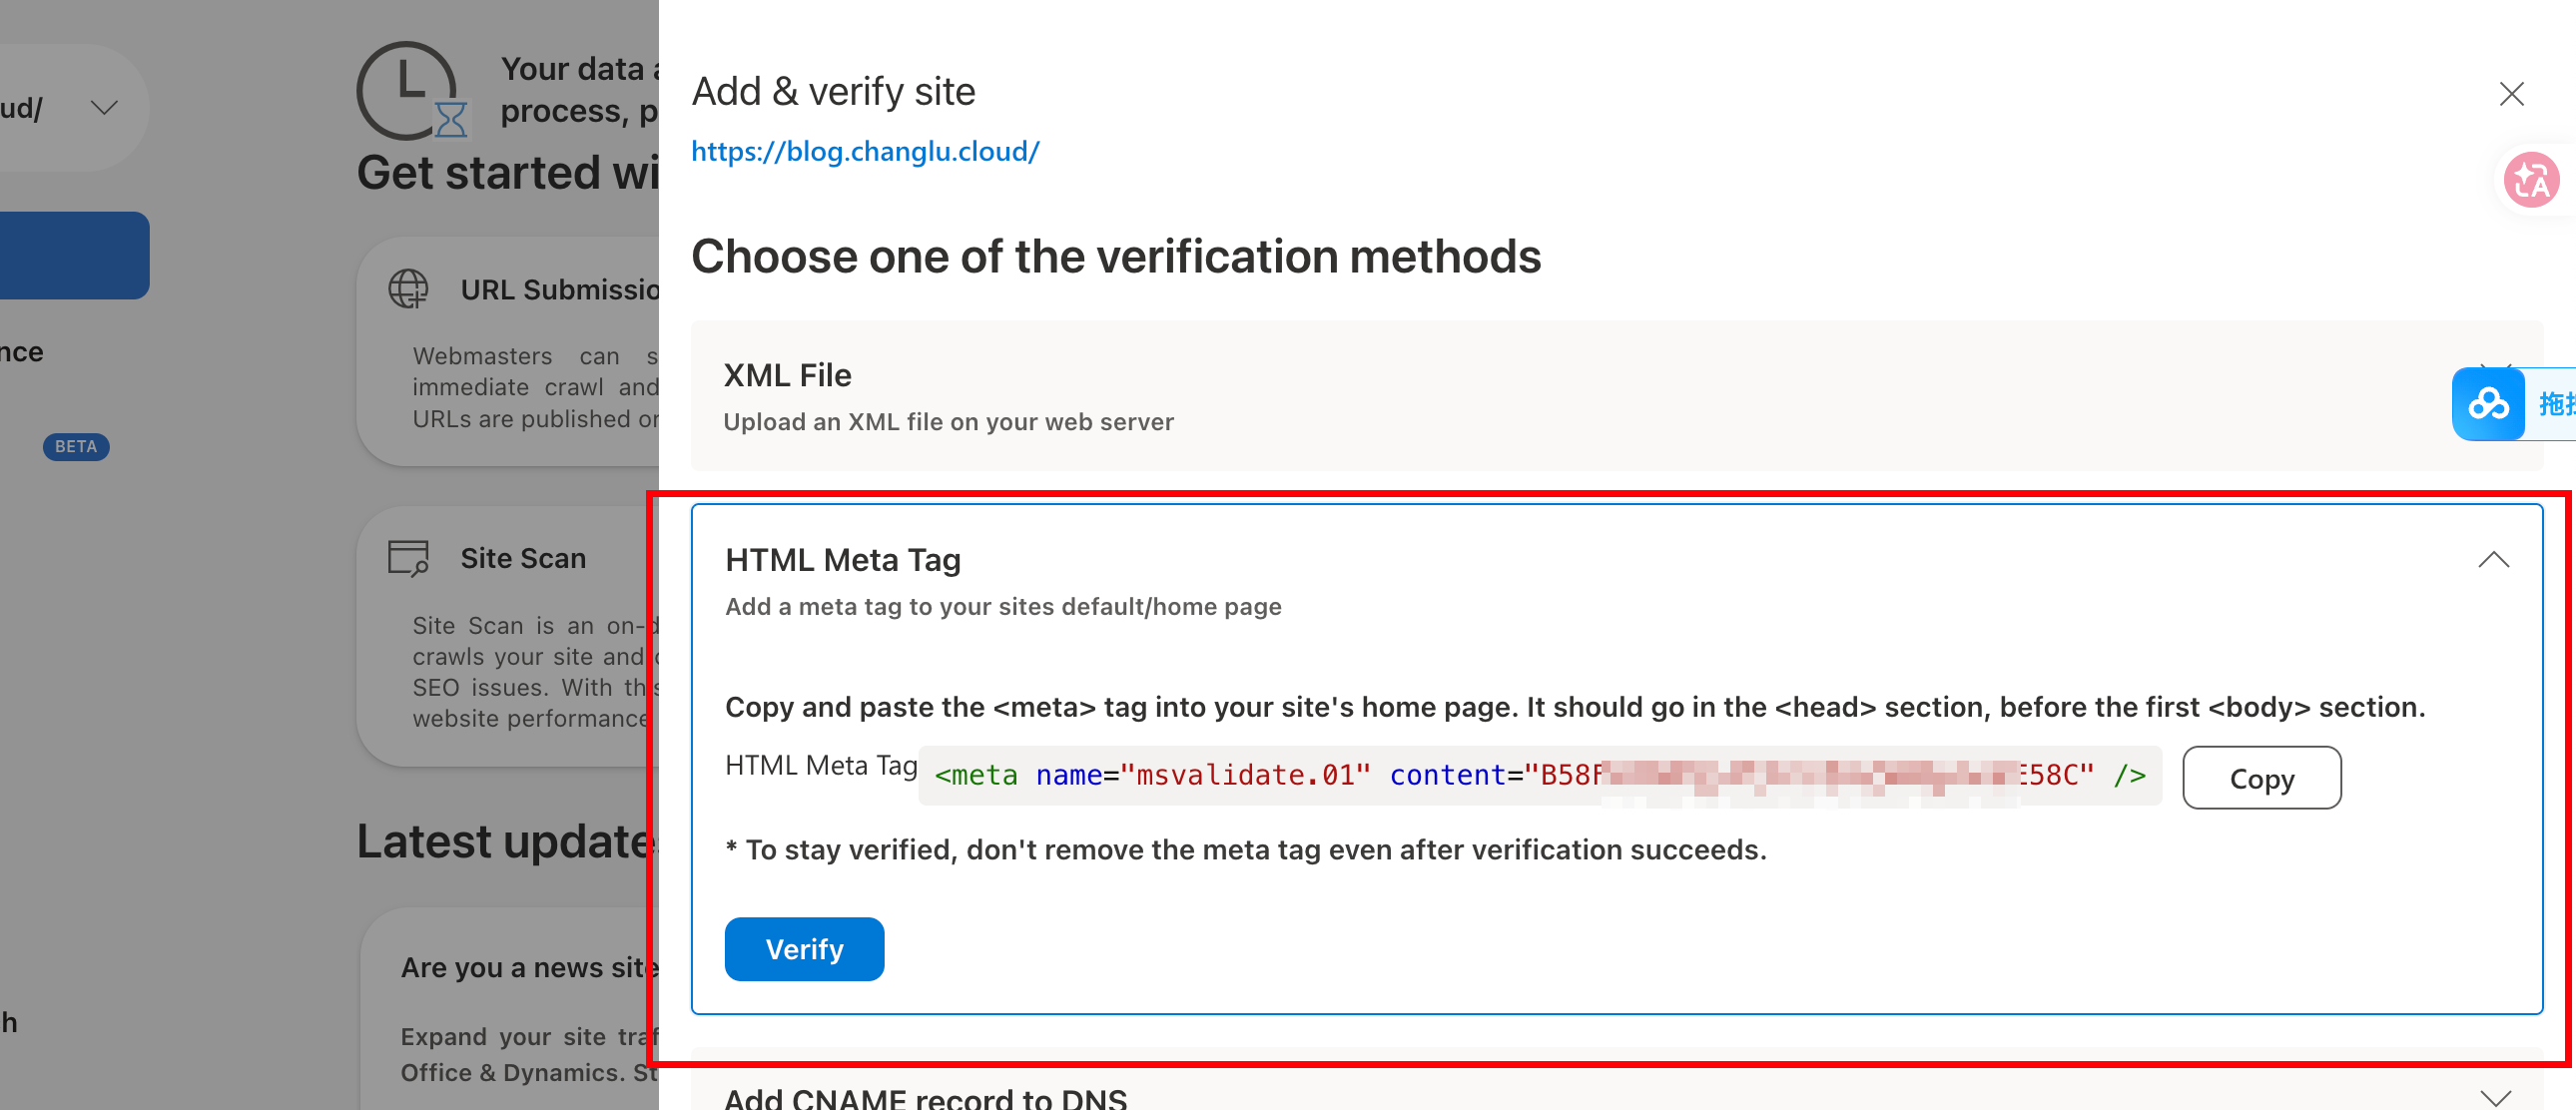
在网站后台配置配置即可:
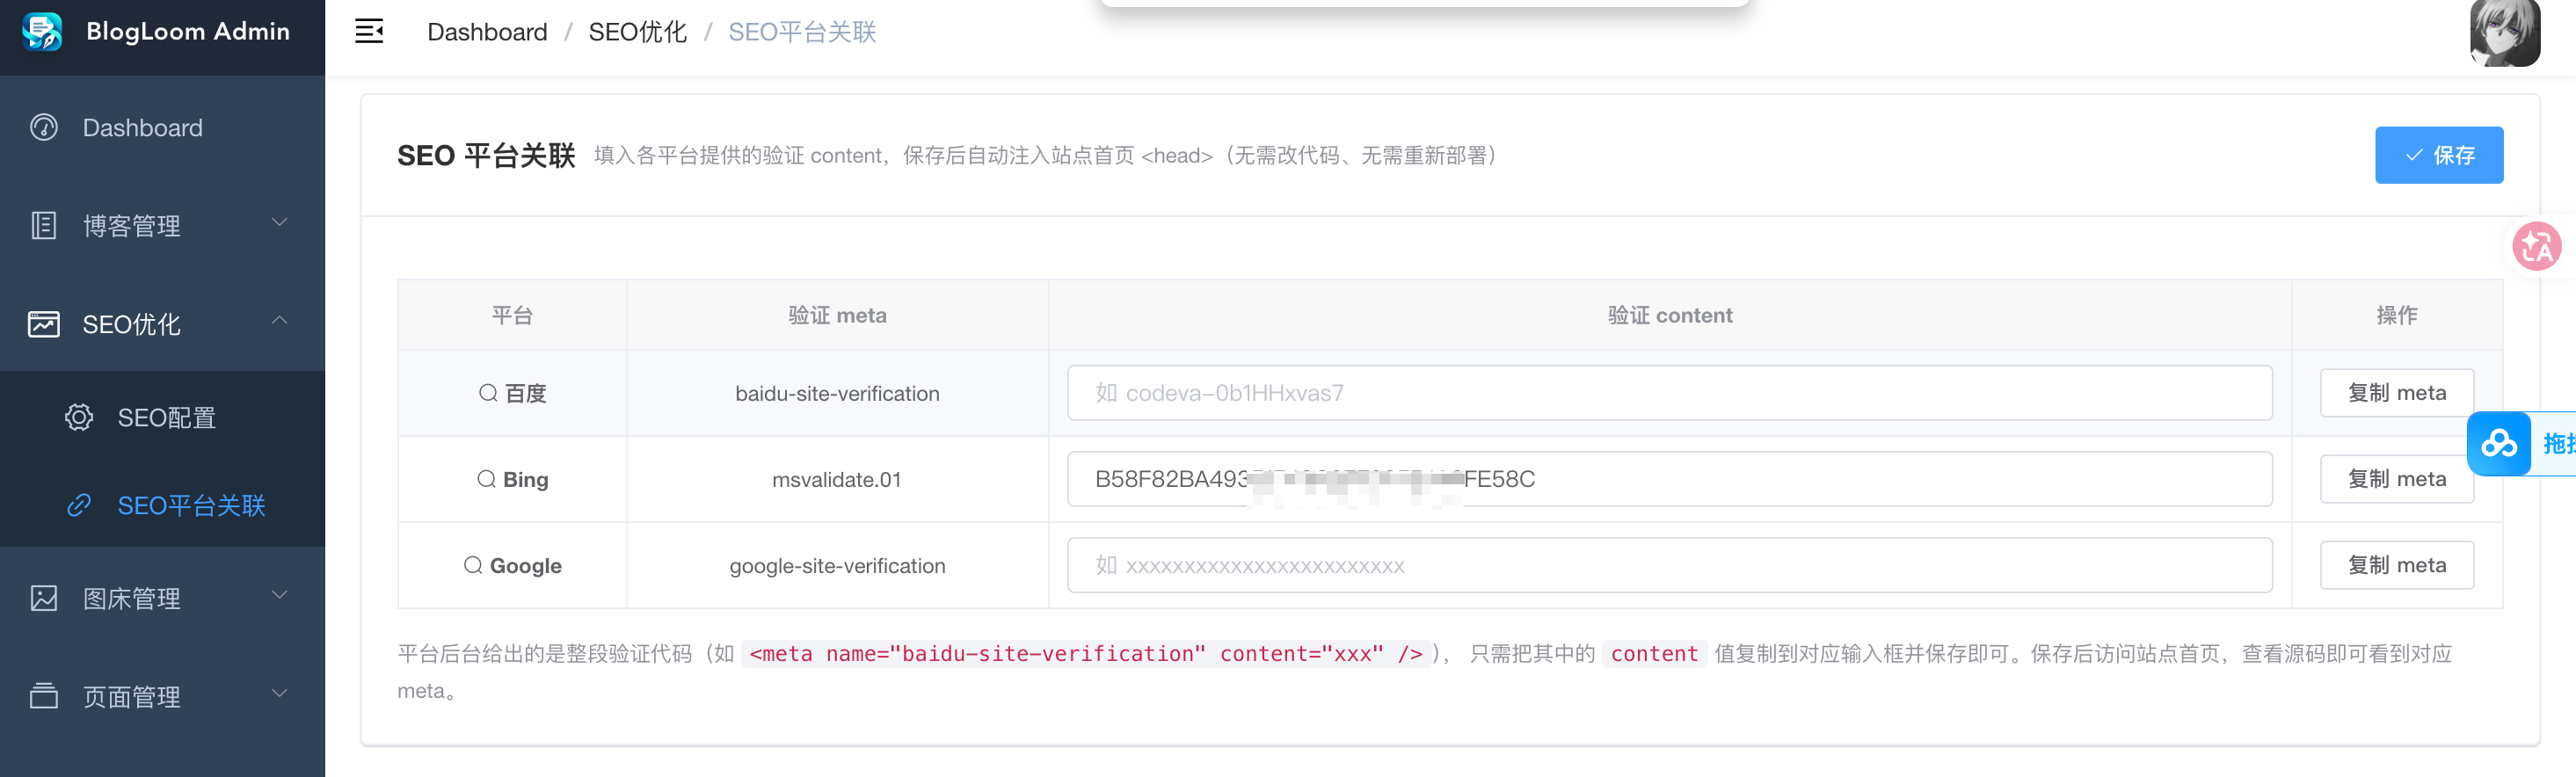
点击Verify即可进行验证通过:
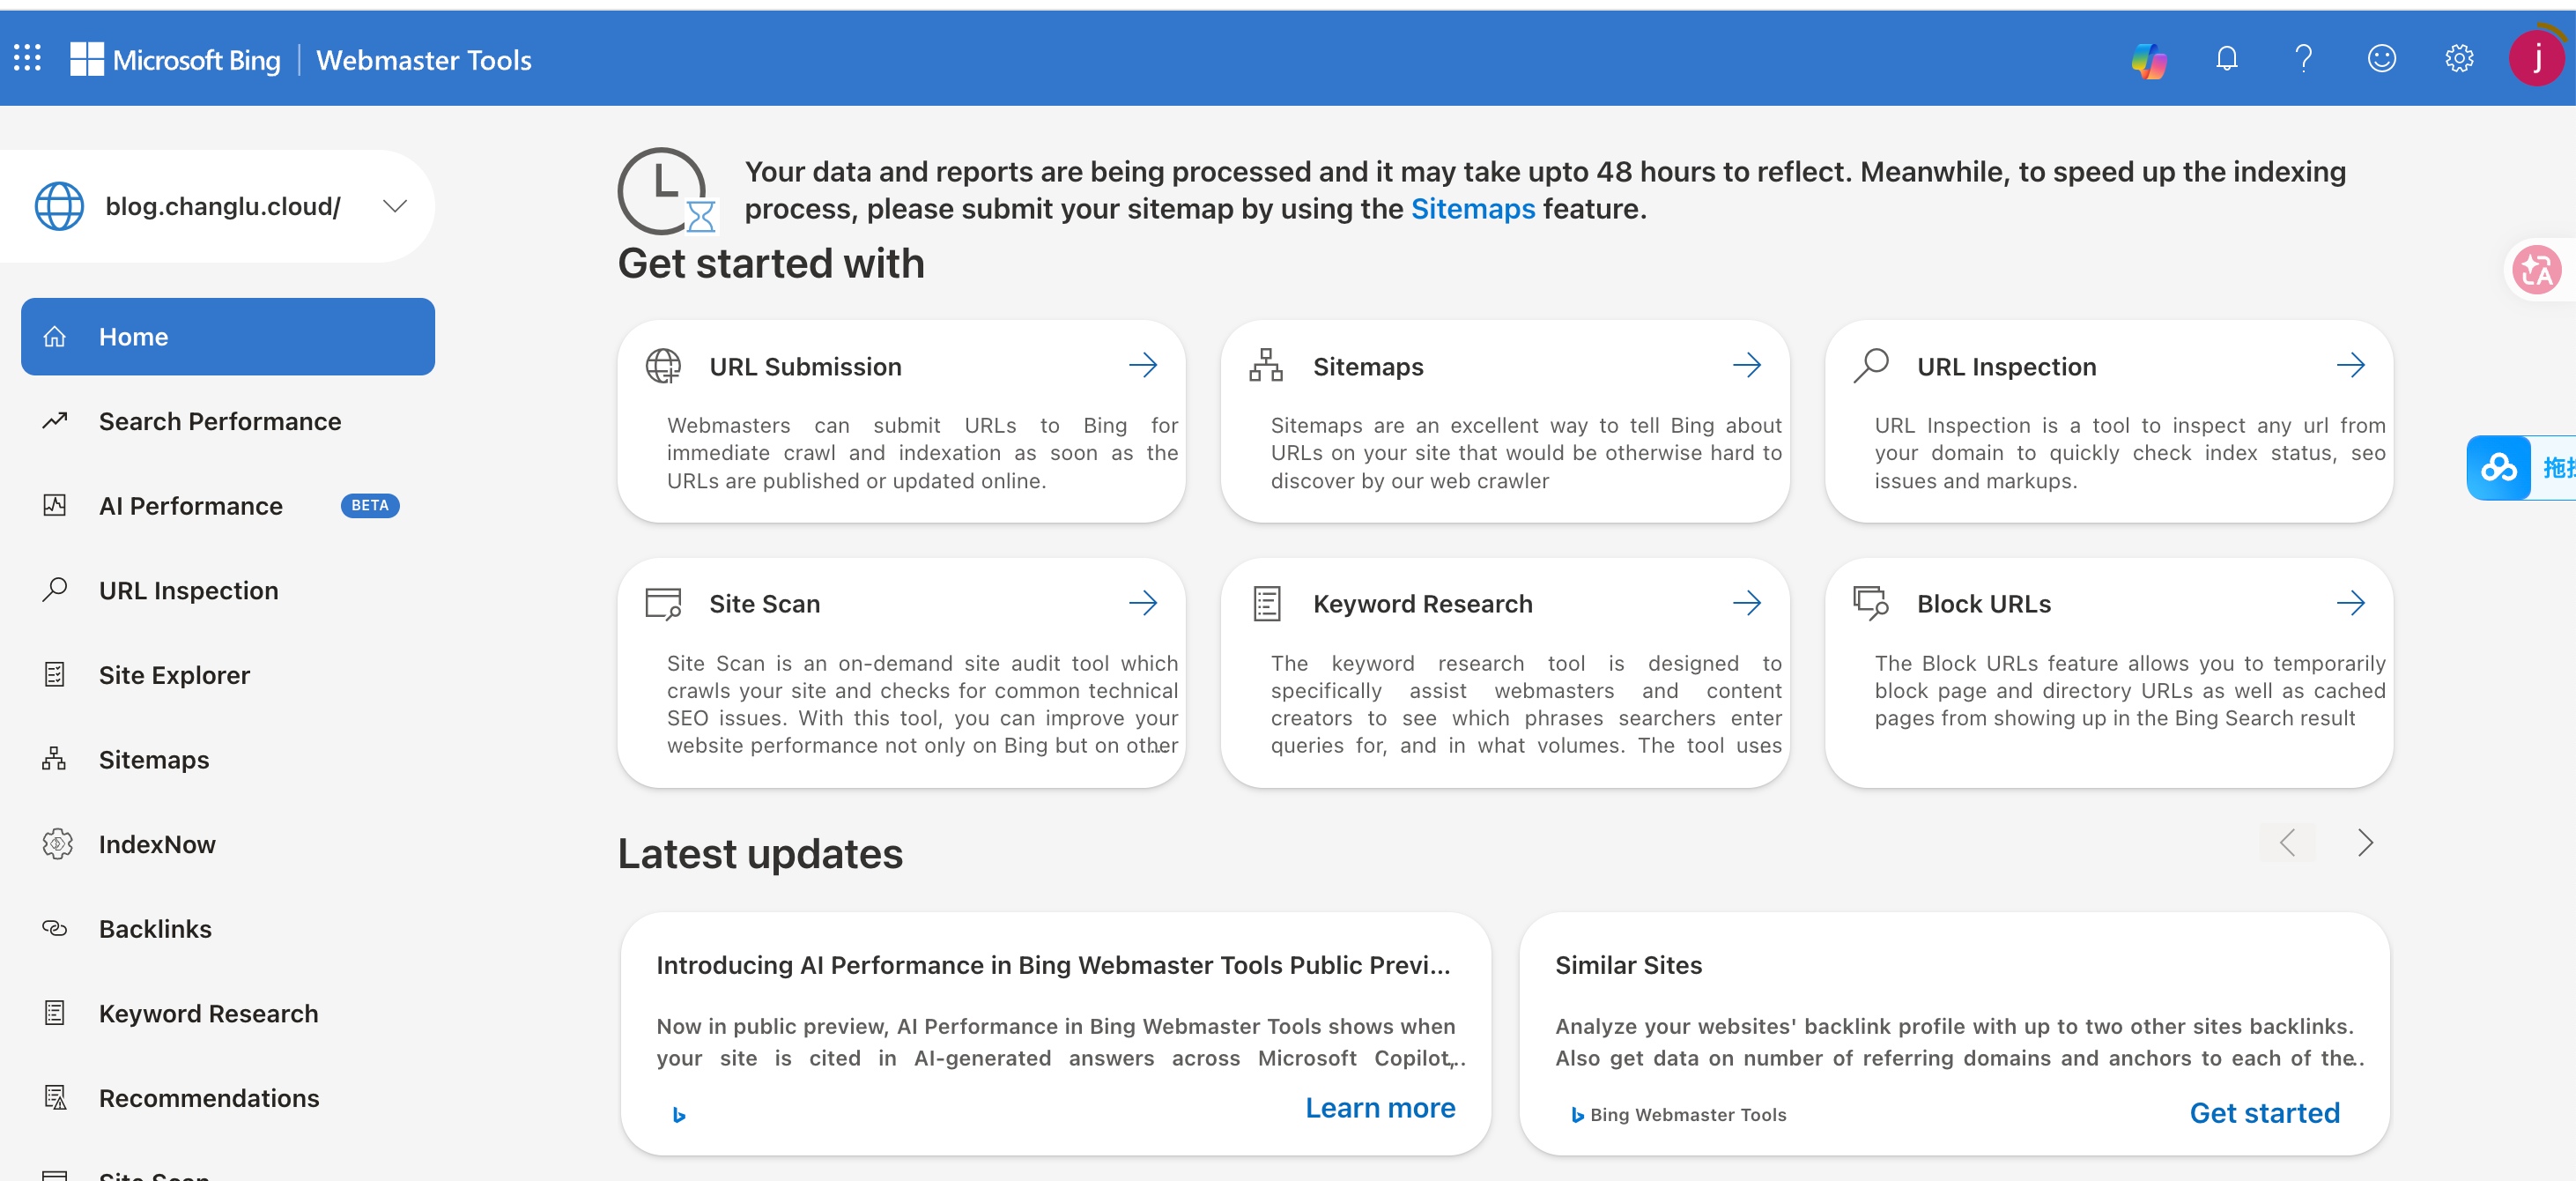
-
提交 Sitemap:提交
https://blog.changlu.cloud/sitemap.xml。提交sitemap:
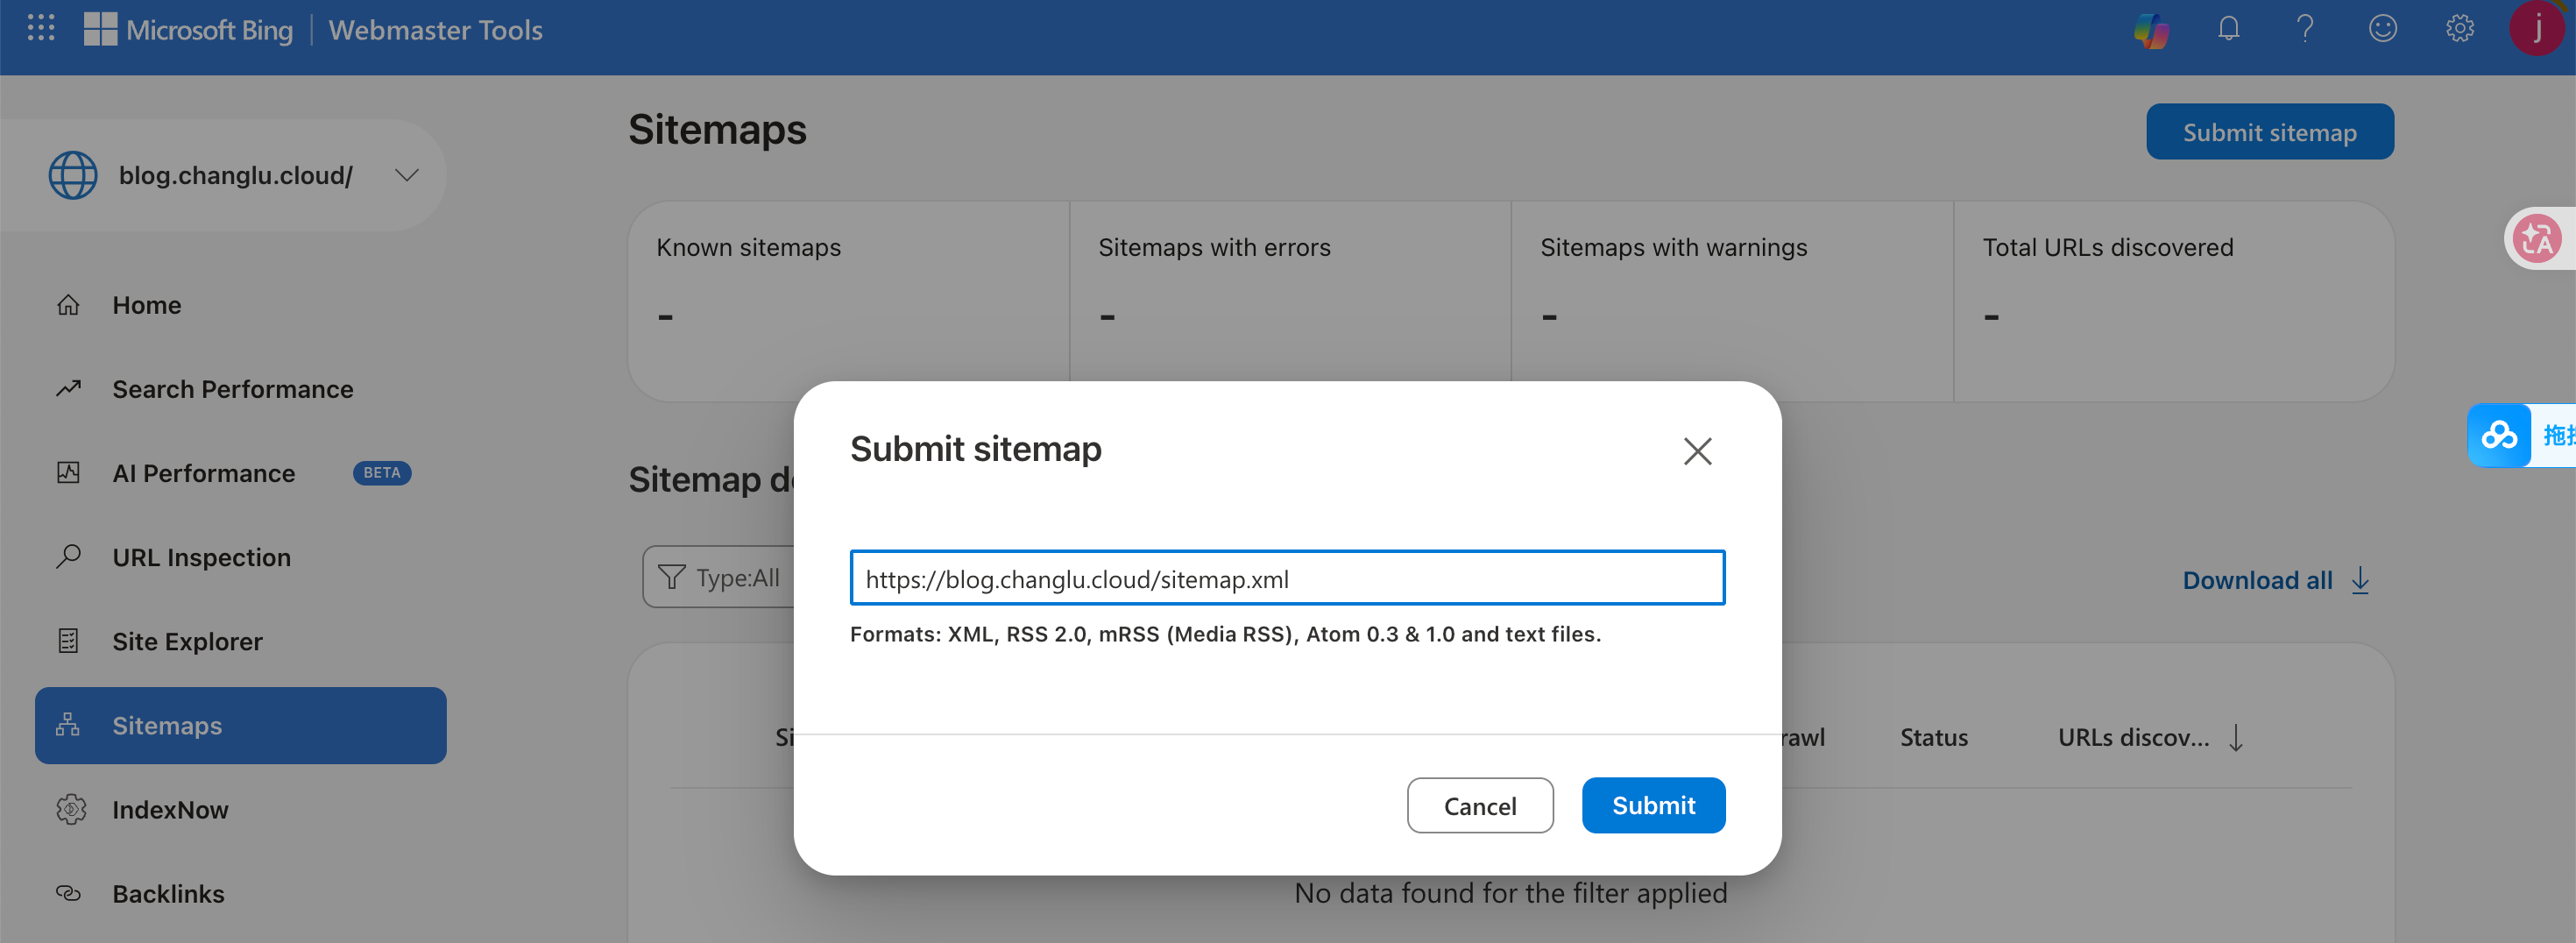
此时状态就是在处理中:
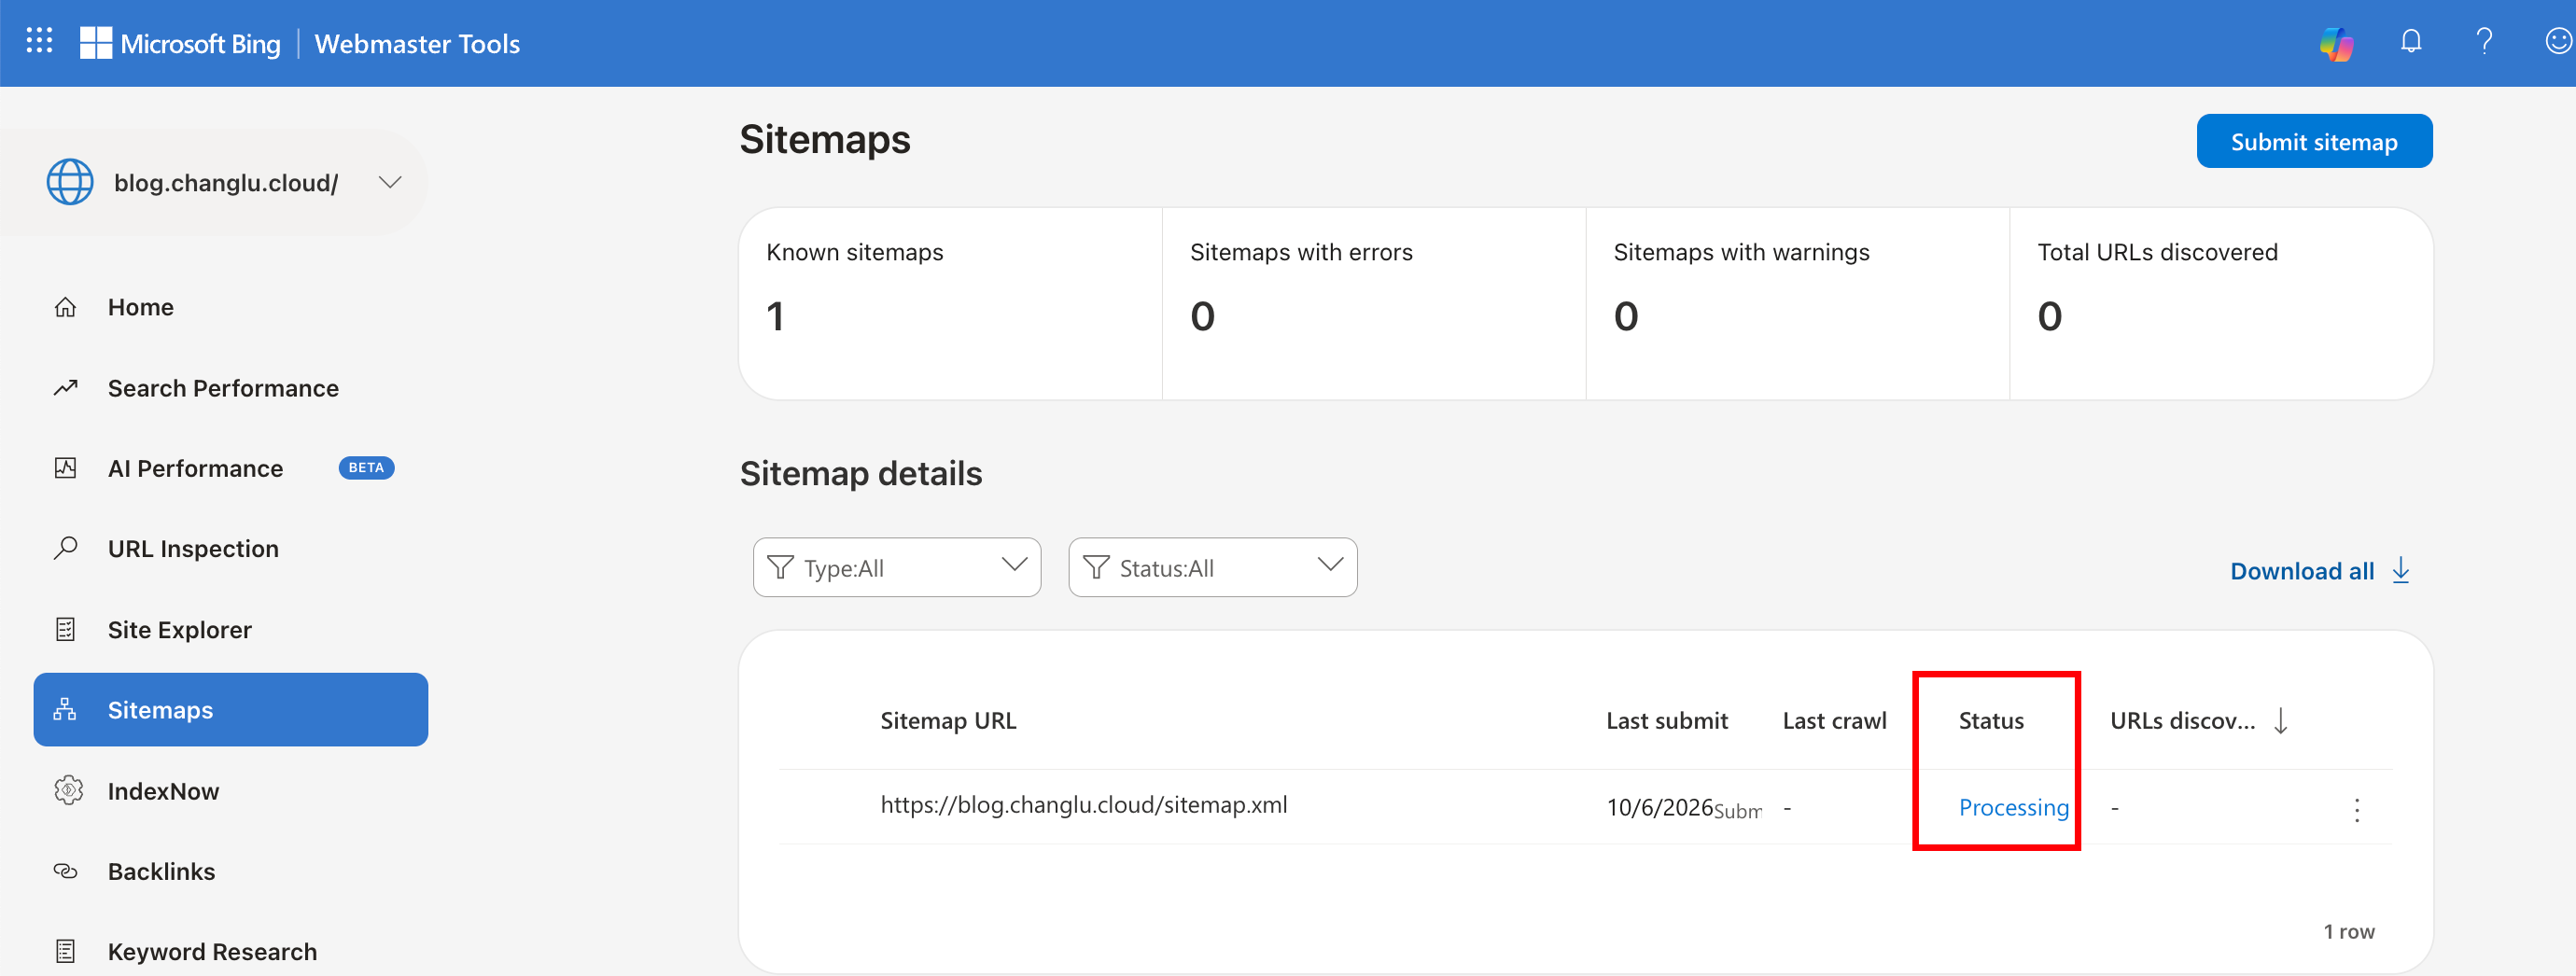
等待一会即可成功:
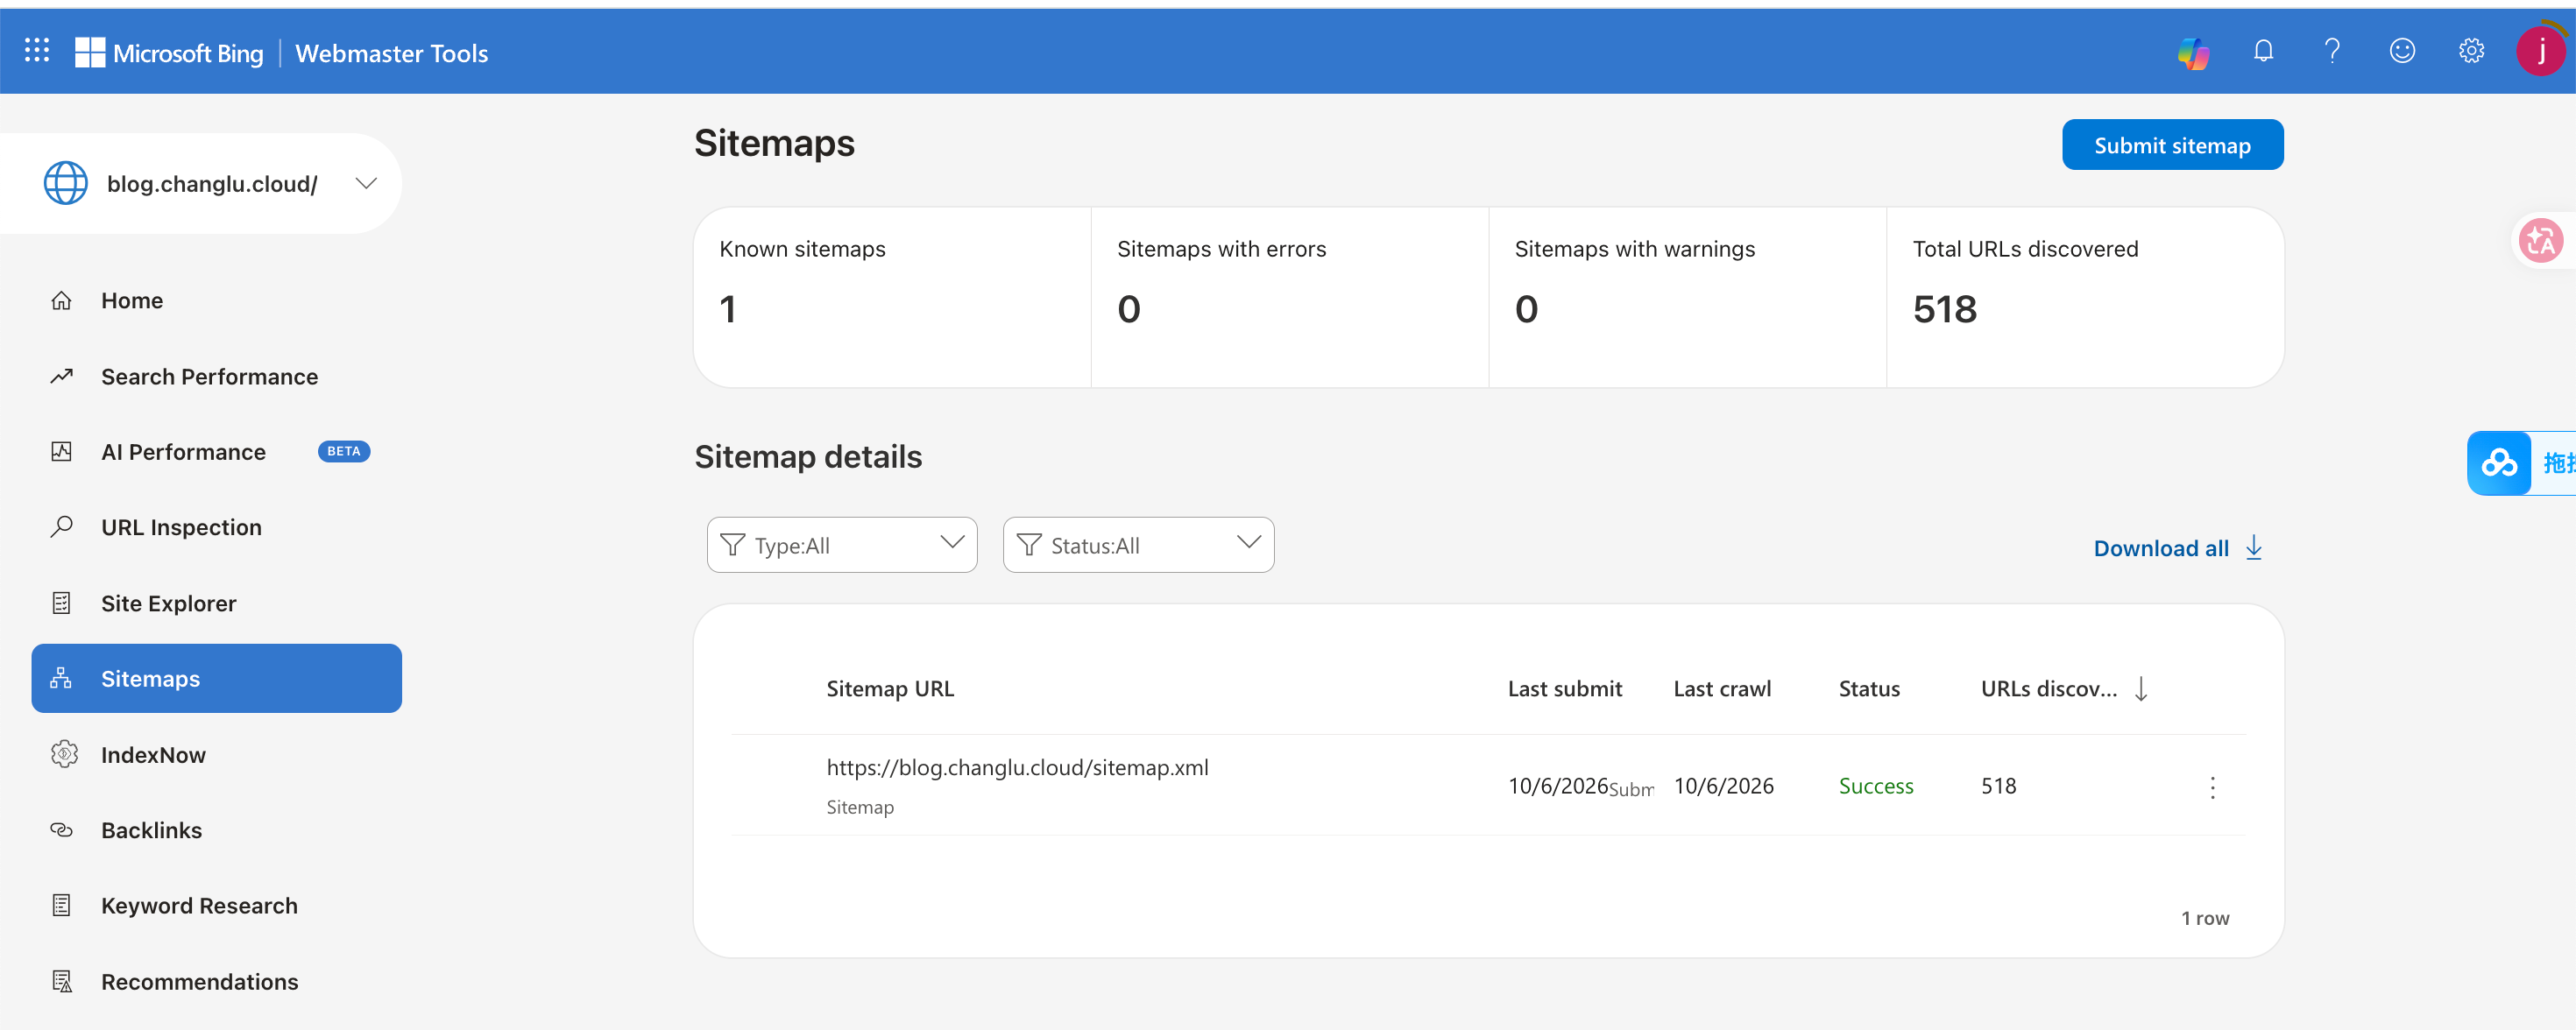
-
IndexNow 主动推送(F13):在站点根目录放
<你的key>.txt(内容即 key),发布文章时 POST:
POST https://api.indexnow.org/indexnow
{
  "host": "blog.changlu.cloud",
  "key": "你的key",
  "keyLocation": "https://blog.changlu.cloud/你的key.txt",
  "urlList": ["https://blog.changlu.cloud/blog/513"]
}
Bing 支持从 Google Search Console 导入站点配置,可省去重复验证。
5.2.5、读懂收录状态与常见问题
在各平台后台(以 Search Console 的"页面"报告为例)里,常见状态与含义如下:
| 状态 | 含义 | 常见原因 | 对策 |
|---|---|---|---|
| 已编入索引 | 正常收录 | — | 保持更新 |
| 已发现 - 尚未编入索引 | 引擎知道 URL 但还没抓 | 站点新、权重低、抓取预算不足 | 提交 Sitemap、加内链、耐心等待 |
| 已抓取 - 尚未编入索引 | 抓了但未收录 | 内容质量/重复度高、与其他页雷同 | 提升原创度、完善 description |
| 已排除(alternate/canonical) | 被 canonical 指向别处 | 页面重复、canonical 配错 | 检查 canonical 是否自指标准 URL |
| 已排除(noindex) | 页面上有 noindex | 误加 meta robots | 确认内容页无 noindex |
| 已被 robots.txt 屏蔽 | 抓取被拦截 | robots 规则过严 | 检查是否误 Disallow 文章路径 |
重点:看到"已发现 / 已抓取 - 尚未编入索引"是新手最常见的正常现象,多数是内容权重和时效问题,先按上表排查,别急着改代码。
5.2.6、收录监控节奏
每周花五分钟,固定看这五项,别被海量指标淹没:
① 搜索点击(Search Console)
② 访客数(GA4 / Umami)
③ 热门文章(GA4 / Umami)
④ 来源渠道(GA4 / Umami)
⑤ GitHub / 订阅入口点击(配置事件后看)
另外可定期用 site:blog.changlu.cloud 粗略核对收录数量,并与 Search Console 的"已编入索引"页面数交叉验证。
5.3、广告接入(Google AdSense)
本节定位:只讲两件事——核心代码实现与核心申请步骤。 广告的选型理由、概念、配置规范、布局原则、合规红线、指标与 FAQ 等"需求与原理分析",已统一移到 4.4、广告接入需求与原理分析。本节默认读者已读过 4.4,直接进入落地。
5.3.1、核心代码实现
5.3.1.1、后台配置项(一个 JSON 配置)
后台只有一个配置项,值是一组 JSON(设计理由见 4.4.3)。常量与解析模型:
// SiteSettingConstants.java
/** AdSense 广告配置(单个 JSON 字符串,含 client / adsTxt / slots) */
public static final String ADSENSE = "adsense";
// site_setting.adsense 的值(后台唯一入口)
{
  "enabled": true,
  "client": "ca-pub-1234567890123456",
  "adsTxt": "",
  "slots": [
    { "slot": "1111111111", "position": "articleTop",       "enabled": true },
    { "slot": "2222222222", "position": "articleInArticle", "enabled": true },
    { "slot": "3333333333", "position": "articleBottom",    "enabled": false }
  ]
}
// module/seo/domain/AdsenseConfig.java —— 整个 JSON 的载体
@Getter @Setter
public class AdsenseConfig {
    private Boolean enabled;          // 总开关,null 视为 true
    private String client;            // ca-pub-…
    private String adsTxt;            // 可选
    private List<AdSlot> slots = new ArrayList<>();
}

// module/seo/domain/AdSlot.java —— 单个广告位
@Getter @Setter
public class AdSlot {
    private String slot;       // data-ad-slot
    private String position;   // articleTop / articleInArticle / articleBottom / listTop …
    private Boolean enabled;   // null 视为 true
    private String format;     // 可选:auto(默认)
    private Boolean fullWidth; // 可选:默认 true
}
// SiteSettingService 扩展:读一次,解析成对象;组装时都从这里取
AdsenseConfig getAdsenseConfig();                  // 读 site_setting.adsense → 解析 JSON;空/异常返回空对象
String getAdsenseClient();                         // = getAdsenseConfig().getClient(),空则不注入
Map<String, String> getAdsenseSlotsByPosition();   // 只放 enabled != false 的位置 → slot,便于模板取
void saveAdsenseConfig(String json);               // 写 site_setting.adsense + deleteSiteInfoCache
解析兜底(关键):getAdsenseConfig() 必须容错——JSON 为空、格式错、client 为空时都返回"空配置",这样下游"拿不到就不输出",与 4.3.8 的 GA4 处理一致:
@Override
public AdsenseConfig getAdsenseConfig() {
    String json = settingValue(SiteSettingConstants.ADSENSE);
    if (json == null || json.trim().isEmpty()) return new AdsenseConfig();
    try {
        AdsenseConfig cfg = JacksonUtils.parse(json, AdsenseConfig.class);
        return cfg == null ? new AdsenseConfig() : cfg;
    } catch (Exception e) {
        return new AdsenseConfig(); // 配置损坏 = 不注入,绝不报错中断页面
    }
}
5.3.1.2、SSR 页面注入(seo-head.html + seo/blog.html)
① 加载器注入公共 head(与 GA4 的 th:if 同款;配了 ID 才输出):
<script th:if="${seo.adsenseClient != null and !seo.adsenseClient.isEmpty()}"
        async
        th:src="'https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=' + ${seo.adsenseClient}"
        crossorigin="anonymous"></script>
SeoMeta 增加字段,由 SeoMetaBuilder 从 getAdsenseConfig() 组装时填充:
private String adsenseClient;                          // = config.getClient(),空则不注入加载器
private Map<String, String> adsenseSlots = new HashMap<>(); // 位置 → slot(只放 enabled != false)
真正组装的地方就是
SeoMetaBuilder:读一次siteSettingService.getAdsenseConfig(),把client作为加载器开关、把slots过滤后转成position → slot的 map,注入SeoMeta;模板只消费这个 map,不感知原始 JSON。
② 文章模板按位置渲染广告位(templates/seo/blog.html),用 adslot 片段,取不到 slot 就不渲染:
<div class="article-ad"
     th:fragment="adslot(seo, pos)"
     th:if="${seo.adsenseClient != null and seo.adsenseSlots[${pos}] != null}">
  <ins class="adsbygoogle"
       style="display:block"
       th:attr="data-ad-client=${seo.adsenseClient},data-ad-slot=${seo.adsenseSlots[${pos}]}"
       data-ad-format="auto"
       data-full-width-responsive="true"></ins>
  <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
</div>

<article>
  <div th:replace="~{seo/blog :: adslot(${seo}, 'articleTop')}"></div>
  <h1 th:text="${article.title}">文章标题</h1>
  <div class="content" th:utext="${article.content}">正文</div>
  <div th:replace="~{seo/blog :: adslot(${seo}, 'articleBottom')}"></div>
</article>
文内位(articleInArticle)需在 SeoHtmlSupport 里按 </p> 计数插入占位,作为进阶项,一阶段可先不做。
5.3.1.3、SPA 页面注入(main.js + 路由切换)
// main.js:读 /site 拿 adsense 配置,动态注入加载器;后台改配置无需重新构建
fetch('/site').then(r => r.json()).then(res => {
  const cfg = res.data.siteInfo.adsense;      // 与后端同一份 JSON(见 5.3.1.1)
  if (!cfg || !cfg.client || cfg.enabled === false) return;
  window.__adsenseClient = cfg.client;
  const s = document.createElement('script');
  s.async = true; s.crossOrigin = 'anonymous';
  s.src = `https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=${cfg.client}`;
  document.head.appendChild(s);
});
/site的siteInfo里把adsense作为对象返回(后端已解析),前端不必再 parse 字符串。
// router/index.js:用户切路由(主动行为)后,为新页面的 <ins> push 一次
router.afterEach(() => {
  if (!window.__adsenseClient) return;
  setTimeout(() => {
    document.querySelectorAll('ins.adsbygoogle:not([data-pushed])').forEach(el => {
      el.setAttribute('data-pushed', '1');            // 标记,避免重复 push
      (window.adsbygoogle = window.adsbygoogle || []).push({});
    });
  }, 0);
});
**合规底线:**只允许"用户切换路由后 push 新广告位";禁止定时器反复刷同一广告位,否则违反 4.4.6 的自动刷新政策。
5.3.1.4、ads.txt 站点级文件(复用 SeoFileService)
// SeoFileController
@GetMapping(value = "/ads.txt", produces = "text/plain;charset=UTF-8")
public String adsTxt() { return seoFileService.adsTxt(); }
// SeoFileServiceImpl:从同一个 adsense 配置里取,自定义优先,否则按 client 自动生成
@Override
public String adsTxt() {
    AdsenseConfig cfg = siteSettingService.getAdsenseConfig();
    String custom = cfg.getAdsTxt();
    if (custom != null && !custom.trim().isEmpty()) return custom;
    String client = cfg.getClient();
    if (client == null || client.trim().isEmpty()) return "";
    return "google.com, " + client.replace("ca-", "") + ", DIRECT, f08c47fec0942fa0\n";
}
后台「SEO 配置 → 核心文件」把 ads.txt 加进 SeoConfigController 的 contentOf/fileNameOf/contentTypeOf 三处 switch 即可查看/下载(见 5.1.5.3)。
5.3.1.5、配置 → 成品对照(文章页)
后台配置(唯一入口:site_setting.adsense 一组 JSON):
{
  "enabled": true,
  "client": "ca-pub-9876543210987654",
  "adsTxt": "",
  "slots": [
    { "slot": "1111111111", "position": "articleTop",       "enabled": true },
    { "slot": "2222222222", "position": "articleInArticle", "enabled": true },
    { "slot": "3333333333", "position": "articleBottom",    "enabled": true }
  ]
}
后端组装(SeoMetaBuilder 从上面 JSON 读一次):
getAdsenseConfig()  →  enabled=true, client=ca-pub-9876…, slots=[…]
   ↓ 过滤 enabled != false
SeoMeta.adsenseClient = "ca-pub-9876543210987654"
SeoMeta.adsenseSlots  = { articleTop: "1111111111", articleInArticle: "2222222222", articleBottom: "3333333333" }
渲染出的 /blog/513 HTML(精简):
<head>
  <title>Java基础学习笔记 09、IO流 - BlogLoom</title>
  <link rel="canonical" href="https://blog.changlu.cloud/blog/513">
  <script async
    src="https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=ca-pub-9876543210987654"
    crossorigin="anonymous"></script>
</head>
<body>
  <div class="article-ad">
    <ins class="adsbygoogle" style="display:block"
         data-ad-client="ca-pub-9876543210987654" data-ad-slot="1111111111"
         data-ad-format="auto" data-full-width-responsive="true"></ins>
    <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
  </div>
  <article>
    <h1>Java基础学习笔记 09、IO流</h1>
    <div class="article-ad">
      <ins class="adsbygoogle" style="display:block"
           data-ad-client="ca-pub-9876543210987654" data-ad-slot="2222222222"
           data-ad-format="auto" data-full-width-responsive="true"></ins>
      <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
    </div>
    <div class="content">……完整正文……</div>
    <div class="article-ad">
      <ins class="adsbygoogle" style="display:block"
           data-ad-client="ca-pub-9876543210987654" data-ad-slot="3333333333"
           data-ad-format="auto" data-full-width-responsive="true"></ins>
      <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
    </div>
  </article>
</body>
页面实际看到的样子(文章页 demo):
┌──────────────────────────────────────────────────────────────┐
│  BlogLoom  首页  归档  标签  分类                      🔍       │
├──────────────────────────────────────────────────────────────┤
│              Java基础学习笔记 09、IO流                        │
│              2026-10-01 · Java · 阅读 1.2w                    │
│   ┌──────────────────────────────────────────────────────┐   │
│   │           广告位 articleTop / slot 1111111111         │   │  ← 标题下方横幅
│   └──────────────────────────────────────────────────────┘   │
│   从 File 类入手……(第 1 段)…(第 2 段)                       │
│   ┌──────────────────────────────────────────────────────┐   │
│   │        广告位 articleInArticle / slot 2222222222      │   │  ← 文内矩形
│   └──────────────────────────────────────────────────────┘   │
│   ……(第 4 段及以后正文、代码块、图片)……                      │
│   ┌──────────────────────────────────────────────────────┐   │
│   │        广告位 articleBottom / slot 3333333333         │   │  ← 正文结束、推荐前
│   └──────────────────────────────────────────────────────┘   │
│   #Java  #IO流                                               │
└──────────────────────────────────────────────────────────────┘
配置 ↔ 成品对应:
| 后台 JSON 字段 | 生成/展示位置 | 页面上看到 |
|---|---|---|
client = ca-pub-9876… |
<head> 的 adsbygoogle.js |
全页广告能加载 |
slots[].position=articleTop / slot=1111… |
<h1> 之后、正文之前 |
标题下横幅 |
slots[].position=articleInArticle / slot=2222… |
正文第 2~3 段后 | 文内矩形 |
slots[].position=articleBottom / slot=3333… |
正文末尾、推荐前 | 结尾信息流 |
adsTxt 留空 |
/ads.txt |
一行 google.com, pub-9876543210987654, DIRECT, … |
5.3.1.6、只接 1 个 slot 的最小示范(推荐起步)
很多人只想先放 1 个广告位。完全可以:把 slots 只留一条,模板就只渲染这一个位置;其余位置"取不到 slot 直接跳过"。配合 Auto ads,效果是"1 个手动位 + Google 自动补位"(原理见 4.4.2 ⑤)。
后台配置(唯一入口 JSON):
{
  "enabled": true,
  "client": "ca-pub-9876543210987654",
  "adsTxt": "",
  "slots": [
    { "slot": "1111111111", "position": "articleTop", "enabled": true }
  ]
}
后端组装(SeoMetaBuilder):
SeoMeta.adsenseClient = "ca-pub-9876543210987654"
SeoMeta.adsenseSlots  = { articleTop: "1111111111" }   // 只有这一个键
渲染出的 /blog/513 HTML(精简,注意只有 1 个广告位):
<head>
  <title>Java基础学习笔记 09、IO流 - BlogLoom</title>
  <link rel="canonical" href="https://blog.changlu.cloud/blog/513">
  <!-- 加载器照常注入(Auto ads 靠它生效) -->
  <script async
    src="https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=ca-pub-9876543210987654"
    crossorigin="anonymous"></script>
</head>
<body>
  <!-- articleTop 有 slot → 渲染 -->
  <div class="article-ad">
    <ins class="adsbygoogle" style="display:block"
         data-ad-client="ca-pub-9876543210987654" data-ad-slot="1111111111"
         data-ad-format="auto" data-full-width-responsive="true"></ins>
    <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
  </div>
  <article>
    <h1>Java基础学习笔记 09、IO流</h1>
    <div class="content">……完整正文……</div>
    <!-- articleInArticle / articleBottom 取不到 slot → 这两处不渲染任何 <ins> -->
  </article>
</body>
页面效果:
┌──────────────────────────────────────────────────────────────┐
│  BlogLoom  首页  归档  标签  分类                      🔍       │
├──────────────────────────────────────────────────────────────┤
│              Java基础学习笔记 09、IO流                        │
│   ┌──────────────────────────────────────────────────────┐   │
│   │      广告位 articleTop / slot 1111111111(唯一手动位)  │   │
│   └──────────────────────────────────────────────────────┘   │
│   正文……(其余位置没有手动广告位;若开了 Auto ads,          │
│          Google 可能自行在别处插入广告)                     │
│   #Java  #IO流                                               │
└──────────────────────────────────────────────────────────────┘
要点:
- 只配 1 个 slot ≠ 页面只显示 1 个广告;Auto ads 开着时可能还有 Google 自动插的广告。
- 想从 1 个变多个,只需在后台 JSON 的
slots里加一条,不改代码。 - 完全不要手动位时,把
slots留空数组[],纯靠 Auto ads 也能有广告。
5.3.1.7、多 slot 时的完整生成代码(顶/文内/底全放)
如果希望精确控制多个位置,就把三个 slot 都配上。每个位置都是独立的广告单元,各自在自己的位置渲染一段 <ins> + 一次 push。
后台配置:
{
  "enabled": true,
  "client": "ca-pub-9876543210987654",
  "adsTxt": "",
  "slots": [
    { "slot": "1111111111", "position": "articleTop",       "enabled": true },
    { "slot": "2222222222", "position": "articleInArticle", "enabled": true, "format": "rectangle" },
    { "slot": "3333333333", "position": "articleBottom",    "enabled": true }
  ]
}
后端组装:
SeoMeta.adsenseClient = "ca-pub-9876543210987654"
SeoMeta.adsenseSlots  = {
  articleTop:       "1111111111",
  articleInArticle: "2222222222",
  articleBottom:    "3333333333"
}
渲染出的 /blog/513 HTML(精简)—— 模板 adslot 片段被调用 3 次:
<head>
  <title>Java基础学习笔记 09、IO流 - BlogLoom</title>
  <link rel="canonical" href="https://blog.changlu.cloud/blog/513">
  <script async
    src="https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=ca-pub-9876543210987654"
    crossorigin="anonymous"></script>
</head>
<body>
  <!-- ① articleTop -->
  <div class="article-ad">
    <ins class="adsbygoogle" style="display:block"
         data-ad-client="ca-pub-9876543210987654" data-ad-slot="1111111111"
         data-ad-format="auto" data-full-width-responsive="true"></ins>
    <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
  </div>

  <article>
    <h1>Java基础学习笔记 09、IO流</h1>

    <!-- ② articleInArticle:由 SeoHtmlSupport 在第 2~3 段后插入占位 -->
    <div class="article-ad">
      <ins class="adsbygoogle" style="display:block"
           data-ad-client="ca-pub-9876543210987654" data-ad-slot="2222222222"
           data-ad-format="rectangle" data-full-width-responsive="true"></ins>
      <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
    </div>

    <div class="content">……完整正文……</div>

    <!-- ③ articleBottom -->
    <div class="article-ad">
      <ins class="adsbygoogle" style="display:block"
           data-ad-client="ca-pub-9876543210987654" data-ad-slot="3333333333"
           data-ad-format="auto" data-full-width-responsive="true"></ins>
      <script>(adsbygoogle = window.adsbygoogle || []).push({});</script>
    </div>
  </article>
</body>
关键点:
- 加载器只有 1 个(在
<head>,来自client);<ins>有几个,就有几次push({})。- 每个
<ins>的data-ad-slot不同,对应后台slots里不同的广告单元。format(如rectangle)只影响桌面显示形状,不改"能不能出广告"。- 想临时去掉某一位:该条
enabled改成false,源码里就不再出现这段<ins>。
变体:
- 只配
articleTop→ 页面只有标题下一个广告位,其它位置不渲染(th:if兜底)。 - 某位
enabled:false→ 该位在SeoMetaBuilder组装时被过滤,源码里不出现。 client留空(或整段 JSON 清空)→<head>无加载器、所有广告位不渲染、ads.txt为空 = 全站关广告,无需改代码。
**SPA 页对照(首页 demo):**加载器由 main.js 注入,<ins> 由 Vue 组件渲染、router.afterEach 统一 push;页面效果:
┌──────────────────────────────────────────────────────────────┐
│  BlogLoom  首页  归档  标签  分类                      🔍       │
├──────────────────────────────────────────────────────────────┤
│   ┌──────────────────────────────────────────────────────┐   │
│   │          广告位 listTop / slot 4444444444             │   │  ← 列表顶部横幅
│   └──────────────────────────────────────────────────────┘   │
│   [封面]  Java基础学习笔记 09、IO流      2026-10-01           │
│   [封面]  Spring Boot 定时任务入门        2026-09-28           │
└──────────────────────────────────────────────────────────────┘
5.3.1.8、验收(curl)
# 文章页加载器 + 广告位
curl -s -H 'Accept: text/html' https://blog.changlu.cloud/blog/513 \
  | grep -Eo 'adsbygoogle[^"]*|data-ad-slot="[0-9]+"'

# ads.txt
curl -s https://blog.changlu.cloud/ads.txt
# 期望:google.com, pub-9876543210987654, DIRECT, f08c47fec0942fa0

# 未配置时不注入(后台先清空发布商 ID)
curl -s -H 'Accept: text/html' https://blog.changlu.cloud/blog/513 | grep -c 'adsbygoogle'  # 期望 0
5.3.2、核心申请步骤
5.3.2.1、申请前自查(8 项)
| # | 项 | 怎么查 | 达标 |
|---|---|---|---|
| 1 | 内容可抓取 | curl -H 'Accept: text/html' …/blog/513 | grep '<h1>' |
源码有正文 |
| 2 | sitemap 可访问 | curl -s …/sitemap.xml |
200 |
| 3 | 被 Google 收录 | Search Console → 页面 | 部分已编入索引 |
| 4 | 隐私政策页 | 打开 /privacy |
含 Cookie + AdSense + 第三方 |
| 5 | 关于/联系页 | /about、有邮箱 |
页脚可进入 |
| 6 | 全站 HTTPS + 自有域名 | 浏览器地址栏 | 小锁 |
| 7 | 移动端可用 | 手机 / PageSpeed | 无红色硬伤 |
| 8 | 无死链 | 抽查导航/内链 | 无 404 |
5.3.2.2、申请与站点验证
① https://adsense.google.com/ 登录注册
② 填账号信息(国家/时区/收款姓名地址,须真实)
③ Sites → 添加站点 blog.changlu.cloud(只填域名)
④ 选验证方式:
     A. AdSense 代码 —— 首页 <head> 放加载器(本项目后台配 adsense JSON 里的 client 即自动注入)
     B. meta 标签  —— 不想首页放广告时用(复用 5.1.5.4 方案 B,由 SpaIndexController 注入)
⑤ 点 Verify(实时校验)
⑥ 进入审核(数天~两周),期间勿频繁改结构
⑦ 通过 → Ready → 广告开始展示(≤1h);被拒 → 按拒信整改,等 7~14 天再申
BlogLoom 推荐方式 B,让首页源码直接带上验证 meta(校验器不执行 JS):
<meta name="google-adsense-account" content="ca-pub-1234567890123456">
5.3.2.3、选择投放方式:按网站、按广告单元或同时使用
Google AdSense 中的「按网站」和「按广告单元」不是二选一,它们可以独立使用,也可以同时使用:
| 方式 | AdSense 后台入口 | 位置由谁决定 | BlogLoom 对应配置 |
|---|---|---|---|
| 按网站(自动广告) | Ads → By site | Google 根据页面自动选择 | autoAds=true,可以不配置 slots |
| 按广告单元(手动广告) | Ads → By ad unit | BlogLoom 根据 position 精确渲染 |
autoAds=false,配置一个或多个 slots |
| 混合投放 | 两处都配置 | Google 自动补位 + BlogLoom 手动位 | autoAds=true,同时配置多个 slots |
BlogLoom 的推荐配置结构为:
{
  "enabled": true,
  "client": "ca-pub-1234567890123456",
  "autoAds": true,
  "adsTxt": "",
  "slots": [
    {
      "position": "articleTop",
      "slot": "1111111111",
      "enabled": true,
      "format": "auto",
      "fullWidth": true
    },
    {
      "position": "articleBottom",
      "slot": "2222222222",
      "enabled": true,
      "format": "auto",
      "fullWidth": true
    }
  ]
}
全局加载器的输出条件:
enabled = true
并且 client 不为空
并且(autoAds = true 或至少存在一个 enabled != false 的 slot)
满足条件时,BlogLoom 在页面 <head> 中输出:
<script async
  src="https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=ca-pub-1234567890123456"
  crossorigin="anonymous"></script>
autoAds |
存在已启用 slot | BlogLoom 是否加载全局脚本 | 实际投放方式 |
|---|---|---|---|
false |
否 | 否 | 不投放 |
true |
否 | 是 | 仅自动广告 |
false |
是 | 是 | 仅手动广告单元 |
true |
是 | 是 | 自动广告 + 手动广告单元 |
关键边界:
adsbygoogle.js是自动广告和手动广告共用的加载器,脚本 URL 本身没有autoAds=true/false参数。autoAds表示 BlogLoom 的投放意图,Google 是否真正自动插入广告,最终仍由 AdSense 后台「按网站」开关决定。
因此需要同步完成以下操作:
- 选择「仅自动广告」或「混合投放」时,需在 AdSense 后台
Ads → By site中开启该站点的自动广告。 - 选择「仅手动广告单元」时,需在 AdSense 后台关闭该站点的自动广告;否则即使 BlogLoom 配置
autoAds=false,Google 仍可能通过同一加载器自动插入广告。 slots可以为空,也可以配置多个;每个 slot 对应一个独立广告单元,不同position不应复用同一个后台单元名称和统计口径。
5.3.2.4、创建广告单元拿 slot
AdSense 后台 → Ads → By ad unit → 新建"展示广告(Responsive)"
  → 保存 → Get code → 复制 <ins> 里的 data-ad-slot
| 单元名 | position | 位置 |
|---|---|---|
blog-article-top |
articleTop |
标题下、正文上 |
blog-article-inarticle |
articleInArticle |
正文第 2~3 段后(进阶) |
blog-article-bottom |
articleBottom |
正文结束、推荐前 |
把 slot 填进后台「SEO 优化 → 广告接入」的广告位表格。
5.3.2.5、ads.txt 上线与状态确认
① 打开 https://blog.changlu.cloud/ads.txt 确认一行内容
② AdSense → Sites → Ads.txt 看 "last crawled" 状态
③ 异常 → 点 Check for updates 重新抓取
④ 状态 Authorized → 正常投放
5.3.2.6、结算与监控
- **结算门槛:**余额满 100 美元 触发支付;需完成 PIN 身份验证与收款方式(国内电汇填 SWIFT/BIC)。
- **核心指标:**Page RPM / Impressions RPM / CTR / CPC(含义见 4.4.7),看周趋势而非单日。
- **监控节奏:**每周固定看广告展示、点击、RPM;出现"无效流量""政策提醒"邮件立即处理(见 4.4.6)。
六、验证测试
6.1、功能验收测试
原则:本节只保留"可整屏截图"的功能级验收;细粒度校验(字段、URL 拼接、HTML 处理、懒加载属性、JSON-LD 字段、XML 合法性等)一律收敛到单元测试(见 6.1.3),不在此重复。
6.1.1、功能测试验证(浏览器 / 后台,可直接截图)
| 序号 | 功能点 | 操作 | 预期结果(截图依据) | 截图 |
|---|---|---|---|---|
| 1 | 文章详情页直出 | 打开 /blog/{id} |
标题、正文、目录、评论占位正常渲染 |  |
| 2 | 文章页 SEO 信息齐全 | 查看网页源代码 | 唯一 <title>、description、canonical、Open Graph、application/ld+json 齐全 |
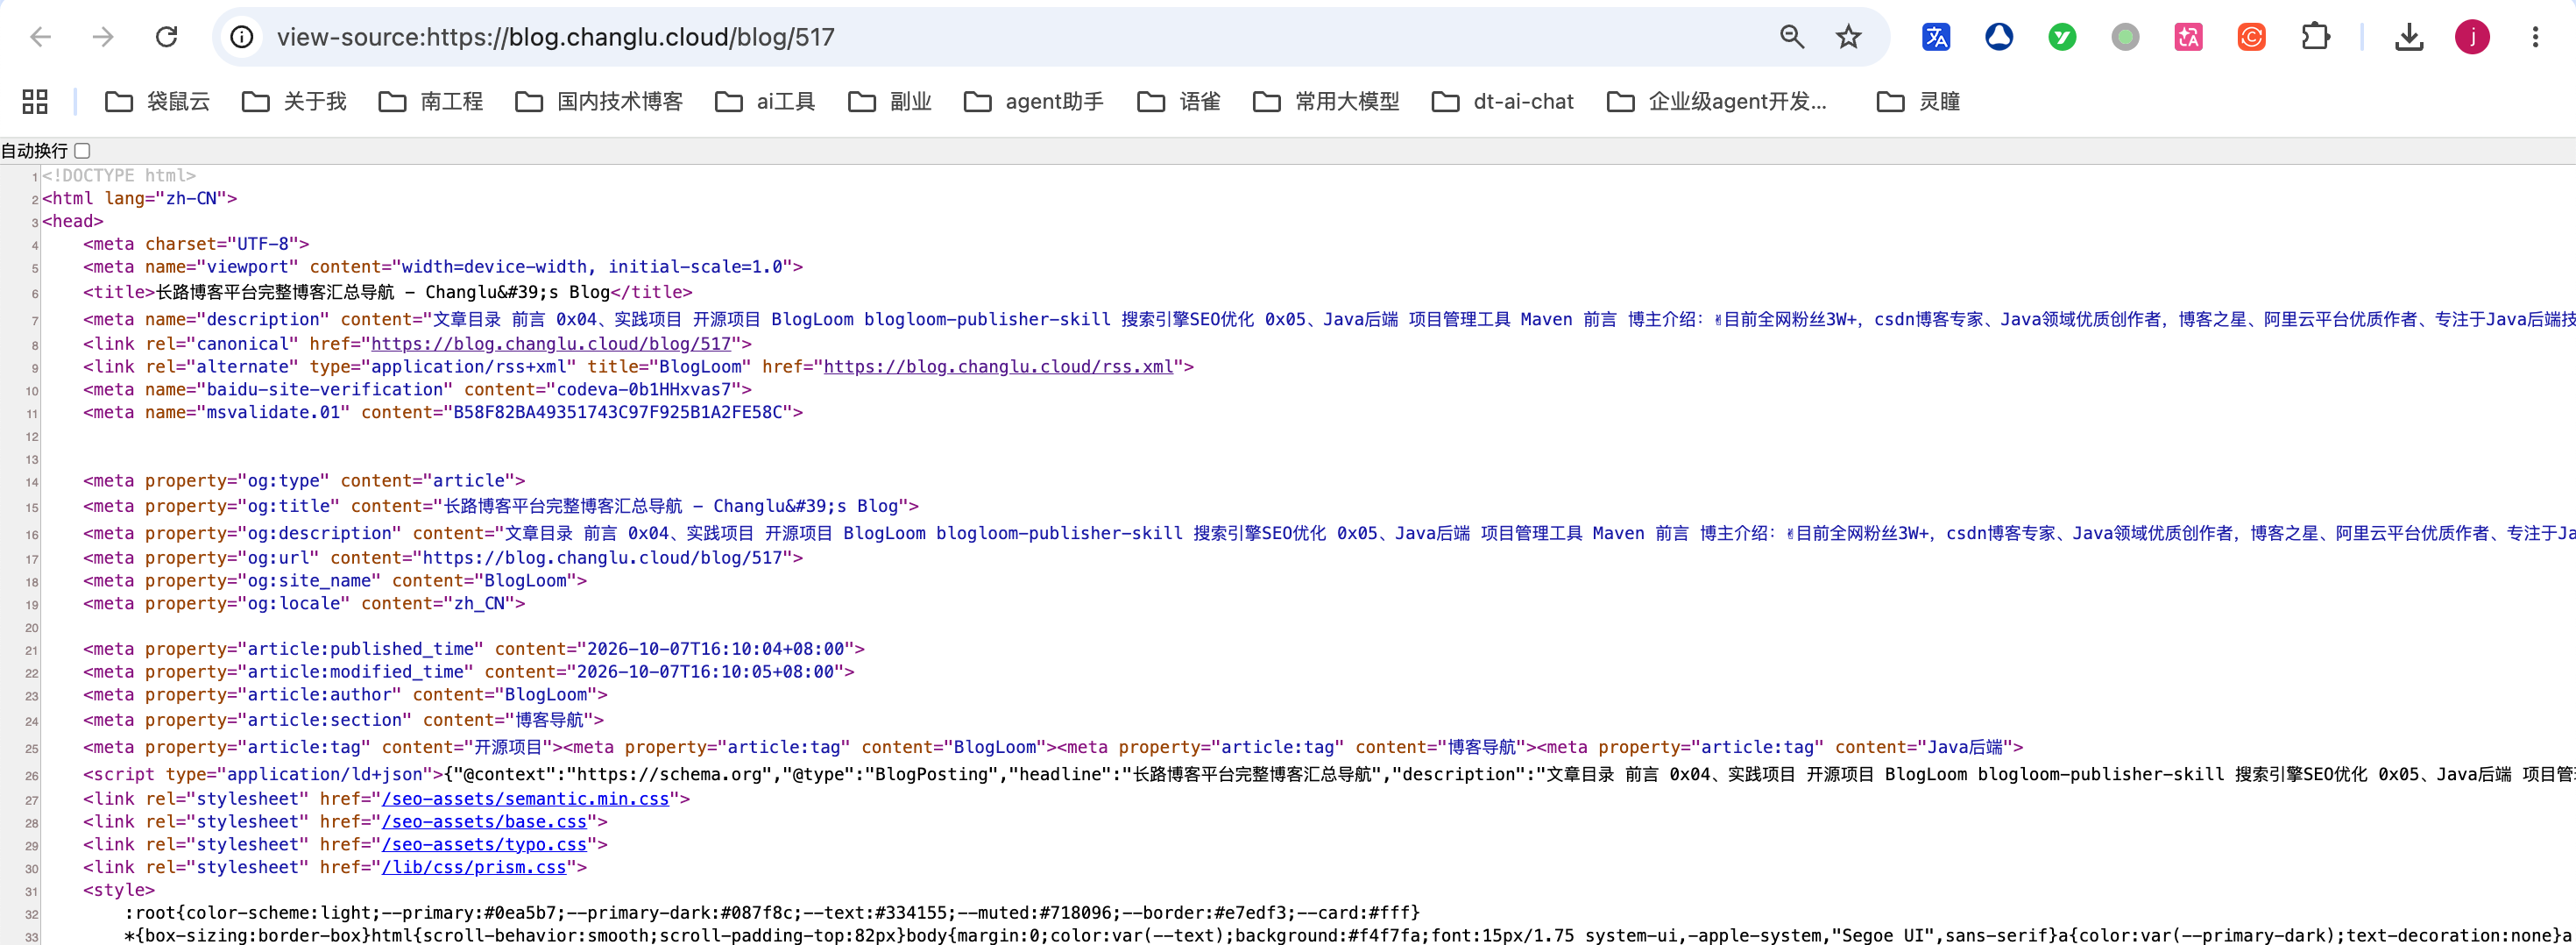 |
| 3 | 分享卡片 | 分享文章链接到微信 / QQ | 出现标题 + 摘要 + 封面卡片 |  |
| 4 | 聚合页直出 | 打开 /home、/tag/x、/category/x、/archives、/column/1 |
均正常展示文章列表 | 归档: 分类:  标签:  |
| 5 | 站点级文件可访问 | 浏览器打开 /robots.txt、/sitemap.xml、/rss.xml |
分别展示抓取规则 / 文章地图 / 订阅内容 | /robots.txt: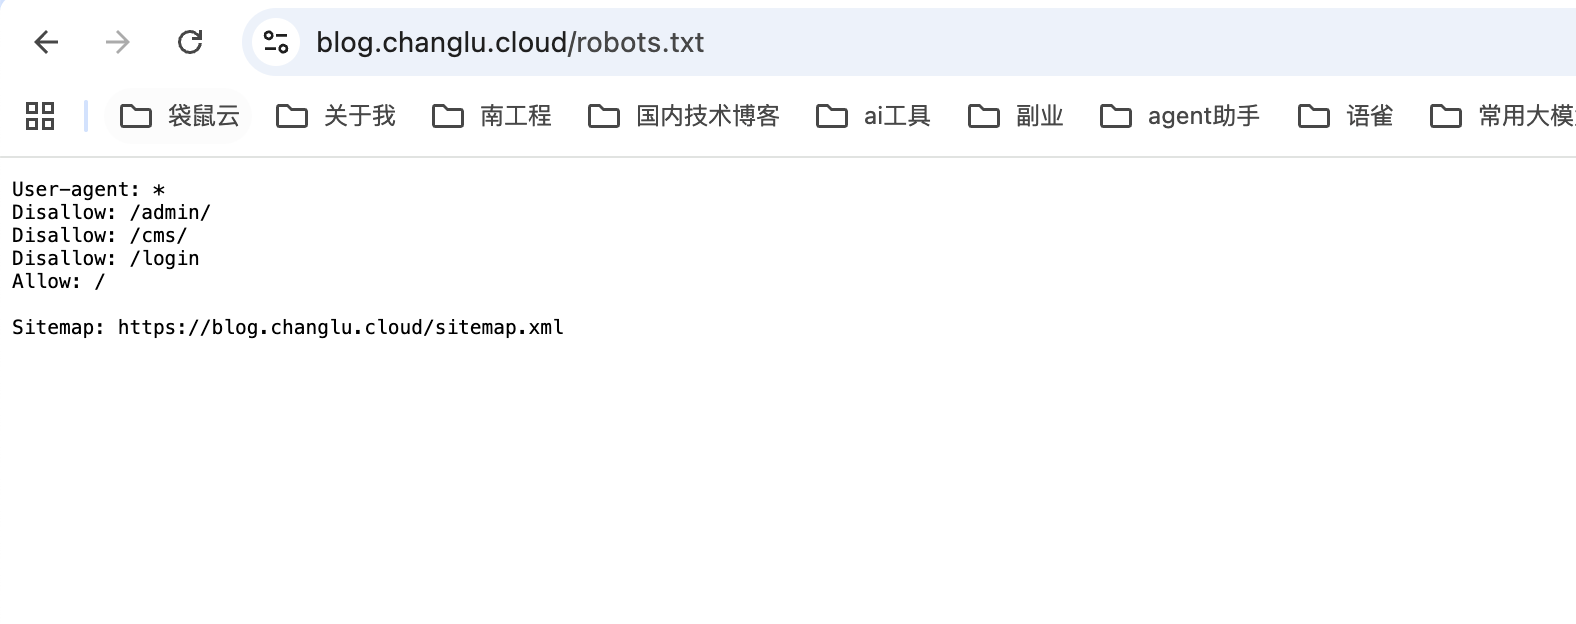 /sitemap.xml: 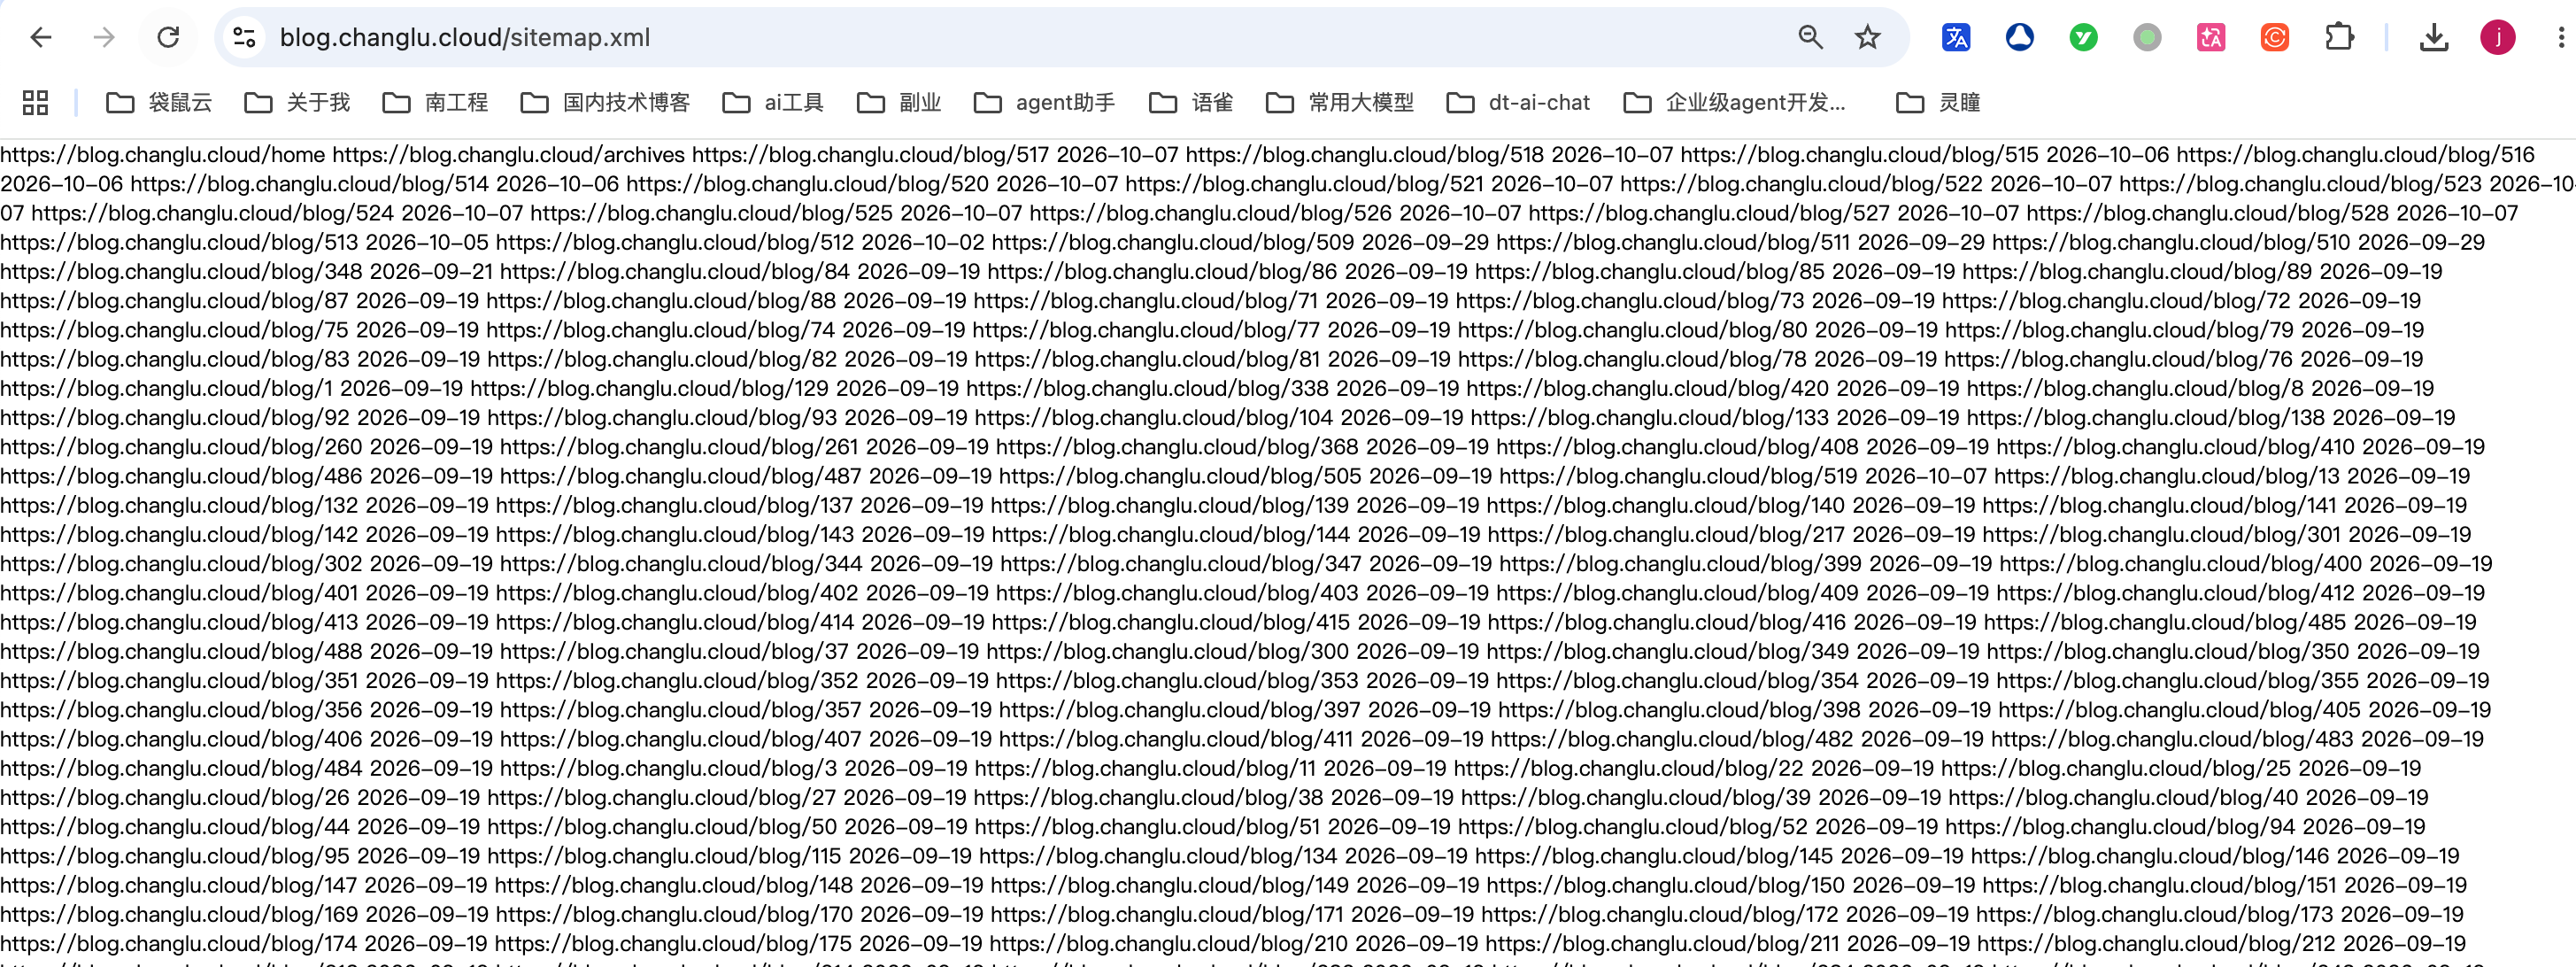 /rss.xml: 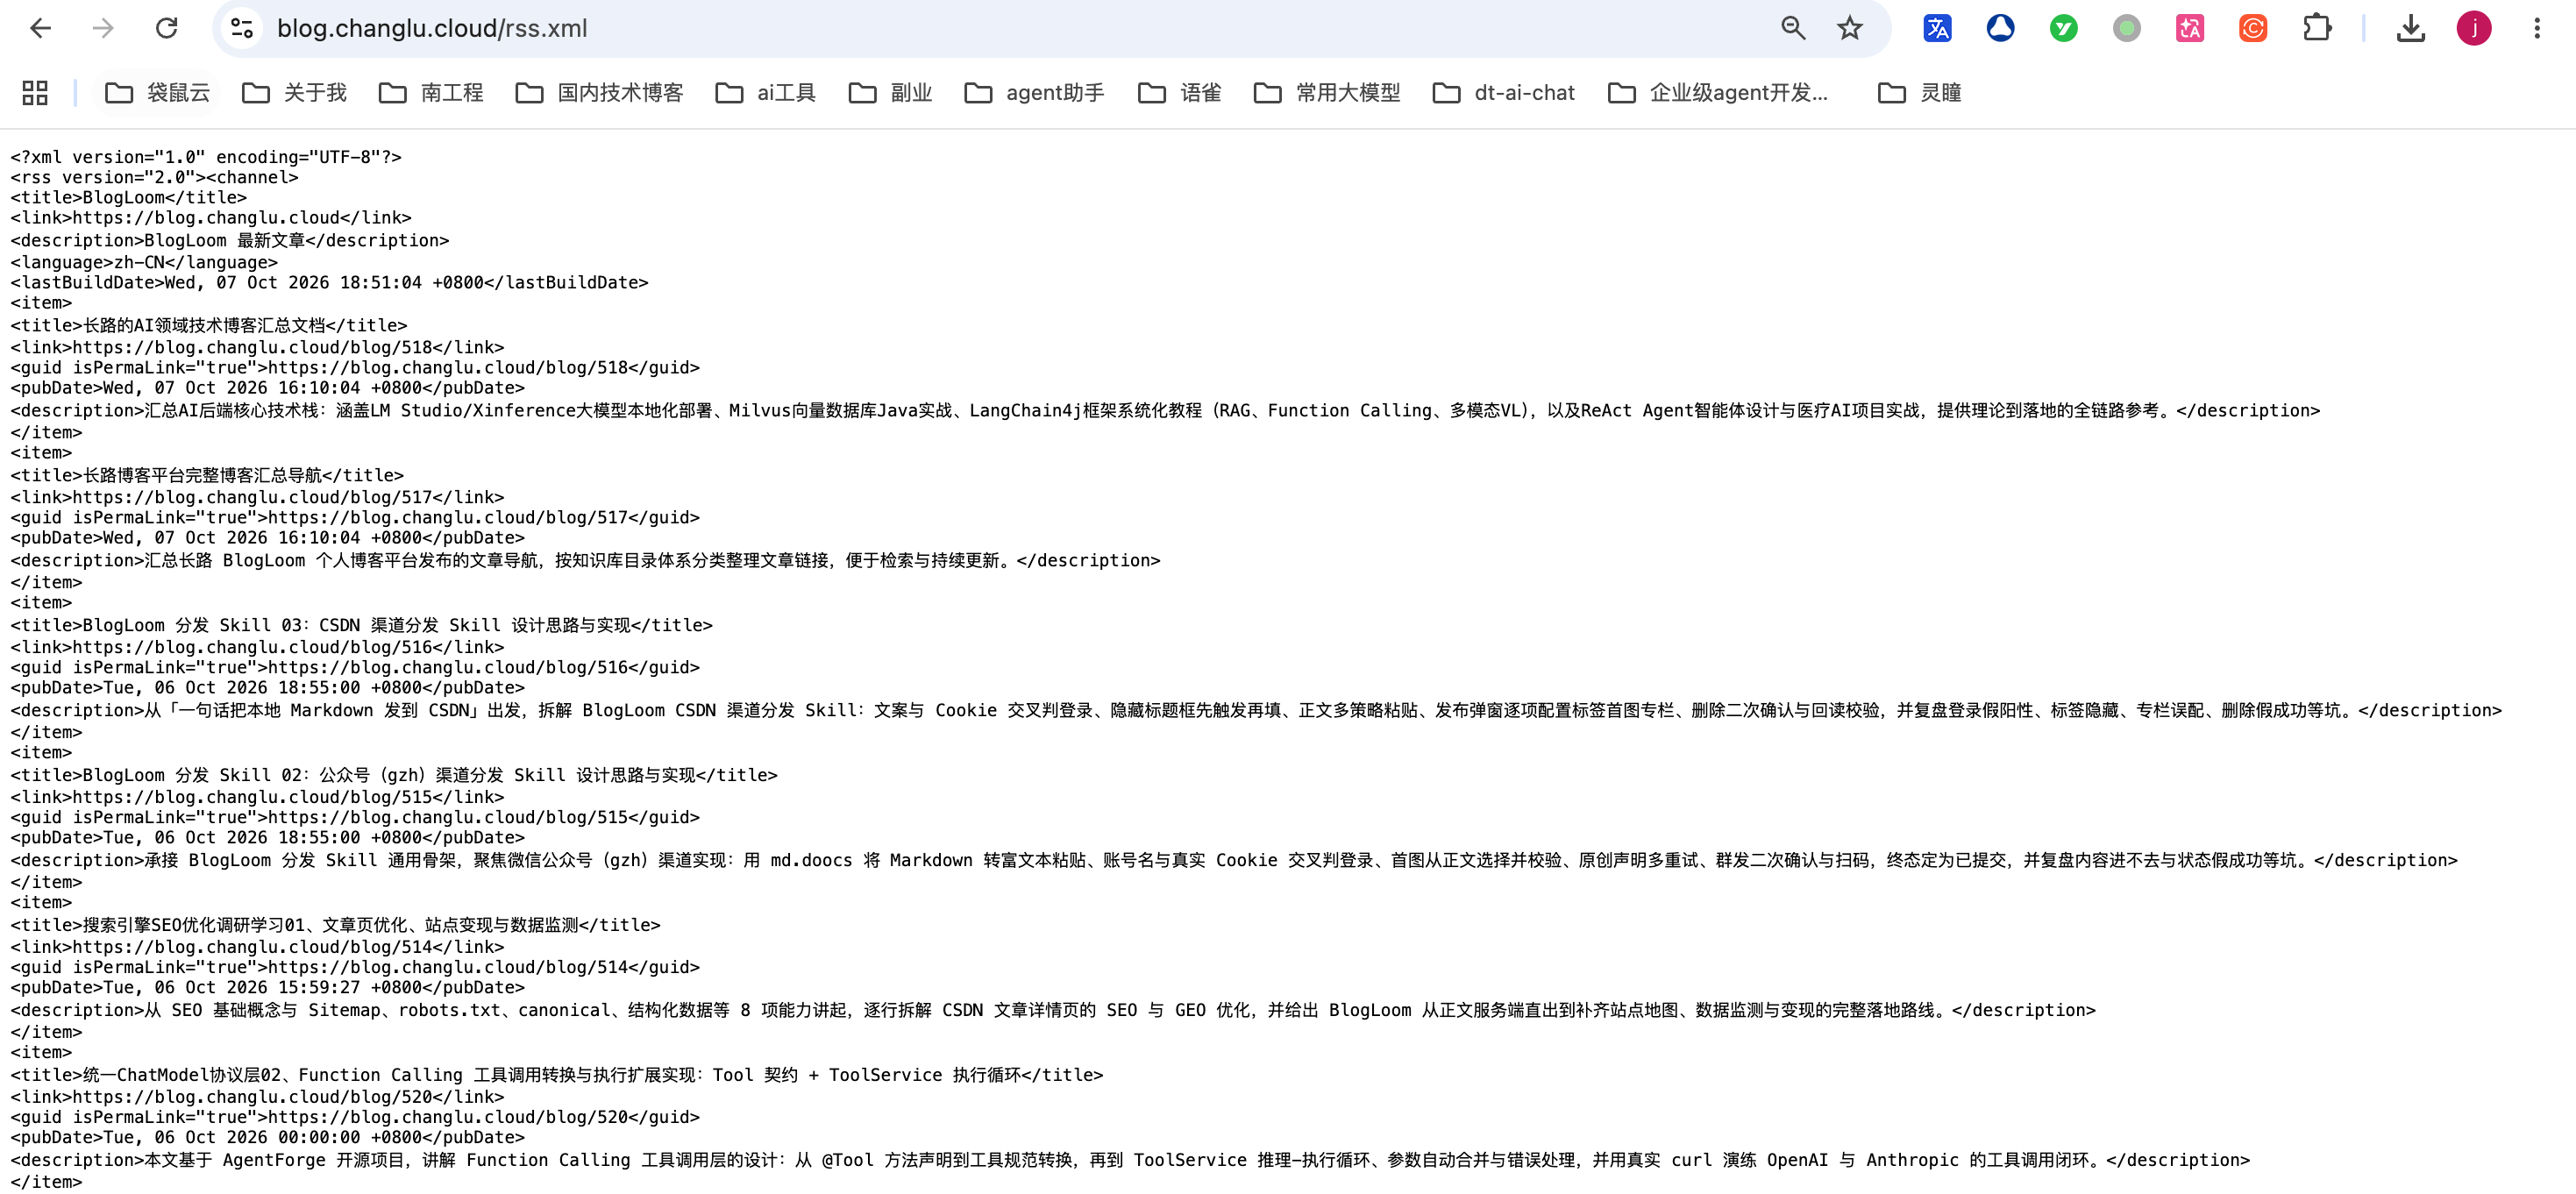 |
| 6 | SEO 域名配置 | 后台「SEO优化 → SEO配置」填域名并保存 | 保存成功;canonical / sitemap / RSS 使用新域名 | 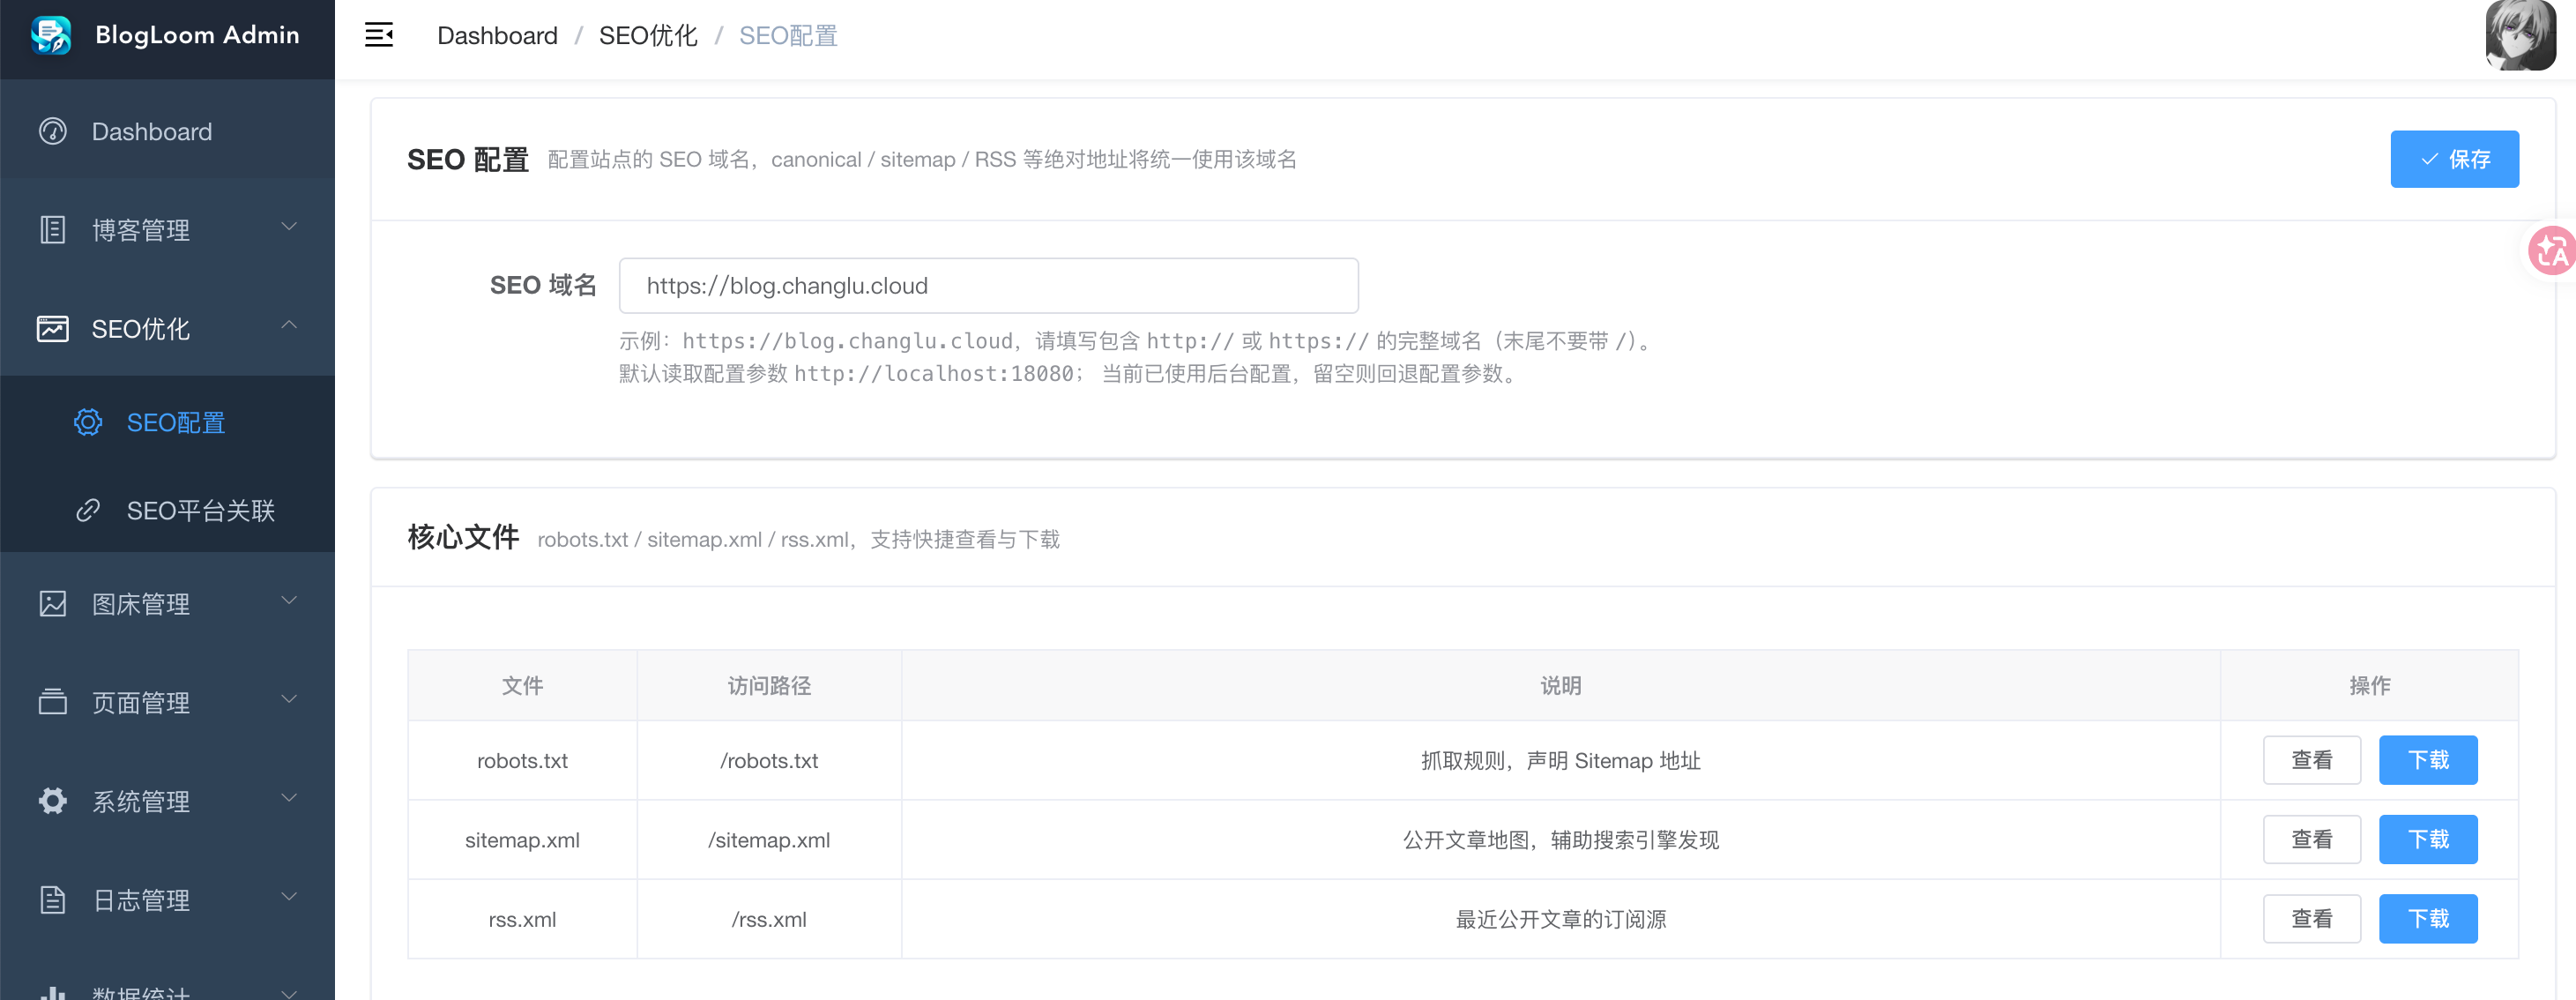 |
| 7 | 核心文件查看 / 下载 | 后台「SEO配置 → 核心文件」点「查看」「下载」 | 弹窗展示内容;下载得到三个文件 | 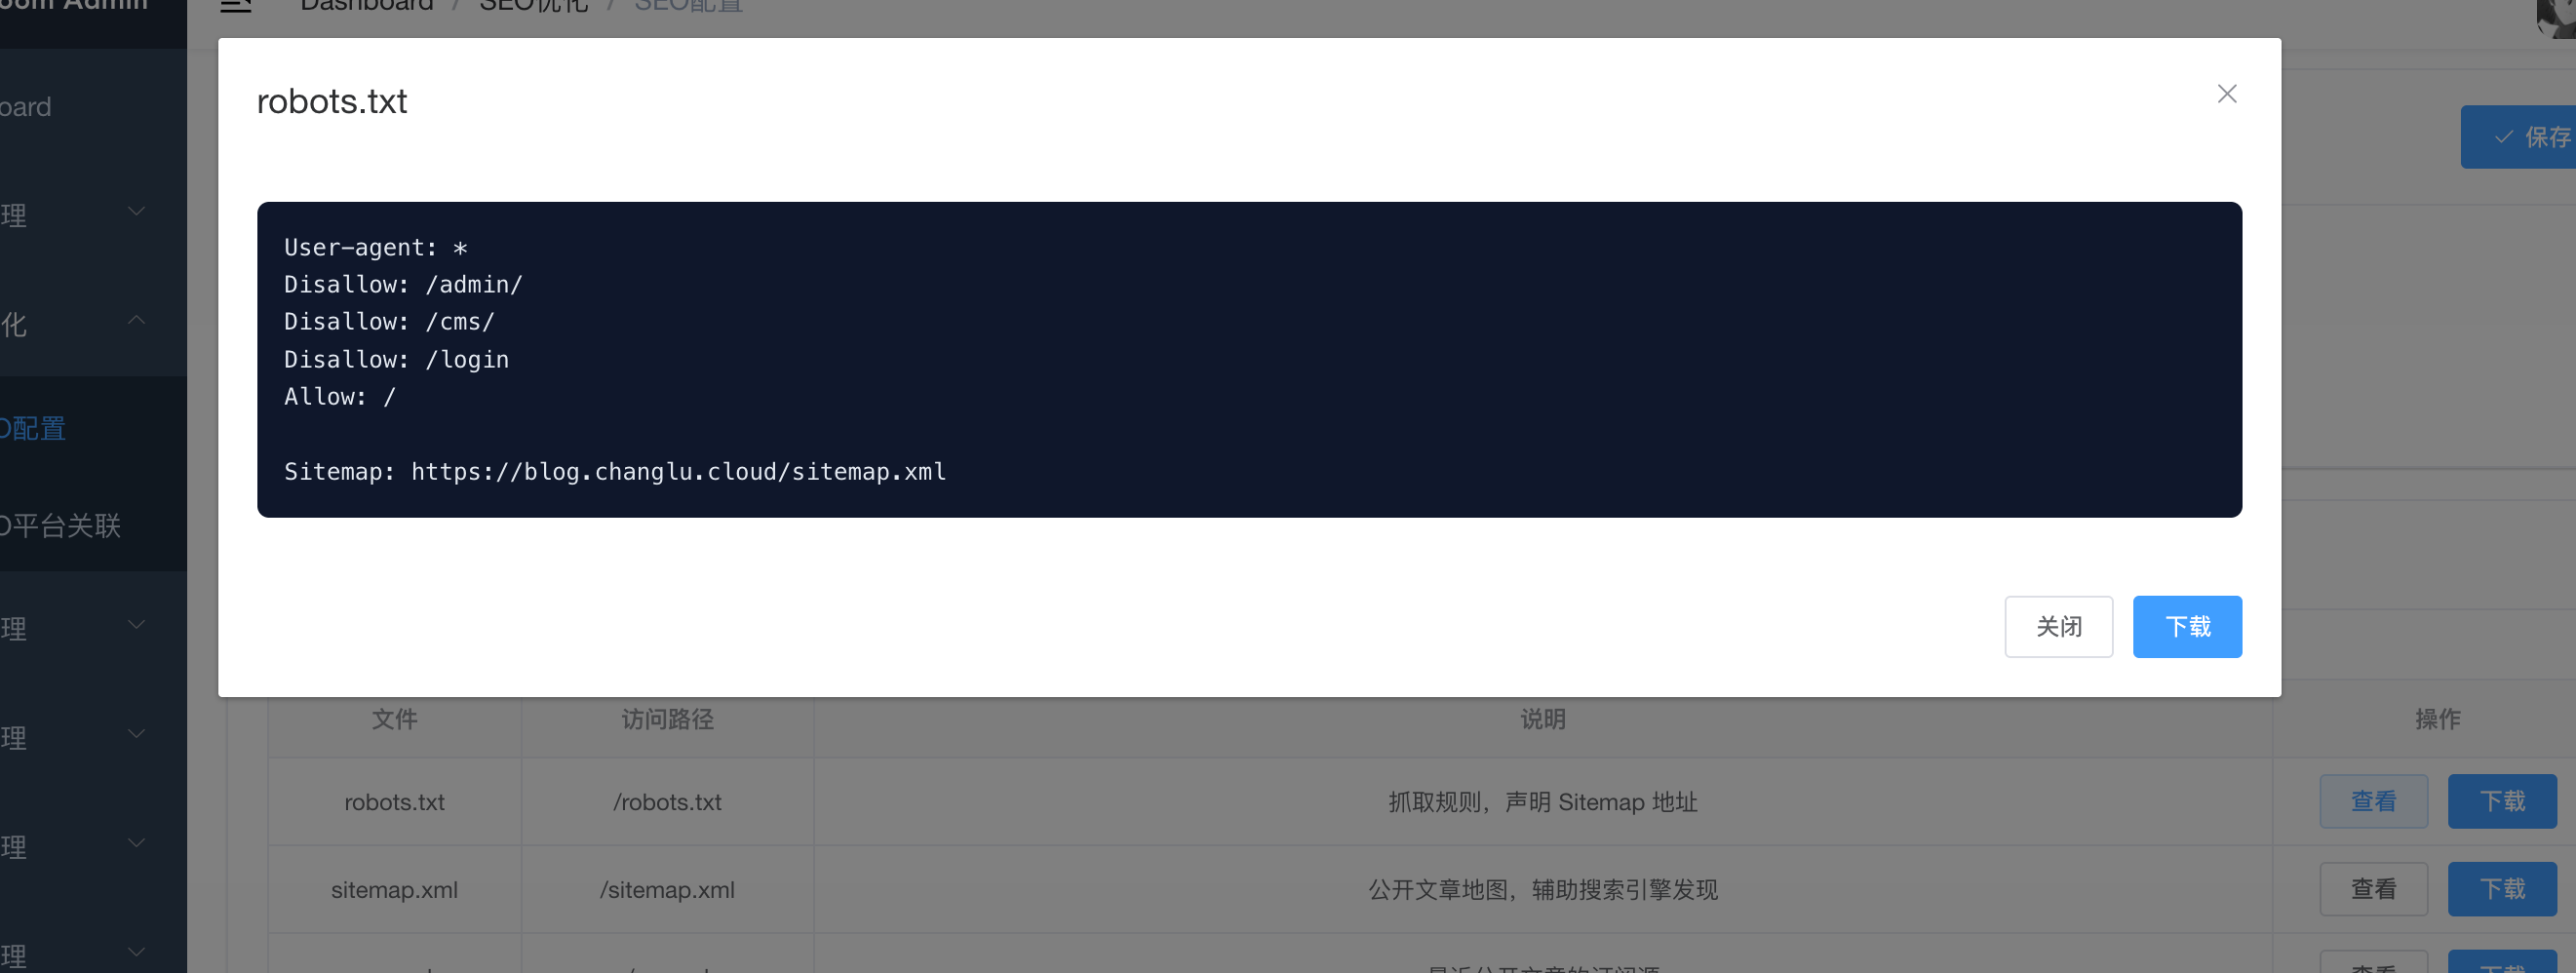 |
| 8 | 阅读页性能 | Lighthouse / PageSpeed Insights | 性能指标达标 | ✅ |
| 9 | 收录情况 | 搜索 site:域名 / Search Console |
有收录与搜索词数据 | 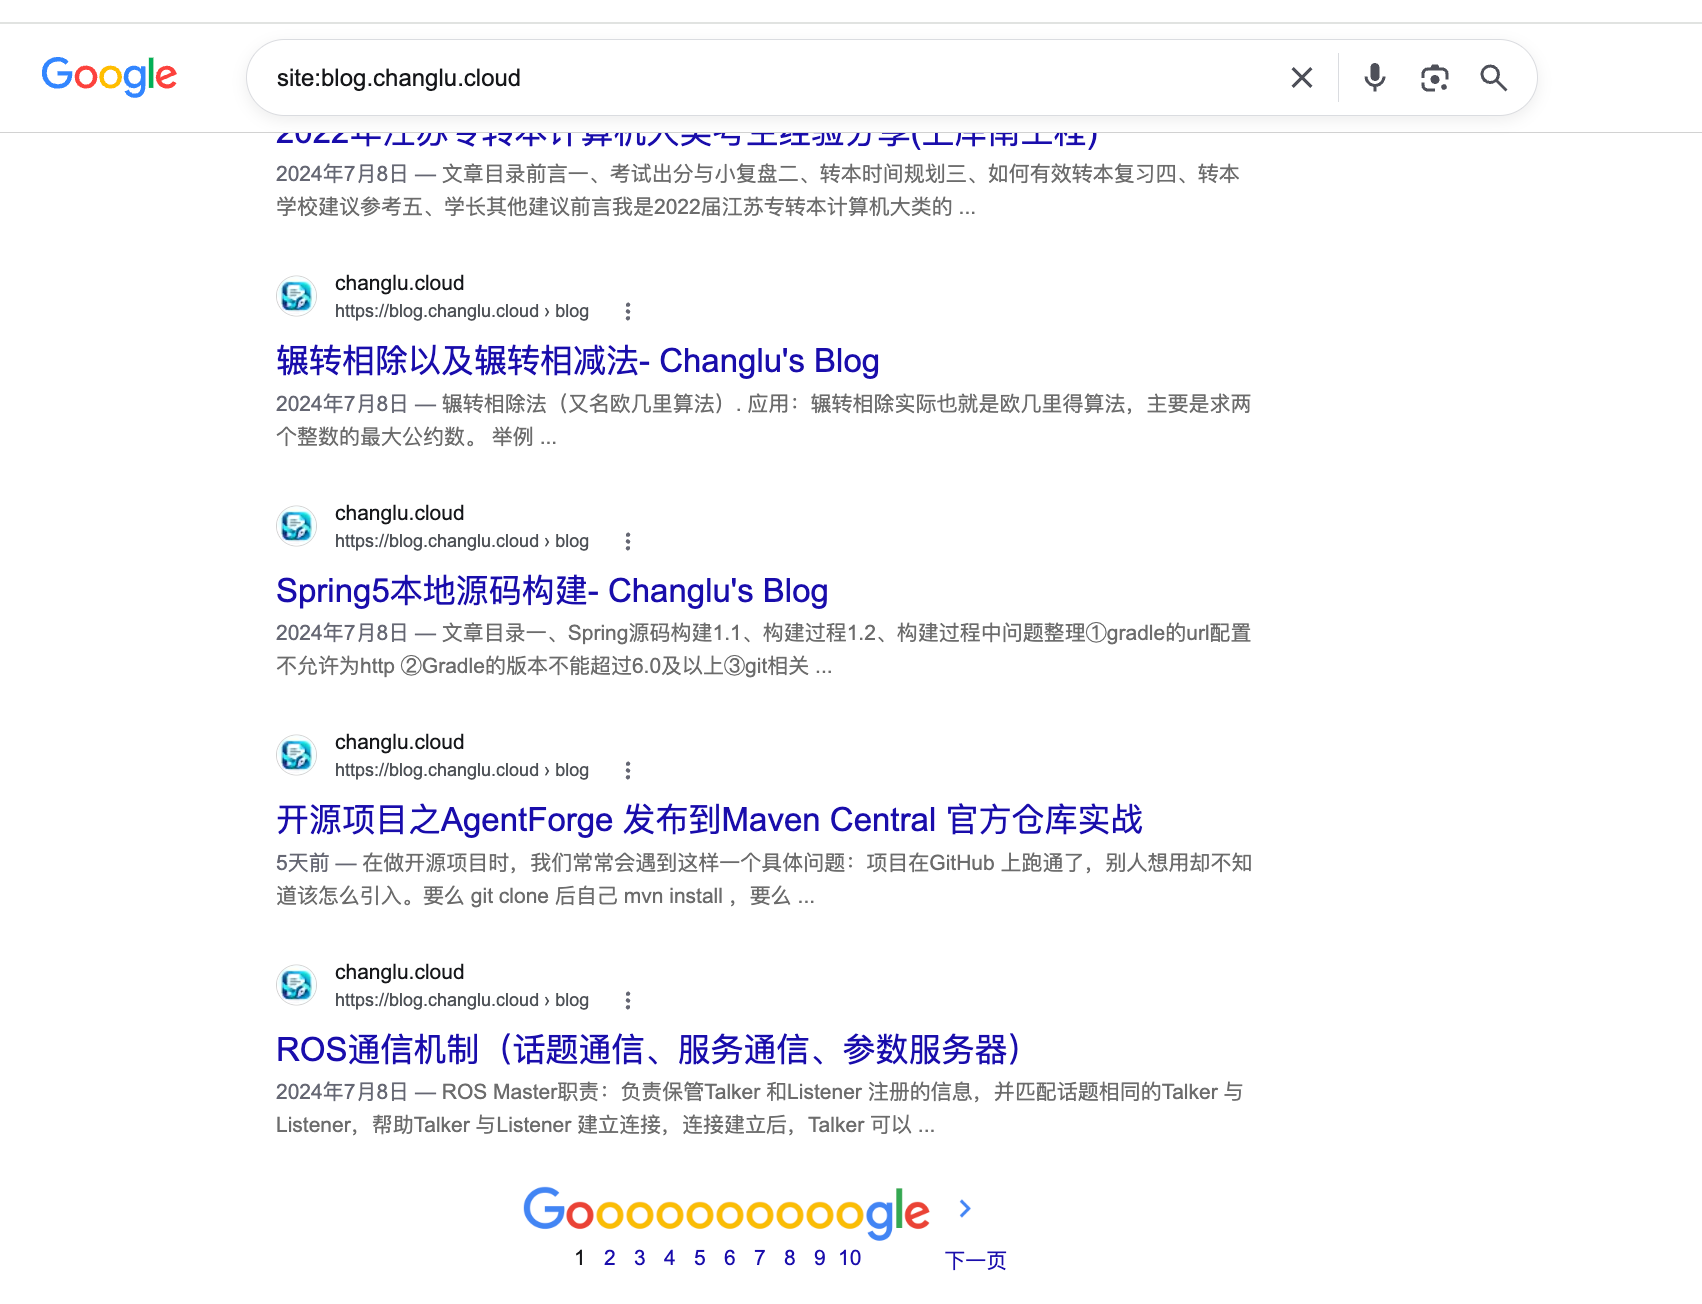 |
6.1.2、curl 测试验证(整份输出,可直接复制)
约定:
https://blog.changlu.cloud换成你的 SEO 域名;513换成实际文章 id。
| 序号 | 功能点 | 完整 curl 命令 | 预期结果 | 是否验证 |
|---|---|---|---|---|
| 1 | 详情页直出 | curl -s -H 'Accept: text/html https://blog.changlu.cloud/blog/513 |
返回完整文章 HTML | ✅ |
| 2 | robots.txt | curl -s https://blog.changlu.cloud/robots.txt |
返回规则与 Sitemap: 行 |
✅ |
| 3 | sitemap.xml | curl -s https://blog.changlu.cloud/sitemap.xml |
返回 <urlset> 文章地图 |
✅ |
| 4 | rss.xml | curl -s https://blog.changlu.cloud/rss.xml |
返回 RSS 2.0 订阅源 | ✅ |
| 5 | 聚合页 | curl -s -H 'Accept: text/html' https://blog.changlu.cloud/home |
返回文章列表 HTML | ✅ |
| 6 | 后台收录控制 | curl -sI https://blog.changlu.cloud/cms/ |
响应头含 X-Robots-Tag |
✅ |
6.1.3、细粒度校验(收敛到单元测试)
下列细粒度点不做人工截图,全部由后端单元测试覆盖,回归时一条命令即可校验:
| 单元测试类 | 覆盖的细粒度点 |
|---|---|
SeoUrlResolverTest |
seoDomain 优先 + 去尾斜杠、外链保持绝对地址 |
SeoMetaBuilderTest |
canonical、Open Graph、BlogPosting JSON-LD 字段 |
SeoHtmlSupportTest |
h1→h2、图片 loading=lazy、data-src 还原、TOC 提取与占位渲染 |
SeoFeedServiceTest |
sitemap 含 canonical 且 XML 合法;rss 转义且 XML 合法 |
SeoSiteLayoutServiceImplTest |
站点布局组装、缓存还原、私密文章过滤 |
SeoEndpointIntegrationTest |
详情页 / 标签聚合页直出、站点级文件端点、仅公开文章 |
运行方式:
cd blog-backend
mvn -Dtest='Seo*Test' test
6.2、一阶段上线验收清单
| 阶段 | 项目 | 完成 |
|---|---|---|
| M1 | GET /blog?id= 返回 firstPicture / description / 作者 |
☐ |
| M2 | curl -H 'Accept: text/html' /blog/{id} 能看到 <h1> 与正文 |
☐ |
| M2 | 每页唯一 <title>,含站点名后缀 |
☐ |
| M2 | meta description 非空且与文章一致 |
☐ |
| M2 | canonical = /blog/{id}(无参数),站内链接/Sitemap 一致 |
☐ |
| M3 | BlogPosting JSON-LD 通过 Schema/富媒体校验 |
☐ |
| M3 | 分享到微信/QQ 出现标题+摘要+封面 | ☐ |
| M4 | /robots.txt 200 且含 Sitemap 行 |
☐ |
| M4 | /sitemap.xml 200,仅含公开已发布文章 |
☐ |
| M4 | /rss.xml 200,页面含 RSS 自动发现链接 |
☐ |
| M5 | curl /tag/{name}、/category/{name}、/archives 可见列表 |
☐ |
| M5 | /cms/ 与 /admin/ 输出 noindex / X-Robots-Tag |
☐ |
| M6 | Search Console 验证成功并提交 Sitemap | ☐ |
| M6 | GA4 有实时数据;GitHub/订阅点击配置事件 | ☐ |
6.3、实施里程碑
| 里程碑 | 内容 | 交付物 | 预计改动 |
|---|---|---|---|
| M1 数据与地基 | F1 数据层补齐;SeoUrlResolver / SeoMeta / SeoMetaBuilder 骨架 |
详情接口含封面/摘要/作者 | 3 个类 + Mapper |
| M2 详情页直出 | F2 + F3;修改 SpaForwardConfig;seo/blog.html + seo-head.html |
curl /blog/{id} 可见正文与 title |
1 Controller + 2 模板 + 过滤器 |
| M3 结构化与传播 | F4 canonical + F5 JSON-LD + F6 OG | 校验工具通过、分享卡片正确 | 扩展 Builder + 片段 |
| M4 站点级文件 | F7 robots + F8 sitemap + F9 rss | 三个端点 200 | 1 Controller + Generator |
| M5 聚合页与收录控制 | F10 聚合页直出 + F11 noindex | 聚合页可抓取、后台不被收录 | 复用列表模板 |
| M6 收录推进与数据监测 | F12 Search Console + GA4;F13 主动推送;F15 SEO 后台配置 | 有收录与流量数据 | 配置 + 片段注入 + 推送 + 后台配置项 |
| M7 广告接入(变现预习,见 5.3) | AdSense 配置项 + SSR/SPA 加载器注入 + 广告位 + ads.txt |
广告位可展示、ads.txt 可访问 |
配置项 + 片段 + SeoFileService + 模板 |
**建议顺序:**M1 → M2 → M3 → M4 完成即"能抓能收",可先提交 Search Console;M5、M6 紧随。
6.4、风险与注意事项
| 风险 | 说明 | 对策 |
|---|---|---|
| SPA 回退抢请求 | 不改 SpaForwardConfig 则 Controller 永不生效 |
M2 必做过滤器放行 |
/blog 前缀误伤接口 |
/blogs、/blog?id= 也是该前缀 |
过滤器只对 Accept: text/html 且无扩展名的导航请求放行 |
| 直出页面样式与 SPA 不一致 | 两套页面维护成本 | 一阶段样式精简,逐步统一;不做 UA 嗅探以免 cloaking |
| 首屏渲染性能 | Thymeleaf 直出正文可能变大 | 图片懒加载、静态资源缓存;P2 再优化 |
| canonical/绝对 URL 配错域名 | 多环境(local/test/prod) | 统一走 SeoUrlResolver + blog.view 配置 |
| 私密文章泄露 | 密码保护文章 | Sitemap/RSS/聚合页一律排除 password 非空文章;仍需鉴权兜底 |
dateModified 造假 |
每次刷新时间伪装更新 | 取真实 update_time |
七、总结
回到最开始那个场景——文章发布了却搜不到。经过这一轮的梳理,我们其实已经把问题拆解得很清楚了:
问题:爬虫拿到空壳
  ↓
方案:后端 Thymeleaf 直出(方案一)
  ↓
最小闭环:F1 数据补齐 → F2 详情页直出 → F3 meta → F4 canonical → F5 JSON-LD → F6 OG → F7 robots → F8 sitemap
  ↓
进阶:F9 rss → F10 聚合页 → F11 收录控制 → F12 数据监测 → F13 主动推送 → F14 性能
一句话总结:一阶段先改 SpaForwardConfig 放行、补齐 BlogDetail 字段、用 Thymeleaf 把 /blog/{id} 正文与 meta 直出,再补 robots / sitemap / rss 三个端点,最后接上 Search Console 与统计。做完这些,BlogLoom 才真正从"爬虫眼里的空壳"变成"能被收录的博客"。
至于第二阶段(性能、内链)、第三阶段(变现,本文已在 5.3 预习 Google AdSense 接入方案)、第四阶段(GEO),都建立在这一阶段的内容与流量之上,不必颠倒顺序。
参考资料
[1]. Sitemaps XML 协议(Sitemaps.org)
[2]. RFC 9309:Robots Exclusion Protocol
[3]. RFC 6596:The Canonical Link Relation
[4]. Schema.org 官方站点
[5]. JSON-LD 1.1(W3C)
[6]. RSS 2.0 Specification(RSS Advisory Board)
[7]. Google 搜索中心:针对生成式 AI 功能优化网站
[10]. CSDN 参考文章(文章页拆解对象)
[11]. BlogLoom 开源项目(GitHub)
整理者:长路 创建时间:2026.10.6 更新时间:2026.10.6
评论区请在客户端页面查看