简介如下
- Curator背景:介绍Curator的定义、起源、项目架构及与ZooKeeper的关系,使用表格展示组件构成。
- Curator的核心功能与典型应用场景:详细说明分布式锁服务、集群领导选举、分布式计数器等功能的实现原理和代码示例。
- Curator的优势与最佳实践:分析Curator相比原生ZooKeeper客户端的优势,并提供配置、连接管理和异常处理的最佳实践。
- Curator生态与未来发展:探讨Curator的社区支持、行业应用和未来可能的演进方向。
一、Curator背景
1.1 定义与概述
Curator是Netflix公司开源的一套ZooKeeper客户端框架,后来成为Apache的顶级项目。它解决了ZooKeeper原生API非常底层的细节开发工作,包括连接重连、反复注册Watcher和NodeExistsException异常处理等常见问题。
与ZooKeeper提供的原生客户端相比,Curator的抽象层次更高,简化了ZooKeeper客户端的开发量。 它提供了一套Fluent风格的操作API,并封装了ZooKeeper各种应用场景的实现,如分布式锁服务、集群领导选举、共享计数器、缓存机制、分布式队列等。
相关资源链接
- 开源地址:https://github.com/apache/curator
- 官方文档:http://curator.apache.org/
- 官方Recipes文档(包含分布式队列、TreeCache等):http://curator.apache.org/curator-recipes/
- Java API文档:http://curator.apache.org/apidocs/
1.2 发展历史与项目地位
Curator最初由Netflix开发并开源,后来转移到Apache软件基金会,目前是Apache的顶级项目。 随着ZooKeeper在分布式系统领域的广泛应用,Curator逐渐成为最流行的ZooKeeper客户端之一,被众多知名企业和项目所采用。
Curator有2.x.x和3.x.x两个主要系列版本,支持不同版本的ZooKeeper。其中Curator 2.x.x兼容ZooKeeper的3.4.x和3.5.x,而Curator 3.x.x只兼容ZooKeeper 3.5.x,并提供了一些新特性如动态重新配置、watch删除等。
1.3 项目架构与组件
Curator由一系列精心设计的模块构成,每个模块都有特定的职责:
表:Curator主要组件构成
| 组件名称 | 功能描述 |
|---|---|
| curator-client | 提供ZooKeeper client的封装,用于取代原生的ZooKeeper客户端,提供一些非常有用的客户端特性 |
| curator-framework | 提供了常见的zk相关的底层操作,简化ZooKeeper客户端编程,添加了连接管理、重试机制等 |
| curator-recipes | 提供ZooKeeper典型应用场景的实现,这些实现都是基于Curator Framework构建的 |
| curator-test | 包含TestingServer、TestingCluster和一些测试工具,用于开发和测试环境 |
| curator-x-discovery | 在framework上构建的服务发现实现 |
| curator-examples | 各种使用Curator特性的案例,供开发者参考学习 |
对于大多数开发者而言,最常用的是curator-framework和curator-recipes两个模块。 curator-framework提供了高层API简化ZooKeeper编程,而curator-recipes则提供了分布式场景中各种通用模式的实现。
1.4 与ZooKeeper的关系
Curator构建在ZooKeeper原生客户端之上,不是ZooKeeper的替代品,而是对其的增强和补充。它遵循ZooKeeper的最佳实践,并处理了各种极端情况和边缘场景,使得开发者能够更加专注于业务逻辑,而不是分布式协调的基础设施细节。
二、Curator的核心功能与典型应用场景
2.1 分布式锁服务
分布式锁是分布式系统中控制资源访问的重要机制,Curator提供了多种分布式锁的实现。
2.1.1 可重入锁(InterProcessMutex)
InterProcessMutex是Curator中最常用的分布式锁,类似于JDK的ReentrantLock,支持重入特性,意味着同一个客户端在拥有锁的同时,可以多次获取,不会被阻塞。
// 创建可重入锁
InterProcessMutex mutex = new InterProcessMutex(client, "/curator/lock");

// 获取锁
mutex.acquire();

try {
    // 执行需要同步的临界区代码
    // ...
} finally {
    // 释放锁
    mutex.release();
}
这种锁还支持超时机制,可以使用acquire(long time, TimeUnit unit)方法指定获取锁的超时时间。
2.1.2 不可重入锁(InterProcessSemaphoreMutex)
InterProcessSemaphoreMutex实现了不可重入的分布式互斥锁,与InterProcessMutex调用方法类似,但区别在于该锁是不可重入的,在同一个线程中不可重入。 这种锁适用于不需要重入的场景,通常比可重入锁具有更简单的实现和更好的性能。
2.1.3 读写锁(InterProcessReadWriteLock)
InterProcessReadWriteLock类似于JDK的ReentrantReadWriteLock,提供了分布式读写锁的实现。 一个拥有写锁的线程可重入读锁,但是读锁却不能进入写锁,这意味着写锁可以降级成读锁,但从读锁升级成写锁是不允许的。
InterProcessReadWriteLock rwLock = new InterProcessReadWriteLock(client, "/readwrite/lock");

// 获取读锁
InterProcessMutex readLock = rwLock.readLock();
// 获取写锁
InterProcessMutex writeLock = rwLock.writeLock();
2.1.4 联锁(InterProcessMultiLock)
InterProcessMultiLock是一个锁的容器,当调用acquire时,所有的锁都会被获取,如果失败,则所有锁都会被释放。 这种锁适用于需要同时获取多个资源的场景,确保原子性操作。
List<InterProcessLock> locks = new ArrayList<>();
locks.add(new InterProcessMutex(client, "/lock/lock1"));
locks.add(new InterProcessMutex(client, "/lock/lock2"));

InterProcessMultiLock multiLock = new InterProcessMultiLock(locks);
// 获取所有锁
multiLock.acquire();
2.2 集群领导选举(Leader Election)
在分布式系统中,经常需要从多个节点中选举出一个作为领导者,负责协调任务或分配工作。Curator提供了LeaderSelector组件来实现这一功能,它采用了一种竞争机制,所有参与选举的节点竞争同一个领导位置,获得锁的节点成为领导者。
当领导节点崩溃或断开连接时,其他节点会重新竞争领导位置,确保了系统的高可用性。领导选举过程是公平的,按照先来先服务的顺序分配领导权。
LeaderLatch和LeaderSelector都是为了在分布式环境中实现“领导者选举”而设计的,但它们在设计哲学和使用模式上有显著的区别。
简单来说,核心区别是:
- LeaderLatch: 一旦成为Leader,就会一直持有领导权,直到进程关闭或出现严重错误。它是一个“一劳永逸”的模型。
- LeaderSelector: 允许一个客户端在完成任务后主动放弃领导权,从而触发新一轮选举。它是一个“按需使用”的模型。
2.3 分布式计数器(Shared Counter)
Curator提供了DistributedAtomicNumber类来实现分布式计数器,支持原子性操作和高并发访问。多个客户端可以同时操作同一个计数器,而不需要担心数据一致性问题。计数器提供了递增、递减、设置值等基本操作,所有操作都保证原子性,适用于页面访问统计、资源使用计数等场景。
2.4 屏障(Barrier)和信号量(Semaphore)
分布式屏障是一种同步机制,用于等待多个节点都达到某个状态后再继续执行。Curator提供了DistributedBarrier来实现这一功能,类似于JDK中的CyclicBarrier,但是在分布式环境中工作。
分布式信号量用于控制同时访问某个资源的节点数量,Curator提供了InterProcessSemaphoreV2来实现这一功能,可以用于限流、资源池管理等场景。
2.5 分布式队列
Curator提供了多种分布式队列的实现,包括:
- DistributedQueue:普通分布式队列
- DistributedIdQueue:带ID的分布式队列
- DistributedPriorityQueue:分布式优先级队列
- DistributedDelayQueue:分布式延迟队列
这些队列可以在不同的节点之间共享数据,实现任务的分布式处理和数据传递。
三、Curator的优势与最佳实践
3.1 相比原生ZooKeeper客户端的优势
3.1.1 简化的API设计
Curator提供了Fluent风格的API,大大简化了ZooKeeper客户端的编程难度。 相比于ZooKeeper原生的回调式API,Curator的API更加直观和易于理解。
// 使用Curator创建节点
client.create()
      .creatingParentsIfNeeded()
      .withMode(CreateMode.PERSISTENT)
      .forPath("/path/to/node", "data".getBytes());
3.1.2 连接管理自动化
Curator自动处理连接重连和会话过期等复杂情况,不需要开发者手动处理。 当ZooKeeper服务器连接丢失时,Curator会自动在后台尝试重新连接,并在连接恢复后重建临时节点和监听器。
3.1.3 重试机制
Curator提供了灵活且可配置的重试策略,包括:
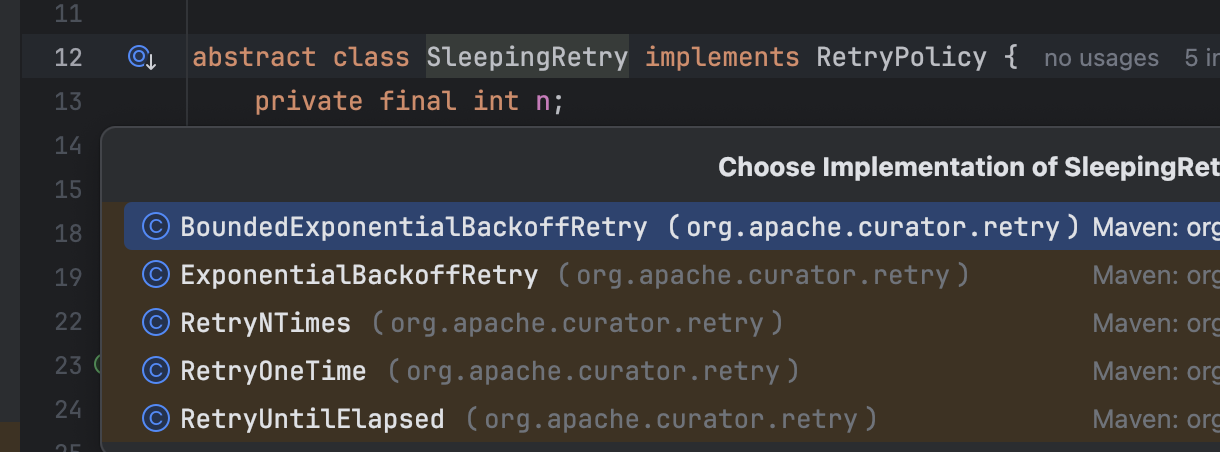
- ExponentialBackoffRetry:指数退避重试策略
- RetryNTimes:指定最大重试次数的策略
- RetryForever:永远重试直到成功的策略
- RetryUntilElapsed:在指定时间范围内重试的策略
// 配置重试策略
RetryPolicy retryPolicy = new ExponentialBackoffRetry(1000, 3);
CuratorFramework client = CuratorFrameworkFactory.newClient("127.0.0.1:2181", retryPolicy);
3.1.4 遵循最佳实践的实现
Curator的各种应用场景实现(recipes)都遵循了ZooKeeper的最佳实践,并考虑了各种极端情况。 这意味着开发者可以直接使用这些经过验证的实现,而不需要自己从头实现并处理各种边界情况。
3.2 性能特点与局限性
3.2.1 性能表现
Curator在性能上做了大量优化:
- 连接池管理:有效管理ZooKeeper连接,减少资源消耗
- 缓存机制:对节点数据和状态进行缓存,减少网络请求
- 批量操作:支持批量创建、删除等操作,提高操作效率
- 异步处理:提供异步API,避免阻塞主线程
3.2.2 局限性
- 依赖ZooKeeper:Curator强依赖于ZooKeeper,不能独立使用
- 学习成本:虽然比原生API简单,但仍然需要学习Curator的概念和API
- 版本兼容性:需要仔细选择与ZooKeeper版本兼容的Curator版本
3.3 部署与配置最佳实践
3.3.1 客户端配置
正确的配置是保证Curator稳定运行的基础,以下是一个推荐的配置示例:
RetryPolicy retryPolicy = new ExponentialBackoffRetry(1000, 3);

CuratorFramework client = CuratorFrameworkFactory.builder()
                .connectString("192.168.107.135:2181")
                .retryPolicy(retryPolicy)
                .sessionTimeoutMs(60000) // 会话超时时间
                .connectionTimeoutMs(15000) // 连接超时时间
                .namespace("myapp") // 命名空间,所有操作都会在该路径下进行
                .build();
client.start();
3.3.2 连接管理最佳实践
- 共享客户端实例:在应用程序中共享同一个Curator客户端实例,避免创建多个连接
- 正确关闭连接:在应用程序关闭时正确调用
close()方法释放资源 - 监控连接状态:通过ConnectionStateListener监控连接状态变化,做出相应处理
3.3.3 异常处理
Curator中的异常主要分为两种类型:
- 可恢复异常:如连接丢失、会话过期等,Curator会自动处理
- 不可恢复异常:如节点不存在、无权限访问等,需要开发者手动处理
try {
    InterProcessMutex lock = new InterProcessMutex(client, "/resource/lock");
    if (lock.acquire(1000, TimeUnit.MILLISECONDS)) {
        try {
            // 访问共享资源
        } finally {
            lock.release();
        }
    }
} catch (Exception e) {
    // 处理异常
    logger.error("获取分布式锁失败", e);
}
四、Curator生态与未来发展
4.1 社区支持与活跃度
作为Apache的顶级项目,Curator拥有活跃的开源社区和持续的开发维护。 开发者可以通过多种渠道获取支持和参与社区:
- GitHub仓库:提交issue和pull request
- 邮件列表:参与技术讨论和获取帮助
- 官方文档:查阅详细的API文档和使用指南
4.2 行业应用与典型案例
Curator被众多知名公司和技术项目所采用,特别是在微服务架构和分布式系统中:
- Netflix:作为最初的开源方,Netflix在其大规模的微服务架构中广泛使用Curator
- 阿里巴巴:在其分布式中间件和微服务组件中使用了Curator
- Apache项目:多个Apache项目如Dubbo、ShardingSphere等使用Curator作为ZooKeeper客户端
4.3 与其他分布式协调技术的对比
虽然ZooKeeper+Curator是流行的分布式协调解决方案,但也存在其他替代技术:
4.3.1 与etcd+jetcd的对比
etcd是CoreOS团队发起的开源项目,采用Raft协议而不是ZAB协议,提供了类似于ZooKeeper的分布式键值存储功能。etcd的客户端jetcd提供了类似Curator的功能,但在API设计和特性支持上有所不同。
4.3.2 与Consul的对比
Consul提供了服务发现、配置管理等功能,内置了类似ZooKeeper的分布式协调能力。Consul有自己的客户端库,不需要额外的封装层。
4.4 未来发展趋势
随着云原生和微服务架构的普及,分布式协调技术继续发挥着重要作用。Curator未来的发展方向可能包括:
- 对ZooKeeper新特性的支持:随着ZooKeeper本身的演进,Curator需要及时适配新特性
- 云原生适配:更好地适应容器化和云原生环境
- 性能优化:持续优化性能,降低资源消耗
- 新分布式模式:增加更多分布式系统常用模式的实现
五、总结
Curator作为ZooKeeper的高级客户端库,极大地简化了分布式协调服务的开发难度,提供了可靠、高效、易用的分布式系统基础组件。
通过封装ZooKeeper底层的复杂细节,提供丰富的分布式应用场景实现,Curator让开发者能够专注于业务逻辑,而不需要深入理解ZooKeeper的内部工作机制。其流畅的API设计、完善的重试机制和连接管理,以及经过实践检验的各种分布式模式实现,使得它成为构建分布式系统的重要工具。
虽然近年来出现了其他分布式协调技术,但ZooKeeper+Curator的组合仍然因其成熟度、稳定性和丰富功能而在众多企业和项目中广泛应用。对于需要构建可靠、高可用分布式系统的开发者来说,掌握Curator技术栈仍然是非常有价值的技能。
参考文章
[1]. Kurator: https://openatom.cn/project/8uvqv1exdme0
[2]. Curator中的分布式锁解读-腾讯云开发者社区-腾讯云: https://cloud.tencent.cn/developer/article/2341493?from=15425
[3]. Zookeeper开源客户端Curator之基本功能讲解-腾讯云开发者社区-腾讯云: https://cloud.tencent.com.cn/developer/article/1015374?from=15425
[4]. 干货 | Elasticsearch索引管理利器——Curator深入详解-腾讯云开发者社区-腾讯云: https://cloud.tencent.com.cn/developer/article/1382110?from=15425
[5]. Curator中的分布式锁解读: https://bbs.huaweicloud.com/blogs/399441
[6]. Kurator v0.5.0正式发布! 打造统一的多集群备份与存储体验: https://www.huaweicloud.com/s/JW5hdOWFrOe9keWcsOWdgOaAjuS5iOi9rOaNouaIkOengee9keWcsOWdgCU/t_60_p_987
[7]. 从保管到创造:由Curator词义的演变论其内涵和角色: http://bianke.cnki.net.https.gzlib.proxy.chaoxing.com/Web/Article/WBXK202303007.html
[8]. 分布式云原生平台Kurator v0.2.0正式发布!一键构建分布式云原生平台: https://bbs.huaweicloud.com/blogs/391855
评论区请在客户端页面查看