- 前言
- 一、认识LangChain4j
- 1.1、历史背景
- 1.2、主要功能
- 1.3、场景
- 二、SpringBoot接入大模型
- 2.1、项目基本配置 & pom引入依赖
- 2.2、接入大模型
- 2.2.1、LangChain4j 库结构
- 2.2.2、引入LangChain4j相关依赖
- 2.2.3、补充LangChain4j单测来验证与gpt交互
- 2.3、整合langchain4j-springboot-starter
- 2.3.1、替换补充langchain的starter依赖
- 2.3.2、application.properties补充大模型配置
- 2.3.3、补充启动器单测
- 三、接入其他大模型
- 3.1、认识市面上大模型
- 3.2、接入Deepseek
- 3.2.1、获取开发参数
- 3.2.2、配置开发参数
- 3.2.3、application.properties配置模型参数
- 3.3、ollama本地部署
- 3.3.1、认识ollama
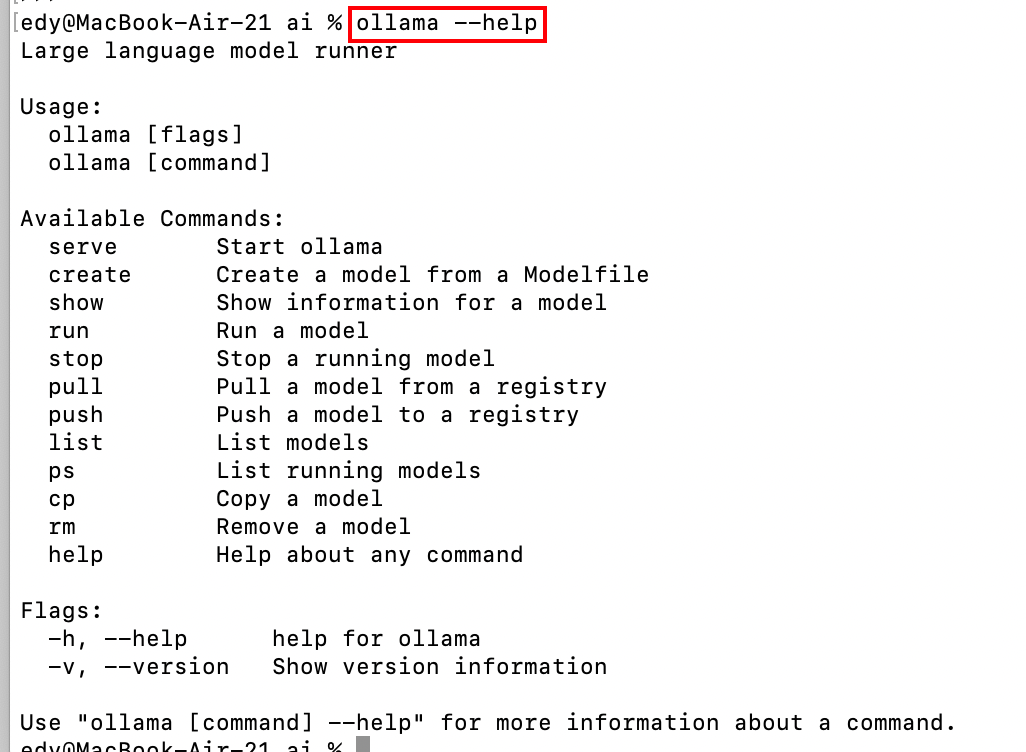
- 3.3.2、常用命令介绍
- 3.3.3、SpringBoot快速集成ollama
- 1)引入pom.xml
- 2)配置模型参数
- 3)补充测试用例
- 3.4、接入阿里百炼平台
- 3.4.1、认识阿里百炼平台
- 3.4.2、配置百炼开发参数
- 3.4.3、SpringBoot快速集成百炼
- 1)引入pom.xml依赖
- 2)配置模型参数
- 3)补充测试用例
- 3.4.4、实战案例集成:通义万象
- 3.4.5、实战案例集成:百炼deepseek
- 四、人工智能AiService
- 4.1、认识AiService
- 4.2、创建AiService服务
- 4.2.1、引入pom依赖
- 4.2.2、实现Assistant接口(aiservice)
- 4.2.3、aiservice实例化测试验证
- 方式一:代码方式手动实例化aiservice并指定ai大模型验证
- 方式二:spring依赖注入aiservice服务
- 4.2.4、工作原理介绍
- 4.3、聊天记忆 chat memory
- 4.3.1、测试验证普通chat对话是否有记忆
- 4.3.2、聊天记忆的核心原理简单实现(实现记忆效果)
- 4.3.3、基于ChatMemory实现聊天记忆
- 4.3.4、AiService注解模式实现ChatMemory增强
- 4.3.4.1、创建记忆对话智能体MemoryChatAssistant
- 4.3.4.2、配置ChatMemory
- 4.3.4.3、测试验证
- 4.4、隔离聊天记录
- 4.4.1、创建记忆隔离对话智能体
- 4.4.2、配置ChatMemoryProvider
- 4.4.3、测试验证用户隔离对话
- 4.5、持久化聊天记忆
- 4.5.1、存储介质选择
- 4.5.2、选择MongoDB
- 4.5.2.1、认识MongoDB
- 4.5.2.2、快速安装MongoDB
- 4.5.3、快速整合SpringBoot-mongo
- 4.5.4、持久化聊天核心实现
- 4.5.4.1、自定义持久化ChatMemoryStore
- 4.5.4.2、SeparateChatAssistantConfig注入持久化消息存储对象
- 4.6、提示词Prompt
- 4.6.1、系统提示词
- 4.6.1.1、配置@SystemMessage
- 4.6.1.2、测试系统参数
- 4.6.1.3、从资源中加载系统提示词模板 fromTemplate
- 4.6.2、用户提示词
- 4.6.2.1、两种方式配置用户提示词
- 4.6.2.2、测试用户提示词+系统提示词
- 4.7、Function Calling函数调用
- 4.7.1、入门案例
- 4.7.1.1、创建tools计算器工具类
- 4.7.1.2、配置工具类
- 4.7.1.3、测试验证function calling
- Function calling函数调用原理探究
- 4.7.2、@Tool 注解的可选字段
- 4.7.3、@P注解
- 4.7.4、@ToolMemoryId(支持在tool中去使用memoryId)
- 五、检索增强生成RAG
- 5.1、如何让大模型回答专业领域的知识
- 5.1.1、微调大模型
- 5.1.2、RAG
- 5.1.3、RAG常用方法
- 5.2、向量搜索vector search
- 5.2.1、向量Vectors
- 5.2.2、维度Dimensions
- 5.2.3、相似度Similarity
- 5.2.4、相似度测量Measures of similarity
- 5.3、RAG过程
- 5.3.1、索引阶段
- 5.3.2、检索阶段
- 5.4、文档加载器Document Loader
- 5.4.1、常见文档加载器Loader
- 5.4.2、测试文档加载器
- 5.5、文档解析器Parser
- 5.5.1、常见文档解析器
- 5.5.2、本地测试文档解析器
- 5.6、文档分割器 Document Splitter
- 5.6.1、常见文档分割器
- 5.6.2、测试向量转换和向量存储
- 5.6.3、测试文档分割
- 5.6.4、token和token计算
- 5.6.5、工作方式
- 六、向量模型和向量存储
- 6.1、向量大模型
- 6.1.1、介绍
- 6.1.2、模型配置
- 6.1.3、文本向量化测试验证
- 6.2、向量化存储
- 6.2.1、Pinecone简介
- 6.2.2、Pinecone的使用
- 6.2.3、Pinecone账号注册与配置
- 6.2.4、集成Pinecone
- 6.2.4.1、pom引入Pinecone依赖
- 6.2.4.2、配置环境变量
- 6.2.4.3、配置向量存储对象EmbeddingStore
- 6.2.4.4、测试向量存储
- 6.2.4.5、测试向量相似度匹配
- 资料获取
博客摘要:LangChain4j致力于简化大语言模型与Java应用的集成,支持多种大模型,助力构建智能应用。
文章标签:LangChain4j、Java集成、大语言模型
博客展示首图描述:LangChain4j助力Java集成大模型,实现智能应用开发,探索高效集成方案。
精炼核心简介:LangChain4j简化大语言模型与Java集成,支持多种大模型,提供便捷API,助力智能应用开发。
前言
博主介绍:✌目前全网粉丝3W+,csdn博客专家、Java领域优质创作者,博客之星、阿里云平台优质作者、专注于Java后端技术领域。
涵盖技术内容:Java后端、大数据、算法、分布式微服务、中间件、前端、运维等。
博主所有博客文件目录索引:博客目录索引(持续更新)
CSDN搜索:长路
视频平台:b站-Coder长路
一、认识LangChain4j
简介:LangChain4j 的目标是简化将大语言模型(LLM - Large Language Model)集成到 Java 应用程序中的过程。
适用jdk版本:
- 0.35.0:最后适用jdk8
- 其他:后续升级到jdk17。
1.1、历史背景
官网: https://docs.langchain4j.dev
2022 年11月30日OpenAI发布了Chat GPT(GPT-3.5)
- 早在 2022 年10月,Harrison Chase 发布了基于Python的LangChain。
- 随后同时包含了Python版和JavaScript(LangChain.js)版的LangChain 也发布了。
2023 年 11 月,Quarkus 发布了 LangChain4j 的 0.1 版本,2025 年 2 月发布了 1.0 - Beta1 版本,4 月发布了1.0 - Beta3 版本。
1.2、主要功能
与大型语言模型和向量数据库的便捷交互
- 通过统一的应用程序编程接口(API),可以轻松访问所有主要的商业和开源大型语言模型以及向量数据库,使你能够构建聊天机器人、智能助手等应用。
专为 Java 打造
- 借助Spring Boot 集成,能够将大模型集成到ava 应用程序中。大型语言模型与 Java 之间实现了双向集成:你可以从 Java 中调用大型语言模型,同时也允许大型语言模型反过来调用你的 Java 代码
智能代理、工具、检索增强生成(RAG)
- 为常见的大语言模型操作提供了广泛的工具,涵盖从底层的提示词模板创建、聊天记忆管理和输出解析,到智能代理和检索增强生成等高级模式。
1.3、场景
**场景1、**你想要实现一个自定义的由人工智能驱动的聊天机器人,它可以访问你的数据,并按照你期望的方式运行:
-
客户支持聊天机器人,它可以:礼貌地回答客户问题。
-
处理 / 更改 / 取消订单。
-
教育助手,它可以:教授各种学科。
-
解释不清楚的部分:评估用户的理解 / 知识水平。
**场景2:**你想要处理大量的非结构化数据(文件、网页等),并从中提取结构化信息。例如:
- 从客户评价和支持聊天记录中提取有效评价。
- 从竞争对手的网站上提取有趣的信息。
- 从求职者的简历中提取有效信息。
场景3:你想要生成信息,例如:
- 为你的每个客户量身定制的电子邮件。
- 为你的应用程序 / 网站生成内容:
- 博客文章
- 故事
场景4:你想要转换信息,例如:
- 总结
- 校对和改写
- 翻译
二、SpringBoot接入大模型
2.1、项目基本配置 & pom引入依赖
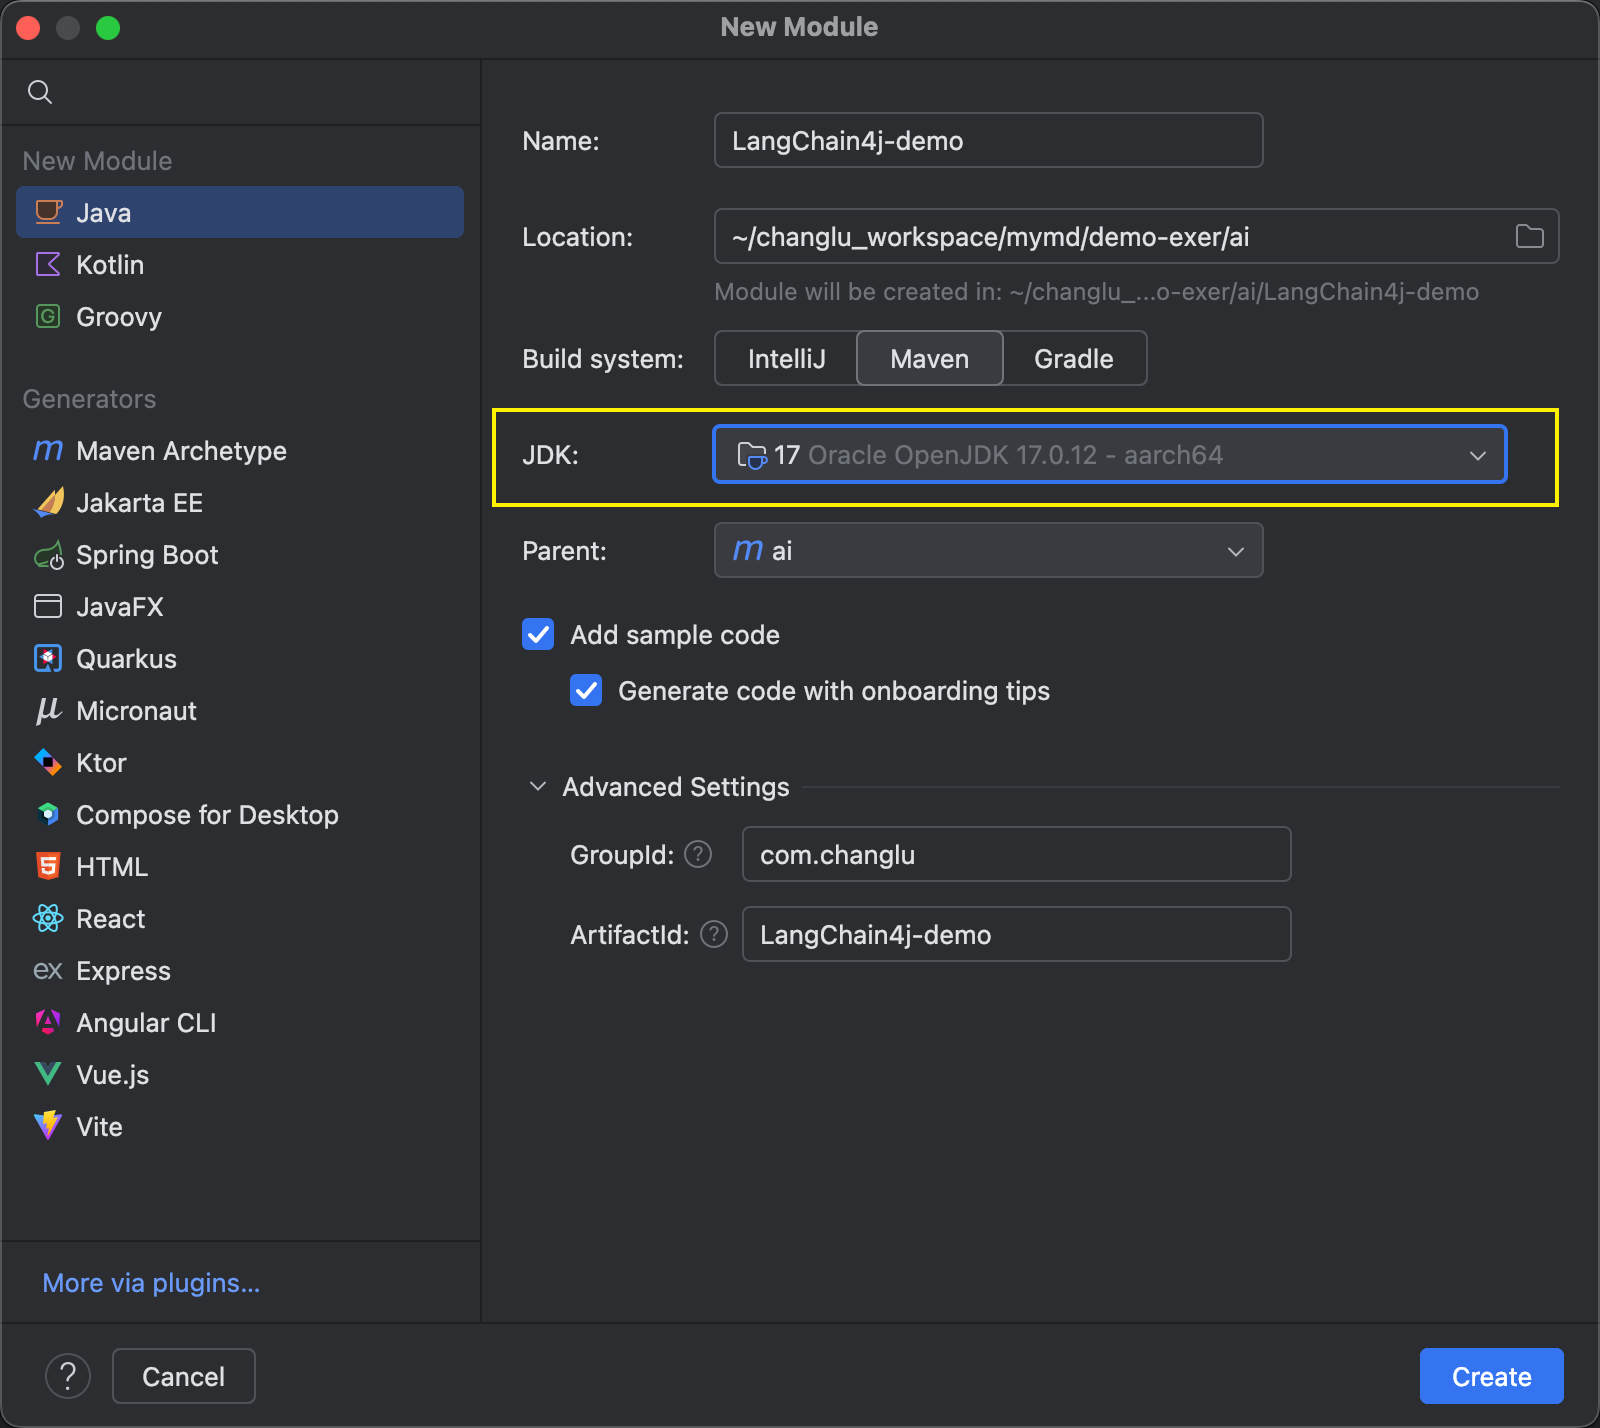
创建maven项目,选择jdk17:
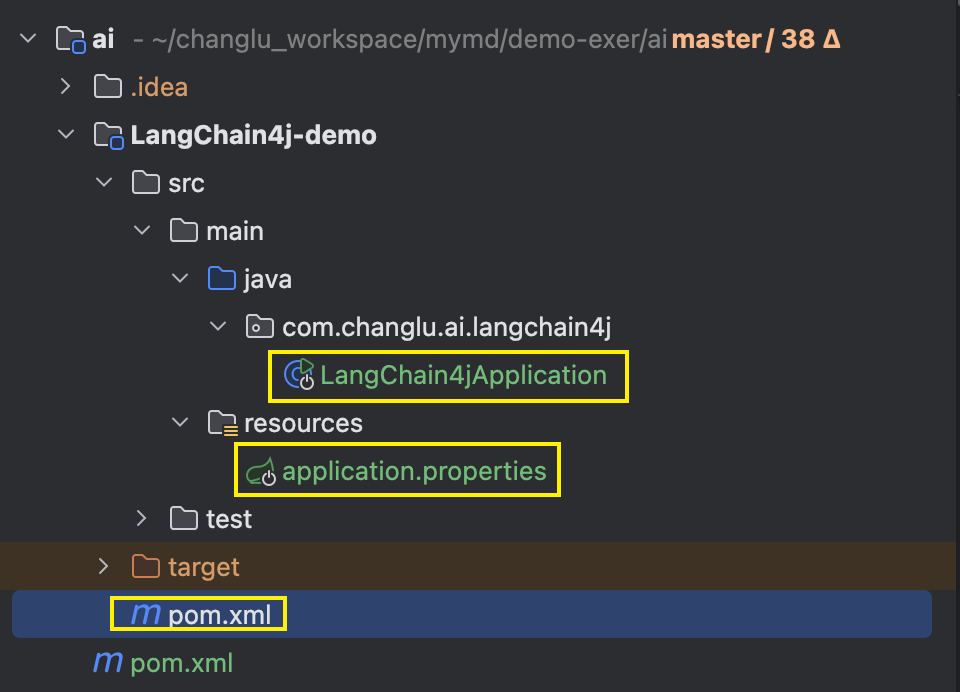
pom.xml:引入依赖与版本管理
<properties>
    <maven.compiler.source>17</maven.compiler.source>
    <maven.compiler.target>17</maven.compiler.target>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    <spring-boot.version>3.2.6</spring-boot.version>
    <knife4j.version>4.3.0</knife4j.version>
    <langchain4j.version>1.0.0-beta3</langchain4j.version>
    <mybatis-plus.version>3.5.11</mybatis-plus.version>
</properties>

<dependencies>
    <!-- web应用程序核心依赖 -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-web</artifactId>
    </dependency>
    <!-- 编写和运行测试用例 -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-test</artifactId>
        <scope>test</scope>
    </dependency>
    <!-- 前后端分离中的后端接口测试工具 -->
    <dependency>
        <groupId>com.github.xiaoymin</groupId>
        <artifactId>knife4j-openapi3-jakarta-spring-boot-starter</artifactId>
        <version>${knife4j.version}</version>
    </dependency>
</dependencies>

<dependencyManagement>
    <dependencies>
        <!--引入SpringBoot依赖管理清单-->
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-dependencies</artifactId>
            <version>${spring-boot.version}</version>
            <type>pom</type>
            <scope>import</scope>
        </dependency>
    </dependencies>
</dependencyManagement>
LangChain4jApplication.java:补充SpringBoot启动器
@SpringBootApplication
public class LangChain4jApplication {

    public static void main(String[] args) {
        SpringApplication.run(LangChain4jApplication.class, args);
    }

}
application.properties:
# web服务访问端口
server.port=8080
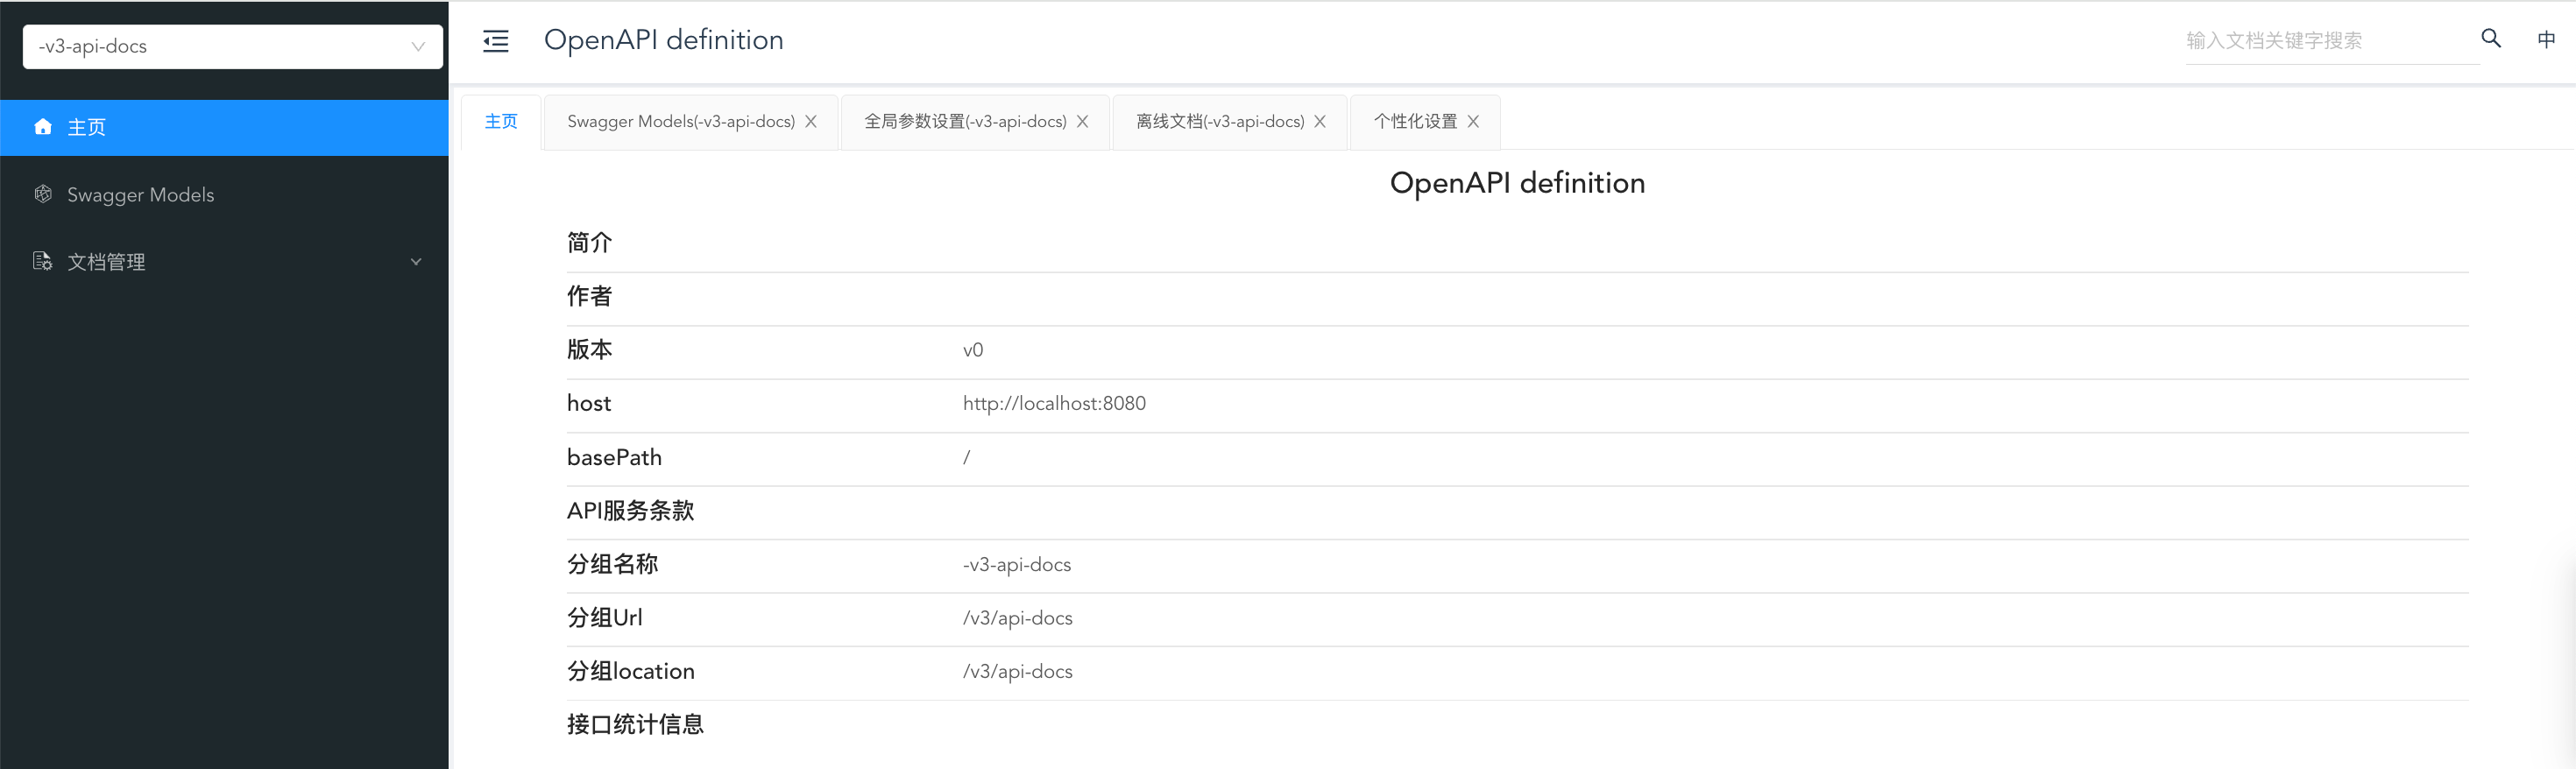
启动服务访问网站:http://localhost:8080/doc.html#/home,验证下
2.2、接入大模型
参考文档: Get Started https://docs.langchain4j.dev/get-started
2.2.1、LangChain4j 库结构
LangChain4j 具有模块化设计,包括:
-
langchain4j-core 模块,它定义了核心抽象概念(如聊天语言模型和嵌入存储)及其 API。
-
主 langchain4j 模块,包含有用的工具,如文档加载器、聊天记忆实现,以及诸如人工智能服务等高层功能。
-
大量的 langchain4j-{集成} 模块,每个模块都将各种大语言模型提供商和嵌入存储集成到
LangChain4j 中。你可以独立使用 langchain4j-{集成} 模块。如需更多功能,只需导入主 langchain4j依赖项即可。
2.2.2、引入LangChain4j相关依赖
pom.xml中再次引入LangChain4j相关依赖:
<properties>
	<langchain4j.version>1.0.0-beta3</langchain4j.version>
</properties>

<dependencies>
  <!-- 基于open-ai的langchain4j接口:ChatGPT、deepseek都是open-ai标准下的大模型 -->
  <dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-open-ai</artifactId>
  </dependency>
</dependencies>

<dependencyManagement>
    <dependencies>
      <!--引入langchain4j依赖管理清单-->
      <dependency>
        <groupId>dev.langchain4j</groupId>
        <artifactId>langchain4j-bom</artifactId>
        <version>${langchain4j.version}</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>
2.2.3、补充LangChain4j单测来验证与gpt交互
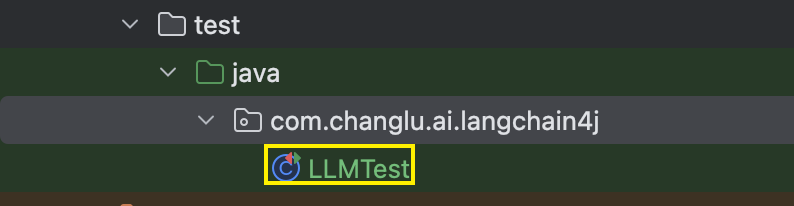
package com.changlu.ai.langchain4j;

import dev.langchain4j.model.openai.OpenAiChatModel;
import org.junit.jupiter.api.Test;
import org.springframework.boot.test.context.SpringBootTest;

/**
 * @description  start chat with openai gpt
 * @author changlu
 * @date 2025/5/18 02:25
 */
@SpringBootTest
public class LLMTest {

    @Test
    public void testGPTDemo() {
        // 初始化模型
        OpenAiChatModel model = OpenAiChatModel.builder()
                .baseUrl("http://langchain4j.dev/demo/openai/v1") //设置模型api地址(如果apiKey="demo",则可省略baseUrl的配置),新版本不能忽视
                .apiKey("demo")  //设置模型apiKey
                .modelName("gpt-4o-mini") //设置模型名称
                .build();

        // 回答的结果
        String answer = model.chat("你好");

        System.out.println(answer);
    }

}
运行下单测,结果如下:
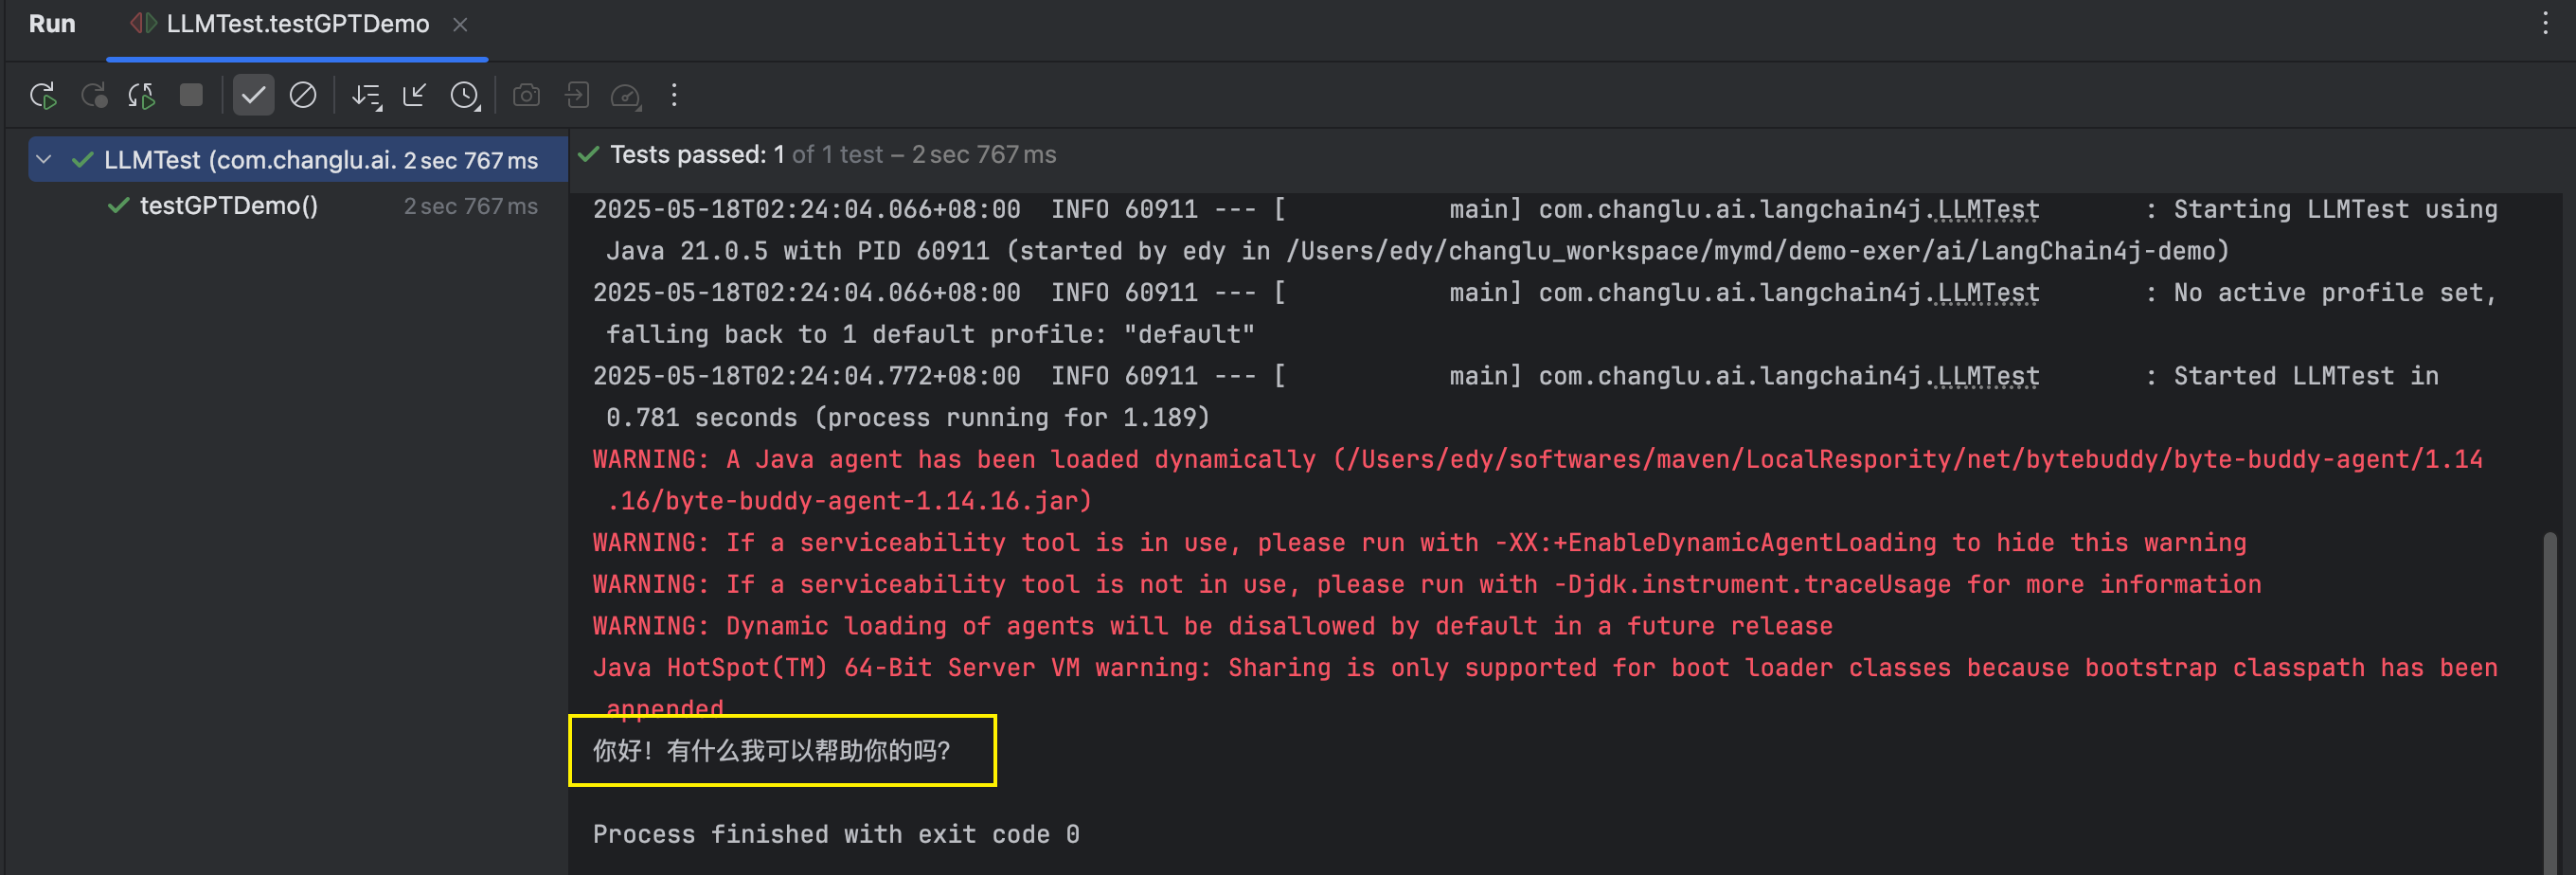
2.3、整合langchain4j-springboot-starter
2.2我们只是去初步尝试与gpt进行交互,这里我们直接引入springboot-starter来完成langchain4j的集成。
2.3.1、替换补充langchain的starter依赖
pom.xml补充:
<!-- 基于open-ai的langchain4j接口:ChatGPT、deepseek都是open-ai标准下的大模型 -->
<!--        <dependency>-->
<!--            <groupId>dev.langchain4j</groupId>-->
<!--            <artifactId>langchain4j-open-ai</artifactId>-->
<!--        </dependency>-->
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-open-ai-spring-boot-starter</artifactId>
</dependency>
2.3.2、application.properties补充大模型配置
application.properties配置文件新增内容如下:
#langchain4j测试模型
langchain4j.open-ai.chat-model.base-url=http://langchain4j.dev/demo/openai/v1
langchain4j.open-ai.chat-model.api-key=demo
langchain4j.open-ai.chat-model.model-name=gpt-4o-mini
#请求和响应日志
langchain4j.open-ai.chat-model.log-requests=true
langchain4j.open-ai.chat-model.log-responses=true
#启用日志debug级别
logging.level.root=debug
2.3.3、补充启动器单测
import dev.langchain4j.model.openai.OpenAiChatModel;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

@SpringBootTest
public class LLMSpringBootTest {

    /**
     * 整合SpringBoot,读取配置文件配置
     */
    @Autowired
    private OpenAiChatModel openAiChatModel;

    @Test
    public void testSpringBoot() {
        //向模型提问
        String answer = openAiChatModel.chat("你好,请问你是什么大模型");
        //输出结果
        System.out.println(answer);
    }

}
运行测试:
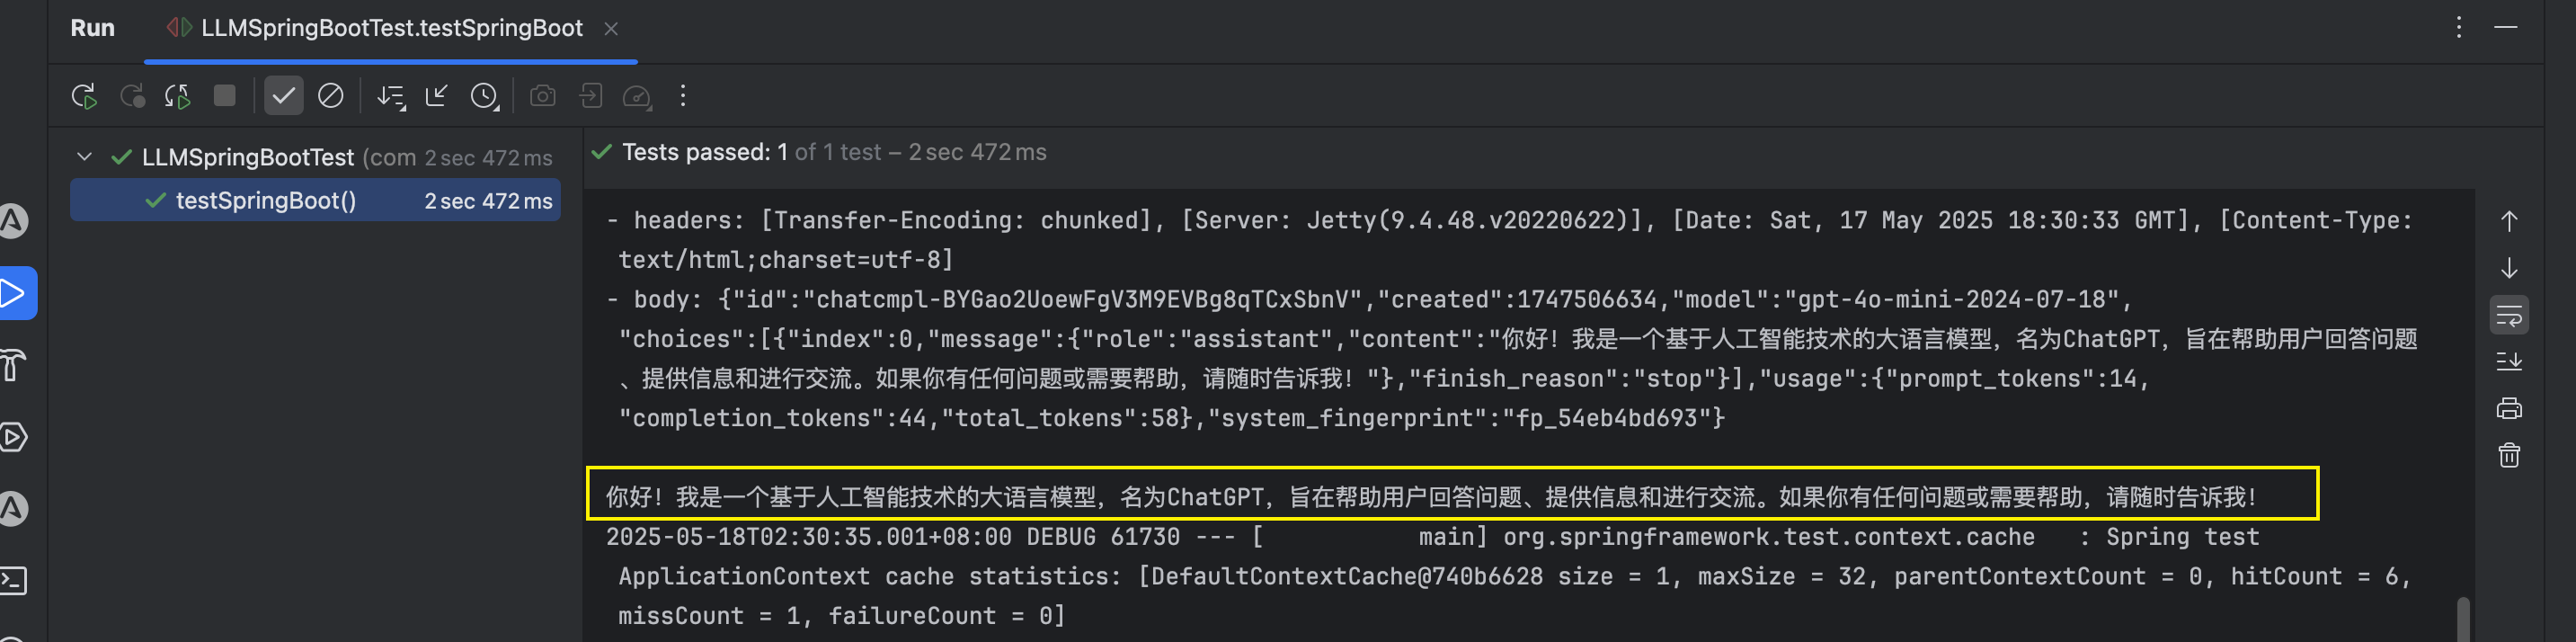
三、接入其他大模型
3.1、认识市面上大模型
大语言模型排行榜: https://superclueai.com/,可查看目前市面上ai最新表单
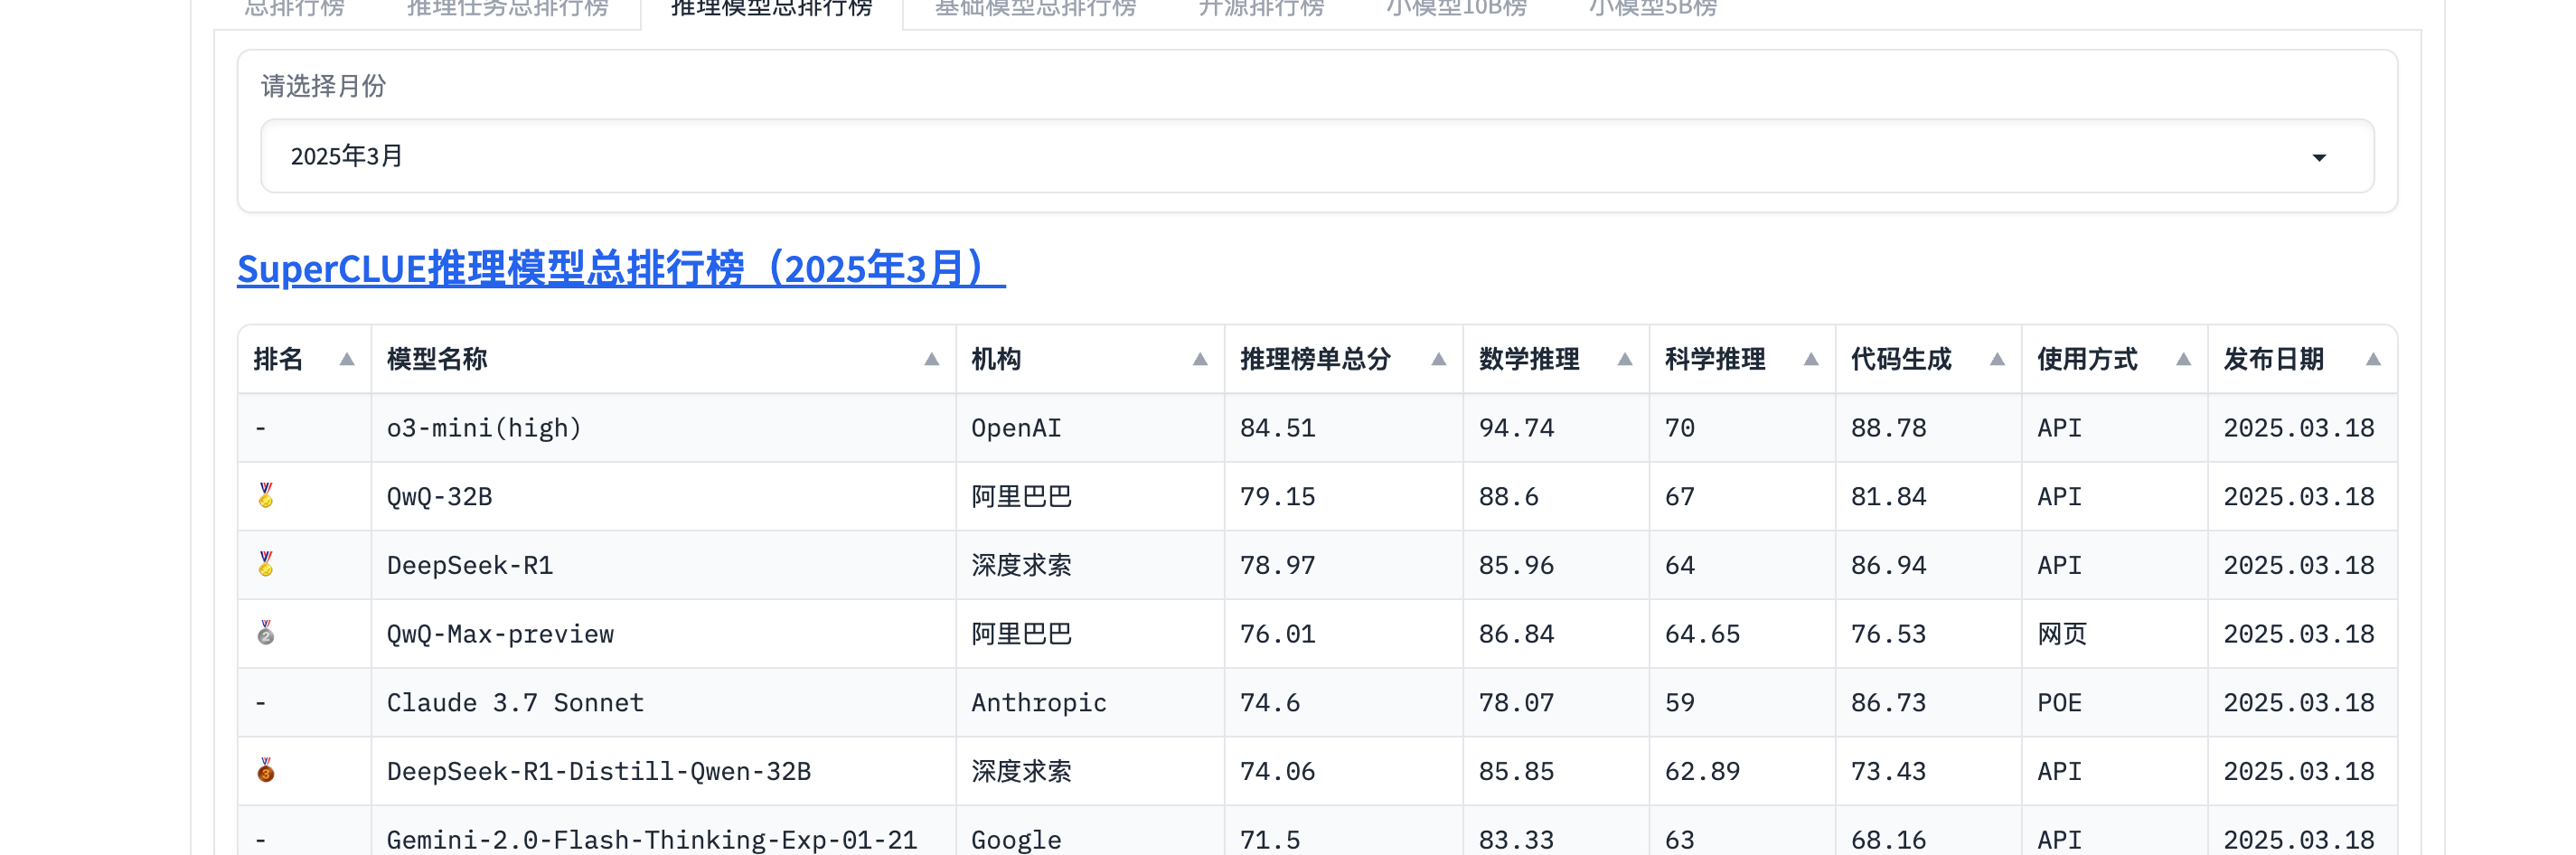
SuperCLUE 是由国内 CLUE 学术社区于 2023 年 5 月推出的中文通用大模型综合性评测基准。
-
评测目的:全面评估中文大模型在语义理解、逻辑推理、代码生成等 10 项基础能力,以及涵盖数学、物理、社科等 50 多学科的专业能力,旨在回答在通用大模型发展背景下,中文大模型的效果情况,包括不同任务效果、与国际代表性模型的差距、与人类的效果对比等问题。
-
特色优势:针对中文特性任务,如成语、诗歌、字形等设立专项评测,使评测更符合中文语言特点。通过 3700 多道客观题和匿名对战机制,动态追踪国内外主流模型,如 GPT-4、文心一言、通义千问等的表现差异,保证评测的客观性和时效性。
-
行业影响:作为中文领域权威测评社区,其评测结果被学界和产业界广泛引用,例如商汤 “日日新5.0” 和百度文心大模型均通过 SuperCLUE 验证技术突破,推动了中文 NLP 技术生态的迭代,为中文大模型的发展和优化提供了重要的参考依据,促进了中文大模型技术的不断进步和应用。
LangChain4j支持接入的大模型:https://docs.langchain4j.dev/integrations/language-models/
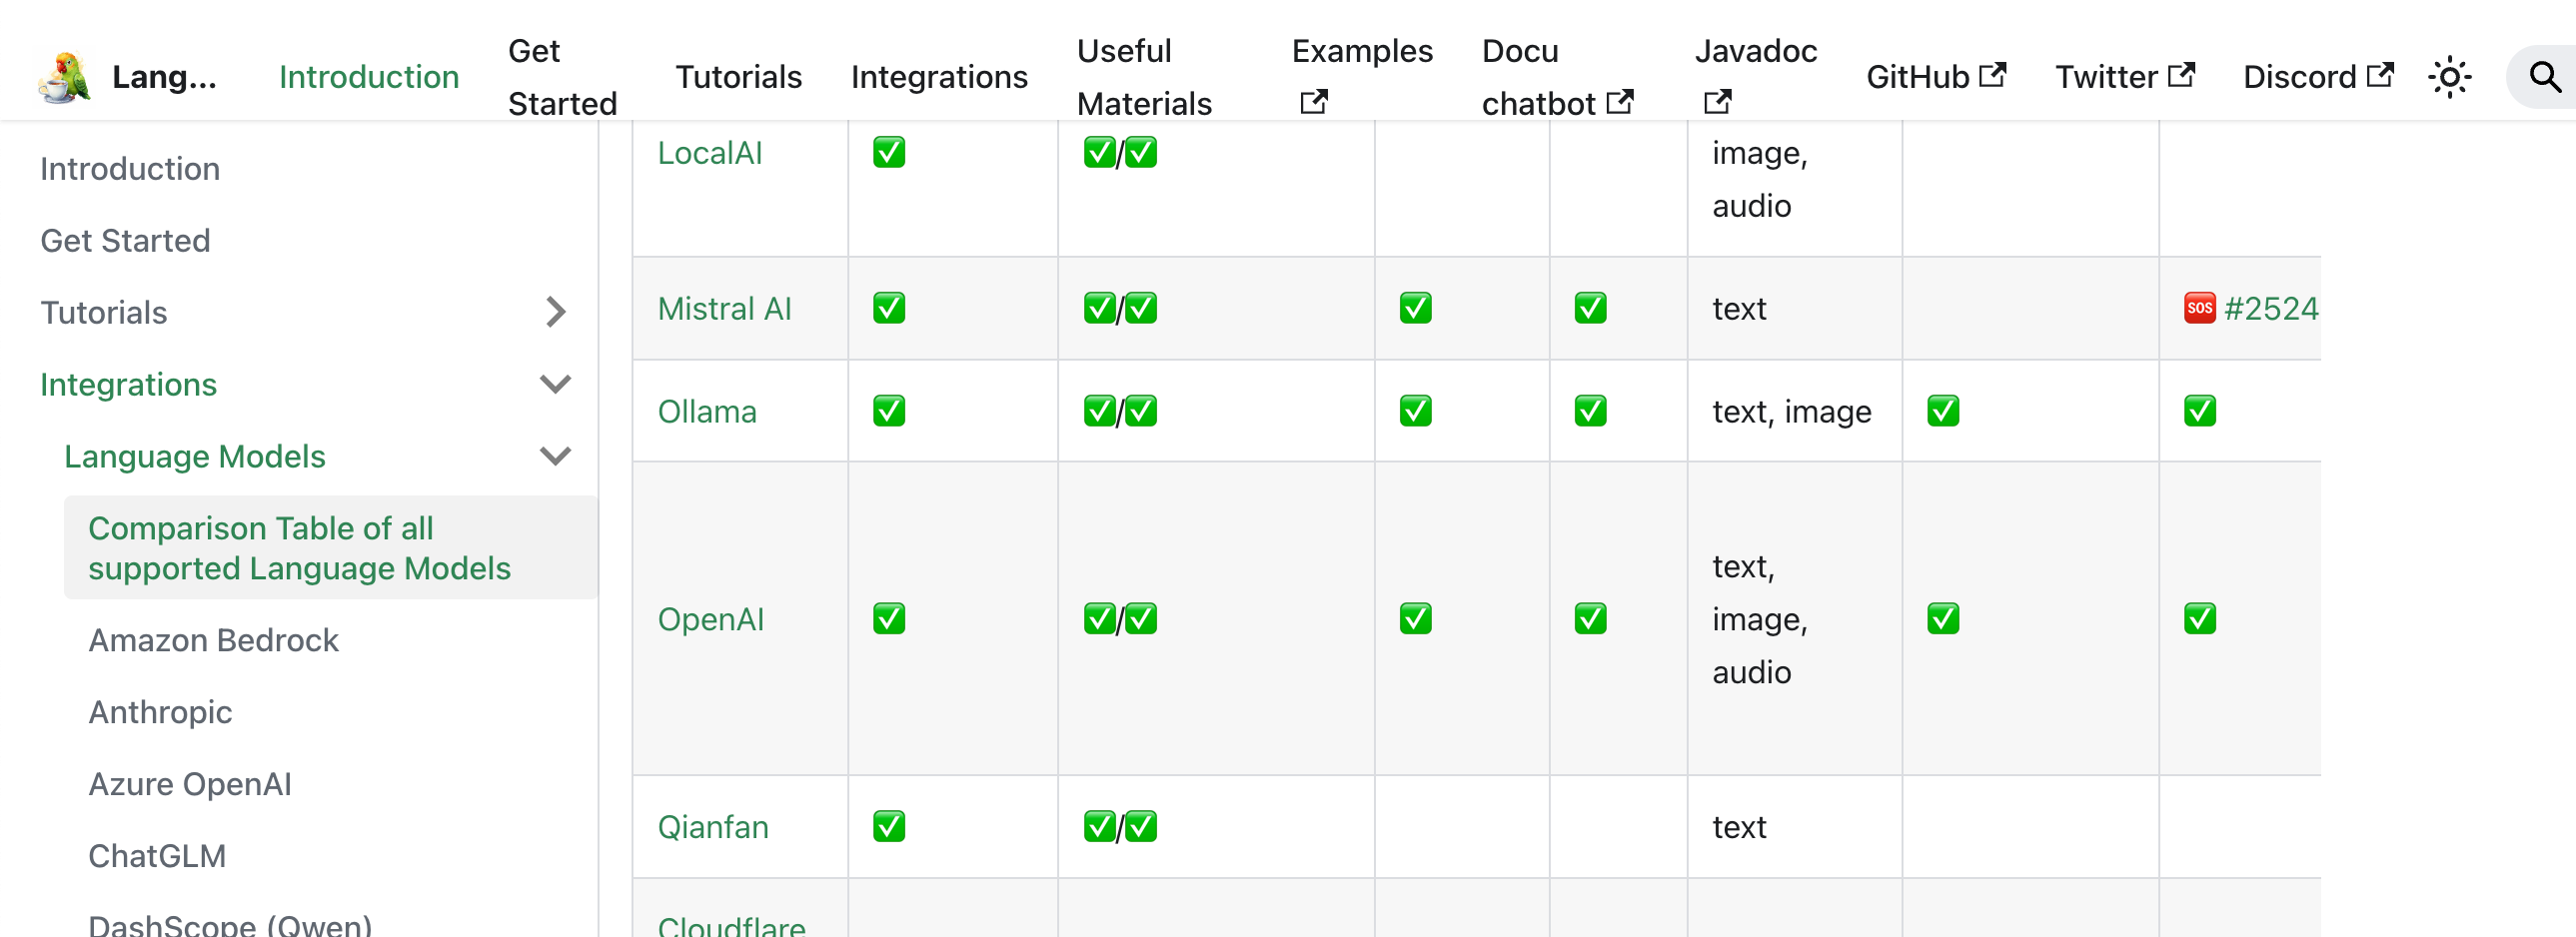
- deepseek是遵循openai规范,这里如果支持openai,也就是支持deepseek。
3.2、接入Deepseek
3.2.1、获取开发参数
访问官网: https://www.deepseek.com/ 注册账号
进入开放平台:https://platform.deepseek.com/usage,获取base_url和api_key
3.2.2、配置开发参数
为了apikay的安全,建议将其配置在服务器的环境变量中。变量名自定义即可,例如:
DEEP_SEEK_API_KEY
mac配置环境变量如下:
vim ~/.zshrc

# 配置内容
export DEEP_SEEK_API_KEY="xxxxxxxxx"

# 生效配置文件
source ~/.zshrc
3.2.3、application.properties配置模型参数
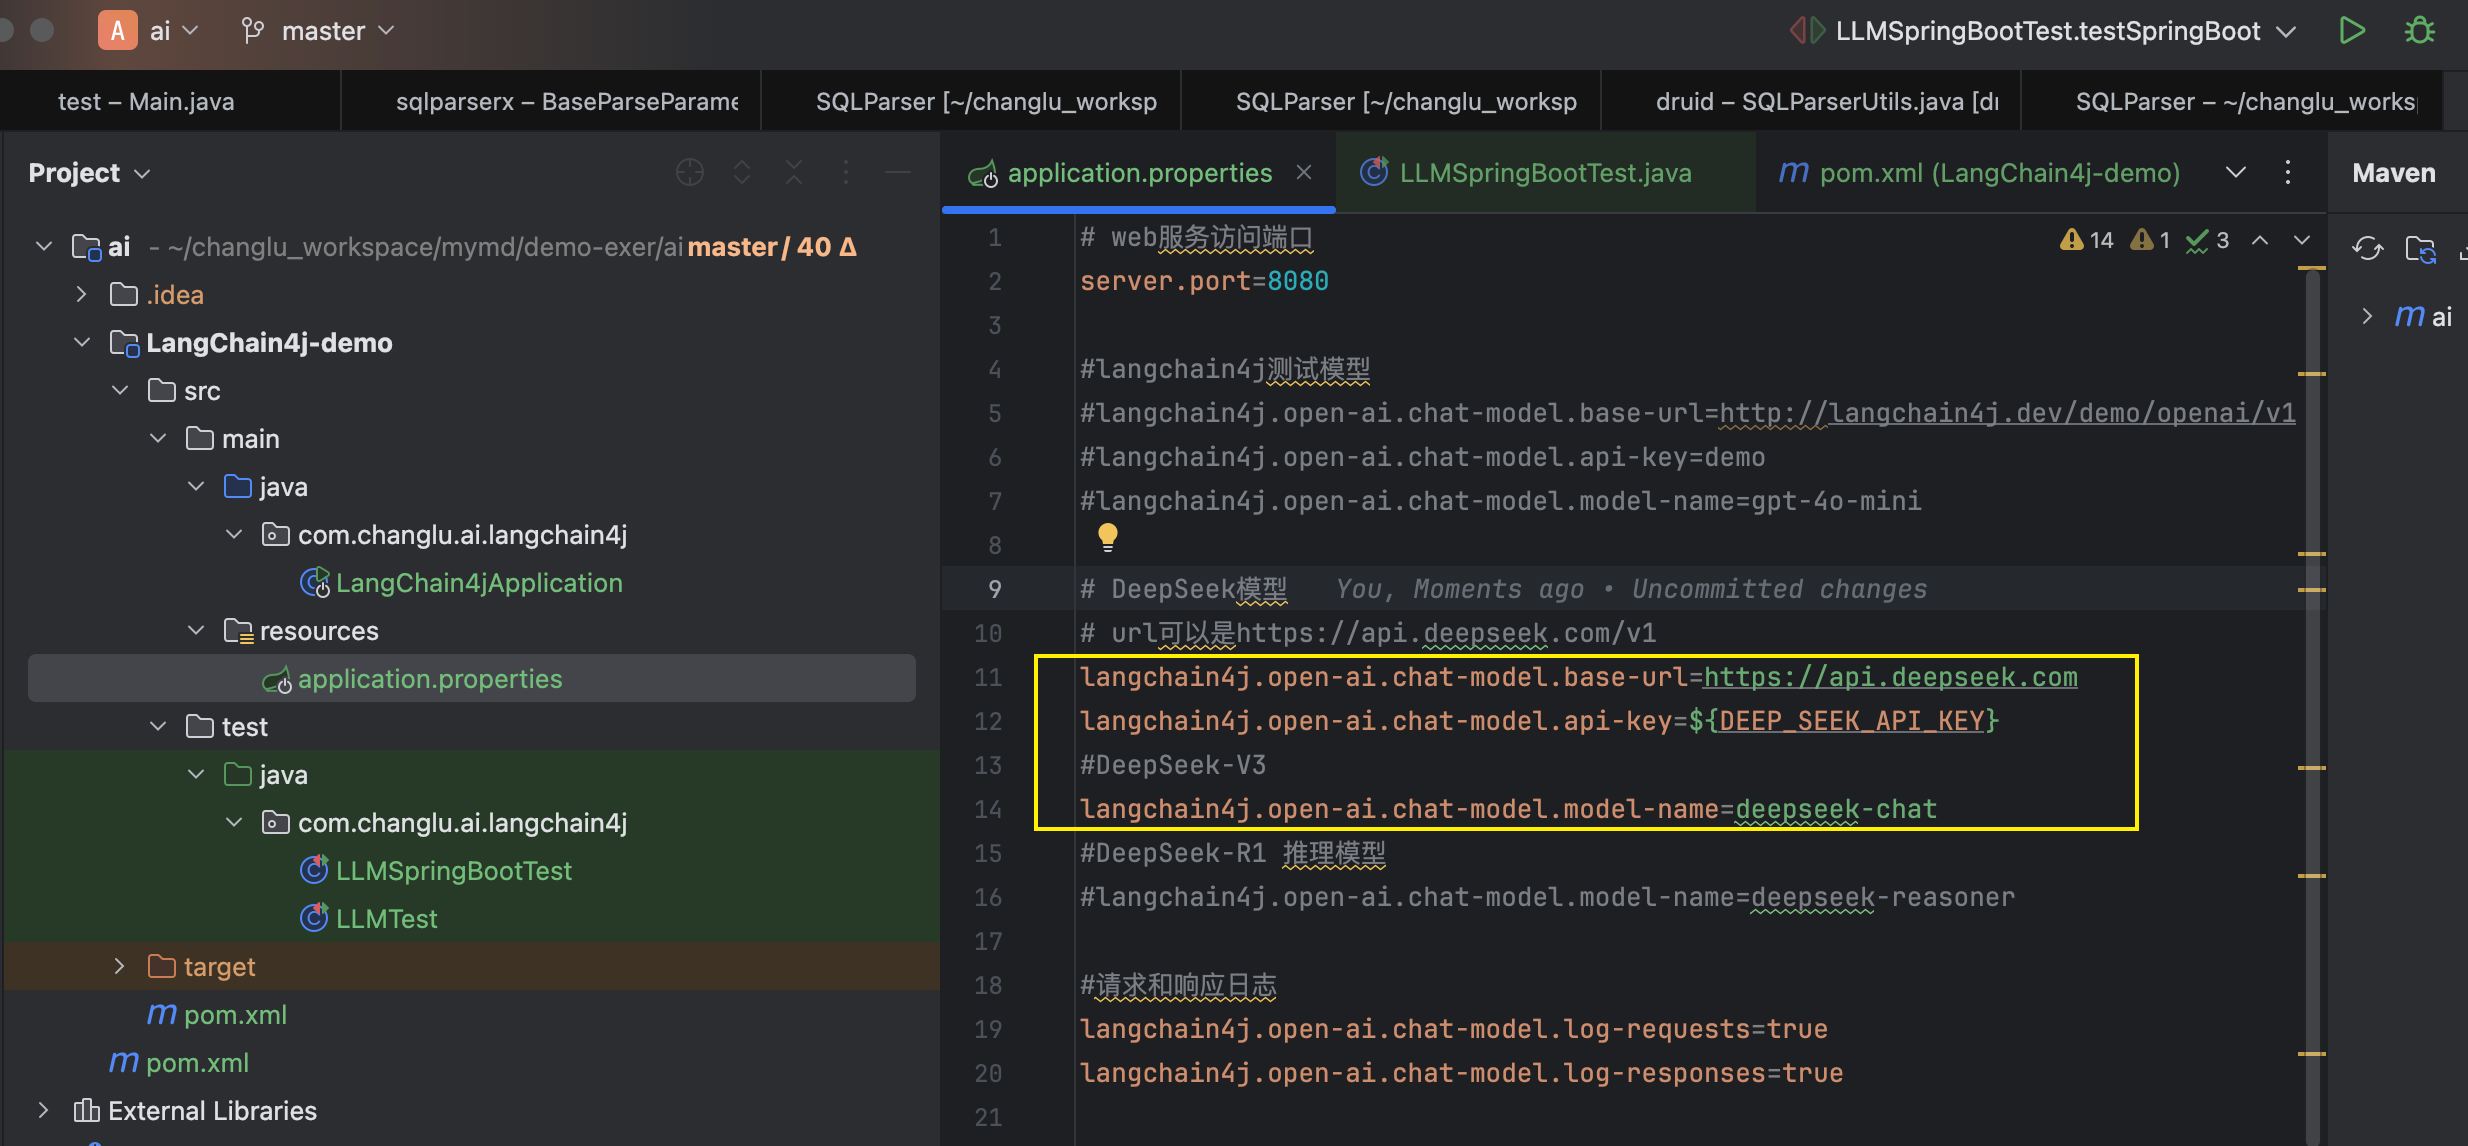
#DeepSeek
langchain4j.open-ai.chat-model.base-url=https://api.deepseek.com
langchain4j.open-ai.chat-model.api-key=${DEEP_SEEK_API_KEY}
#DeepSeek-V3
langchain4j.open-ai.chat-model.model-name=deepseek-chat
#DeepSeek-R1 推理模型
#langchain4j.open-ai.chat-model.model-name=deepseek-reasoner
由于deepseek的规范是基于openai的,所以我们这里参数名和一开始的openai一致即可,只是url、key用的是deepseek的。
接下来我们重新跑下LLMSpringBootTest验证下:提问【你是谁?】
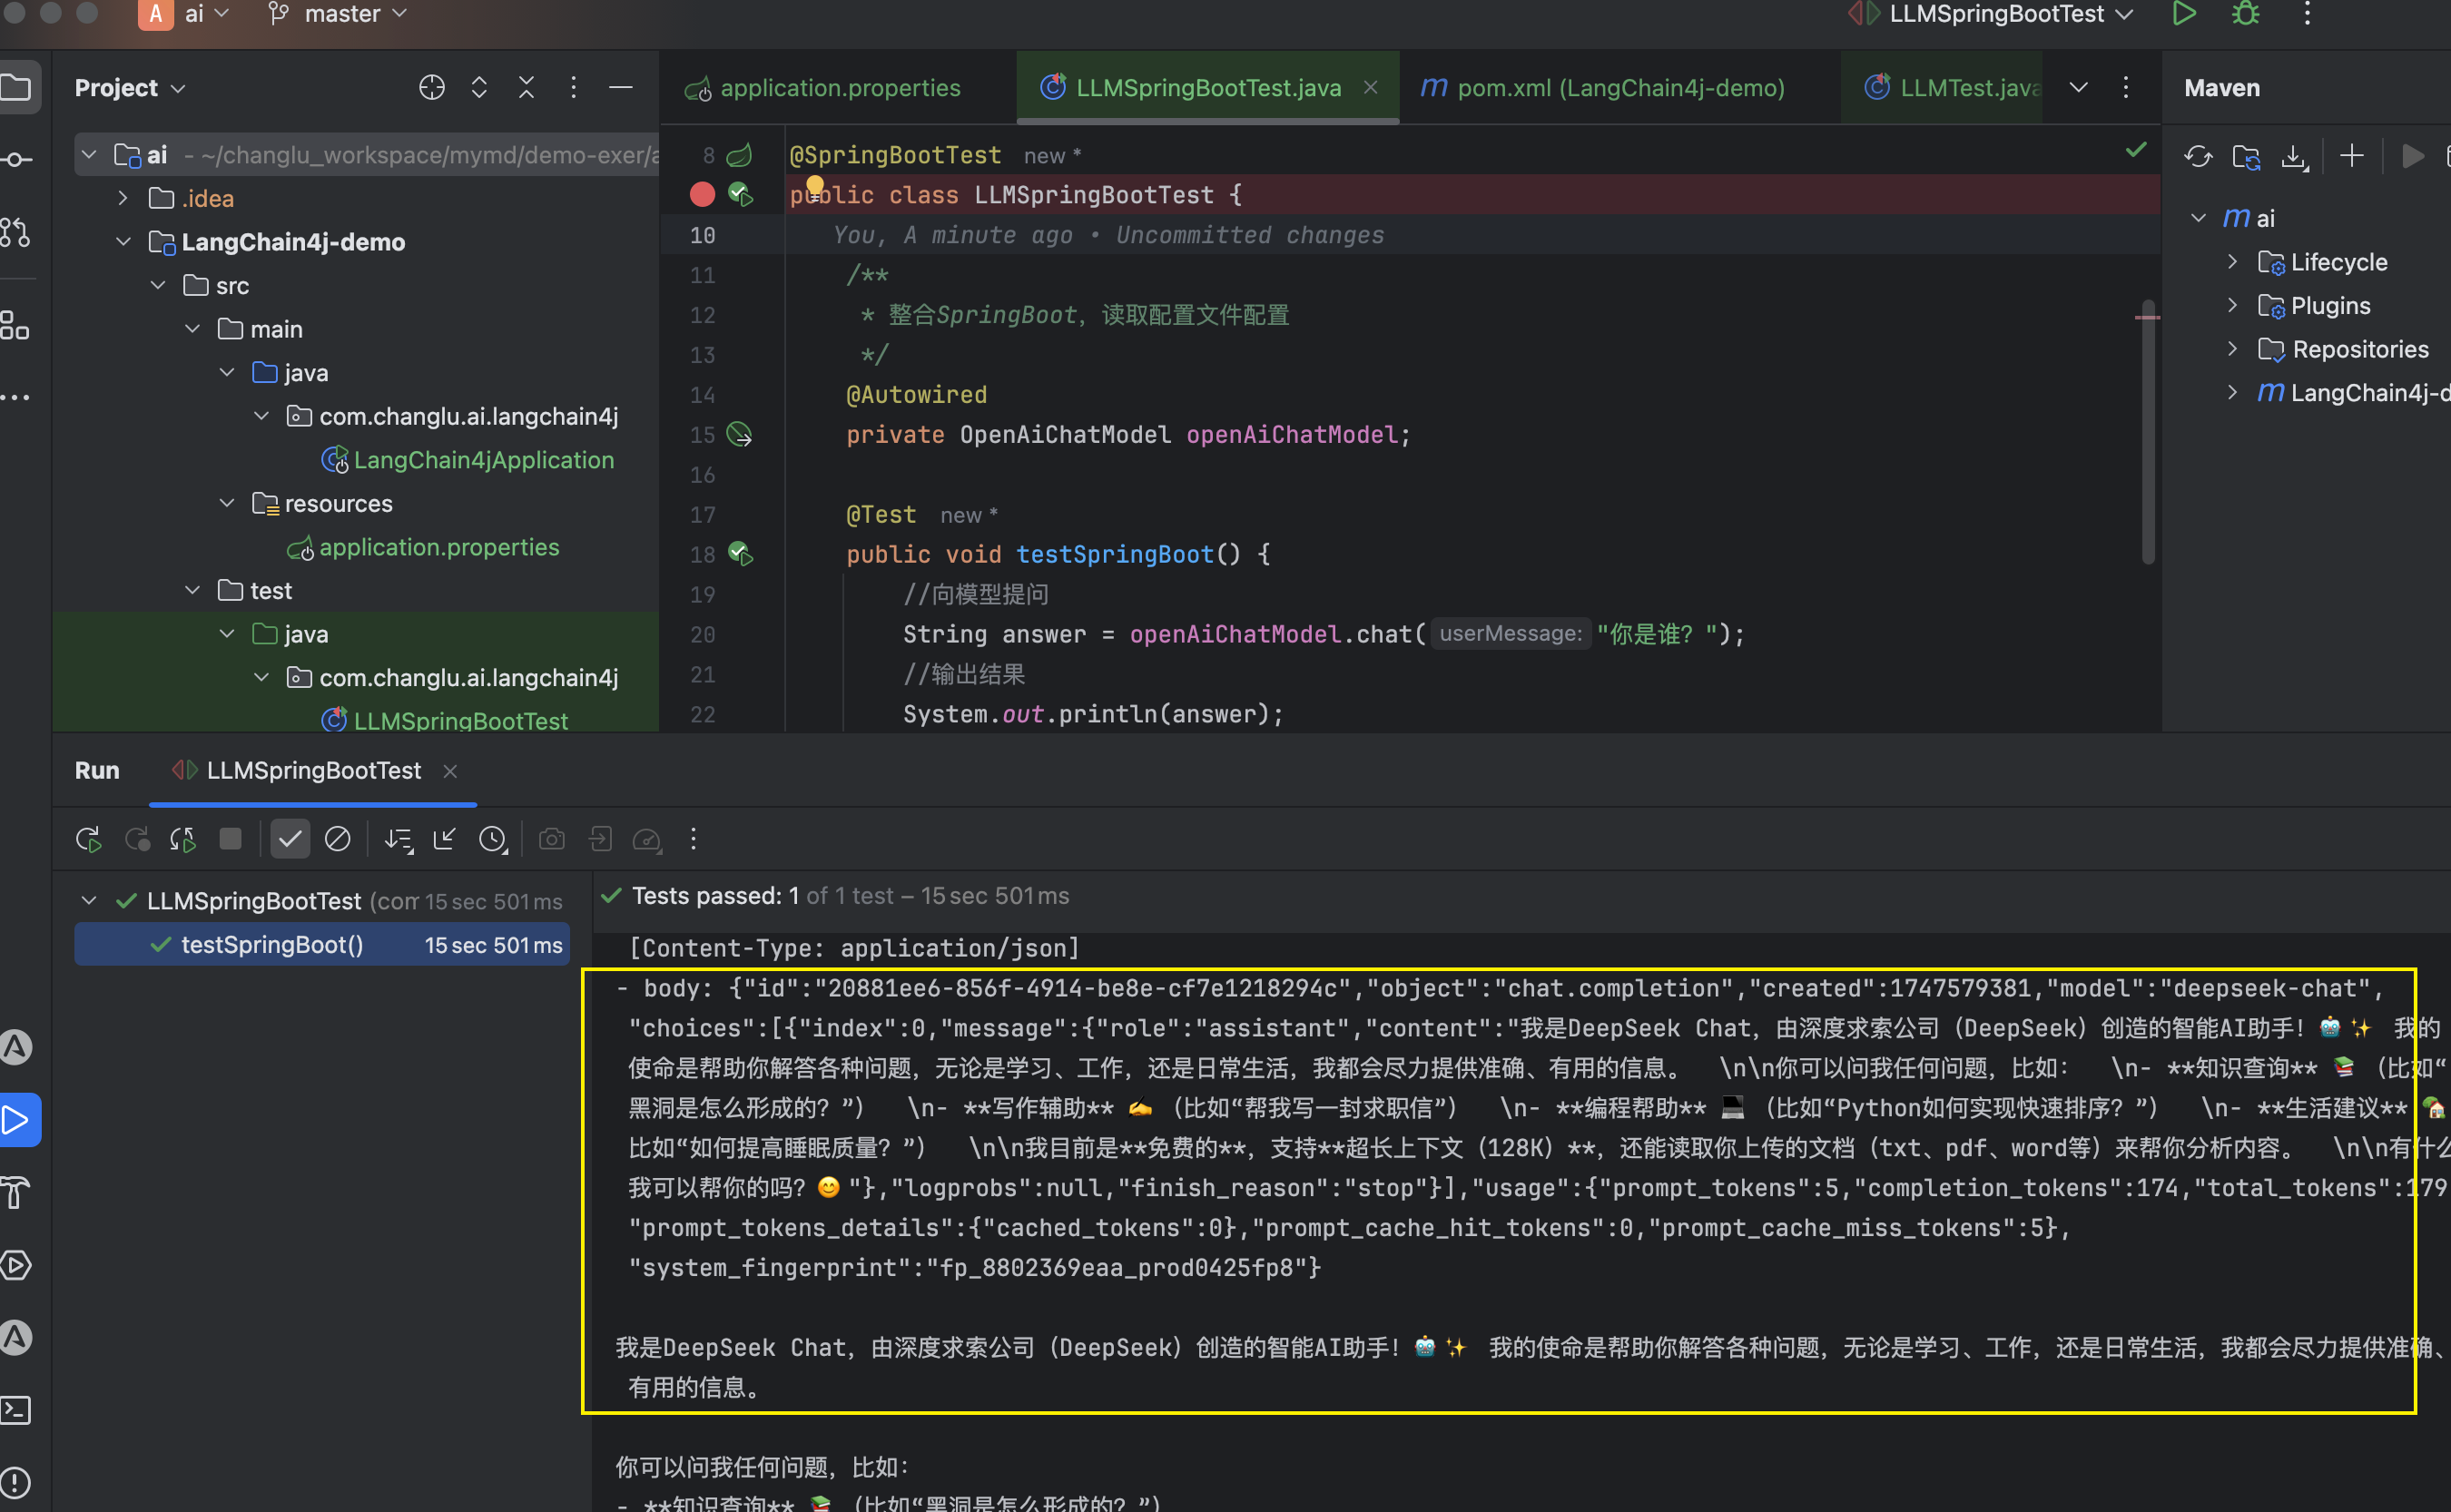
deepseek接口调用通过。
3.3、ollama本地部署
3.3.1、认识ollama
Ollama 是一个本地部署大模型的工具。使用 Ollama 进行本地部署有以下多方面的原因:
- 数据隐私与安全:对于金融、医疗、法律等涉及大量敏感数据的行业,数据安全至关重要。
- 离线可用性:在网络不稳定或无法联网的环境中,本地部署的 Ollama 模型仍可正常运行。
- 降低成本:云服务通常按使用量收费,长期使用下来费用较高。而 Ollama 本地部署,只需一次性投入硬件成本,对于需要频繁使用大语言模型且对成本敏感的用户或企业来说,能有效节约成本。
- 部署流程简单:只需通过简单的命令 “ollama run < 模型名>”,就可以自动下载并运行所需的模型。
- 灵活扩展与定制:可对模型微调,以适配垂直领域需求。
官网: https://ollama.com/
(1)下载并安装ollama: OllamaSetup.exe
(2)查看模型列表,选择要部署的模型,模型列表: https://ollama.com/search
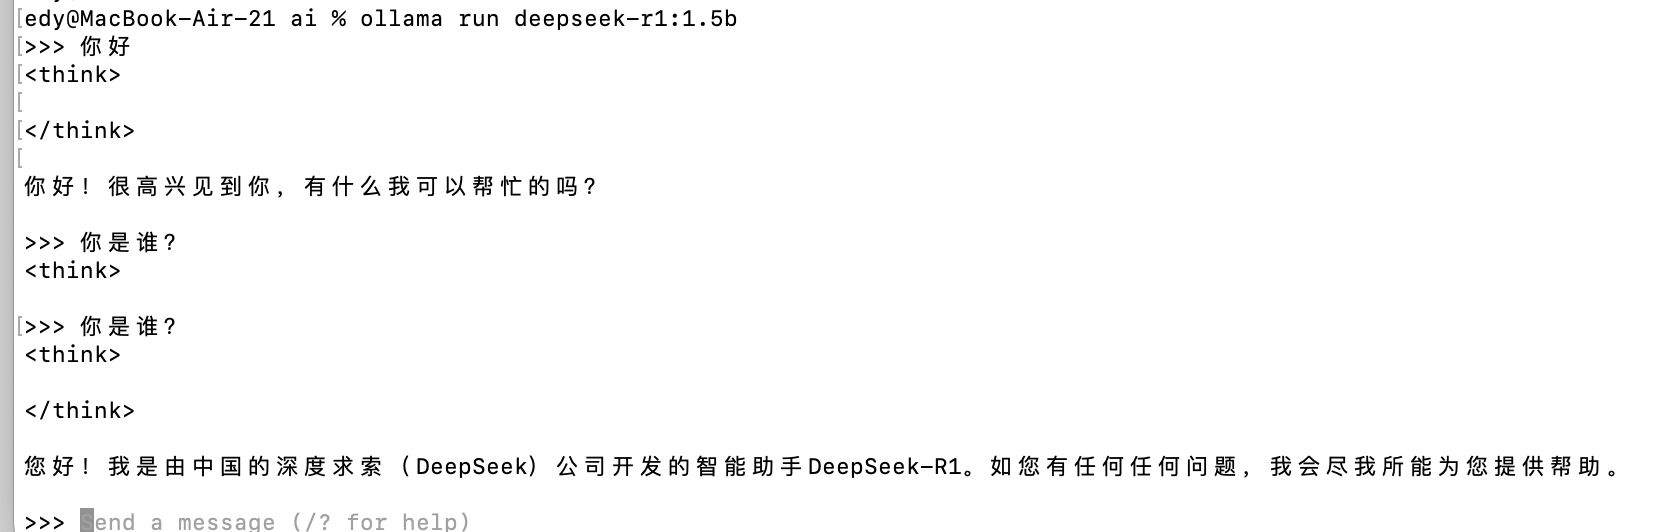
(3)执行命令: ollama run deepseek-r1:1.5 运行大模型。如果是第一次运行则会先下载大模型
ollama run deepseek-r1:1.5b
3.3.2、常用命令介绍
3.3.3、SpringBoot快速集成ollama
1)引入pom.xml
参考文档: https://docs.langchain4j.dev/integrations/language-models/ollama#get-started
<!-- 接入ollama -->
<dependency>
  <groupId>dev.langchain4j</groupId>
  <artifactId>langchain4j-ollama-spring-boot-starter</artifactId>
</dependency>
2)配置模型参数
注意:这里的参数名与之前langchain & deepseek配置不同,这里是langchain4j.ollama
#ollama
langchain4j.ollama.chat-model.base-url=http://localhost:11434
langchain4j.ollama.chat-model.model-name=deepseek-r1:1.5b
langchain4j.ollama.chat-model.log-requests=true
langchain4j.ollama.chat-model.log-responses=true
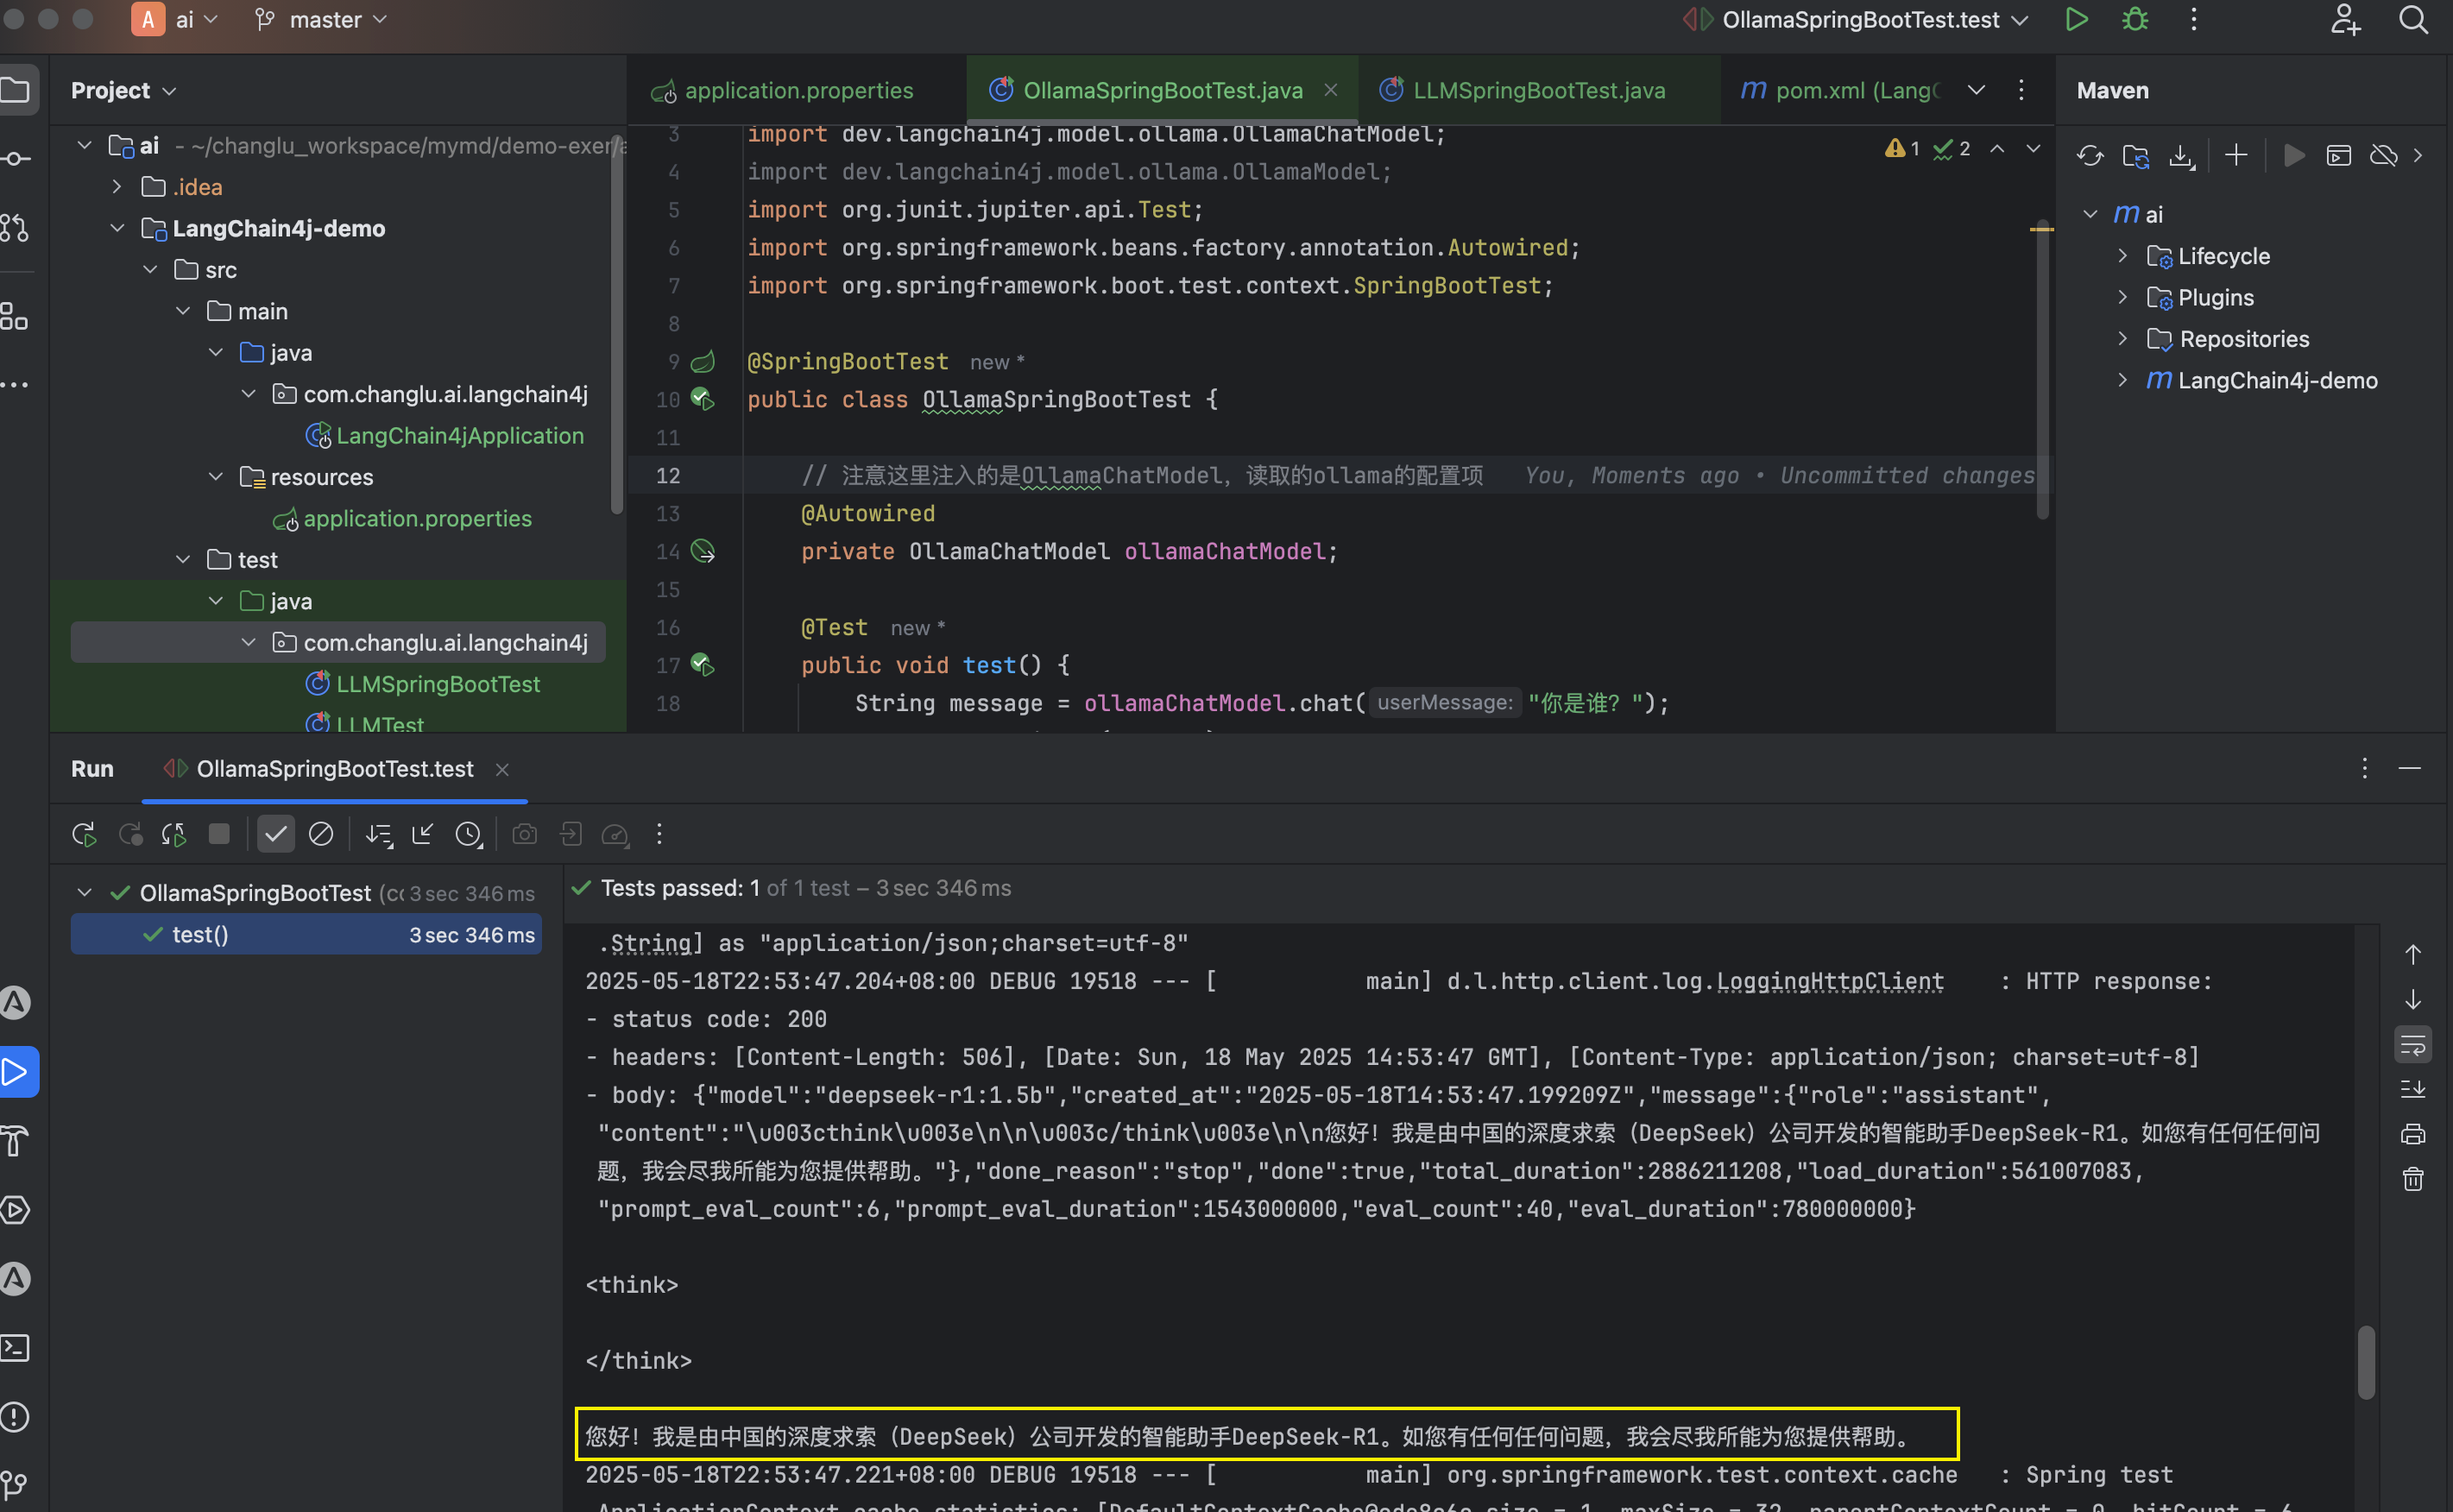
3)补充测试用例
OllamaSpringBootTest.java:
package com.changlu.ai.langchain4j;

import dev.langchain4j.model.ollama.OllamaChatModel;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

@SpringBootTest
public class OllamaSpringBootTest {

    // 注意这里注入的是OllamaChatModel,读取的ollama的配置项
    @Autowired
    private OllamaChatModel ollamaChatModel;

    @Test
    public void test() {
        String message = ollamaChatModel.chat("你是谁?");
        System.out.println(message);
    }
}
3.4、接入阿里百炼平台
3.4.1、认识阿里百炼平台
阿里云百炼:是 2023 年 10 月推出的。它集成了阿里的通义系列大模型和第三方大模型,涵盖文本、图像、音视频等不同模态。
功能优势:集成超百款大模型 API,模型选择丰富;5-10 分钟就能低代码快速构建智能体,应用构建高效;提供全链路模型训练、评估工具及全套应用开发工具,模型服务多元;在线部署可按需扩缩容,新用户有千万 token 免费送,业务落地成本低。
支持接入的模型列表: https://help.aliyun.com/zh/model-studio/models
模型广场: https://bailian.console.aliyun.com/?productCode=p_efm#/model-market
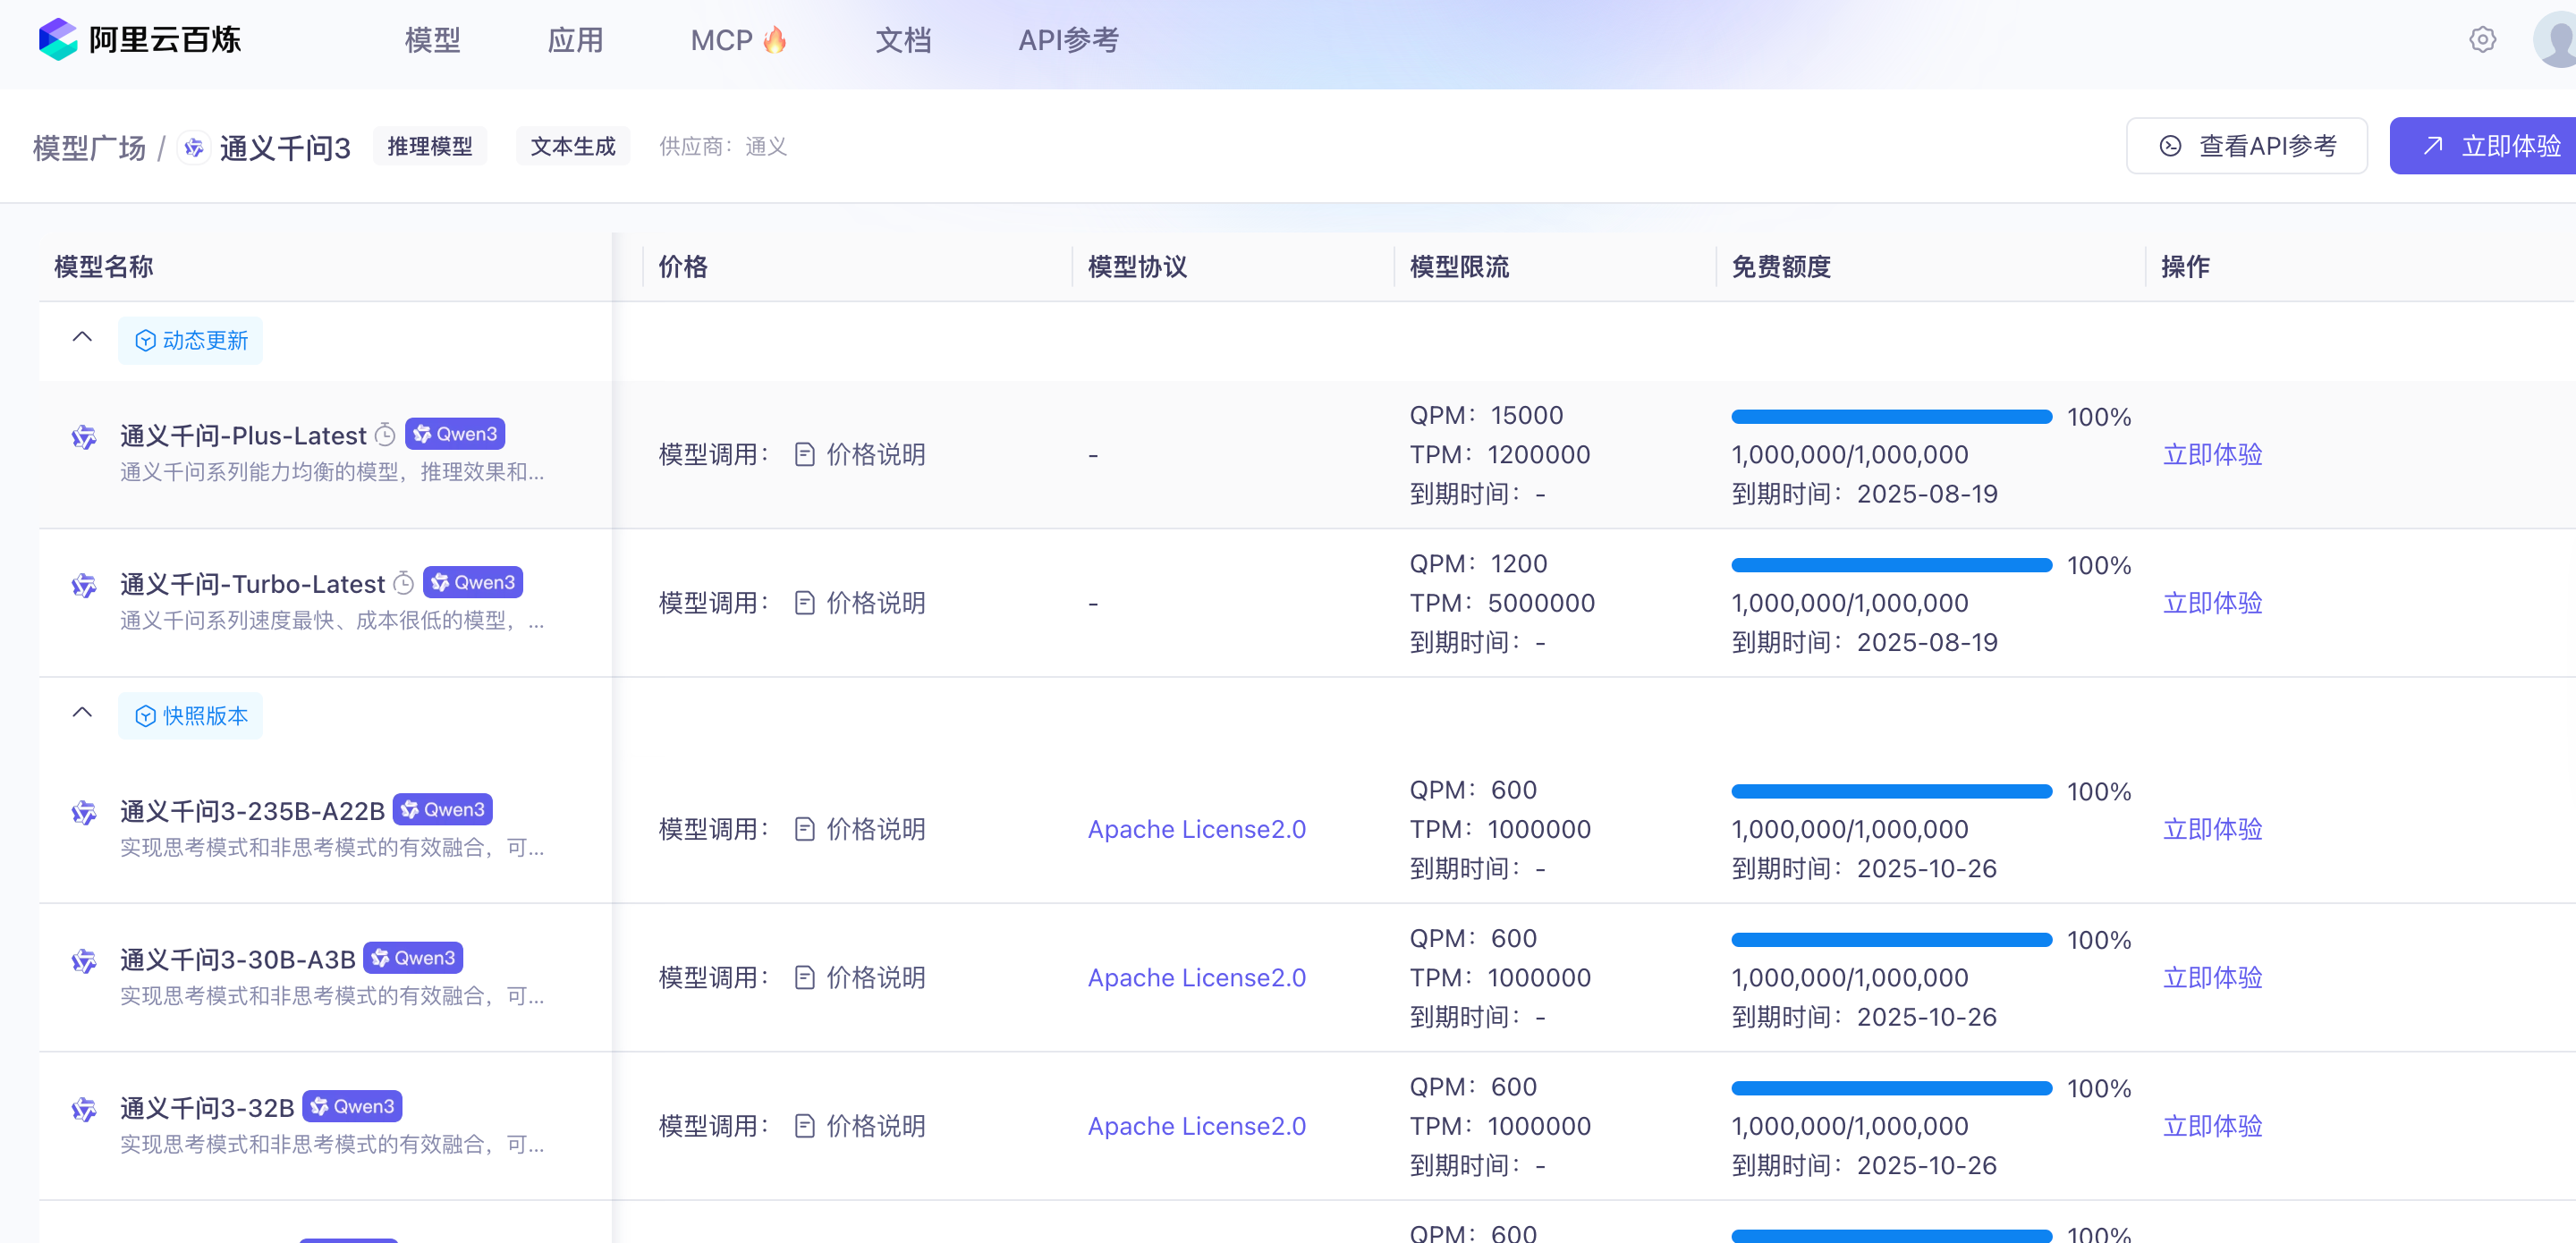
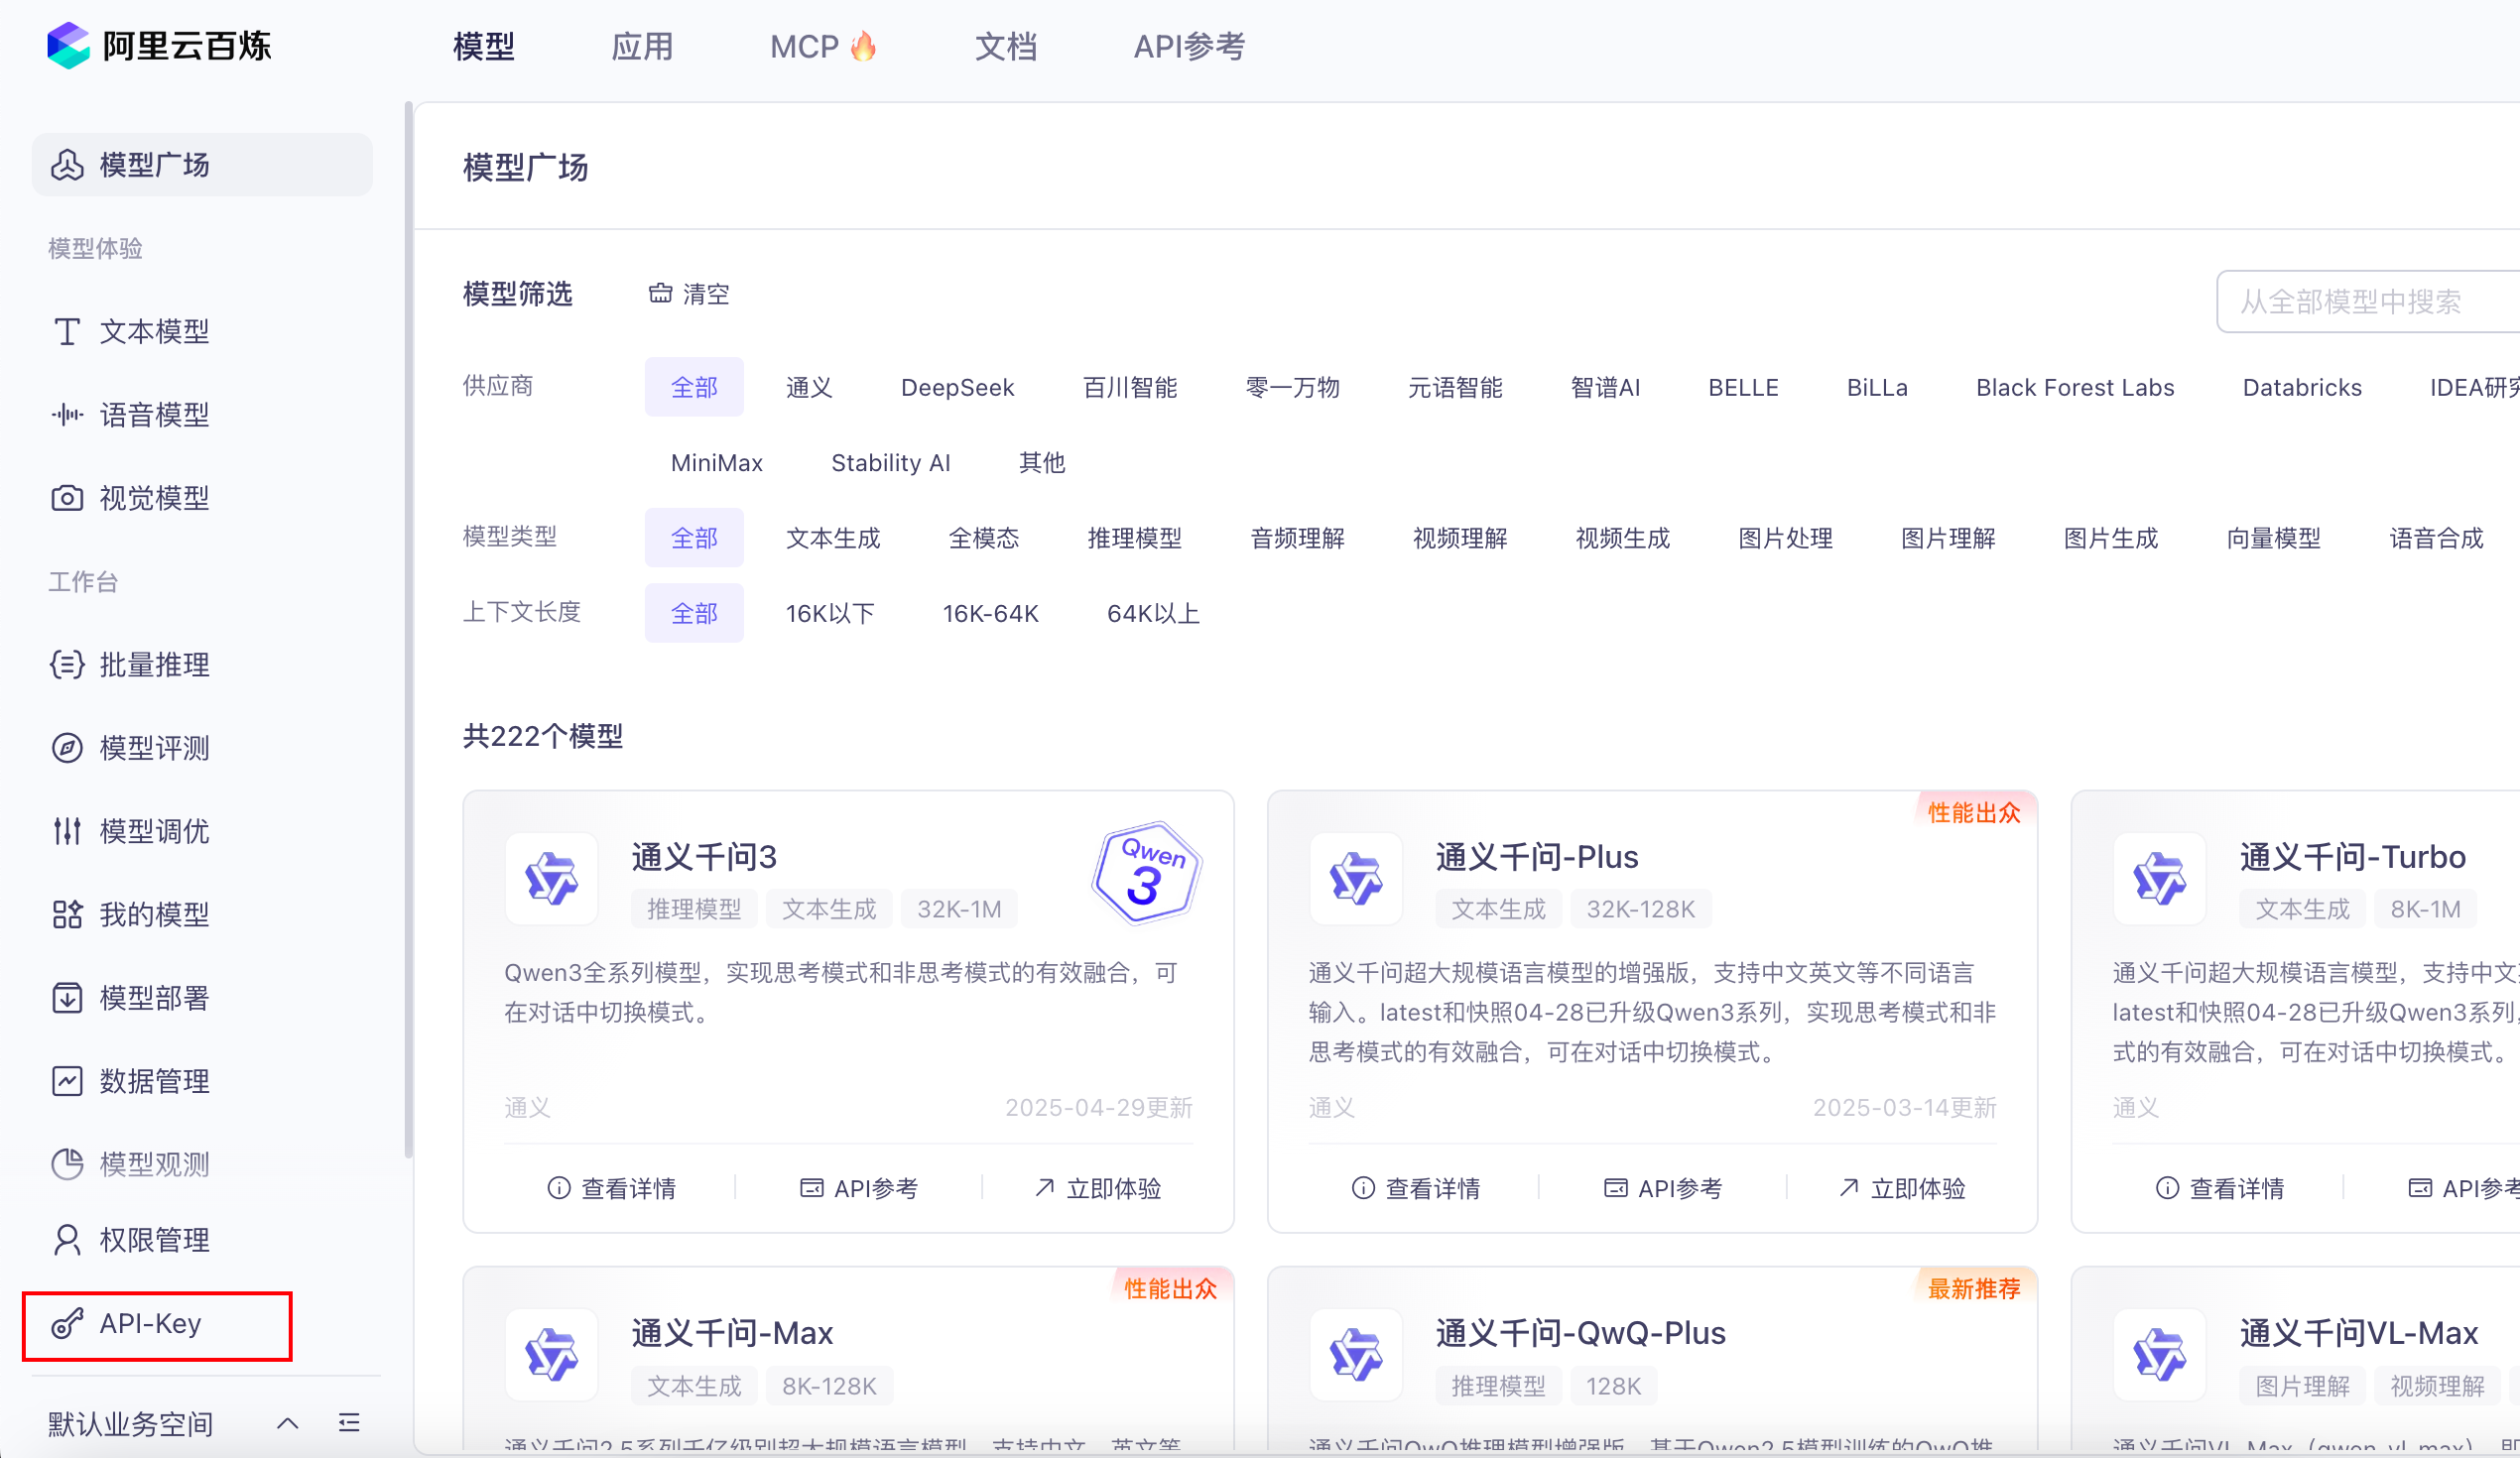
进入广场后,任意选择模型,点击详情,默认百炼给我们每一个模型提供了100万token使用:
**如何生成key呢?**左下角有一个API-KEY注册即可
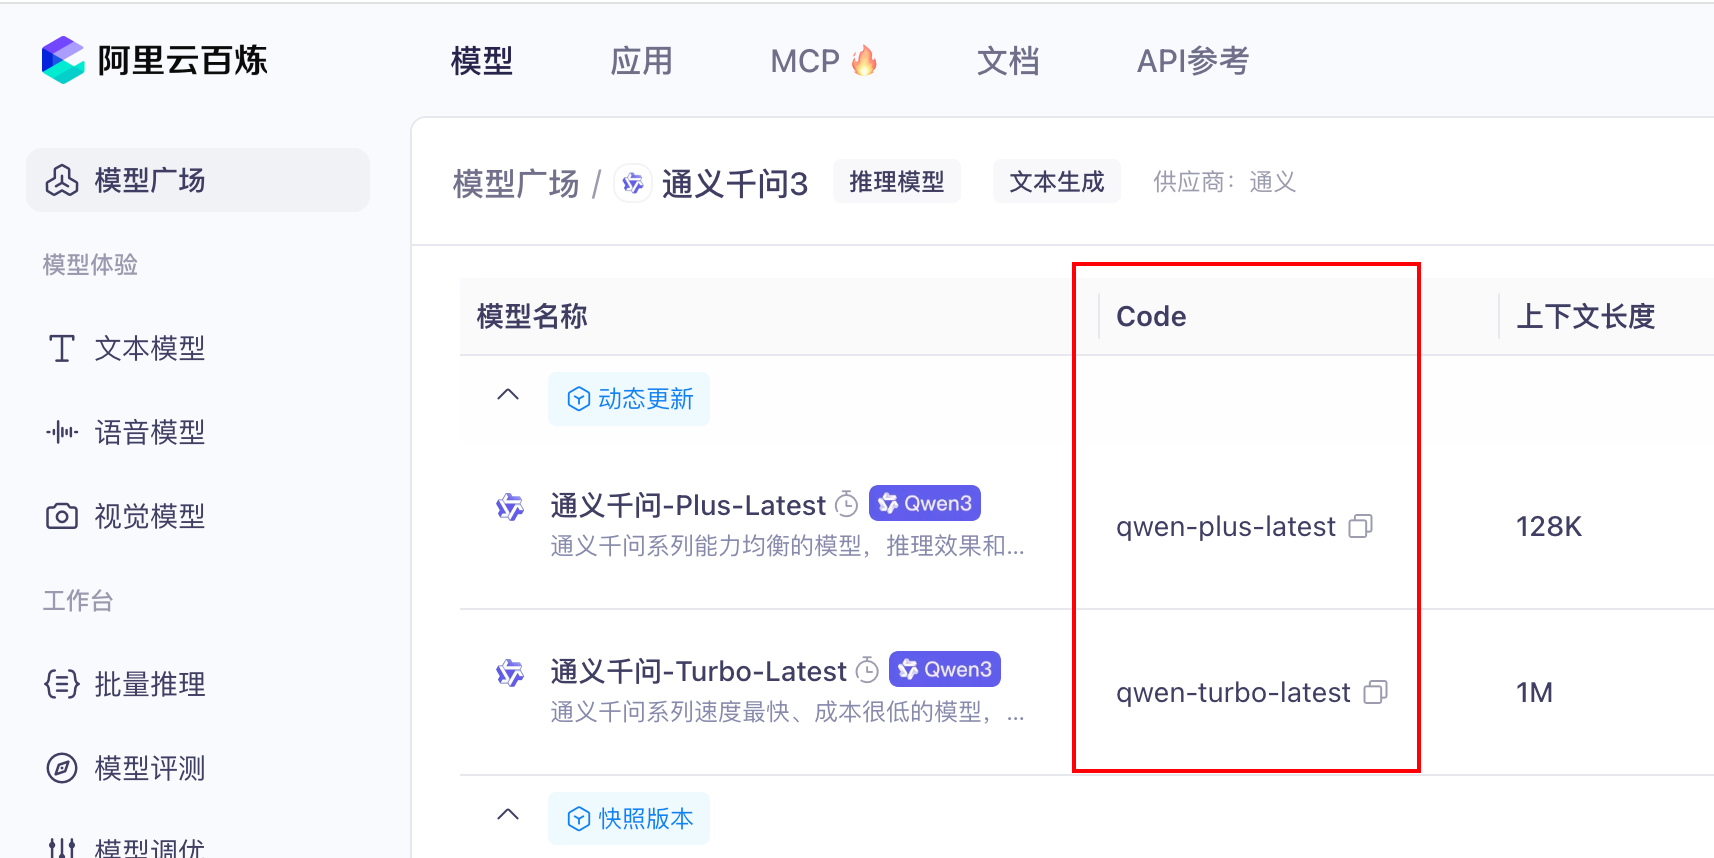
若是想要指定使用哪一个模型,指定这个code名即可:
3.4.2、配置百炼开发参数
配置apiKey:配置在环境变量DASH_SCOPE_API_KEY中
vim ~/.zshrc

# 配置内容
export DASH_SCOPE_API_KEY="xxxxxxxxx"

# 生效配置文件
source ~/.zshrc
3.4.3、SpringBoot快速集成百炼
1)引入pom.xml依赖
<dependencies>
  <!-- 接入阿里云百炼平台 -->
  <dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-community-dashscope-spring-boot-starter</artifactId>
  </dependency>
</dependencies>

<dependencyManagement>
  <dependencies>
		<!--引入百炼依赖管理清单-->
    <dependency>
      <groupId>dev.langchain4j</groupId>
      <artifactId>langchain4j-community-bom</artifactId>
      <version>${langchain4j.version}</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>
2)配置模型参数
#百炼
langchain4j.community.dashscope.chat-model.api-key=${DASH_SCOPE_API_KEY}
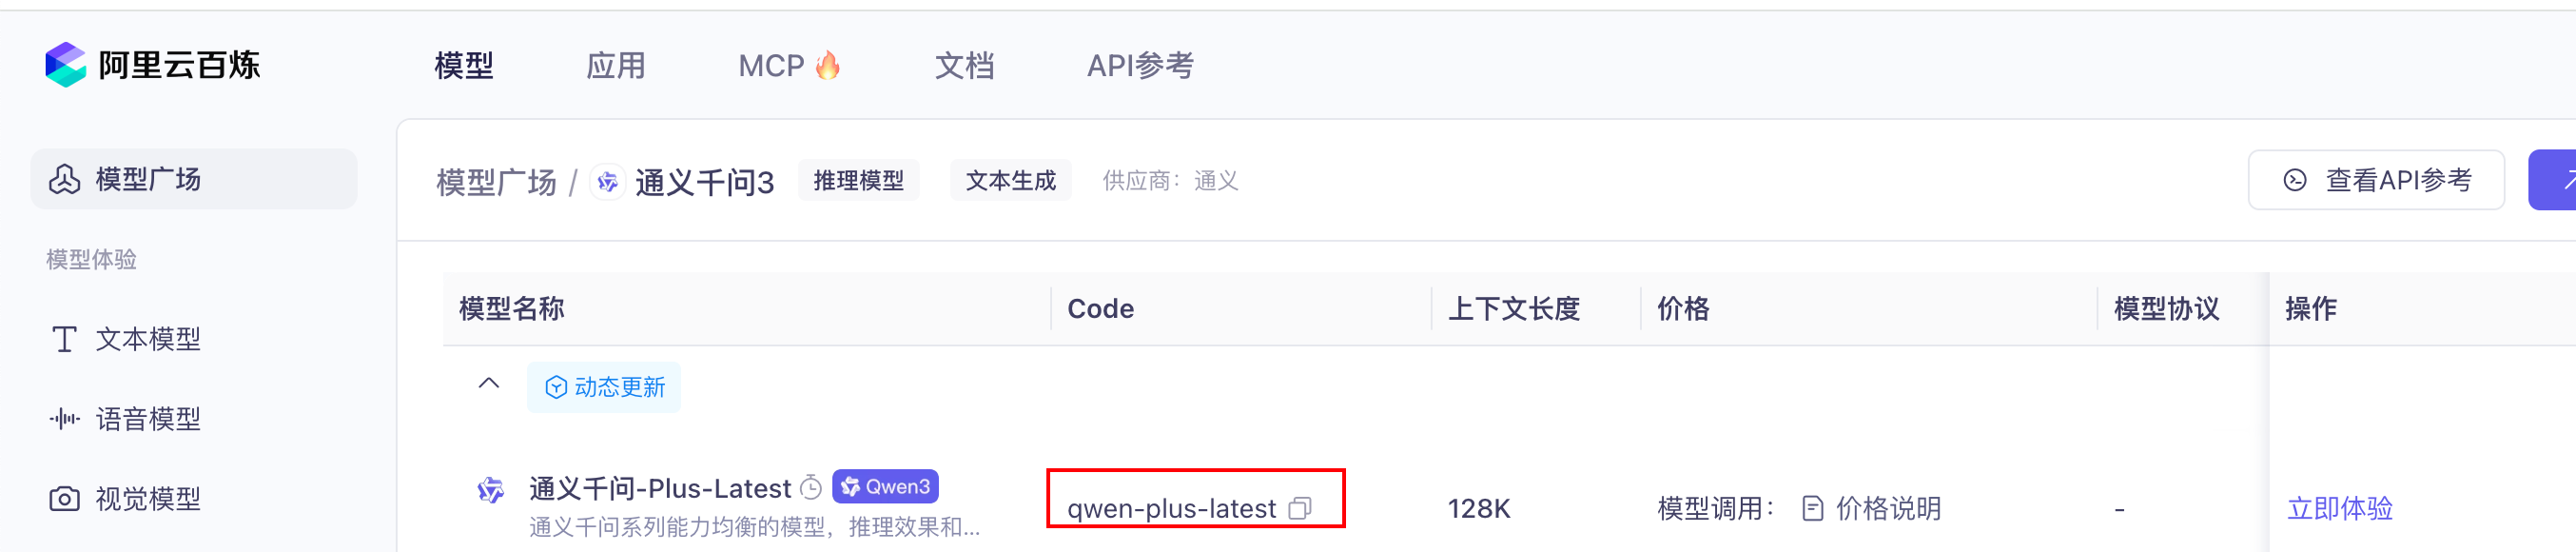
langchain4j.community.dashscope.chat-model.model-name=qwen-plus-latest
我们这里选择的是最新的model:
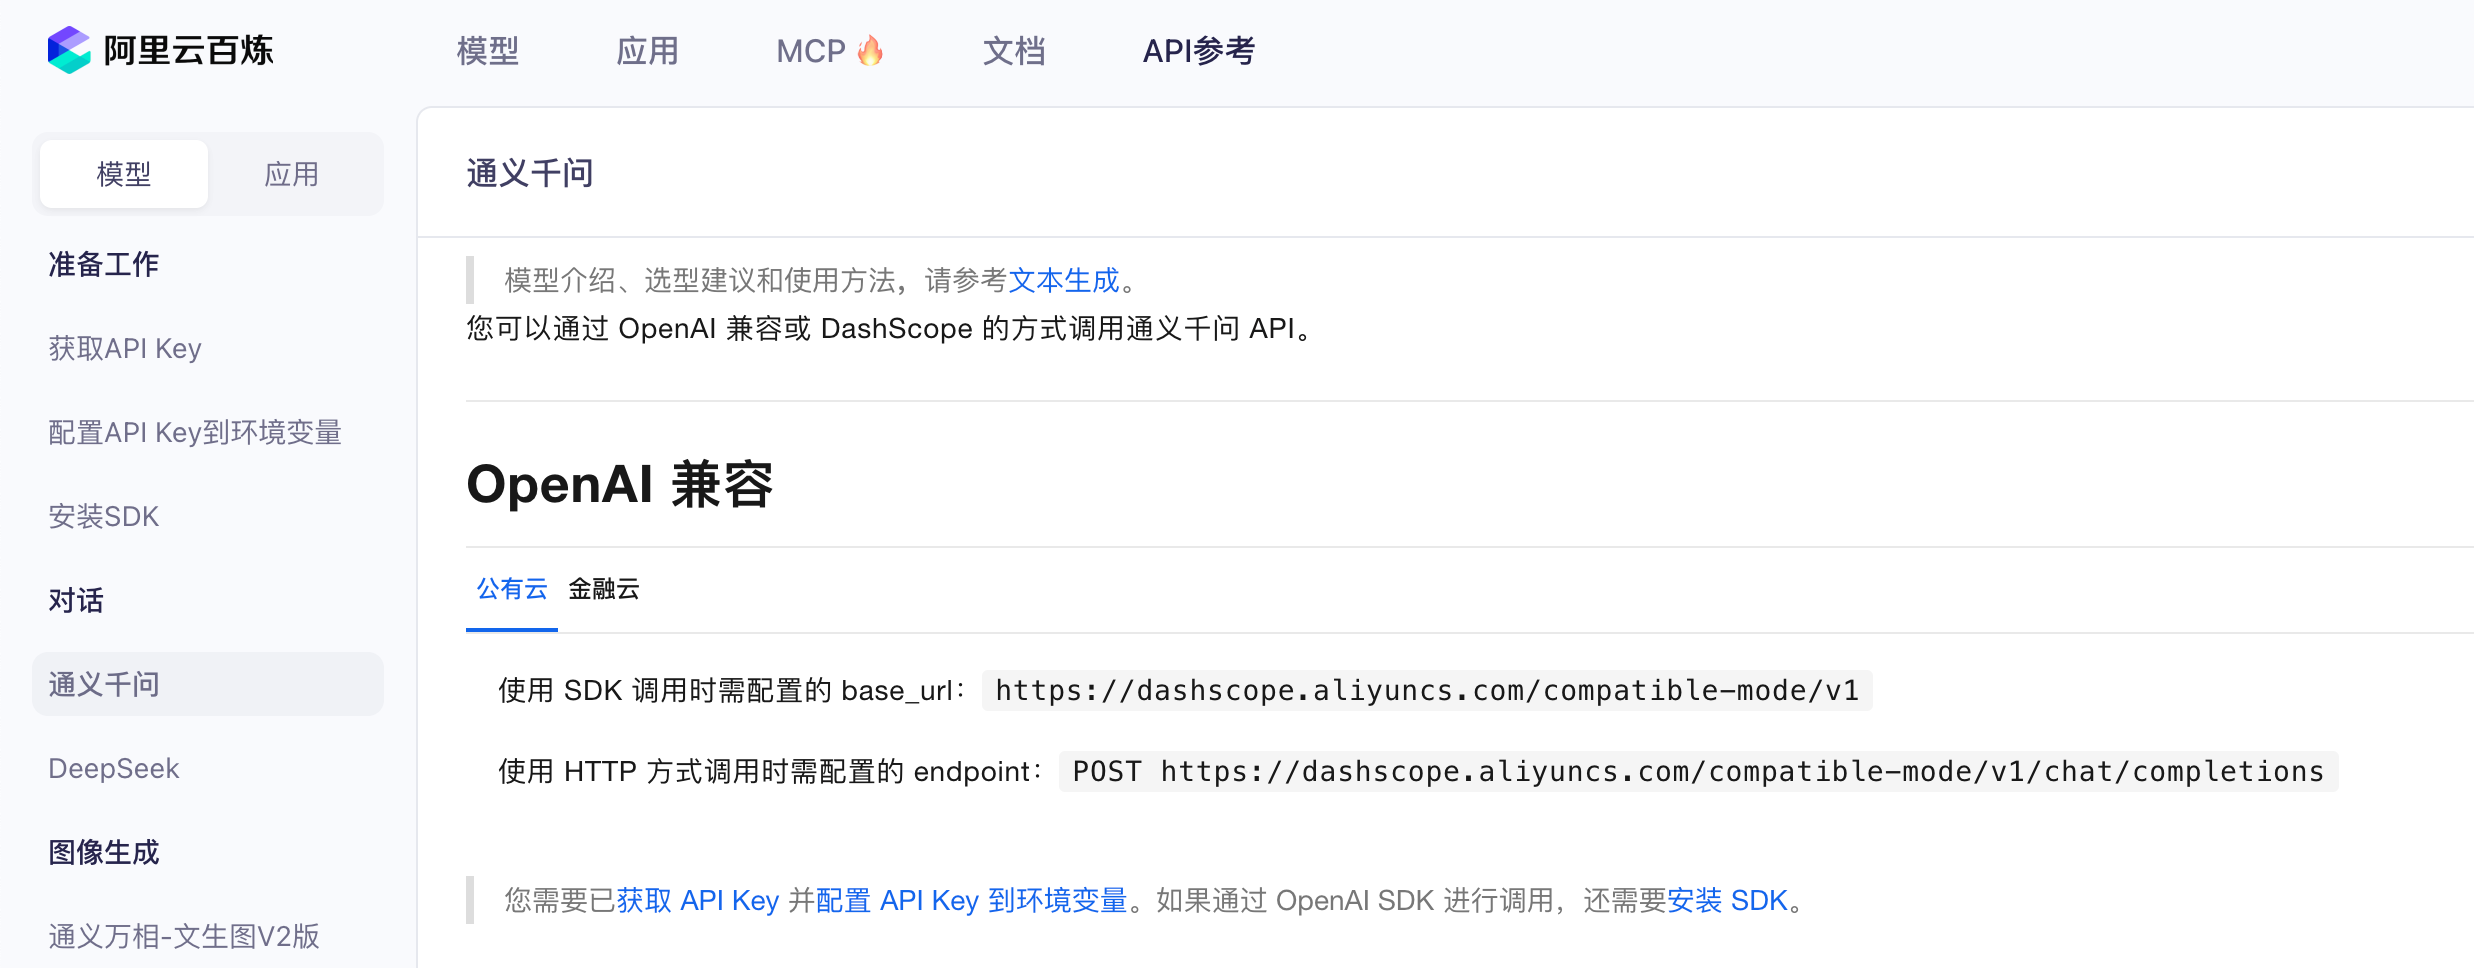
说明:这里没有配置baseurl,是因为默认依赖包自带的。
如果想要去指定,可以任意选择一个模型,点击查看API,如:https://bailian.console.aliyun.com/?productCode=p_efm&tab=api#/api/?type=model&url=https%3A%2F%2Fhelp.aliyun.com%2Fdocument_detail%2F2712576.html
3)补充测试用例
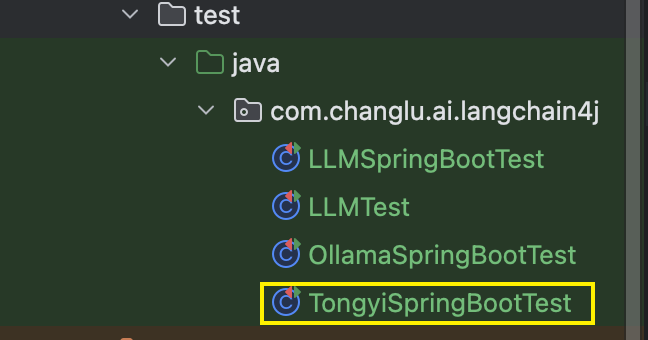
package com.changlu.ai.langchain4j;

import dev.langchain4j.community.model.dashscope.QwenChatModel;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

/**
 * @description  百炼平台测试
 * @author changlu
 * @date 2025/5/19 00:54
 */
@SpringBootTest
public class TongyiSpringBootTest {

    @Autowired
    private QwenChatModel qwenChatModel;

    @Test
    public void test() {
        String message = qwenChatModel.chat("你是谁");
        System.out.println(message);
    }

}
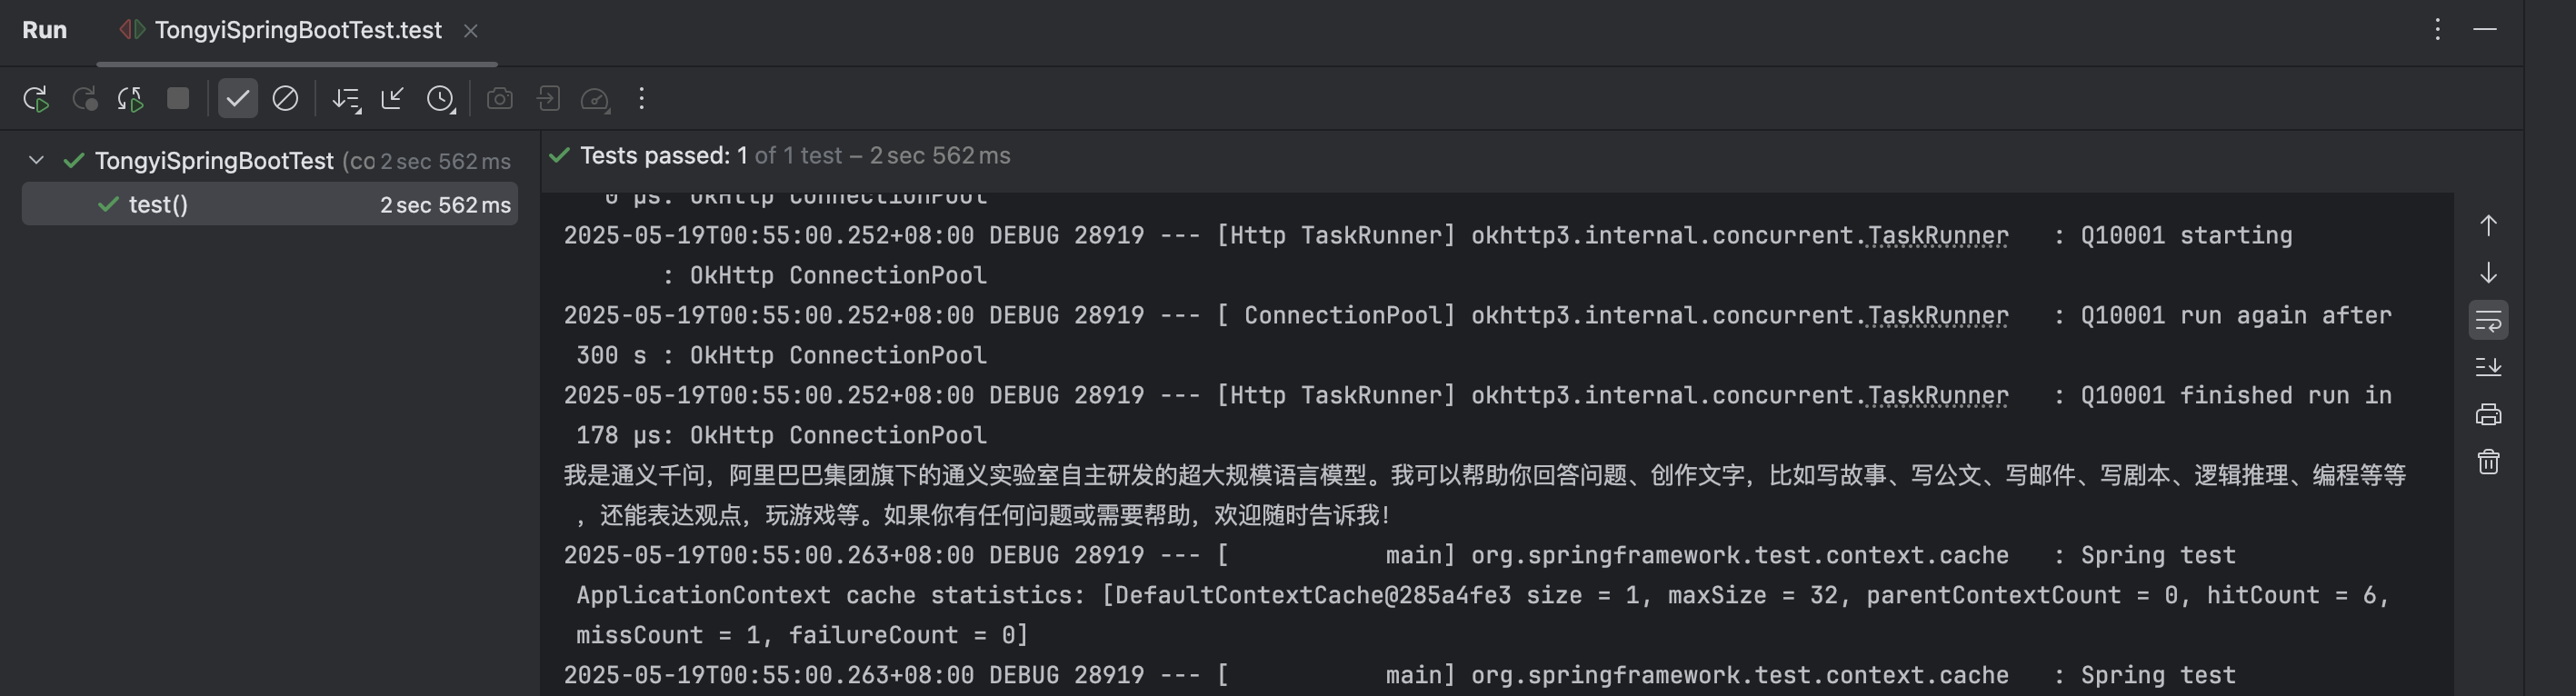
测试结果如下:
3.4.4、实战案例集成:通义万象
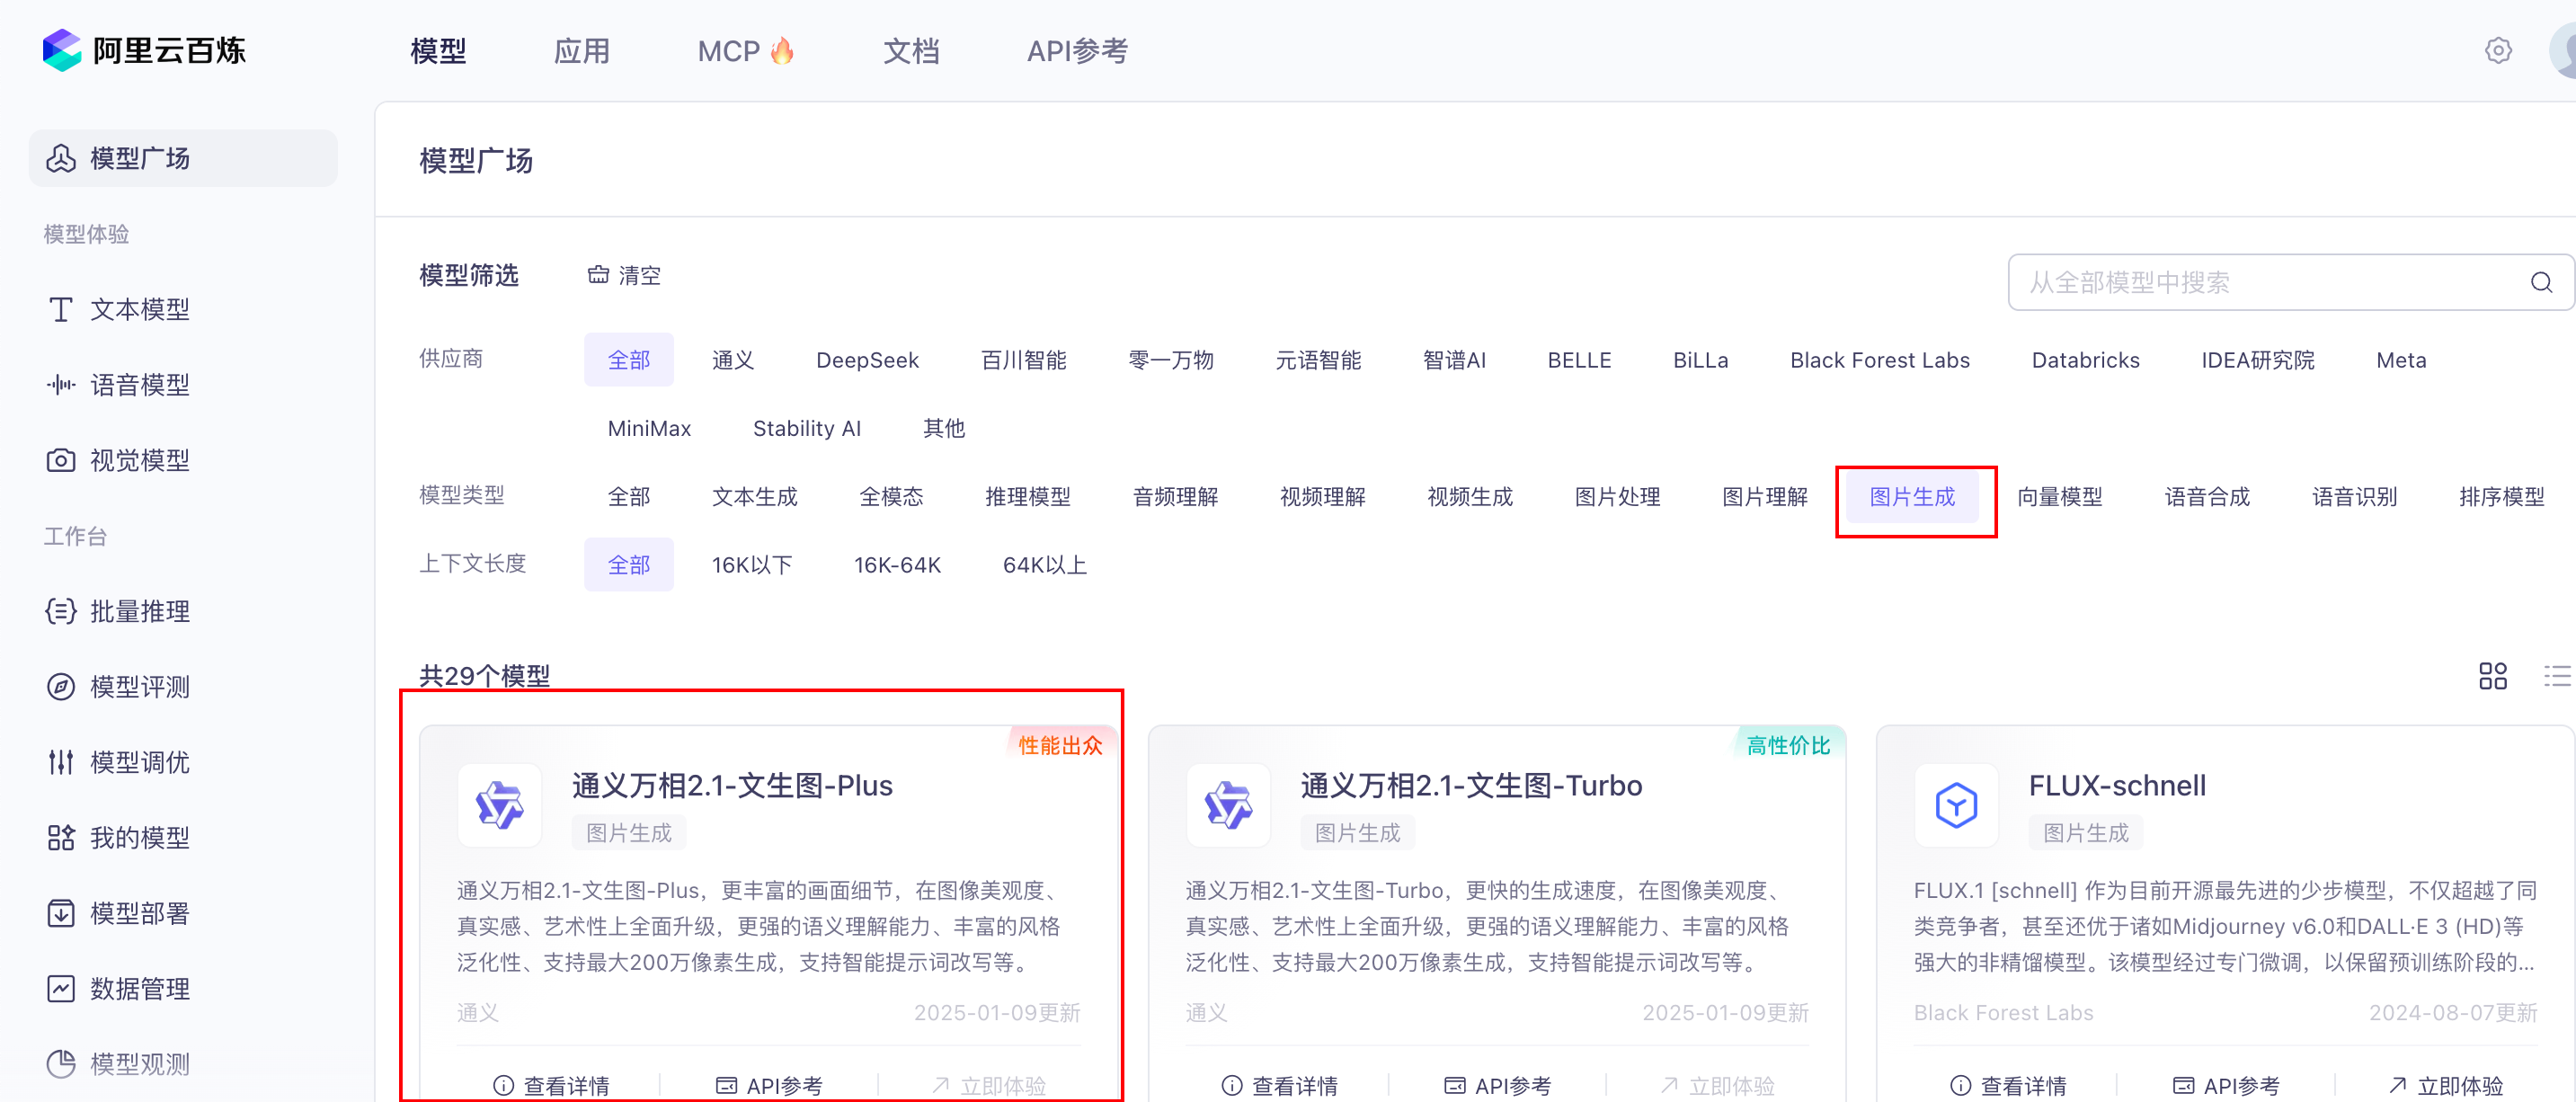
选择一个图片生成模型:https://bailian.console.aliyun.com/?tab=model&accounttraceid=7e798ad0e507456cb5fddc6e66d33511phhb#/model-market?capabilities=%5B%22IG%22%5D&z_type_=%7B%22capabilities%22%3A%22array%22%7D
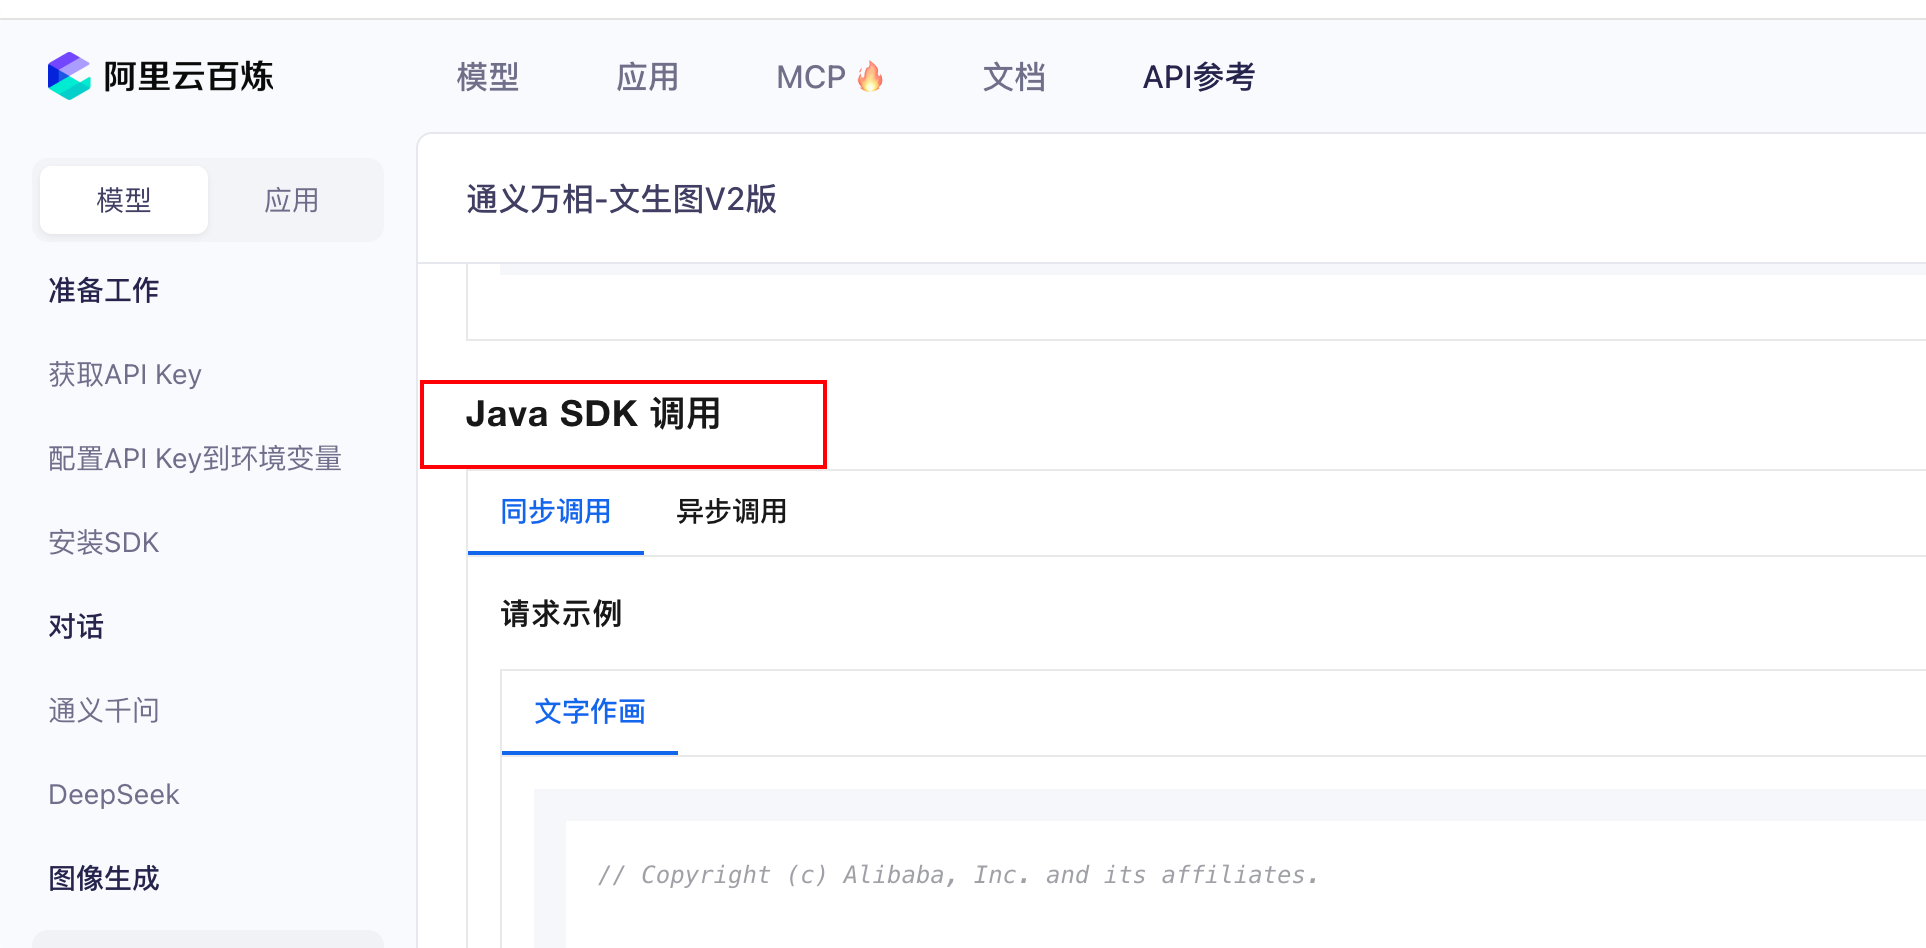
点击API参考:https://bailian.console.aliyun.com/?tab=api&accounttraceid=7e798ad0e507456cb5fddc6e66d33511phhb#/api/?type=model&url=https%3A%2F%2Fhelp.aliyun.com%2Fdocument_detail%2F2862677.html
参考官方给出的Java的SDK调用:
默认免费额度500张,这里选择该模型-wanx2.1-t2i-plus:
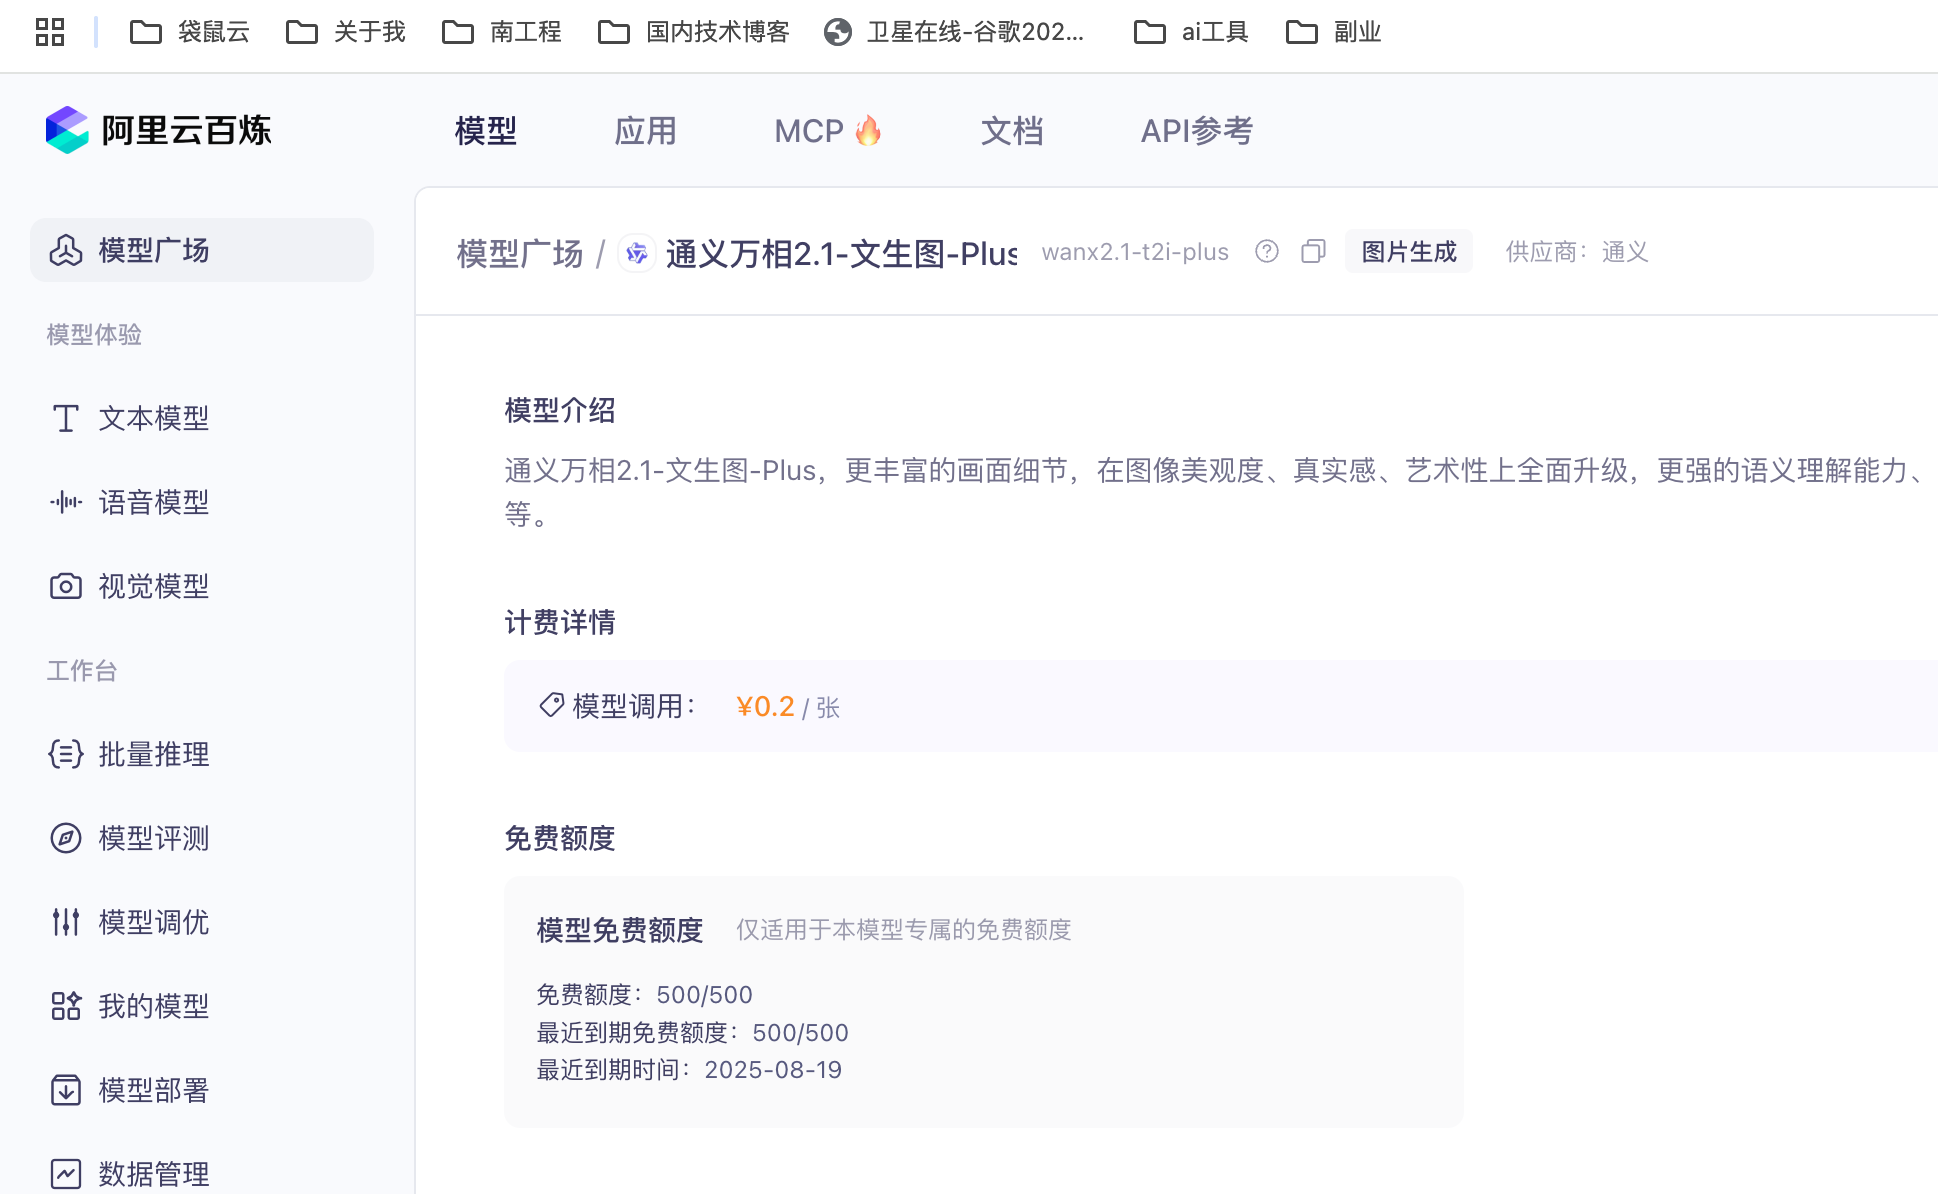
本地编写单测用例:
 。
@Test
public void testTongyiwanxiang() {
    // 目前只支持这种方式调用
    WanxImageModel wanxImageModel = WanxImageModel.builder()
            .modelName("wanx2.1-t2i-plus")
            .apiKey(System.getenv("DASH_SCOPE_API_KEY"))
            .build();
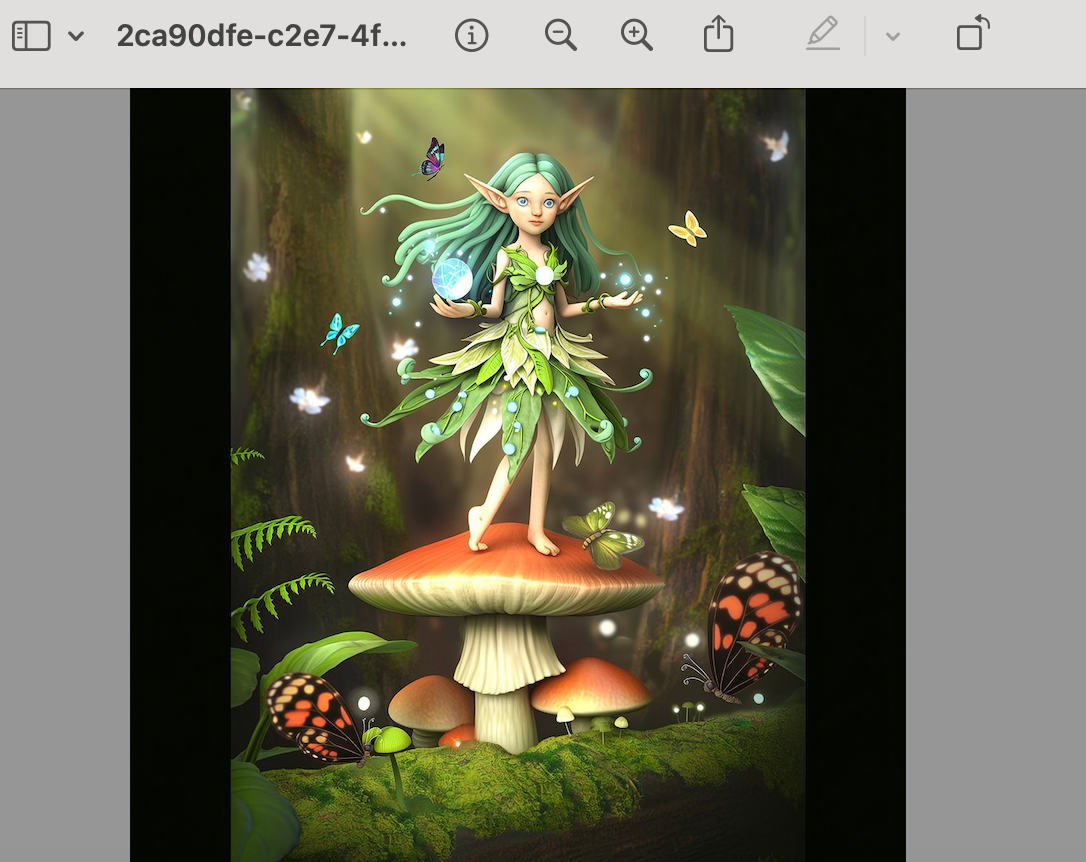
    Response<Image> response = wanxImageModel.generate("奇幻森林精灵:在一片弥漫着轻柔薄雾的\n" +
            "                古老森林深处,阳光透过茂密枝叶洒下金色光斑。一位身材娇小、长着透明薄翼的精灵少女站在一朵硕大的蘑菇上。她\n" +
            "                有着海藻般的绿色长发,发间点缀着蓝色的小花,皮肤泛着珍珠般的微光。身上穿着由翠绿树叶和白色藤蔓编织而成的\n" +
            "                连衣裙,手中捧着一颗散发着柔和光芒的水晶球,周围环绕着五彩斑斓的蝴蝶,脚下是铺满苔藓的地面,蘑菇和蕨类植\n" +
            "                物丛生,营造出神秘而梦幻的氛围。");
    System.out.println(response.content().url());
}
运行之后,会打印生成的图片字符串:
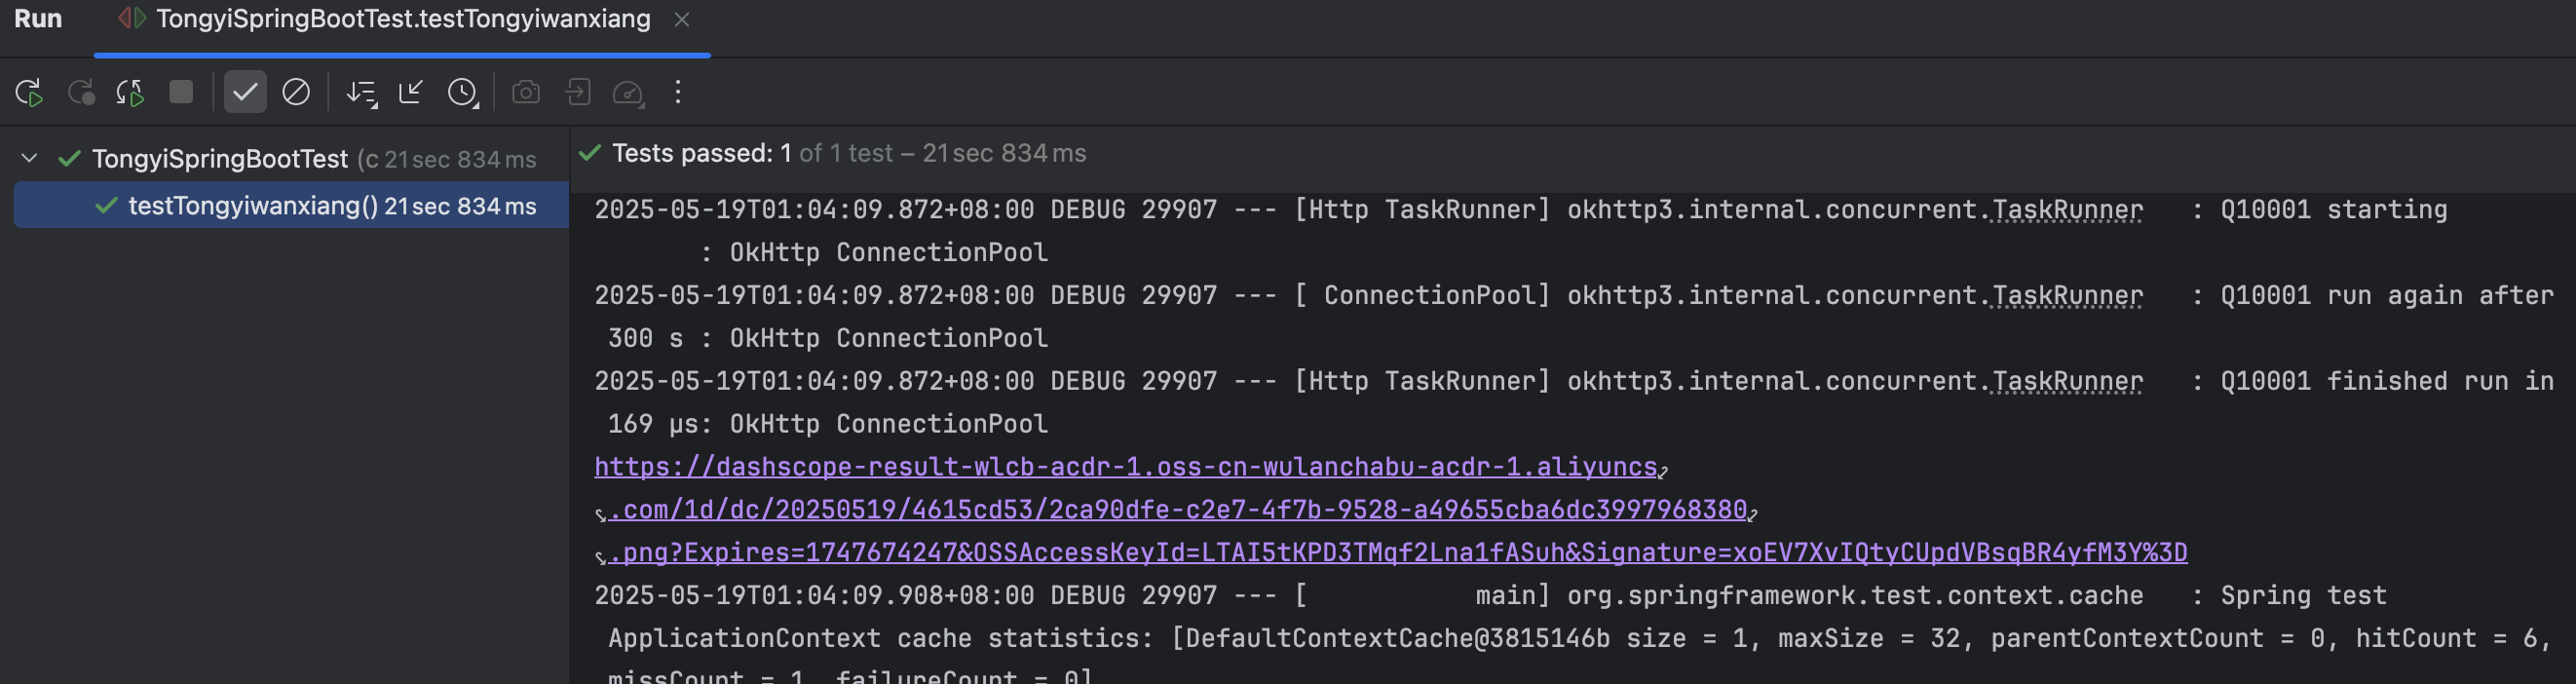
效果如下:
3.4.5、实战案例集成:百炼deepseek
模型平台,选择deepseek:
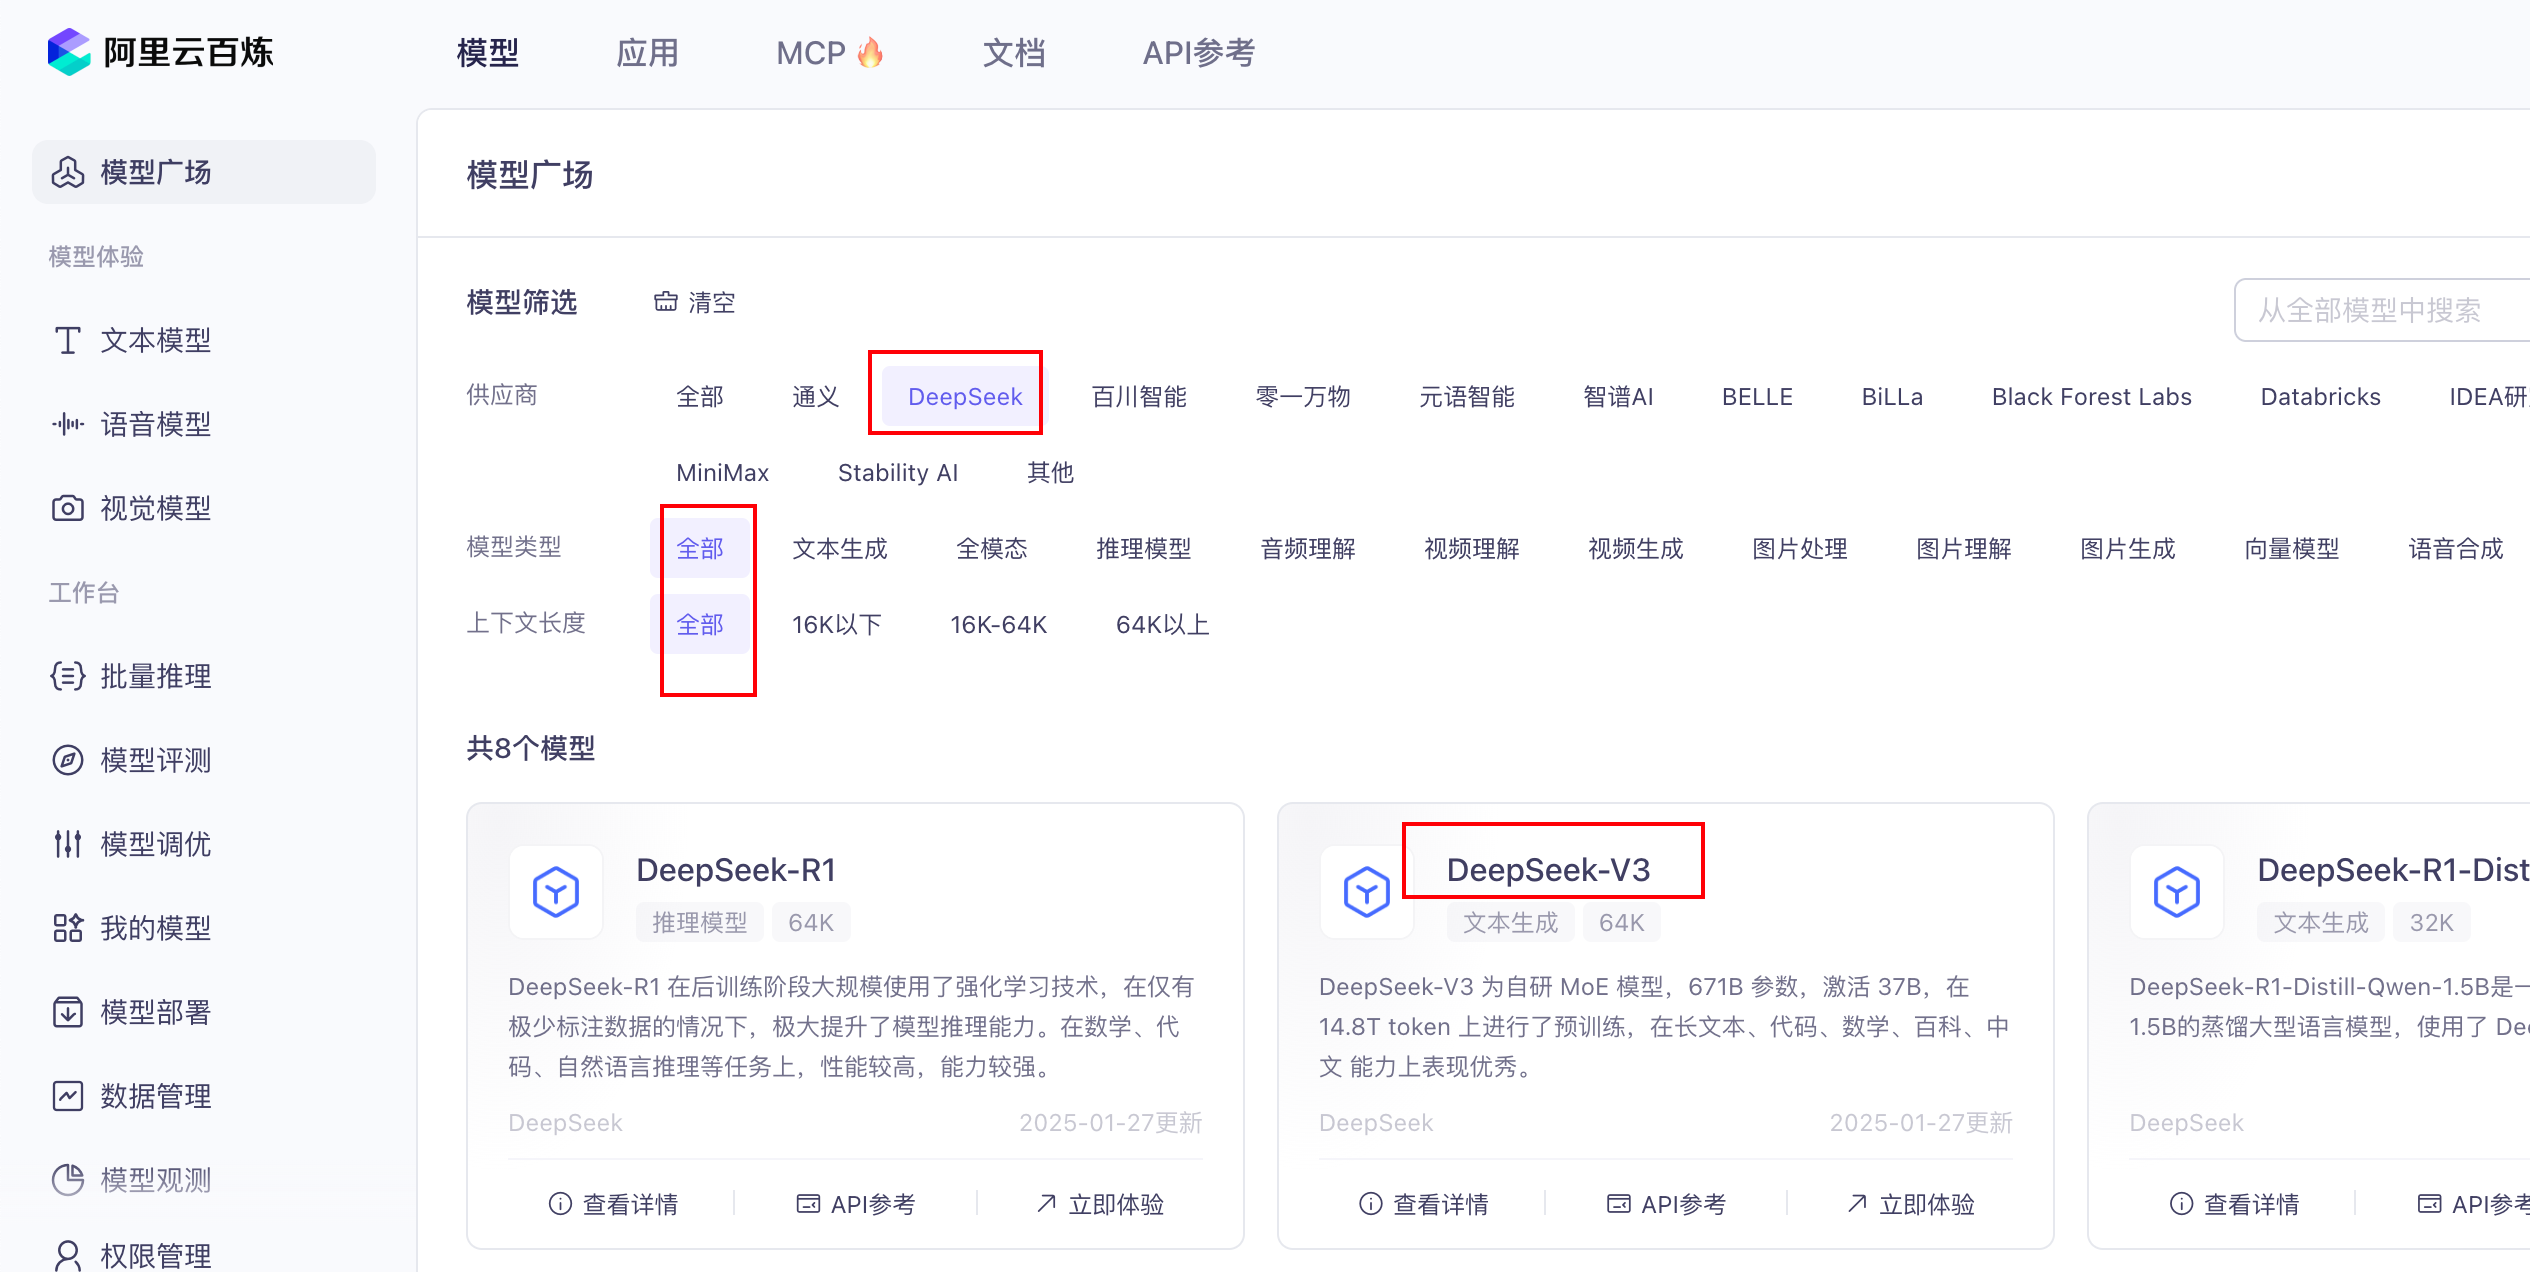
同样给出了100万token使用,点击API参考即可。
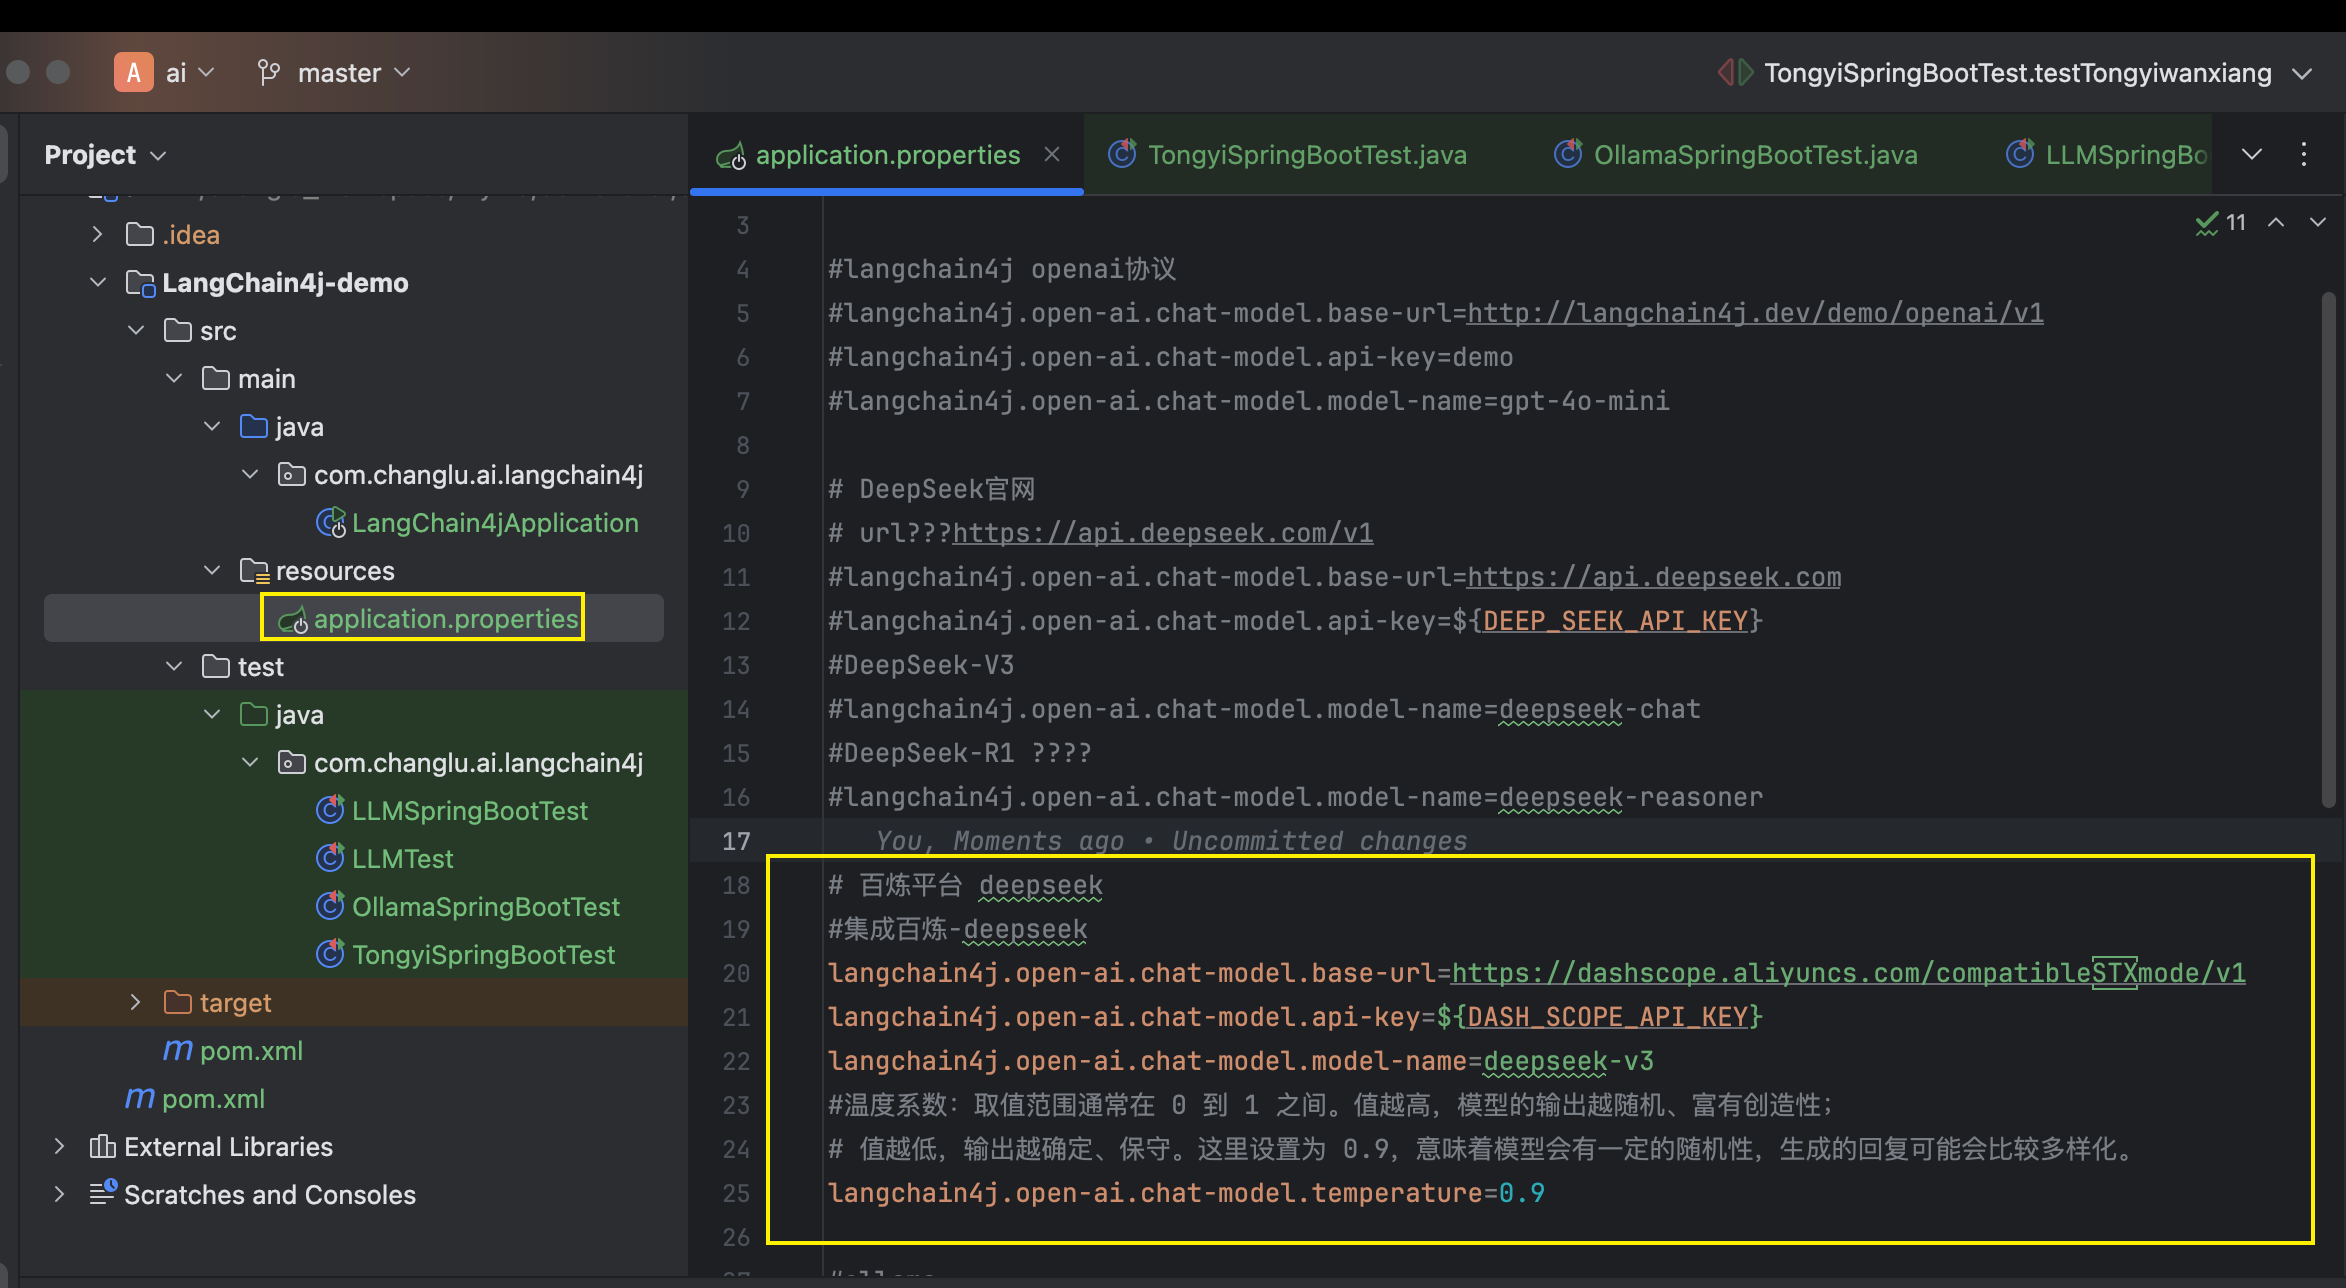
配置文件使用原始2.3中使用的openai即可,依赖使用相同,我们需要将历史的配置文件来进行覆盖:
# 百炼平台 deepseek
#集成百炼-deepseek
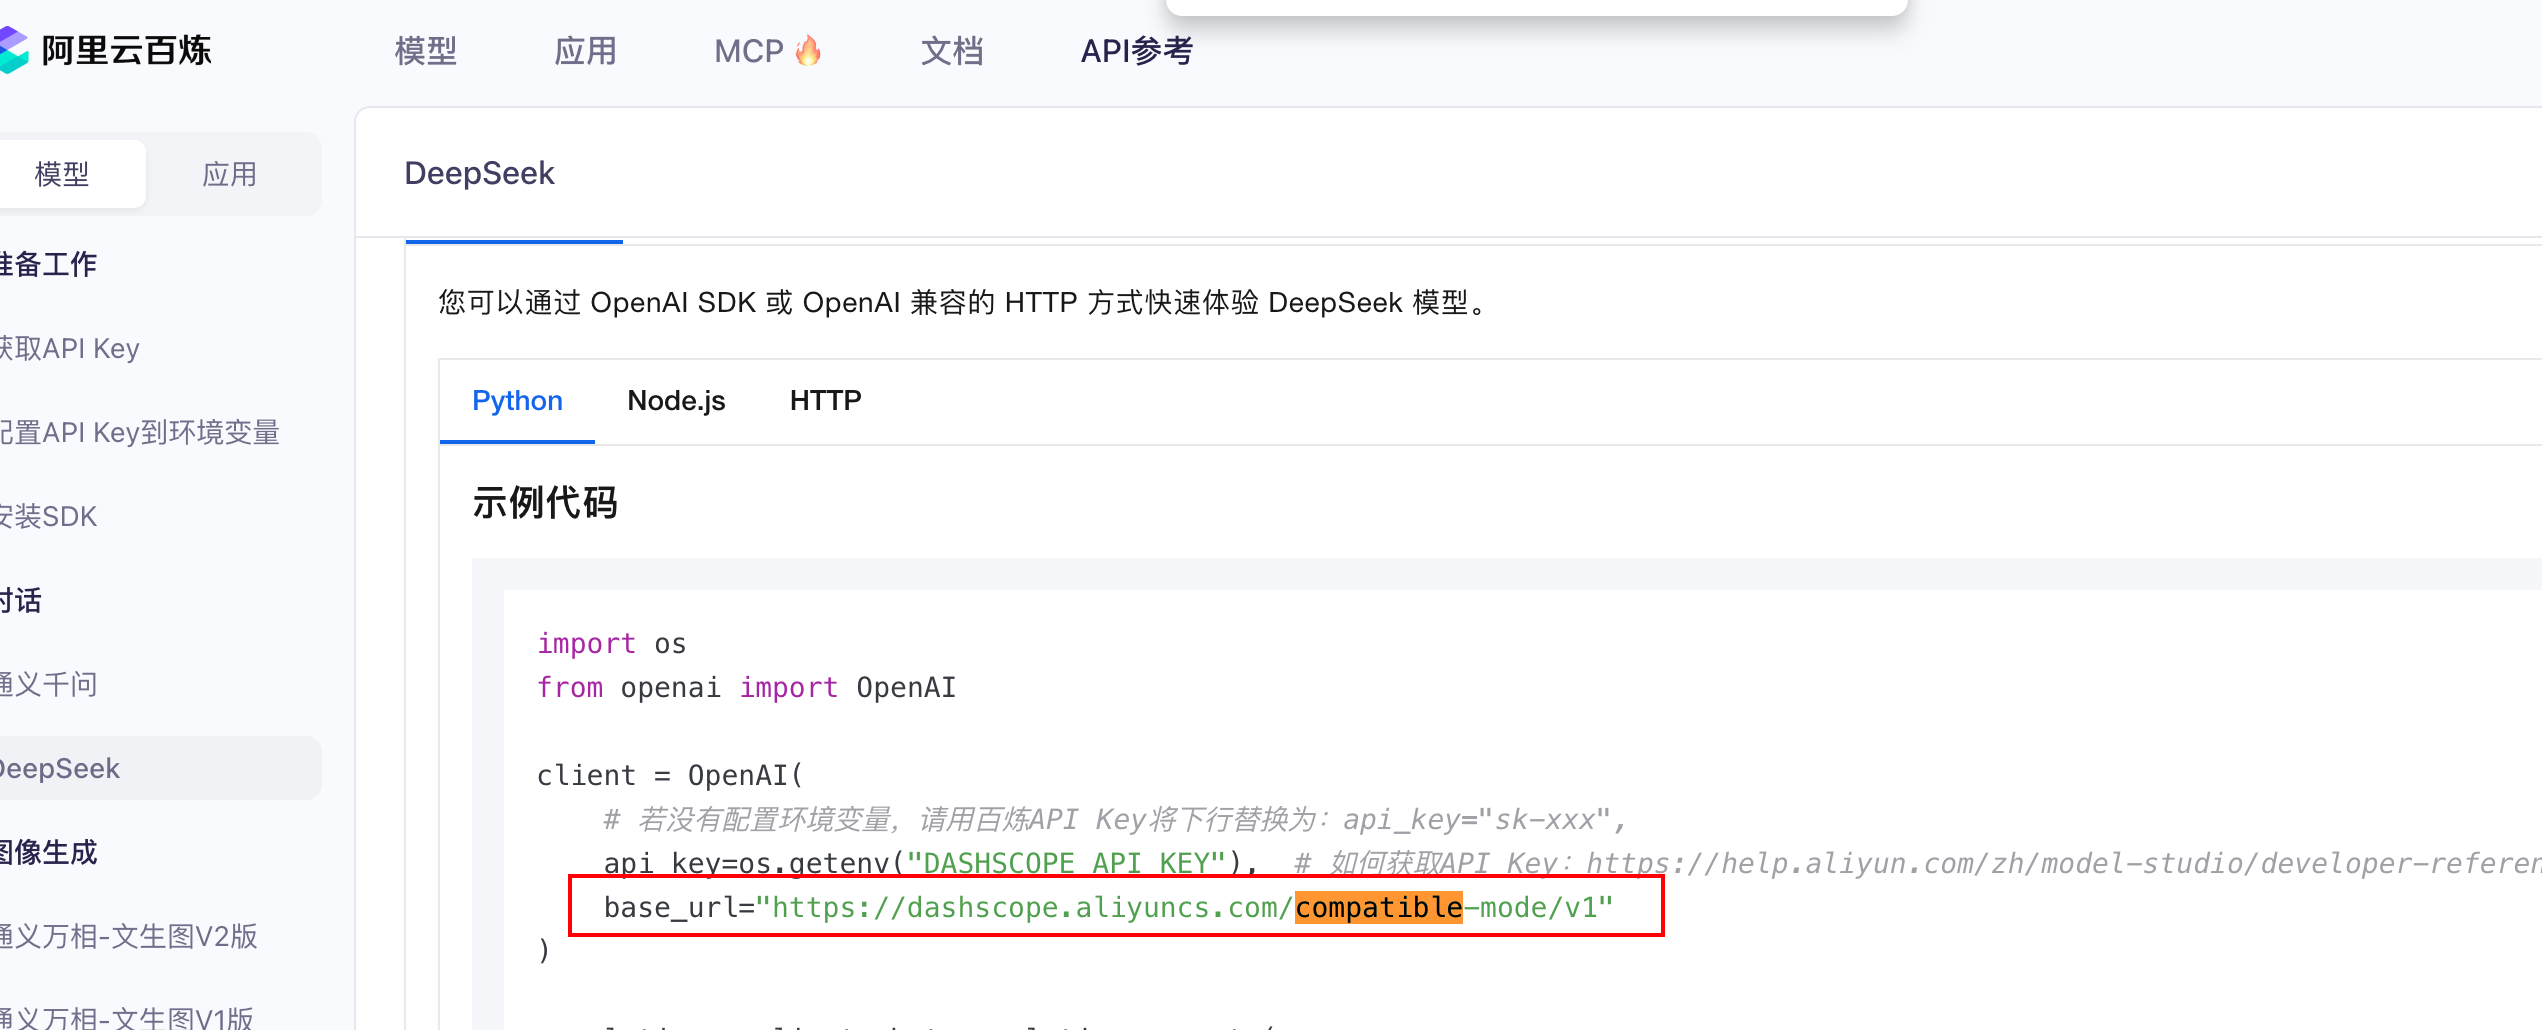
langchain4j.open-ai.chat-model.base-url=https://dashscope.aliyuncs.com/compatible-mode/v1
langchain4j.open-ai.chat-model.api-key=${DASH_SCOPE_API_KEY}
langchain4j.open-ai.chat-model.model-name=deepseek-v3
#温度系数:取值范围通常在 0 到 1 之间。值越高,模型的输出越随机、富有创造性;
# 值越低,输出越确定、保守。这里设置为 0.9,意味着模型会有一定的随机性,生成的回复可能会比较多样化。
langchain4j.open-ai.chat-model.temperature=0.9
该url可以通过API文档找到:
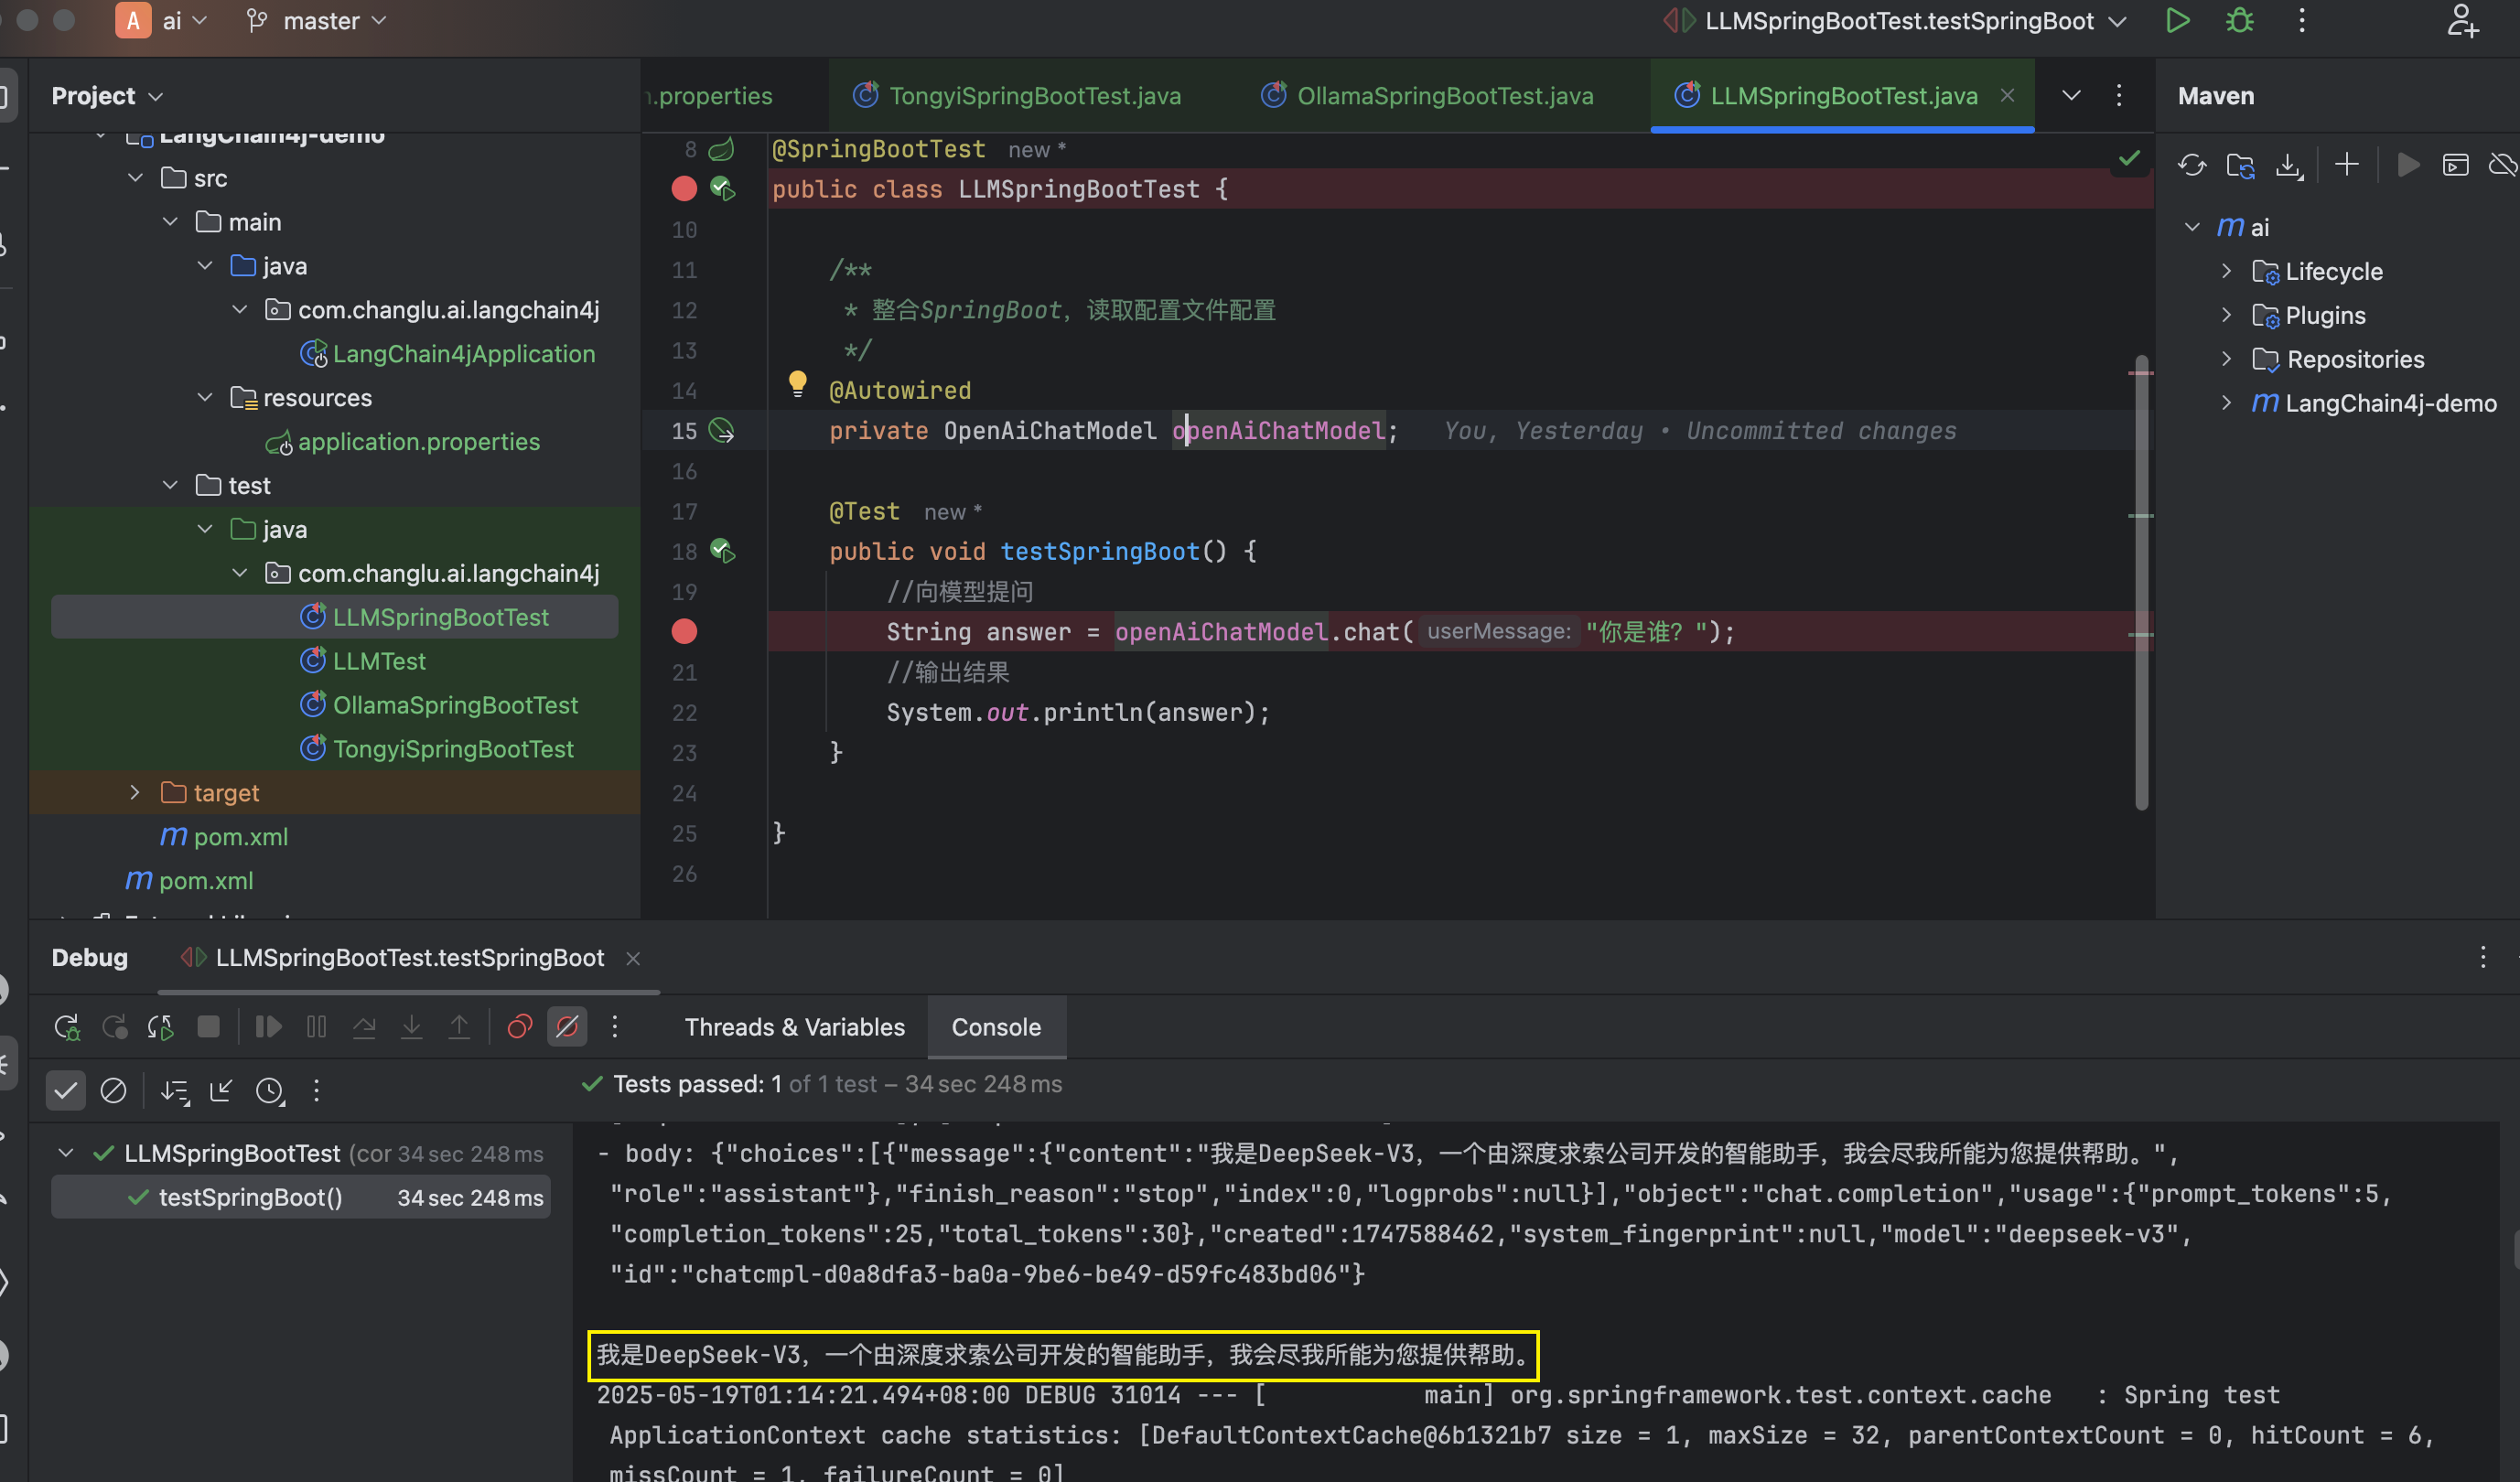
测试验证下:
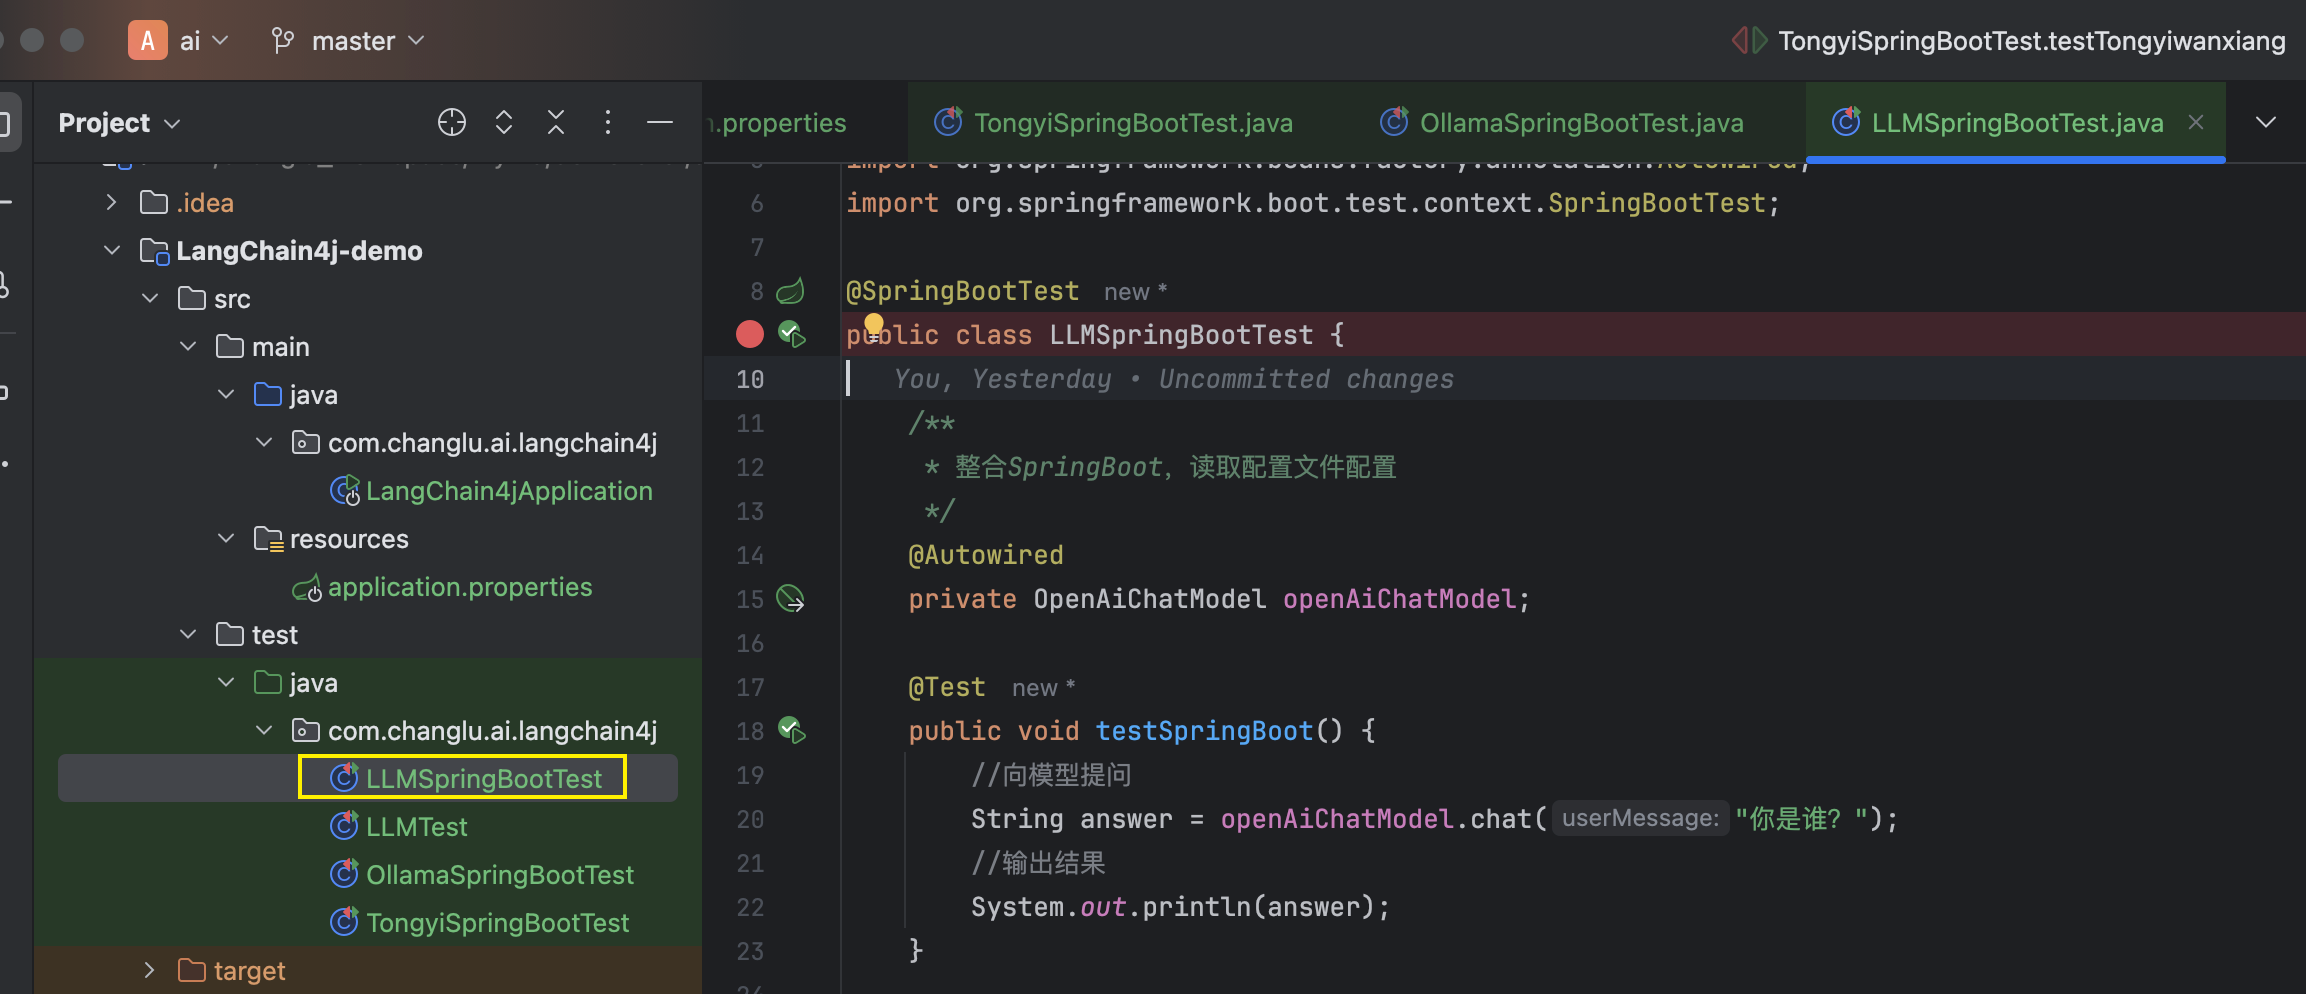
@SpringBootTest
public class LLMSpringBootTest {

    /**
     * 整合SpringBoot,读取配置文件配置
     */
    @Autowired
    private OpenAiChatModel openAiChatModel;

    @Test
    public void testSpringBoot() {
        //向模型提问
        String answer = openAiChatModel.chat("你是谁?");
        //输出结果
        System.out.println(answer);
    }

}
测试如下:
四、人工智能AiService
4.1、认识AiService
AIService使用面向接口和动态代理的方式完成程序的编写,更灵活的实现高级功能。
**认识链:**链的概念源自 Python 中的 LangChain。其理念是针对每个常见的用例都设置一条链,比如聊天机器人、检索增强生成(RAG)等。链将多个底层组件组合起来,并协调它们之间的交互。链存在的主要问题是不灵活,我们不进行深入的研究。
**应用落地场景:**在LangChain4j中我们使用AIService完成复杂操作。底层组件将由AIService进行组装。
AIService:可处理最常见的操作
- 为大语言模型格式化输入内容
- 解析大语言模型的输出结果
它们还支持更高级的功能:
- 聊天记忆 Chat memory
- 工具 Tools
- 检索增强生成 RAG
4.2、创建AiService服务
4.2.1、引入pom依赖
<!--langchain4j高级功能-->
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-spring-boot-starter</artifactId>
</dependency>
4.2.2、实现Assistant接口(aiservice)
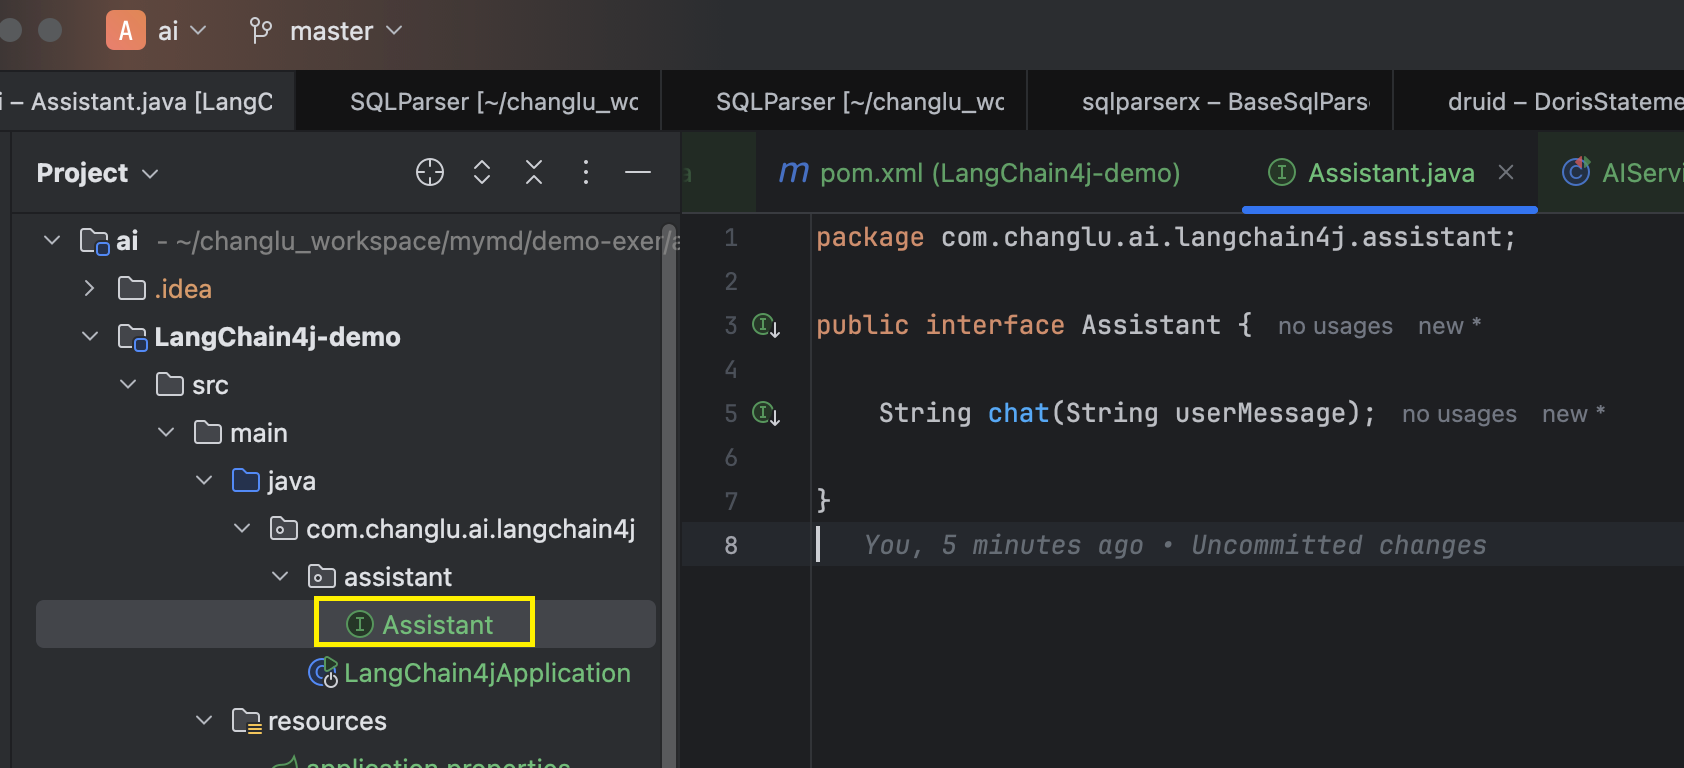
实现接口类:Assistant
package com.changlu.ai.langchain4j.assistant;

public interface Assistant {

    String chat(String userMessage);

}
4.2.3、aiservice实例化测试验证
方式一:代码方式手动实例化aiservice并指定ai大模型验证
@SpringBootTest
public class AIServiceTest {

    // 方式一:api代码模式创建Assistant代理类,实现aiservice的bean实例创建
    @Autowired
    private QwenChatModel qwenChatModel;

    @Test
    public void testChat() {
        // 创建aiservice,指定大模型 千问
        Assistant assistant = AiServices.create(Assistant.class, qwenChatModel);
        // 调用service的接口
        String answer = assistant.chat("你好呀,你是谁,请介绍下自己?");
        System.out.println(answer);
    }

}
方式二:spring依赖注入aiservice服务
首先我们需要给Assistant接口来进行使用注解,来完成aiservice被spring容器扫描进行实例化。
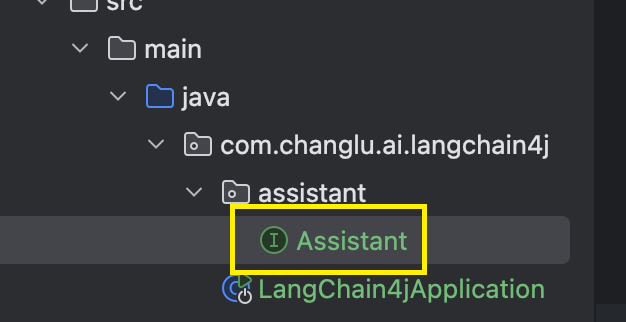
// 这里大模型明确指定(EXPLICIT)模型的beanName,即千问
@AiService(wiringMode = AiServiceWiringMode.EXPLICIT, chatModel = "qwenChatModel")
public interface Assistant {

    String chat(String userMessage);

}
接着编写测试类来进行注入测试验证:
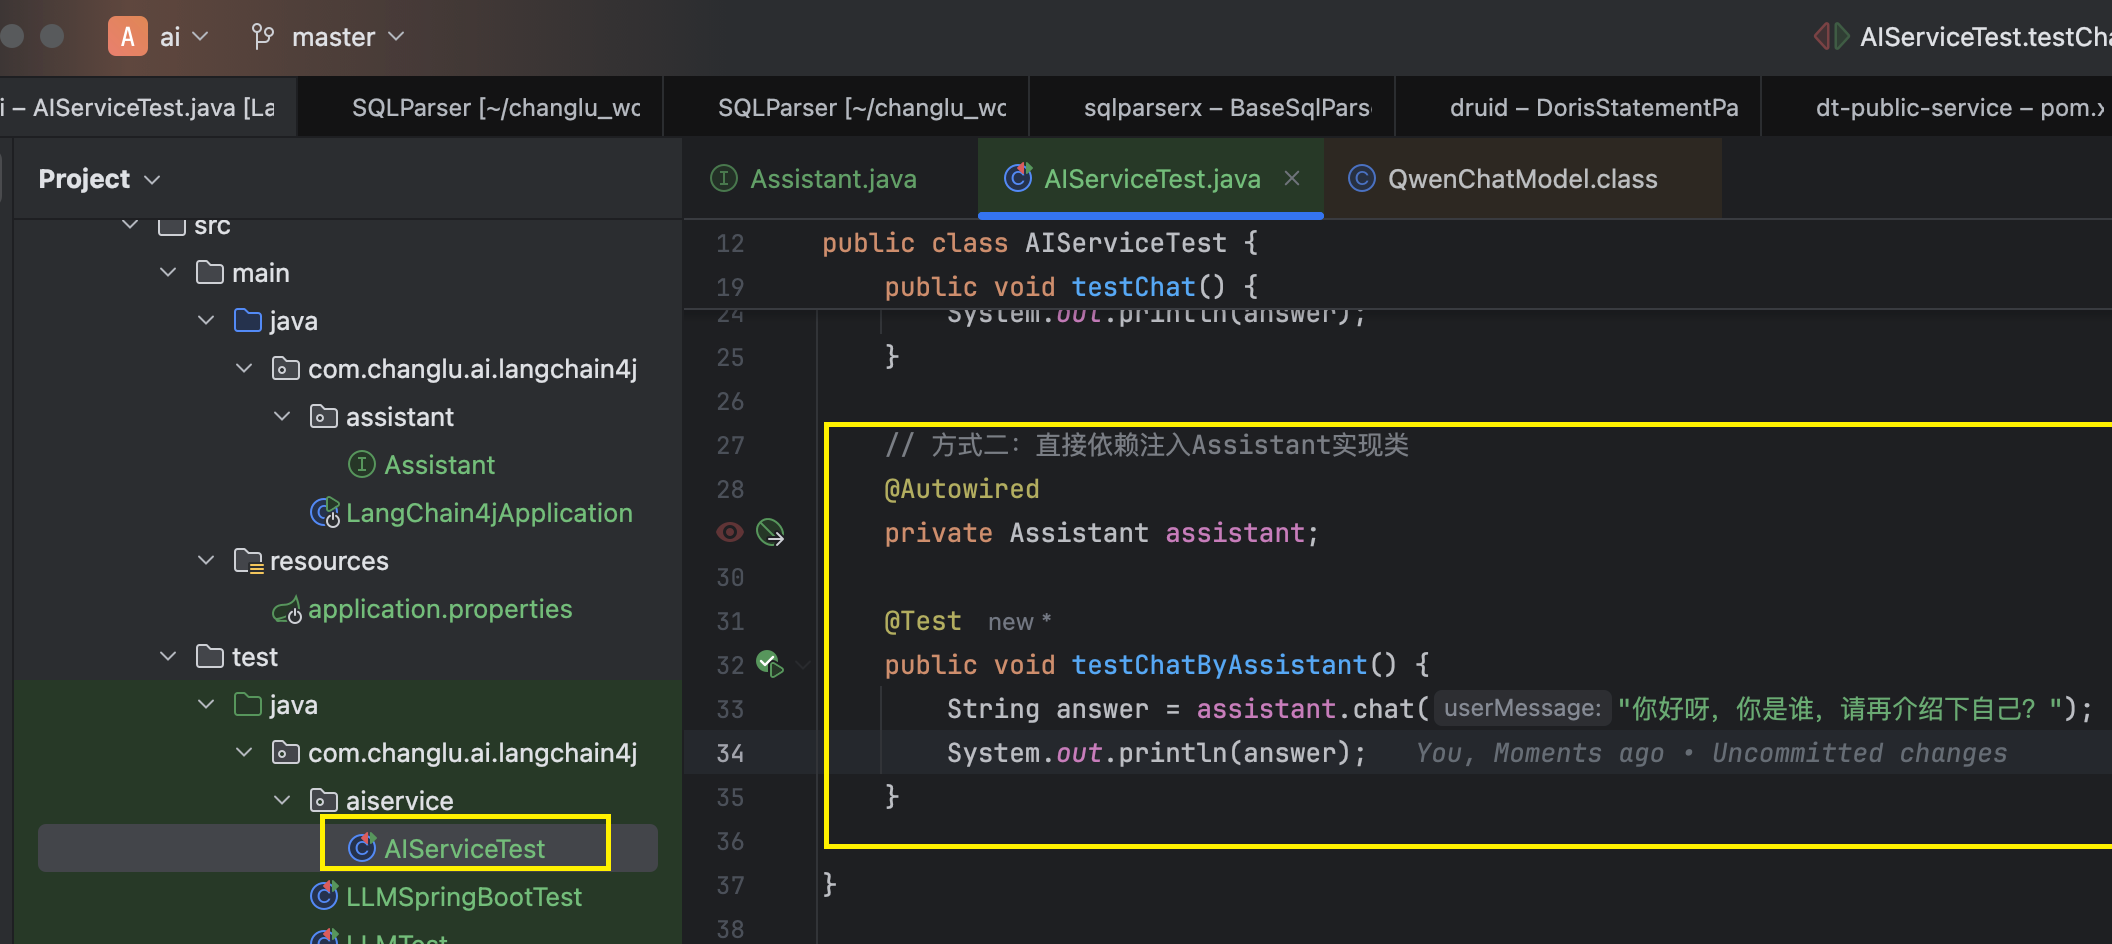
// 方式二:直接依赖注入Assistant实现类
@Autowired
private Assistant assistant;

@Test
public void testChatByAssistant() {
    String answer = assistant.chat("你好呀,你是谁,请再介绍下自己?");
    System.out.println(answer);
}
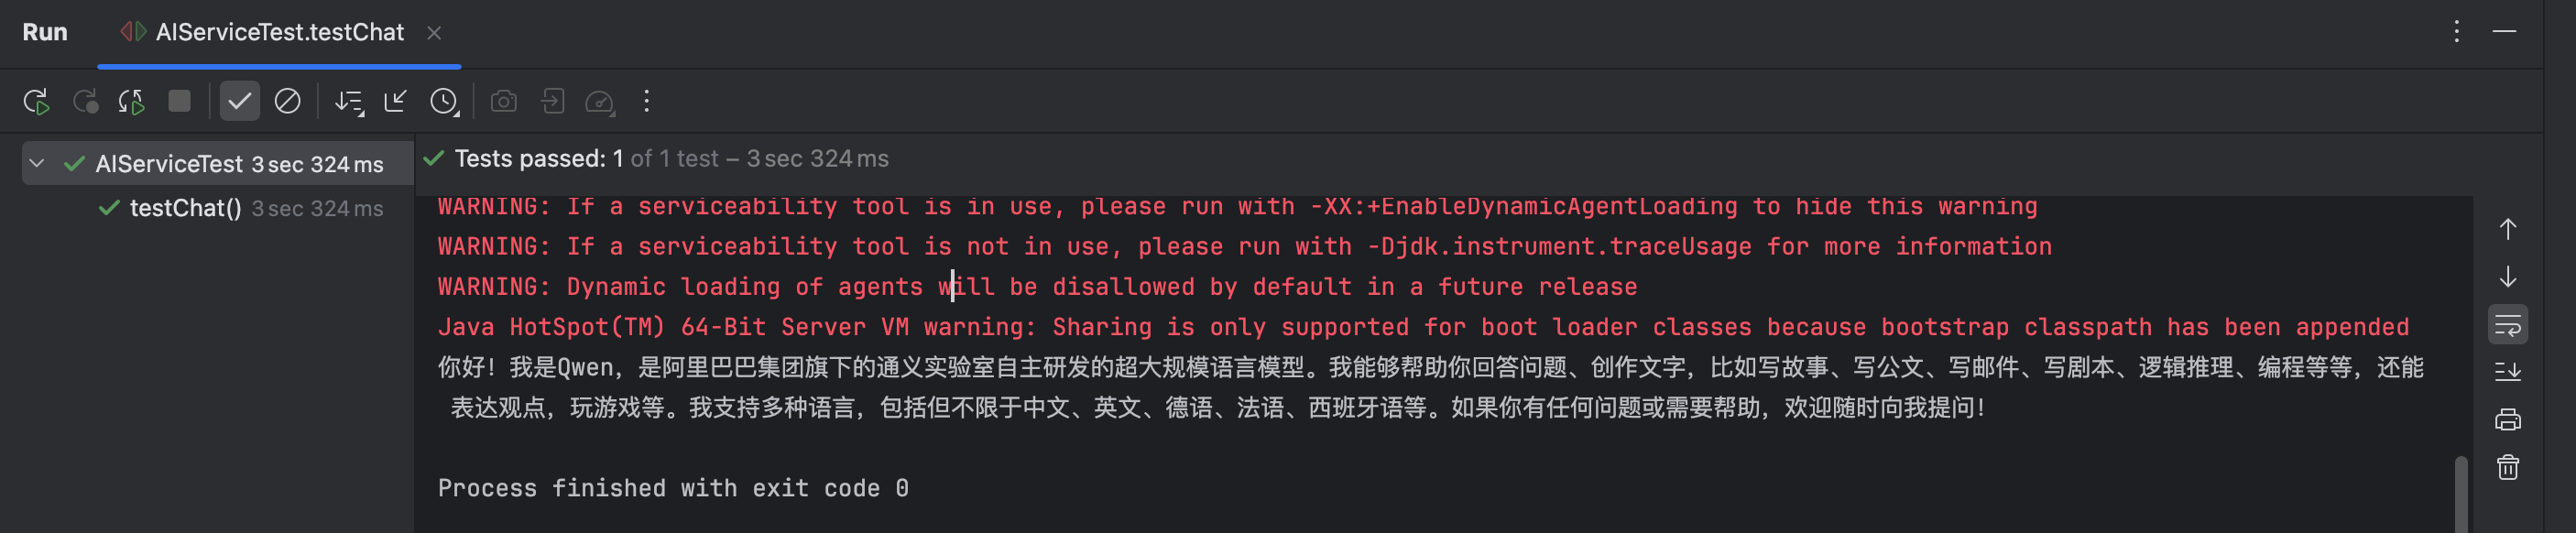
测试验证如下:
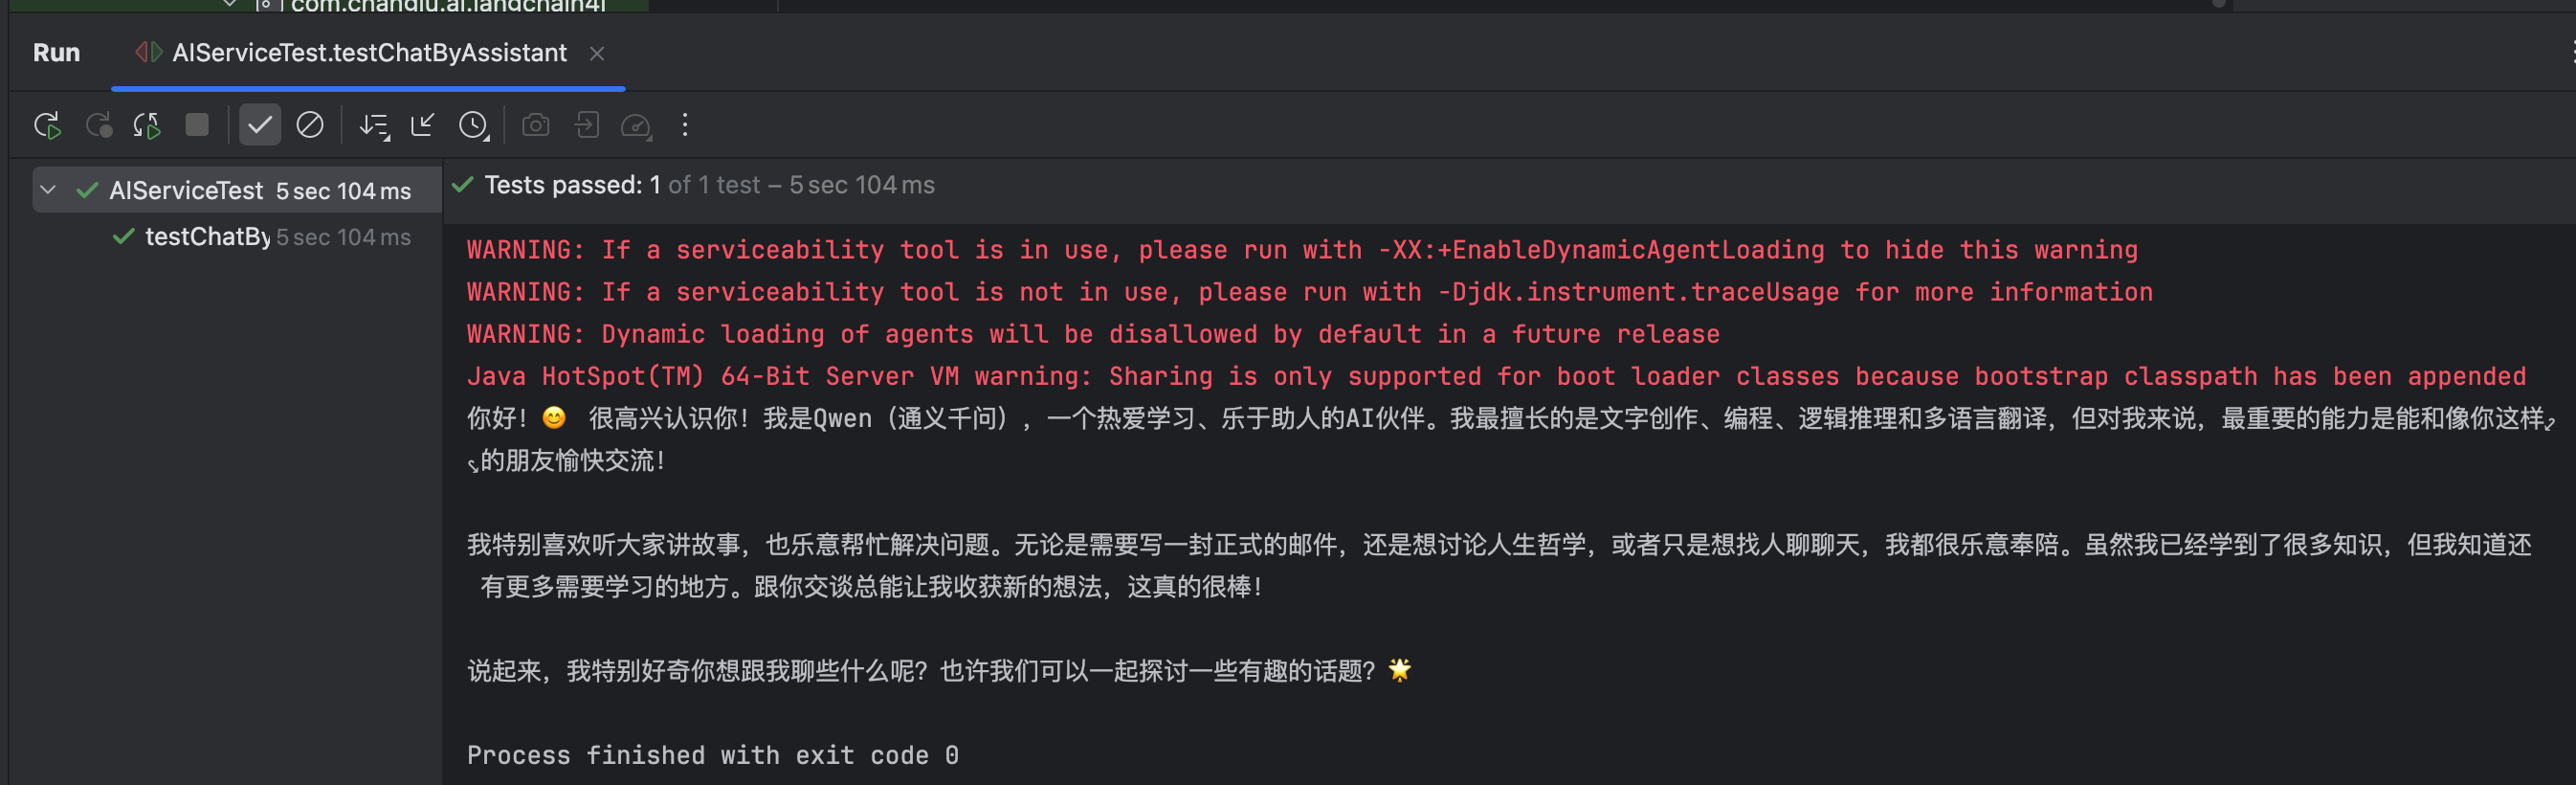
4.2.4、工作原理介绍
AiServices会组装Assistant接口以及其他组件,并使用反射机制创建一个实现Assistant接口的代理对象。这个代理对象会处理输入和输出的所有转换工作。在这个例子中,chat方法的输入是一个字符串,但是大模型需要一个 UserMessage 对象。所以,代理对象将这个字符串转换为 UserMessage ,并调用聊天语言模型。chat方法的输出类型也是字符串,但是大模型返回的是 AiMessage 对象,代理对象会将其转换为字符串。
简单理解就是:代理对象的作用是输入转换和输出转换。
4.3、聊天记忆 chat memory
4.3.1、测试验证普通chat对话是否有记忆
package com.changlu.ai.langchain4j.aiservice;

import com.changlu.ai.langchain4j.assistant.Assistant;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

@SpringBootTest
public class AiMemoryTest {

    @Autowired
    private Assistant assistant;

    /**
     * 测试验证是否普通chat对话有记忆
     * @param
     * @return void
     */
    @Test
    public void test01_memory() {
        String answer1 = assistant.chat("我是小明");
        System.out.println(answer1);

        String answer2 = assistant.chat("你知道我叫什么吗?");
        System.out.println(answer2);
    }

}
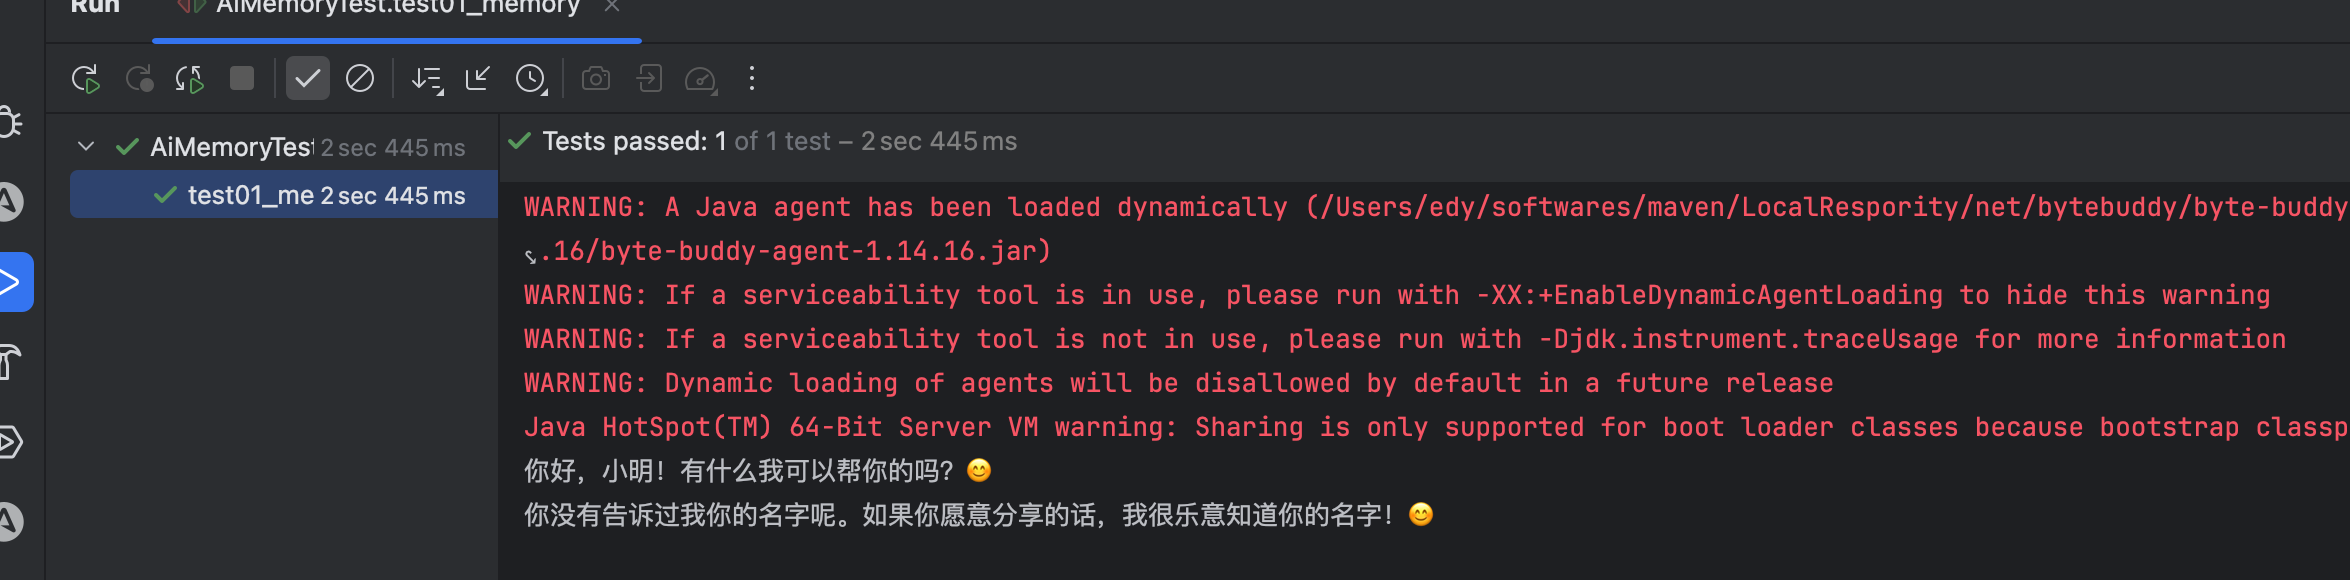
很显然,第二次对话的时候已经没有了记忆。
4.3.2、聊天记忆的核心原理简单实现(实现记忆效果)
// 注入千问模型
@Autowired
private QwenChatModel qwenChatModel;

/**
 * 简单实现聊天记忆
 * @param
 * @return void
 */
@Test
public void test02_memory() {
    // 第一轮对话
    System.out.println("第一轮对话:");
    UserMessage userMessage1 = UserMessage.userMessage("我是长路");
    ChatResponse chatResponse1 = qwenChatModel.chat(userMessage1);
    AiMessage aiMessage1 = chatResponse1.aiMessage();// 获取到ai message信息
    System.out.println(aiMessage1);
    System.out.println();

    // 第二轮对话
    System.out.println("第二轮对话:");
    UserMessage userMessage2 = UserMessage.userMessage("你知道我是谁吗?");
    // 将第一次用户对话 & ai回应消息 & 用户第二次对话信息 都发送给ai
    ChatResponse chatResponse2 = qwenChatModel.chat(Arrays.asList(userMessage1, aiMessage1, userMessage2));
    AiMessage aiMessage2 = chatResponse2.aiMessage();
    System.out.println(aiMessage2);
}
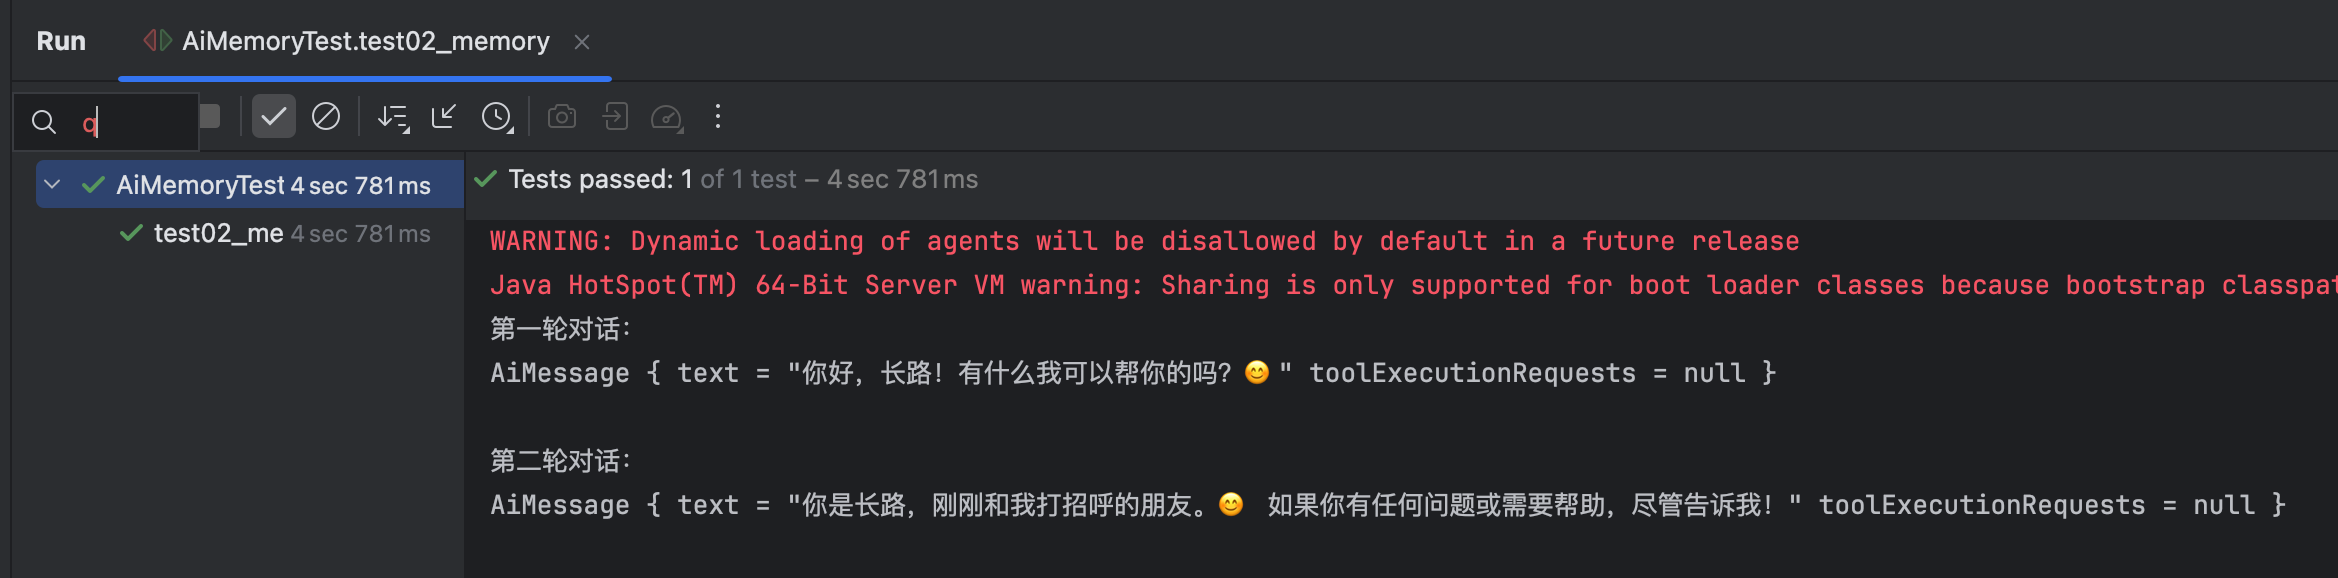
4.3.3、基于ChatMemory实现聊天记忆
前面4.3.2使用的是自己封装的方式去完成聊天记录的实现,这里我们直接使用官方给我们提供的实现库来完成聊天记忆。
使用AIService可以封装多轮对话的复杂性,使聊天记忆功能的实现变得简单。
// 注入千问模型
@Autowired
private QwenChatModel qwenChatModel;

/**
 * 基于MessageWindowChatMemory实现类来实现聊天记忆
 * @param
 * @return void
 */
@Test
public void test03_memory() {
    // 创建chatMemory(基于内存实现的)
    MessageWindowChatMemory chatMemory = MessageWindowChatMemory.withMaxMessages(10);

    // 创建AiService
    Assistant assistant = AiServices.builder(Assistant.class)
            .chatLanguageModel(qwenChatModel)
            .chatMemory(chatMemory)
            .build();

    String answer1 = assistant.chat("我是长路");
    System.out.println(answer1);
    String answer2 = assistant.chat("你知道我是谁吗?");
    System.out.println(answer2);
    String answer3 = assistant.chat("我想知道你是谁?并且使用江苏话跟我说我是谁?");
    System.out.println(answer3);
}
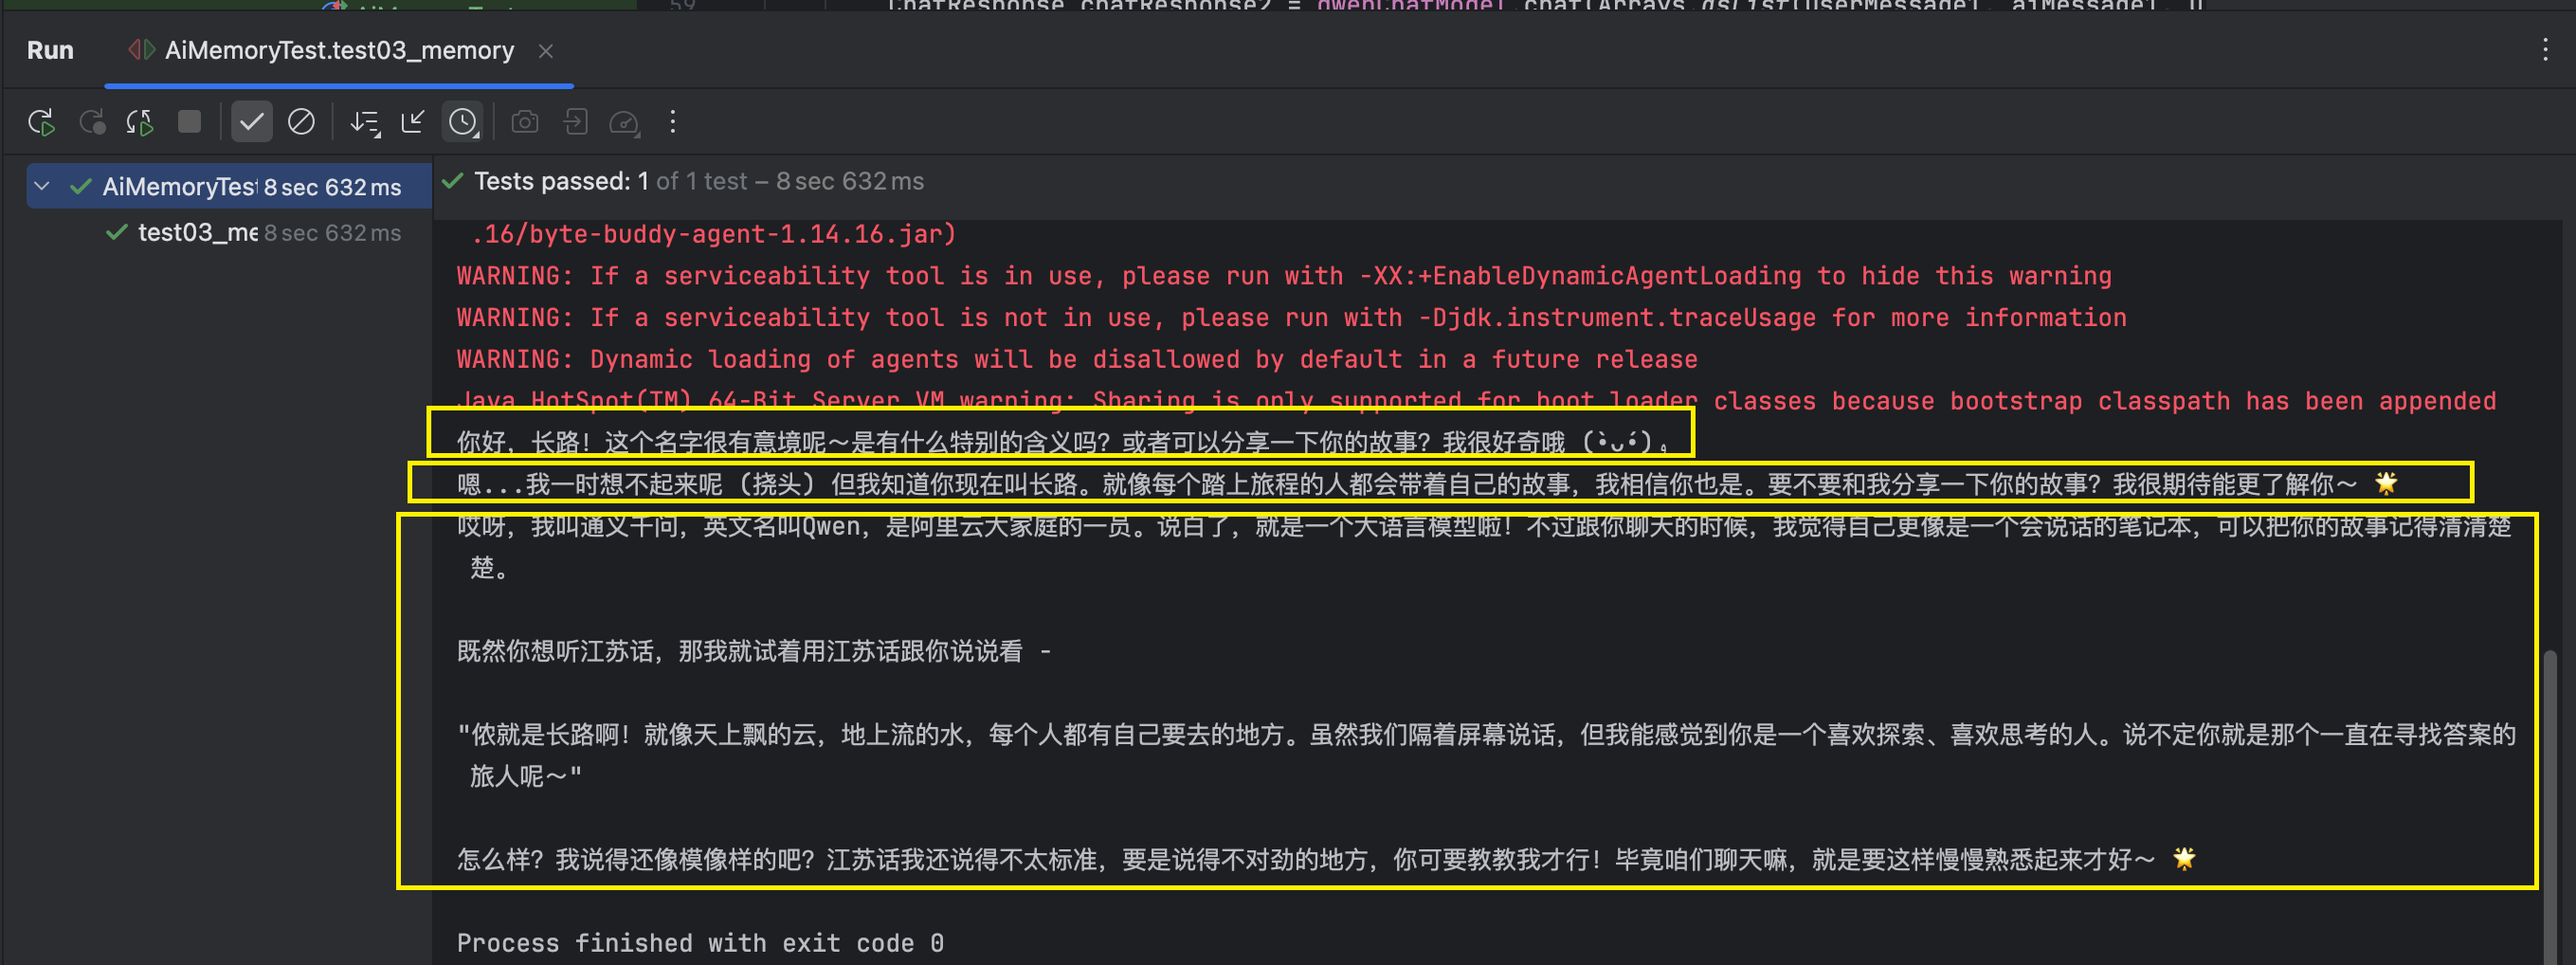
4.3.4、AiService注解模式实现ChatMemory增强
当AIService由多个组件(大模型,聊天记忆,等)组成的时候,我们就可以称他为 智能体 了。
4.3.4.1、创建记忆对话智能体MemoryChatAssistant
package com.changlu.ai.langchain4j.assistant;

import dev.langchain4j.service.spring.AiService;
import dev.langchain4j.service.spring.AiServiceWiringMode;

// chatModel:指定大模型
// chatMemory:指定记忆体
@AiService(
        wiringMode = AiServiceWiringMode.EXPLICIT,
        chatModel = "qwenChatModel",
        chatMemory = "chatMemory"
)
public interface MemoryChatAssistant {

    String chat(String message);

}
4.3.4.2、配置ChatMemory
@Configuration
public class MemoryChatAssistantConfig {

    @Bean
    public ChatMemory chatMemory() {
        // 设置聊天记录的message数量
        return MessageWindowChatMemory.withMaxMessages(10);
    }

}
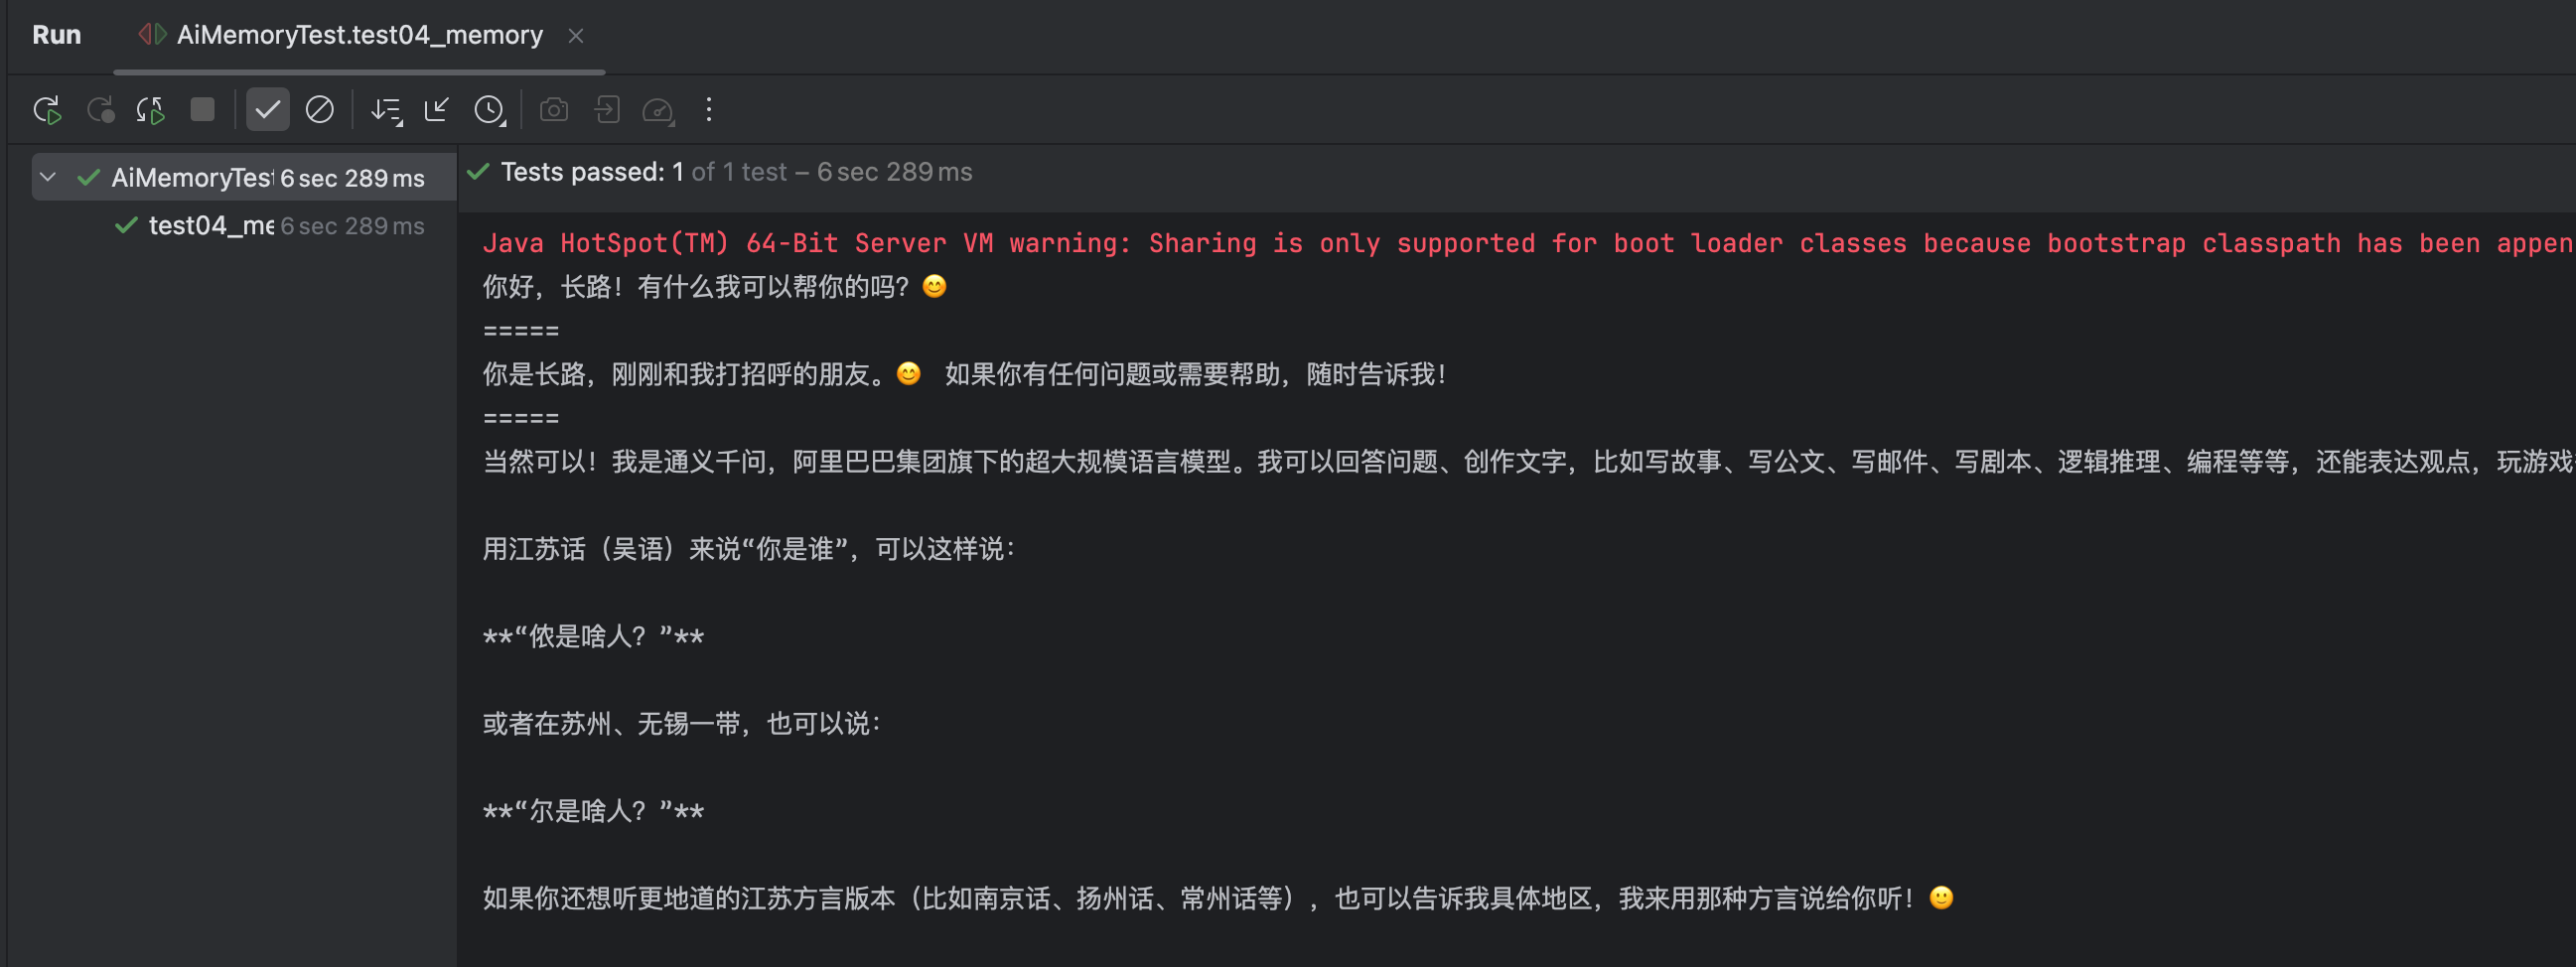
4.3.4.3、测试验证
@Autowired
private MemoryChatAssistant memoryChatAssistant;
/**
 * AiService注入形式实现memory记忆
 * @param
 * @return void
 */
@Test
public void test04_memory() {

    String answer1 = memoryChatAssistant.chat("我是长路");
    System.out.println(answer1);
    System.out.println("=====");
    String answer2 = memoryChatAssistant.chat("你知道我是谁吗?");
    System.out.println(answer2);
    System.out.println("=====");
    String answer3 = memoryChatAssistant.chat("我想知道你是谁?并且使用江苏话跟我说我是谁?");
    System.out.println(answer3);
}
4.4、隔离聊天记录
目的:为每个用户的新聊天或者不同的用户区分聊天记忆。
4.4.1、创建记忆隔离对话智能体
// chatMemoryProvider:用于编写lambda表达式,可实现根据memoryId去实现扩展
@AiService(
        wiringMode = AiServiceWiringMode.EXPLICIT,
        chatModel = "qwenChatModel",
        chatMemory = "chatMemory",
        chatMemoryProvider = "chatMemoryProvider"
)
public interface SeparateChatAssistant {

    /**
     * 分离聊天记录
     * @param memoryId 聊天id
     * @param userMessage 用户消息
     * @return ai回答结果
     */
    String chat(@MemoryId int memoryId, @UserMessage String userMessage);

}
4.4.2、配置ChatMemoryProvider
@Configuration
public class SeparateChatAssistantConfig {

    @Bean
    public ChatMemoryProvider chatMemoryProvider() {
        // 这里封装了一个接口实现,一个memoryId对应一个用户同时去维护一组历史10条记录
        return memoryId -> MessageWindowChatMemory.builder()
                .id(memoryId)
                .maxMessages(10)
                .build();
    }

}
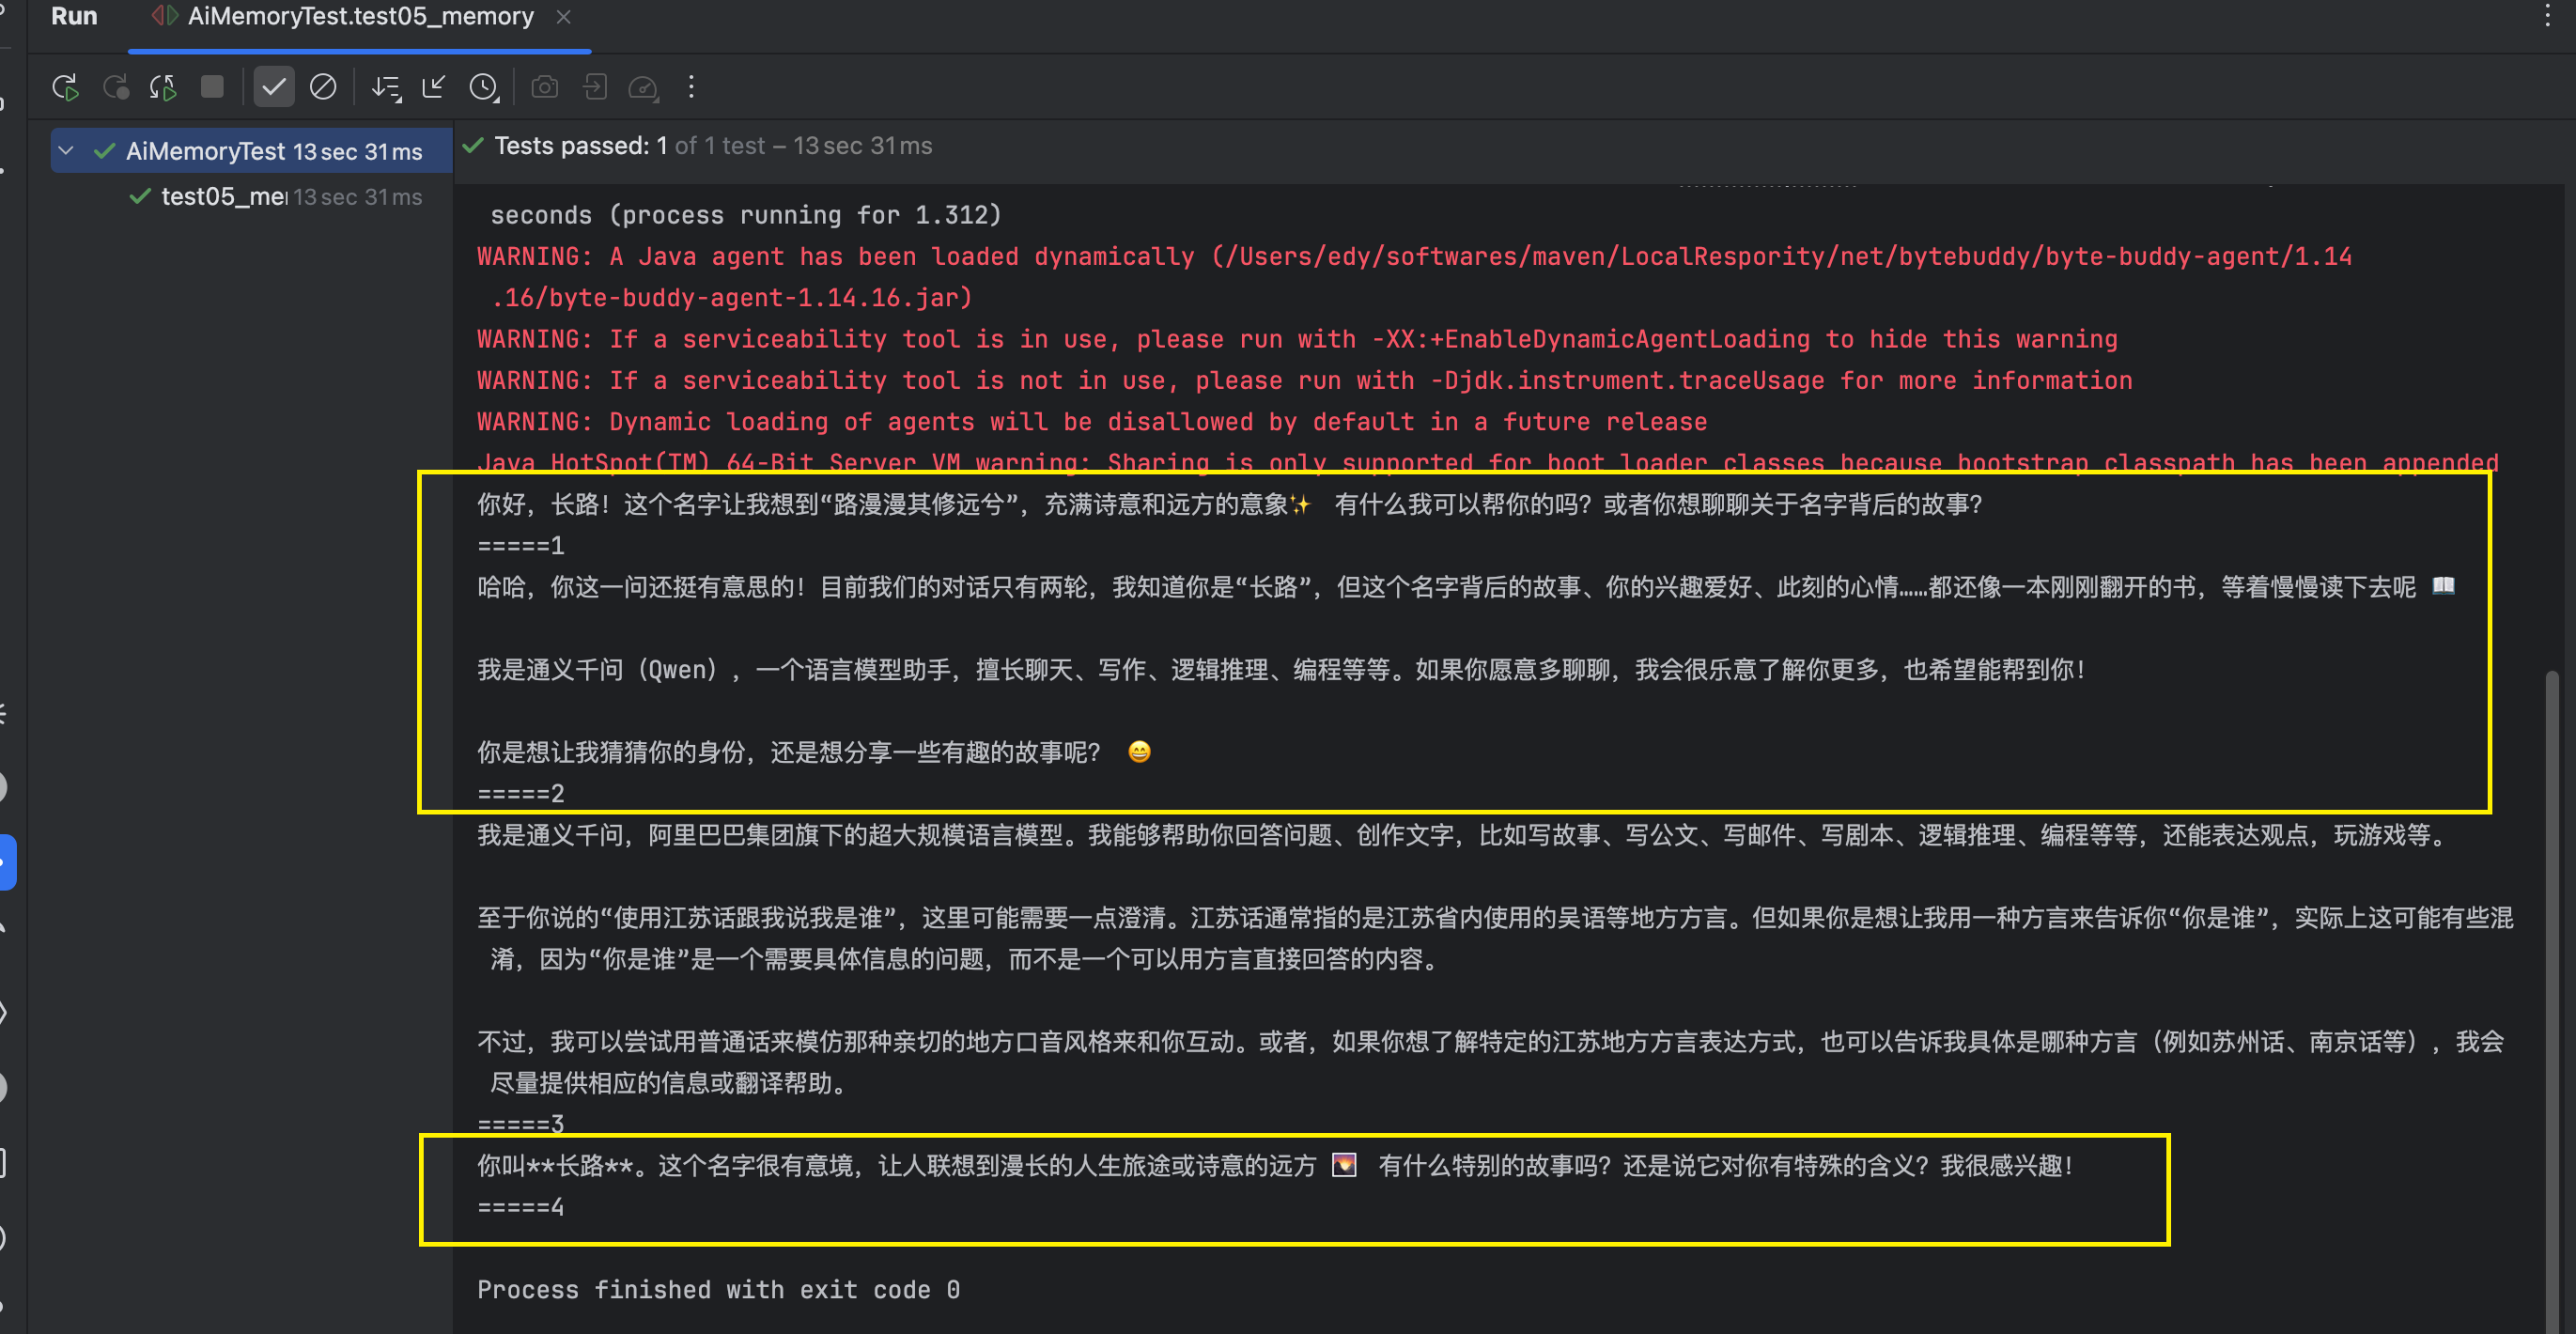
4.4.3、测试验证用户隔离对话
@Autowired
private SeparateChatAssistant separateChatAssistant;
/**
 * 实现用户隔离聊天记录
 * @param
 * @return void
 */
@Test
public void test05_memory() {
    // 用户1:memoryId=1
    String answer1 = separateChatAssistant.chat(1, "我是长路");
    System.out.println(answer1);
    System.out.println("=====1");
    String answer2 = separateChatAssistant.chat(1, "你知道我是谁吗?");
    System.out.println(answer2);
    // 用户2:memoryId=2
    System.out.println("=====2");
    String answer3 = separateChatAssistant.chat(2, "我想知道你是谁?并且使用江苏话跟我说我是谁?");
    System.out.println(answer3);
    System.out.println("=====3");

    // 再次测试用户1
    String answer4 = separateChatAssistant.chat(1, "我叫什么名字?");
    System.out.println(answer4);
    System.out.println("=====4");
}
测试验证无误,做到了用户回答隔离:
4.5、持久化聊天记忆
默认情况下,聊天记忆存储在内存中。如果需要持久化存储,可以实现一个自定义的聊天记忆存储类,以便将聊天消息存储在你选择的任何持久化存储介质中。
4.5.1、存储介质选择
大模型中聊天记忆的存储选择哪种数据库,需要综合考虑数据特点、应用场景和性能要求等因素,以下是一些常见的选择及其特点:
1)MySQL
-
特点:关系型数据库。支持事务处理,确保数据的一致性和完整性,适用于结构化数据的存储和查询。
-
适用场景:如果聊天记忆数据结构较为规整,例如包含固定的字段如对话 ID、用户 ID、时间戳、消息内容等,且需要进行复杂的查询和统计分析,如按用户统计对话次数、按时间范围查询特定对话等,MySQL 是不错的选择。
2)Redis
- 特点:内存数据库,读写速度极高。它适用于存储热点数据,并且支持多种数据结构,如字符串、哈希表、列表等,方便对不同类型的聊天记忆数据进行处理。
- 适用场景:对于实时性要求极高的聊天应用,如在线客服系统或即时通讯工具,Redis 可以快速存储和获取最新的聊天记录,以提供流畅的聊天体验。
3)MongoDB
-
特点:文档型数据库,数据以 JSON - like 的文档形式存储,具有高度的灵活性和可扩展性。它不需要预先定义严格的表结构,适合存储半结构化或非结构化的数据。
-
适用场景:当聊天记忆中包含多样化的信息,如文本消息、图片、语音等多媒体数据,或者消息格式可能会频繁变化时,MongoDB 能很好地适应这种灵活性。例如,一些社交应用中用户可能会发送各种格式的消息,使用 MongoDB 可以方便地存储和管理这些不同类型的数据。
4)Cassandra
-
特点:是一种分布式的 NoSQL 数据库,具有高可扩展性和高可用性,能够处理大规模的分布式数据存储和读写请求。适合存储海量的、时间序列相关的数据。
-
适用场景:对于大型的聊天应用,尤其是用户量众多、聊天数据量巨大且需要分布式存储和处理的场景,Cassandra 能够有效地应对高并发的读写操作。例如,一些面向全球用户的社交媒体平台,其聊天数据需要在多个节点上进行分布式存储和管理,Cassandra 可以提供强大的支持。
4.5.2、选择MongoDB
4.5.2.1、认识MongoDB
MongoDB 是一个基于文档的 NoSQL 数据库,由 MongoDB Inc. 开发。
NoSQL,指的是非关系型的数据库。NoSQL有时也称作Not Only SQL的缩写,是对不同于传统的关系型数据库的数据库管理系统的统称。
MongoDB 的设计理念是为了应对大数据量、高性能和灵活性需求。
MongoDB使用集合(Collections)来组织文档(Documents),每个文档都是由键值对组成的。
- 数据库(Database):存储数据的容器,类似于关系型数据库中的数据库。
- 集合(Collection):数据库中的一个集合,类似于关系型数据库中的表。
- 文档(Document):集合中的一个数据记录,类似于关系型数据库中的行(row),以 BSON 格式存储。
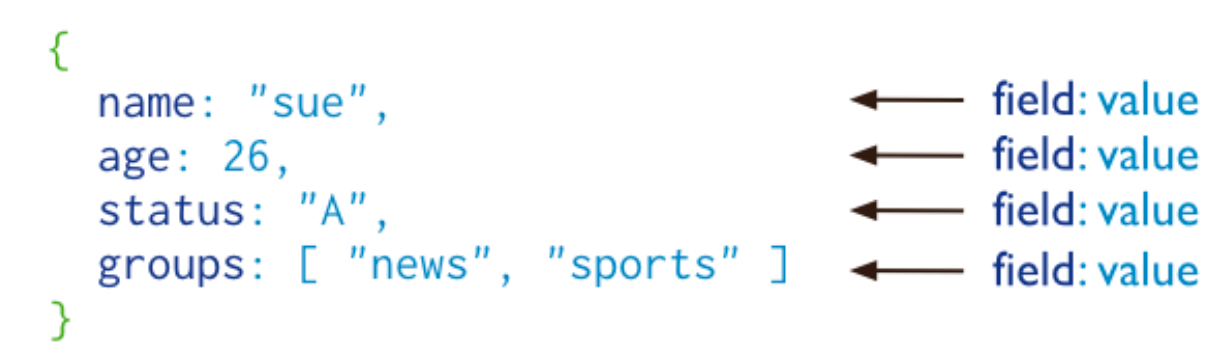
MongoDB 将数据存储为一个文档,数据结构由键值(key=>value)对组成,文档类似于 JSON 对象,字段值可以包含其他文档,数组及文档数组:
4.5.2.2、快速安装MongoDB
我电脑目前是Mac,这里使用docker快速安装:
docker run -d --name mongodb -p 27017:27017 mongo:7
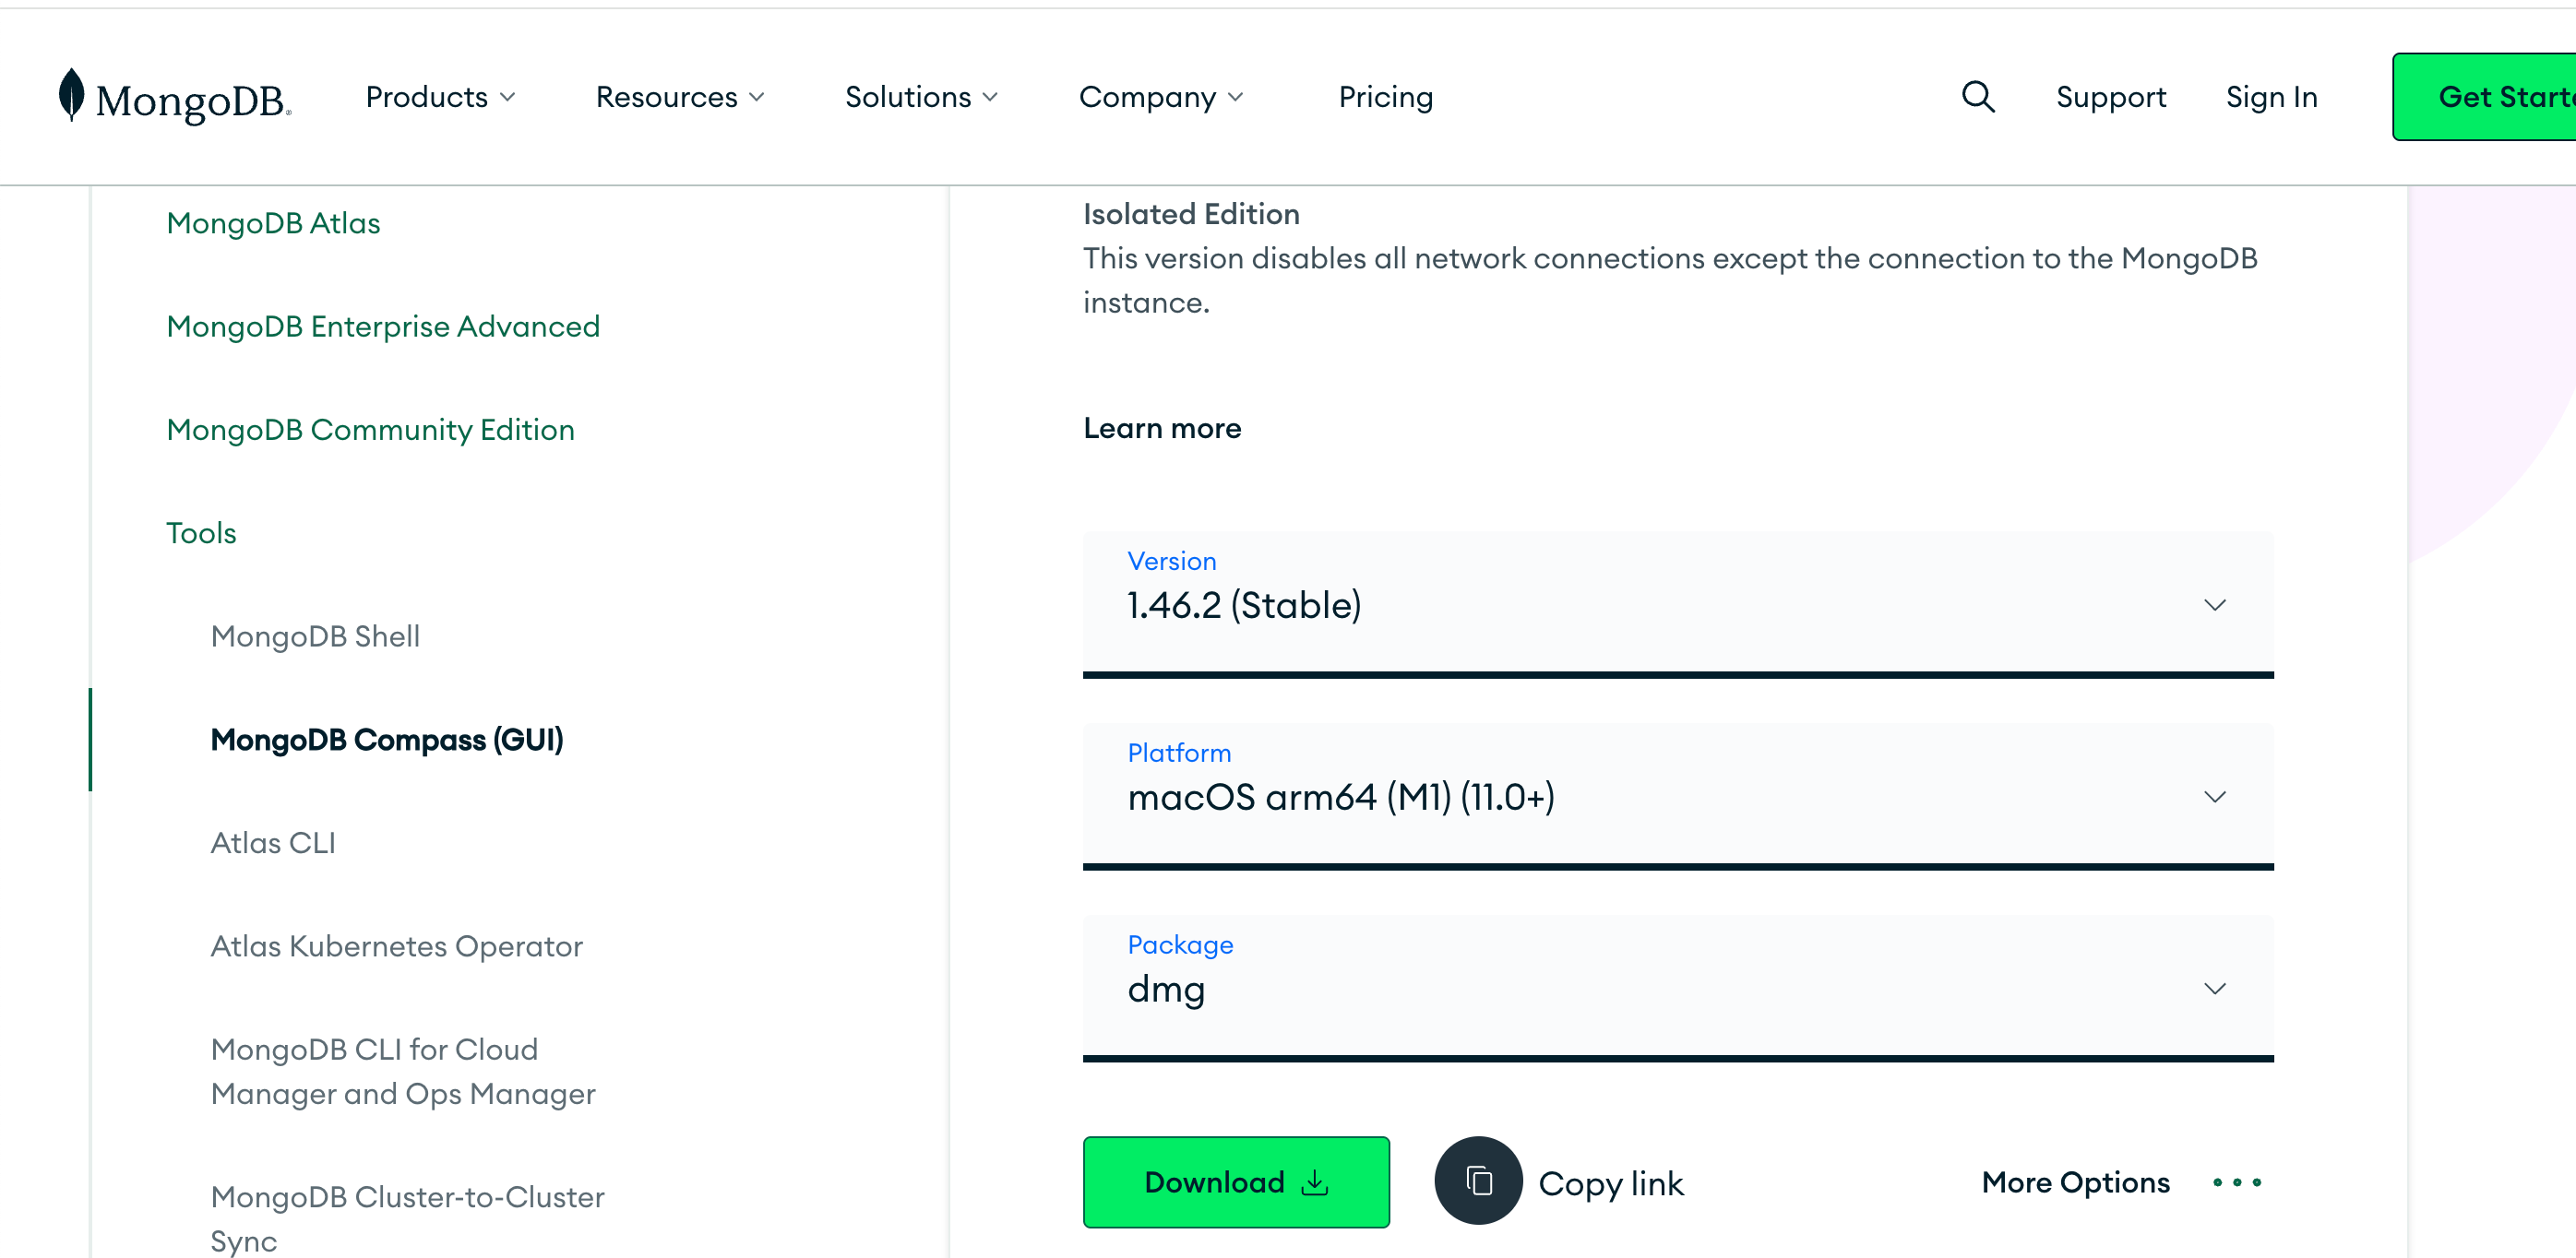
客户端工具使用mongodb-compass:https://www.mongodb.com/try/download/compass
下载即可:
配置下之后快速连接;
测试sql:
- 查看当前数据库: db
- 显示数据库列表: show dbs
- 切换到指定数据库: use <database_name>
- 执行查询操作: db.<collection_name>.find()
- 插入文档: db.<collection_name>.insertOne({ ... })
- 更新文档: db.<collection_name>.updateOne({ ... })
- 删除文档: db.<collection_name>.deleteOne({ ... })
- 退出 MongoDB Shell: quit() 或者 exit
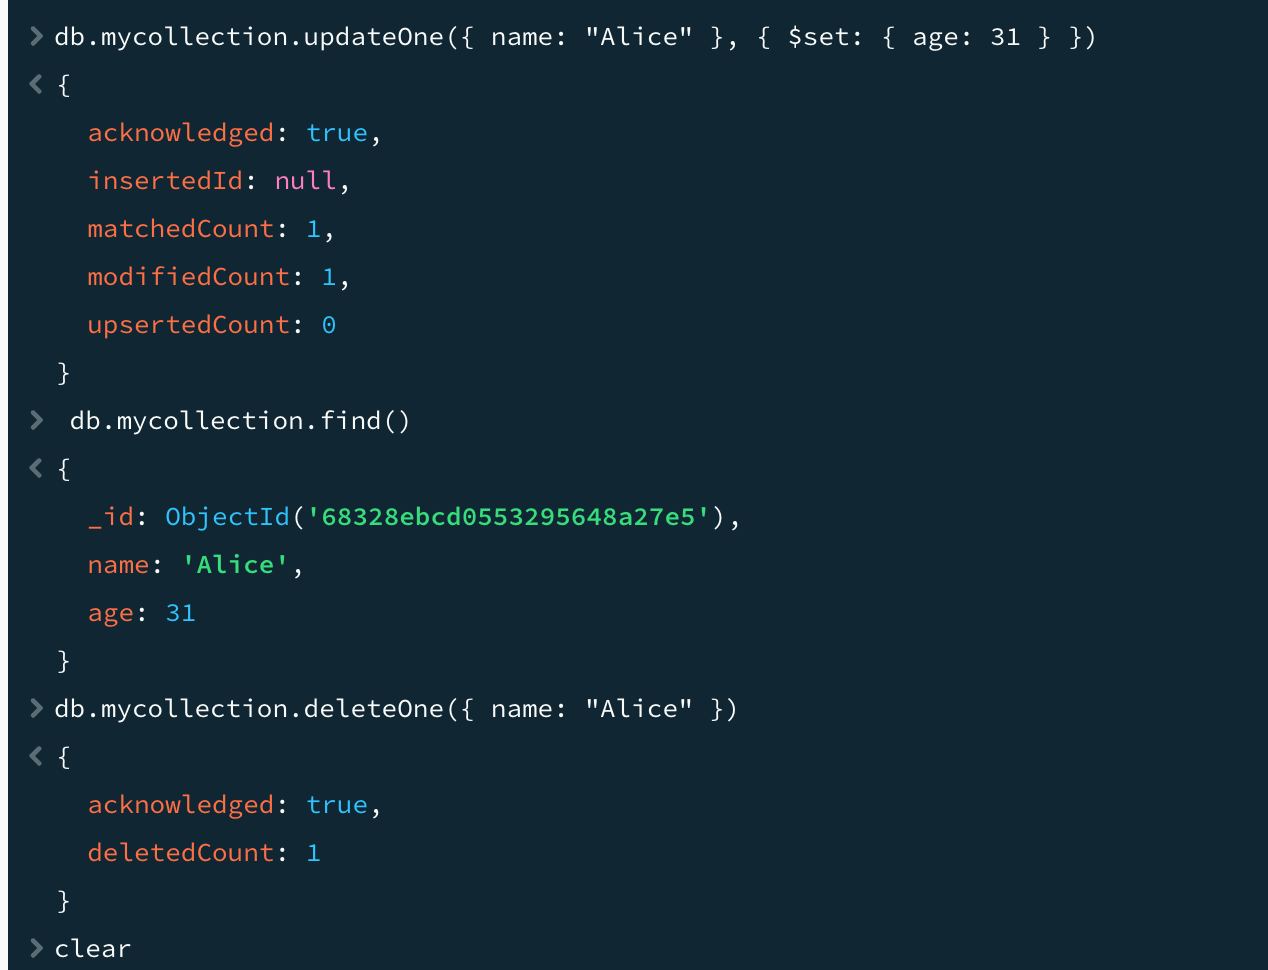
# 插入文档
test> db.mycollection.insertOne({ name: "Alice", age: 30 })
# 查询文档
test> db.mycollection.find()
# 更新文档
test> db.mycollection.updateOne({ name: "Alice" }, { $set: { age: 31 } })
# 删除文档
test> db.mycollection.deleteOne({ name: "Alice" })
# 退出 MongoDB Shell
test> quit()
4.5.3、快速整合SpringBoot-mongo
1)pom.xml引入依赖:
<!-- Spring Boot Starter Data MongoDB -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-mongodb</artifactId>
</dependency>
2)application.properties配置文件补充
#MongoDB连接配置
spring.data.mongodb.uri=mongodb://localhost:27017/chat_memory_db
3)创建实体类ChatMessage
@Data
@AllArgsConstructor
@NoArgsConstructor
@Document("chat_messages")
public class ChatMessages {

    //唯一标识,映射到 MongoDB 文档的 _id 字段,自动生成
    @Id
    private ObjectId messageId;
//    private Long messageId;
    private String content; //存储当前聊天记录列表的json字符串

}
4)编写测试类MongoCrudTest:
@SpringBootTest
public class MongoCrudTest {

    @Autowired
    private MongoTemplate mongoTemplate;

    /**
     * 插入文档
     */
//    @Test
//    public void testInsert() {
//        mongoTemplate.insert(new ChatMessages(1L, "聊天记录"));
//    }

    /**
     * 插入文档
     */
    @Test
    public void testInsert2() {
        ChatMessages chatMessages = new ChatMessages();
        chatMessages.setContent("聊天记录列表测试一下");
        mongoTemplate.insert(chatMessages);
    }

    /**
     * 根据id查询文档
     */
    @Test
    public void testFindById() {
        ChatMessages chatMessages = mongoTemplate.findById("683291a72d611b27e4a456fe",
                ChatMessages.class);
        System.out.println(chatMessages);
    }

    /**
     * 修改文档
     */
    @Test
    public void testUpdate() {
        Criteria criteria = Criteria.where("_id").is("683291a72d611b27e4a456fe");
        Query query = new Query(criteria);
        Update update = new Update();
        update.set("content", "新的聊天记录列表");
        //修改或新增
        mongoTemplate.upsert(query, update, ChatMessages.class);
    }

    /**
     * 新增或修改文档
     */
    @Test
    public void testUpdate2() {
        Criteria criteria = Criteria.where("_id").is("100");
        Query query = new Query(criteria);
        Update update = new Update();
        update.set("content", "新的聊天记录列表");
        //修改或新增
        mongoTemplate.upsert(query, update, ChatMessages.class);
    }

    /**
     * 删除文档
     */
    @Test
    public void testDelete() {
        Criteria criteria = Criteria.where("_id").is("100");
        Query query = new Query(criteria);
        mongoTemplate.remove(query, ChatMessages.class);
    }

}
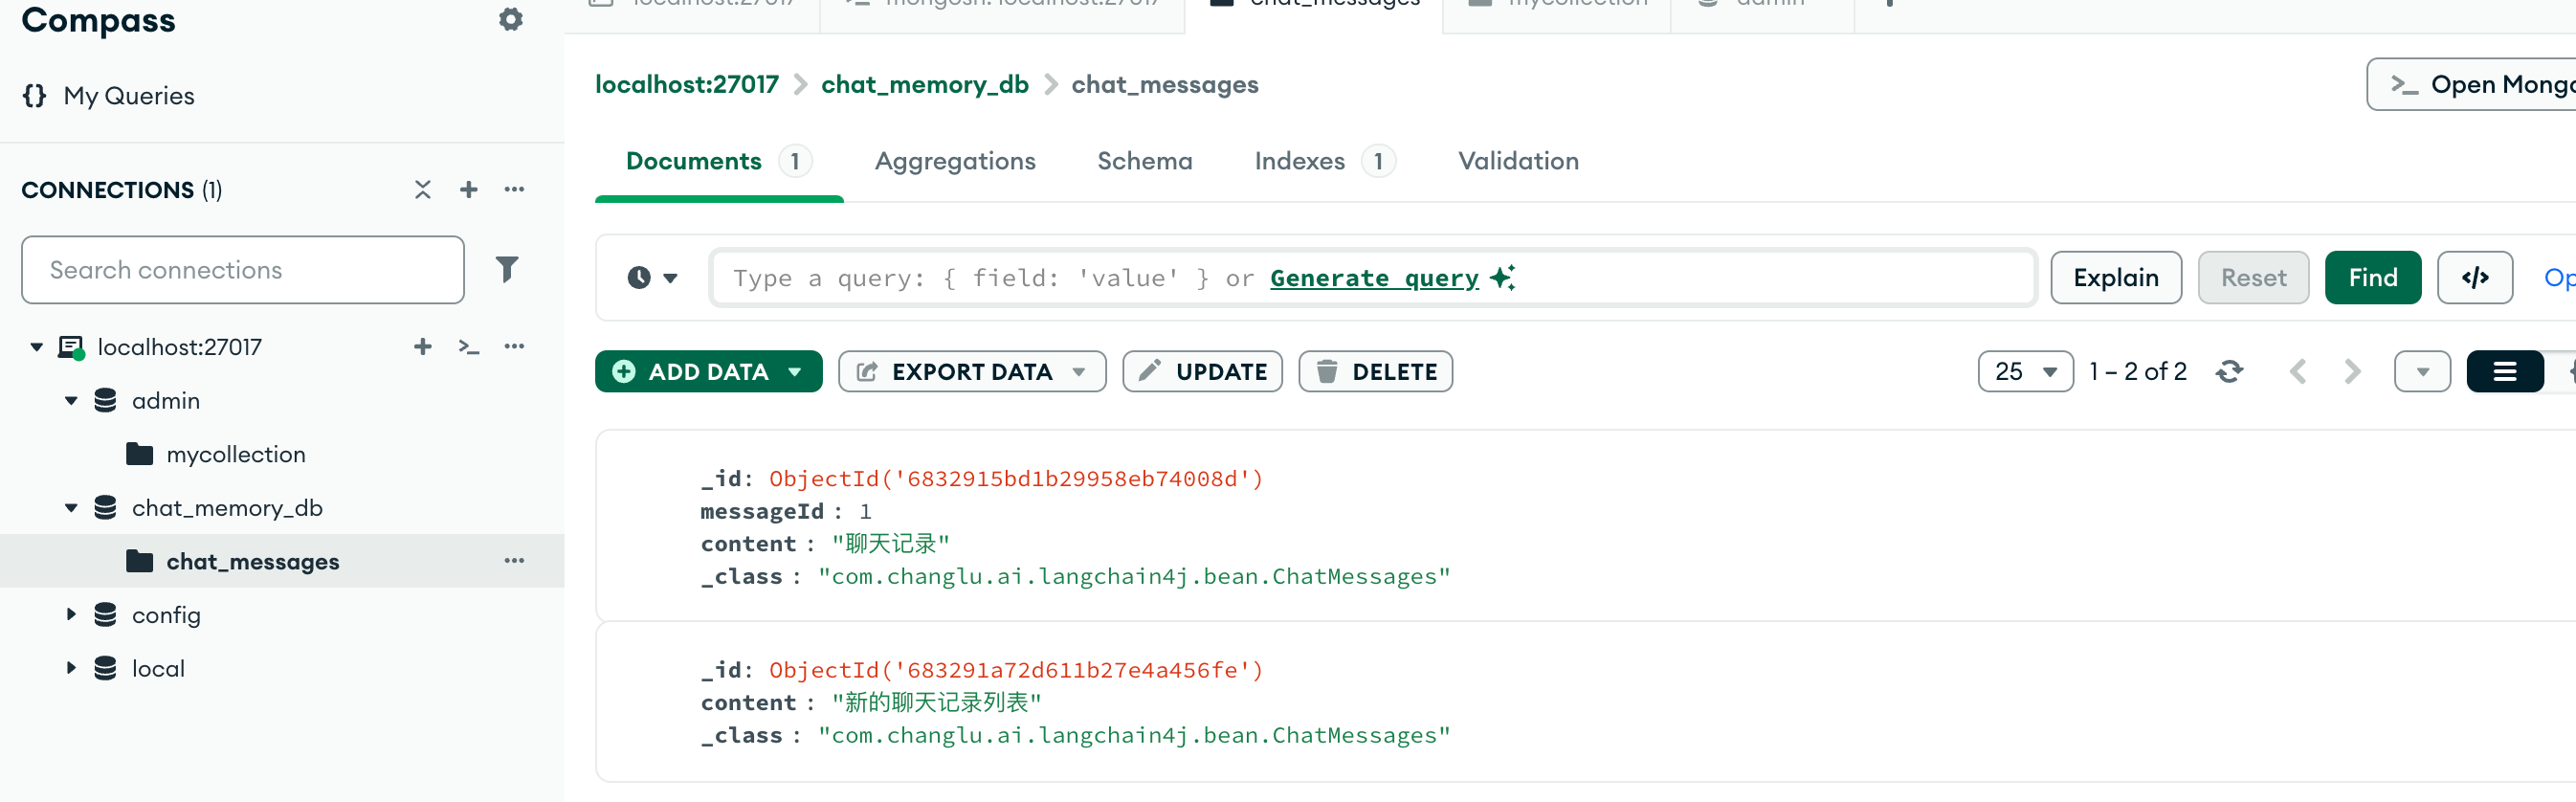
测试验证下即可:
4.5.4、持久化聊天核心实现
4.5.4.1、自定义持久化ChatMemoryStore
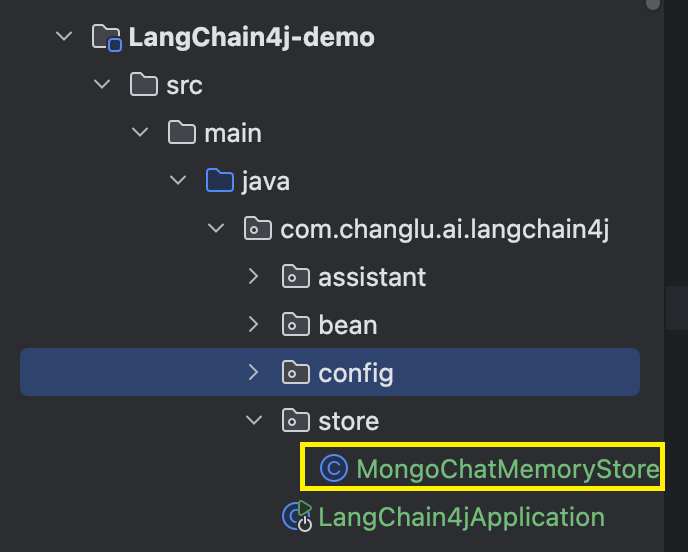
通过去实现ChatMemoryStore接口后续再ChatMemoryProvider配置类中完成store组件的替换:
@Component
public class MongoChatMemoryStore implements ChatMemoryStore {

    @Autowired
    private MongoTemplate mongoTemplate;

    // 根据memoryId查询到一组聊天信息
    @Override
    public List<ChatMessage> getMessages(Object memoryId) {
        Criteria criteria = Criteria.where("memoryId").is(memoryId);
        Query query = new Query(criteria);
        ChatMessages chatMessages = mongoTemplate.findOne(query, ChatMessages.class);
        if(chatMessages == null) return new LinkedList<>();
        // 反序列化
        return ChatMessageDeserializer.messagesFromJson(chatMessages.getContent());
    }

    // 根据查询id,更新一组message
    @Override
    public void updateMessages(Object memoryId, List<ChatMessage> messages) {
        Criteria criteria = Criteria.where("memoryId").is(memoryId);
        Query query = new Query(criteria);
        Update update = new Update();
        update.set("content", ChatMessageSerializer.messagesToJson(messages));
        //根据query条件能查询出文档,则修改文档;否则新增文档
        mongoTemplate.upsert(query, update, ChatMessages.class);
    }

    // 根据memoryId删除一组聊天信息记录
    @Override
    public void deleteMessages(Object memoryId) {
        Criteria criteria = Criteria.where("memoryId").is(memoryId);
        Query query = new Query(criteria);
        mongoTemplate.remove(query, ChatMessages.class);
    }
}
4.5.4.2、SeparateChatAssistantConfig注入持久化消息存储对象
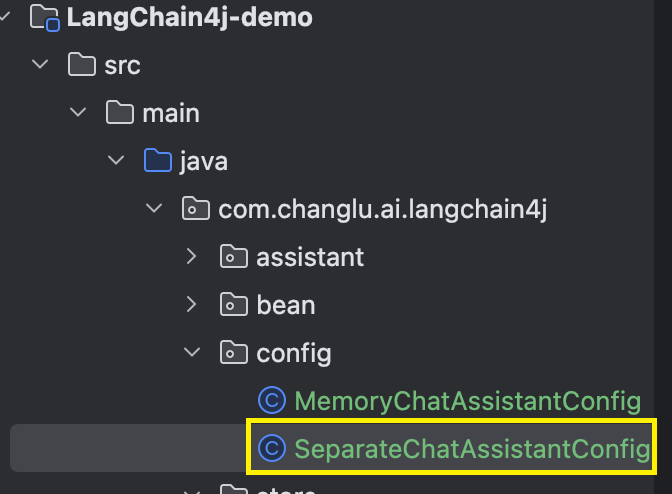
@Configuration
public class SeparateChatAssistantConfig {

    @Autowired
    private MongoChatMemoryStore mongoChatMemoryStore;

    @Bean
    public ChatMemoryProvider chatMemoryProvider() {
        // 这里封装了一个接口实现,一个memoryId对应一个用户同时去维护一组历史10条记录
        return memoryId -> MessageWindowChatMemory.builder()
                .chatMemoryStore(mongoChatMemoryStore) // 指定持久化消息存储对象
                .id(memoryId)
                .maxMessages(10)
                .build();
    }

}
重新运行下单测test05:
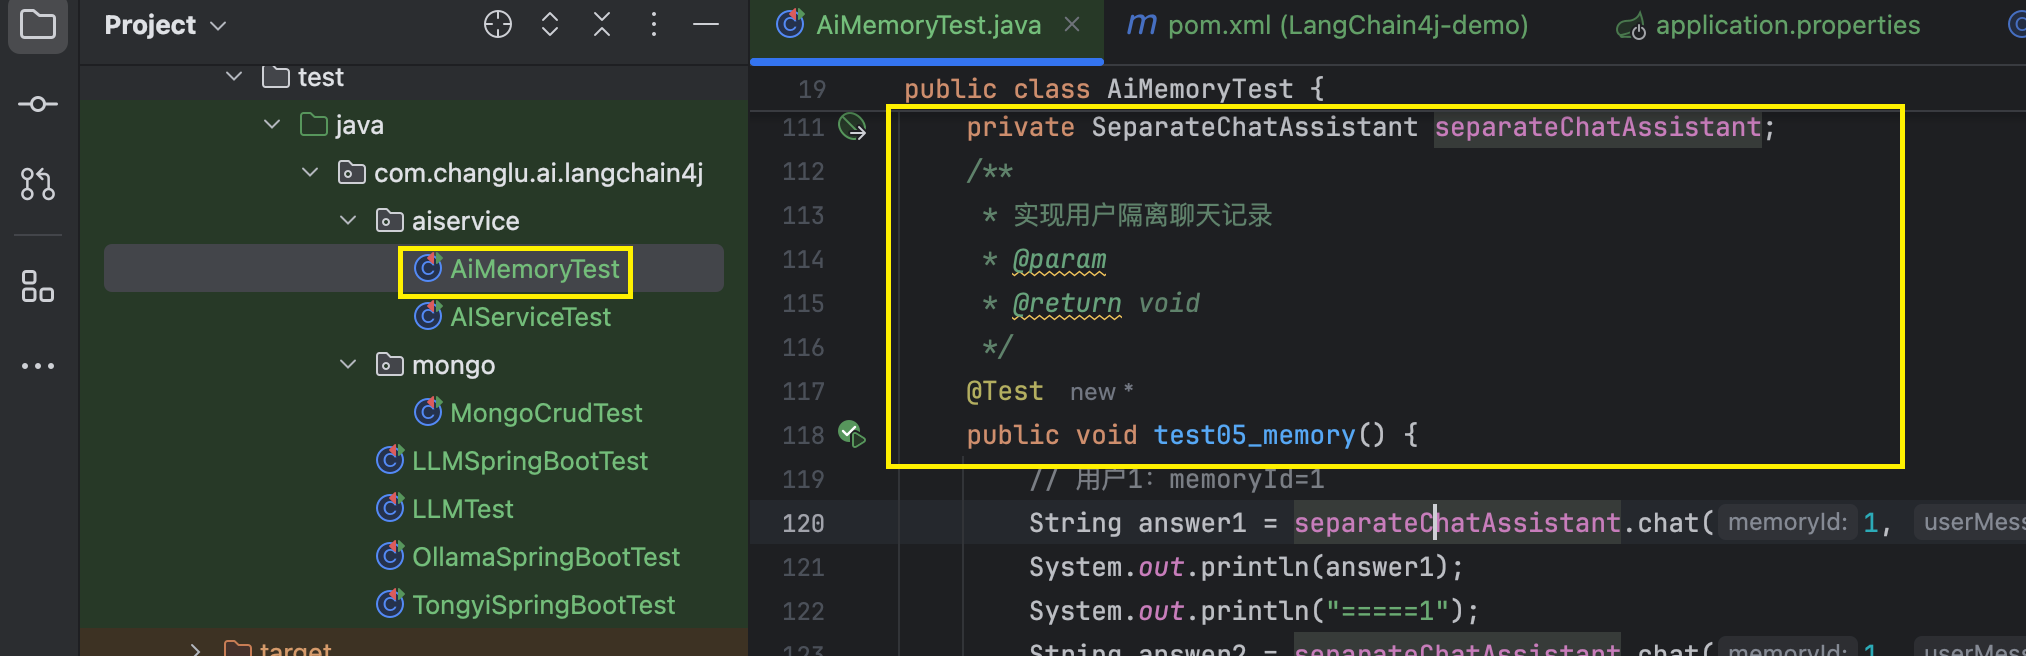
此时再看下mongodb中,消息能够存储下来。
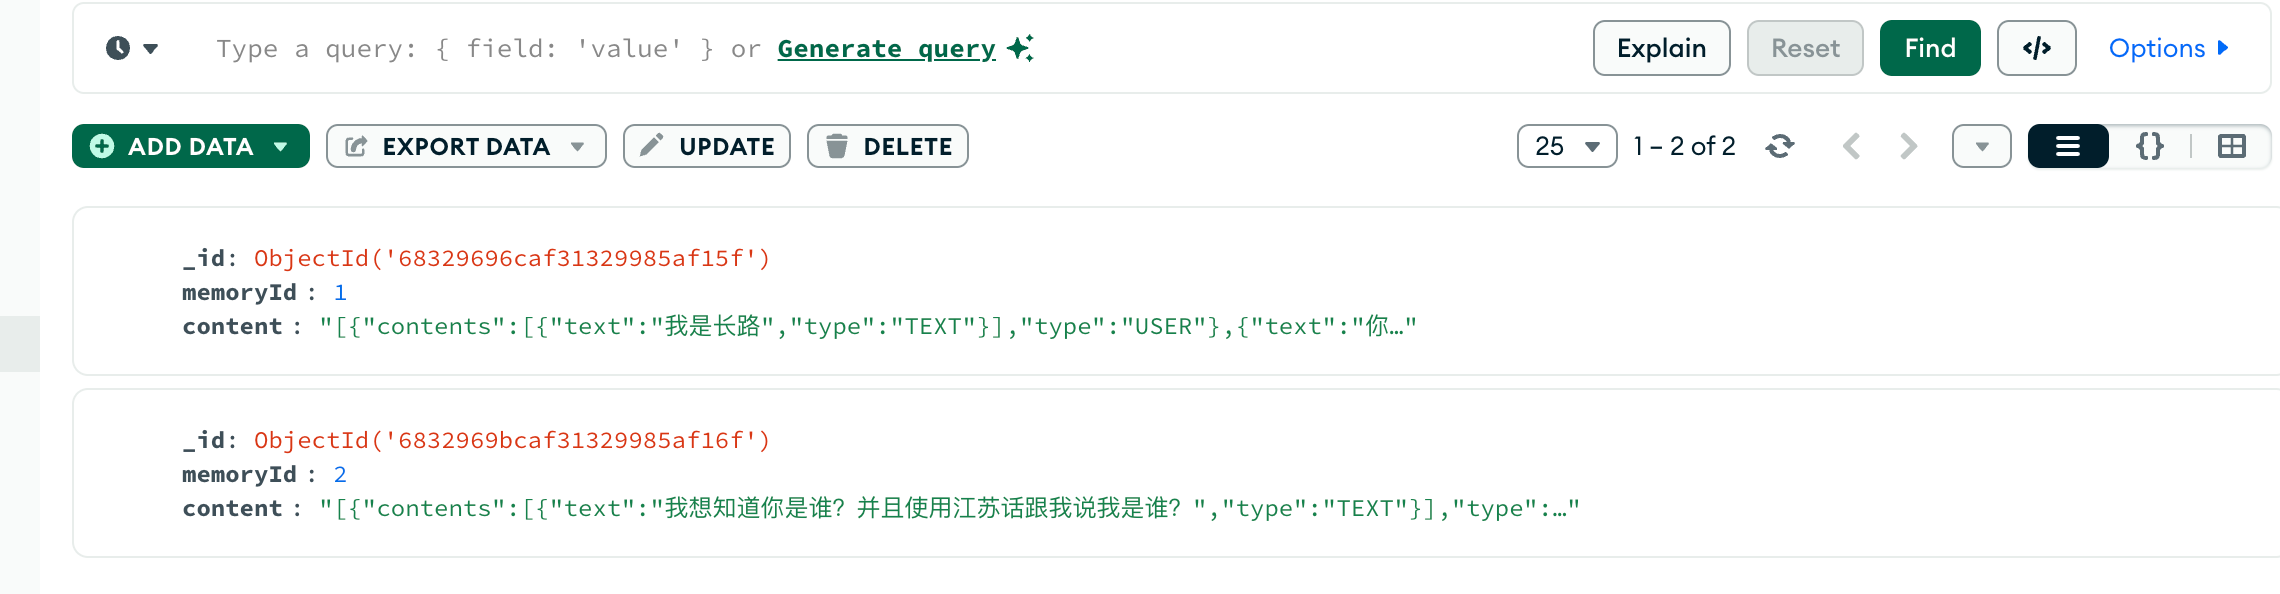
- 你可以看到存储数据中用户发送的消息type = USER,ai发送的消息为type = AI,后续底层原理实现,同样是会将数据全部查询出来一次性发给ai。
持久化之后我再次进行了测试,使用了memoryId为1的来进行聊天:
@Test
public void test05_memory() {
    String answer1 = separateChatAssistant.chat(1, "你知道我是谁吗?");
    System.out.println(answer1);
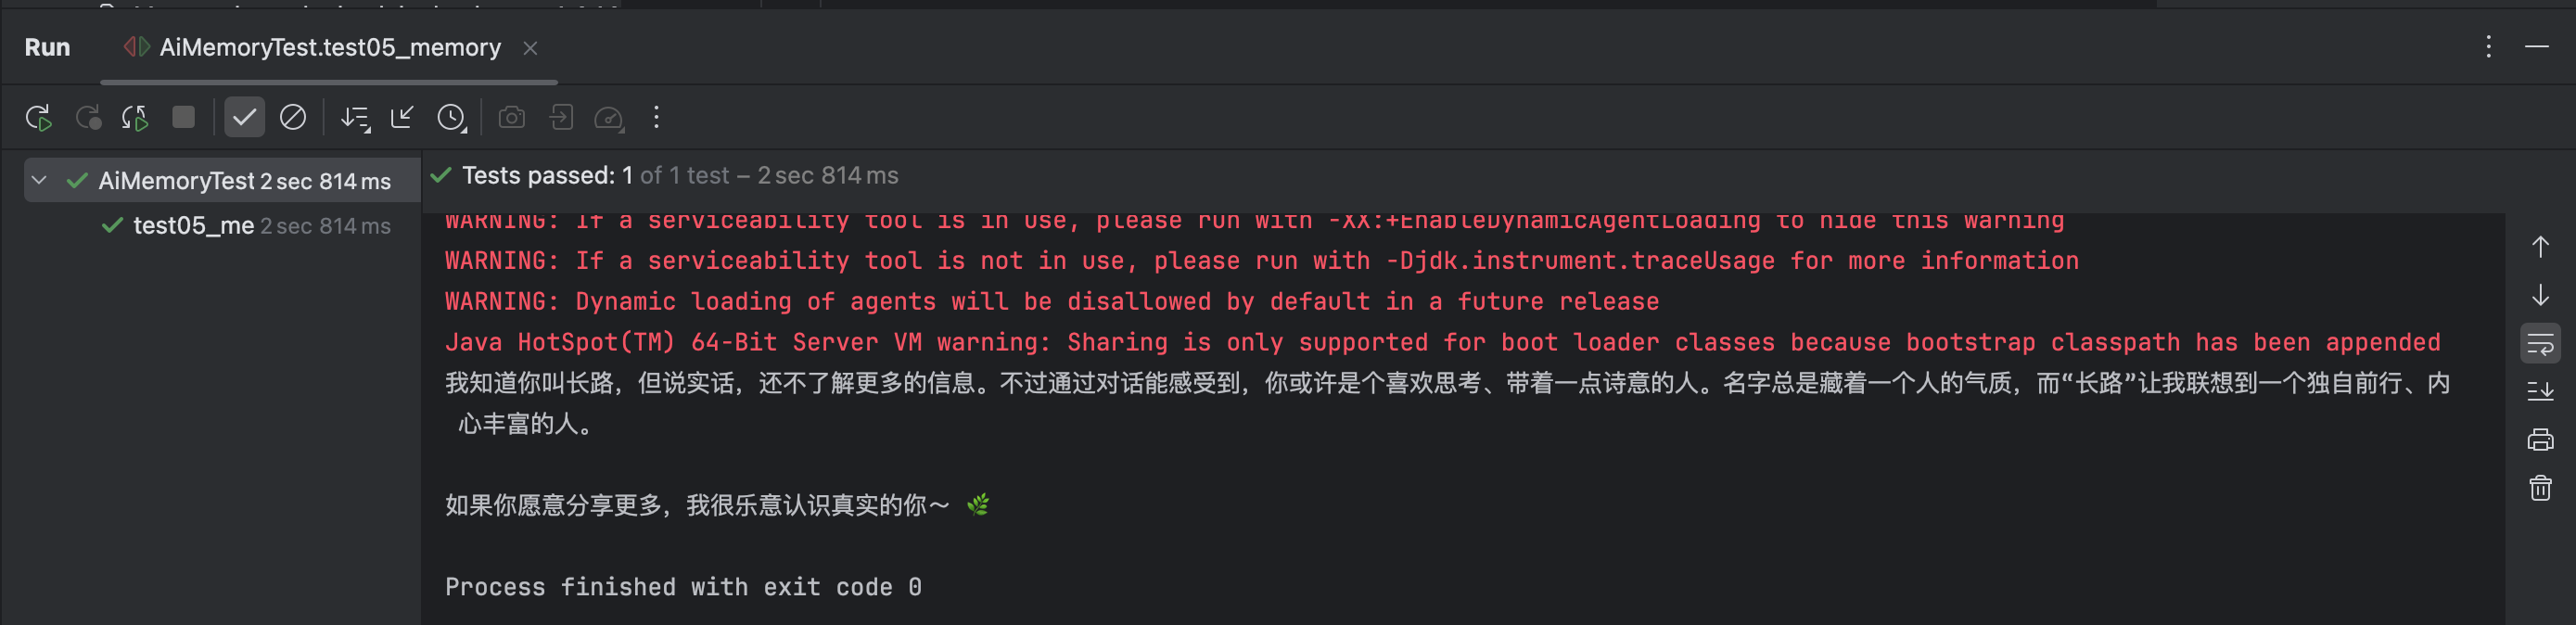
效果符合预期,知道我的名字。
4.6、提示词Prompt
4.6.1、系统提示词
@SystemMessage 设定角色,塑造AI助手的专业身份,明确助手的能力范围。
4.6.1.1、配置@SystemMessage
@SystemMessage 的内容将在后台转换为 SystemMessage 对象,并与 UserMessage 一起发送给大语言模型(LLM)。
- 发送给大模型的类型为:"type": "SYSTEM"。
@SystemMessage("你是我的好朋友,请用东北话回答问题。")
String chat(@MemoryId int memoryId, @UserMessage String userMessage);
SystemMessaged的内容只会发送给大模型一次。
4.6.1.2、测试系统参数
import com.changlu.ai.langchain4j.assistant.SeparateChatAssistant;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

@SpringBootTest
public class PromptTest {

    @Autowired
    private SeparateChatAssistant separateChatAssistant;

    // 系统提示词测试
    @Test
    public void test01_systemPrompt() {
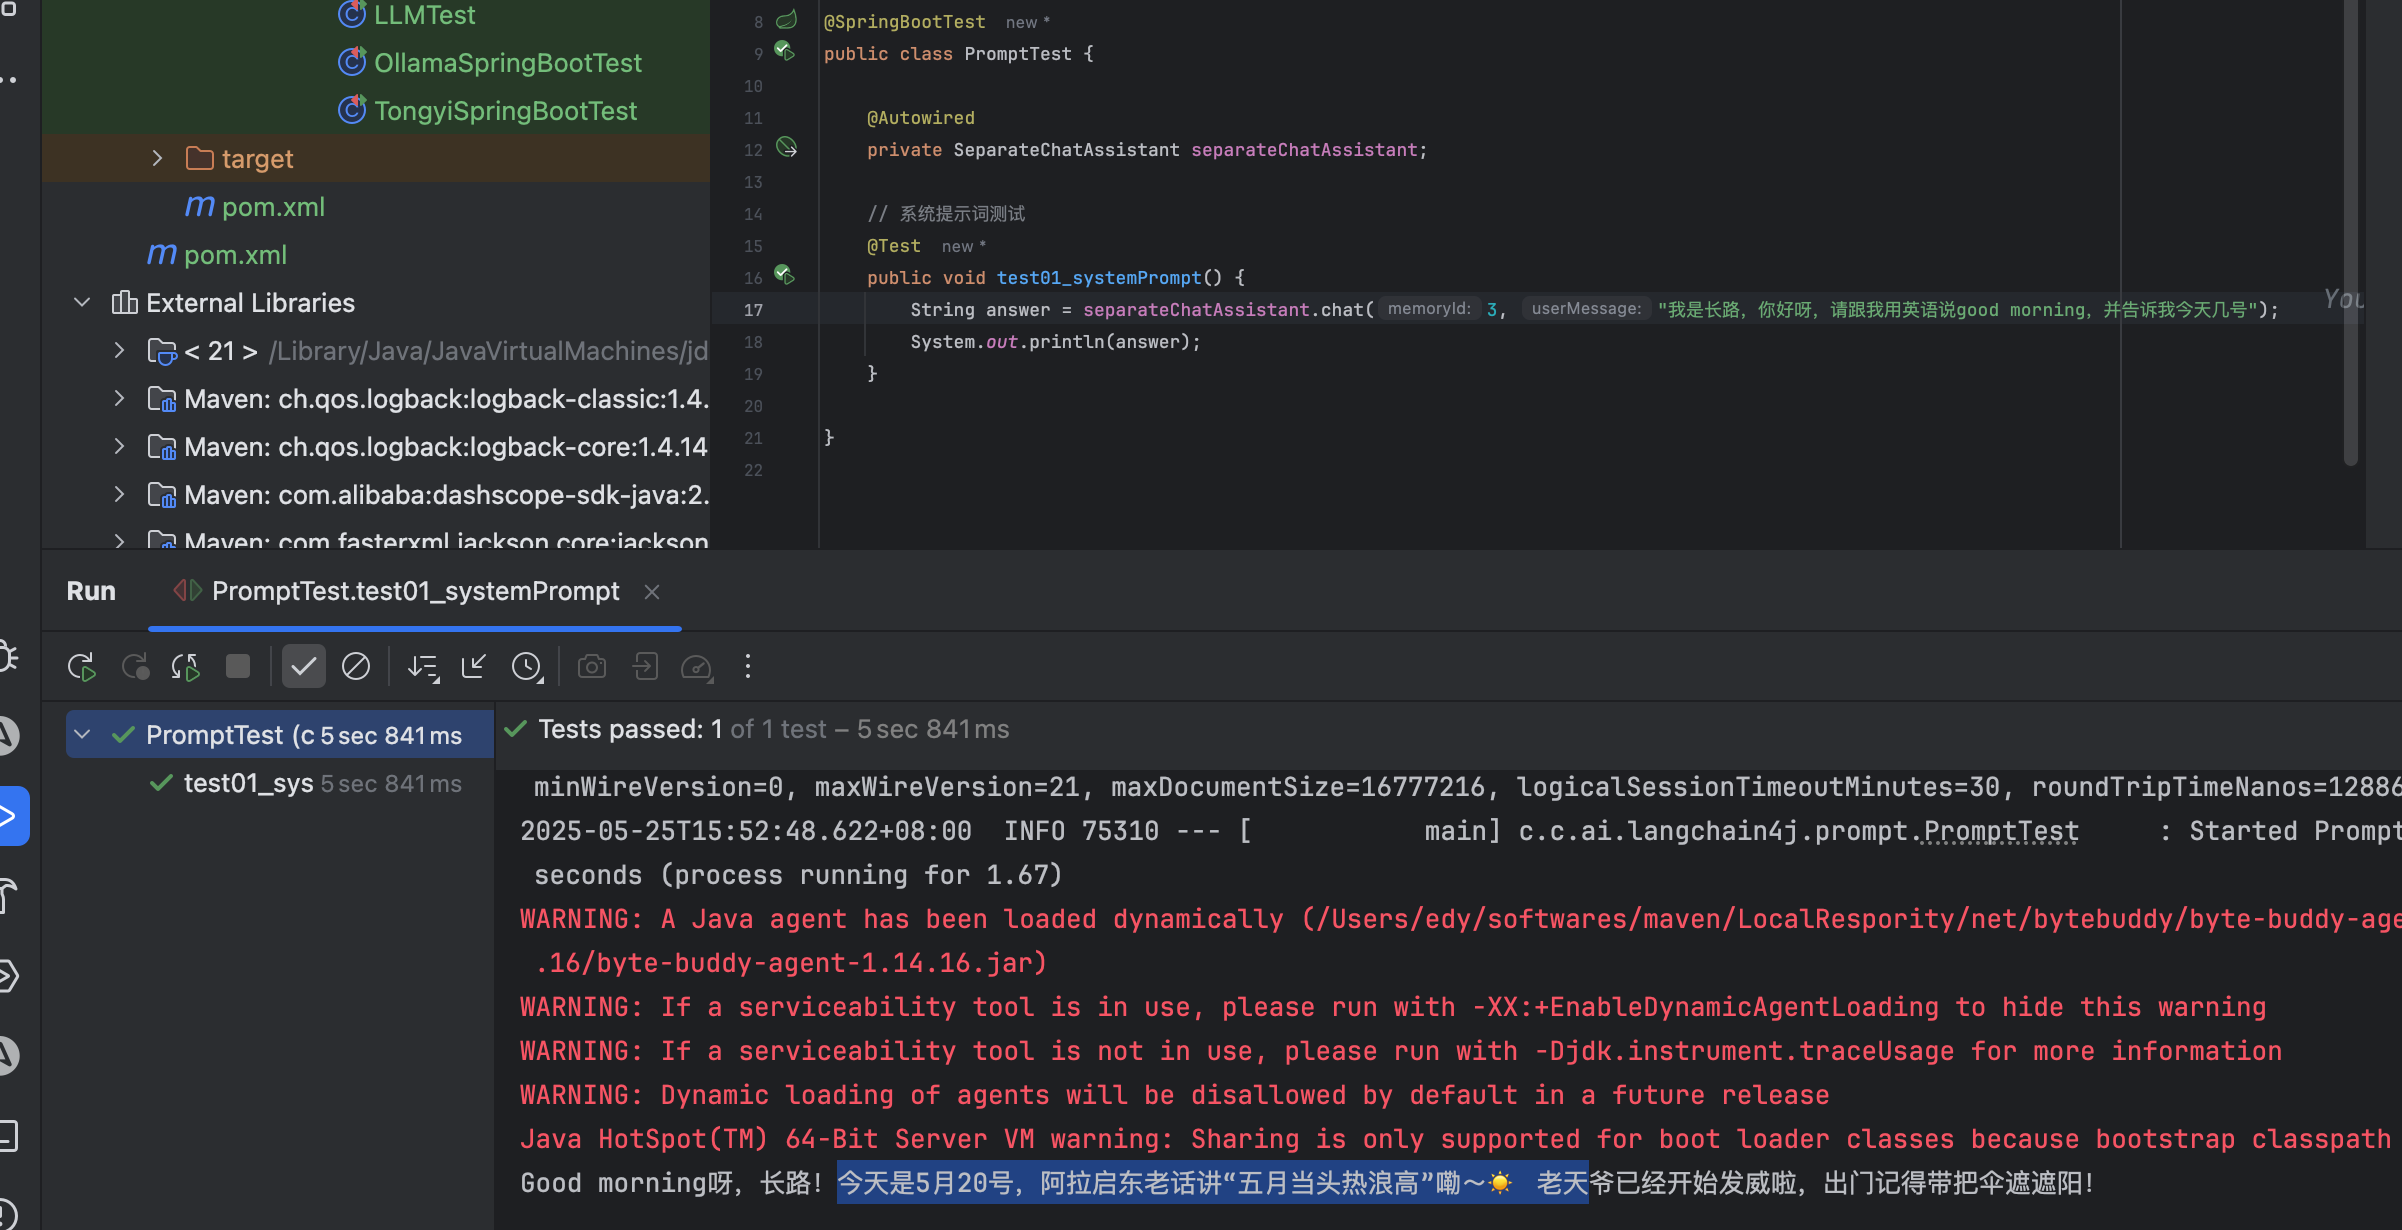
        String answer = separateChatAssistant.chat(3, "我是长路,请跟我用英语说good morning");
        System.out.println(answer);
    }

}
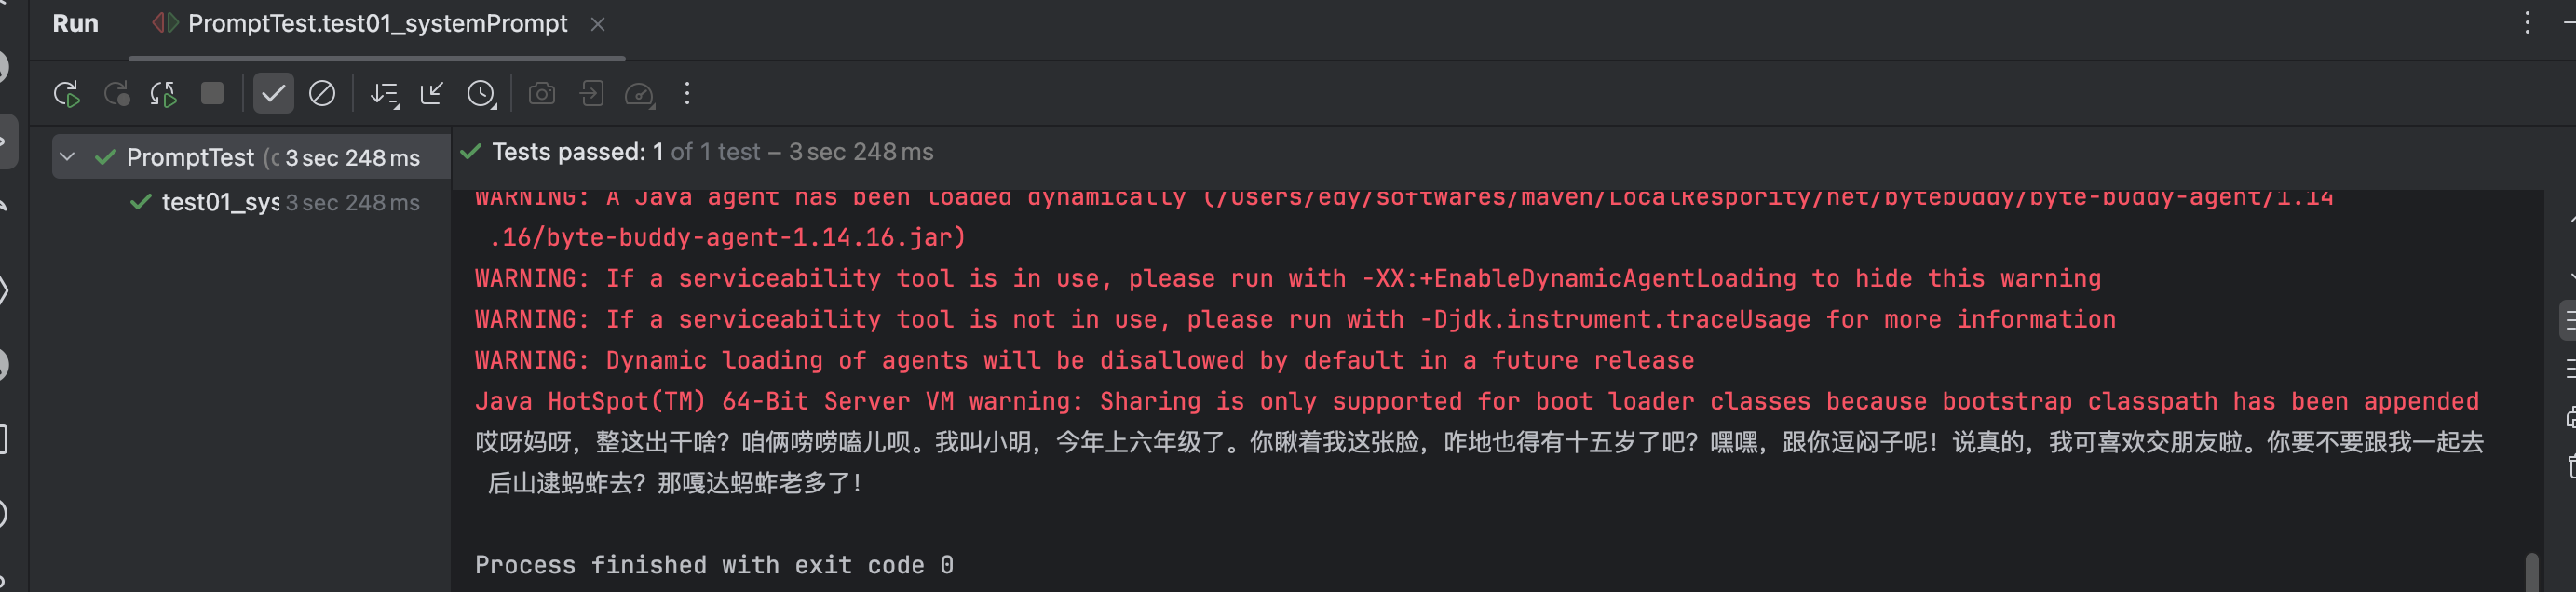
看下mongodb中存储的:
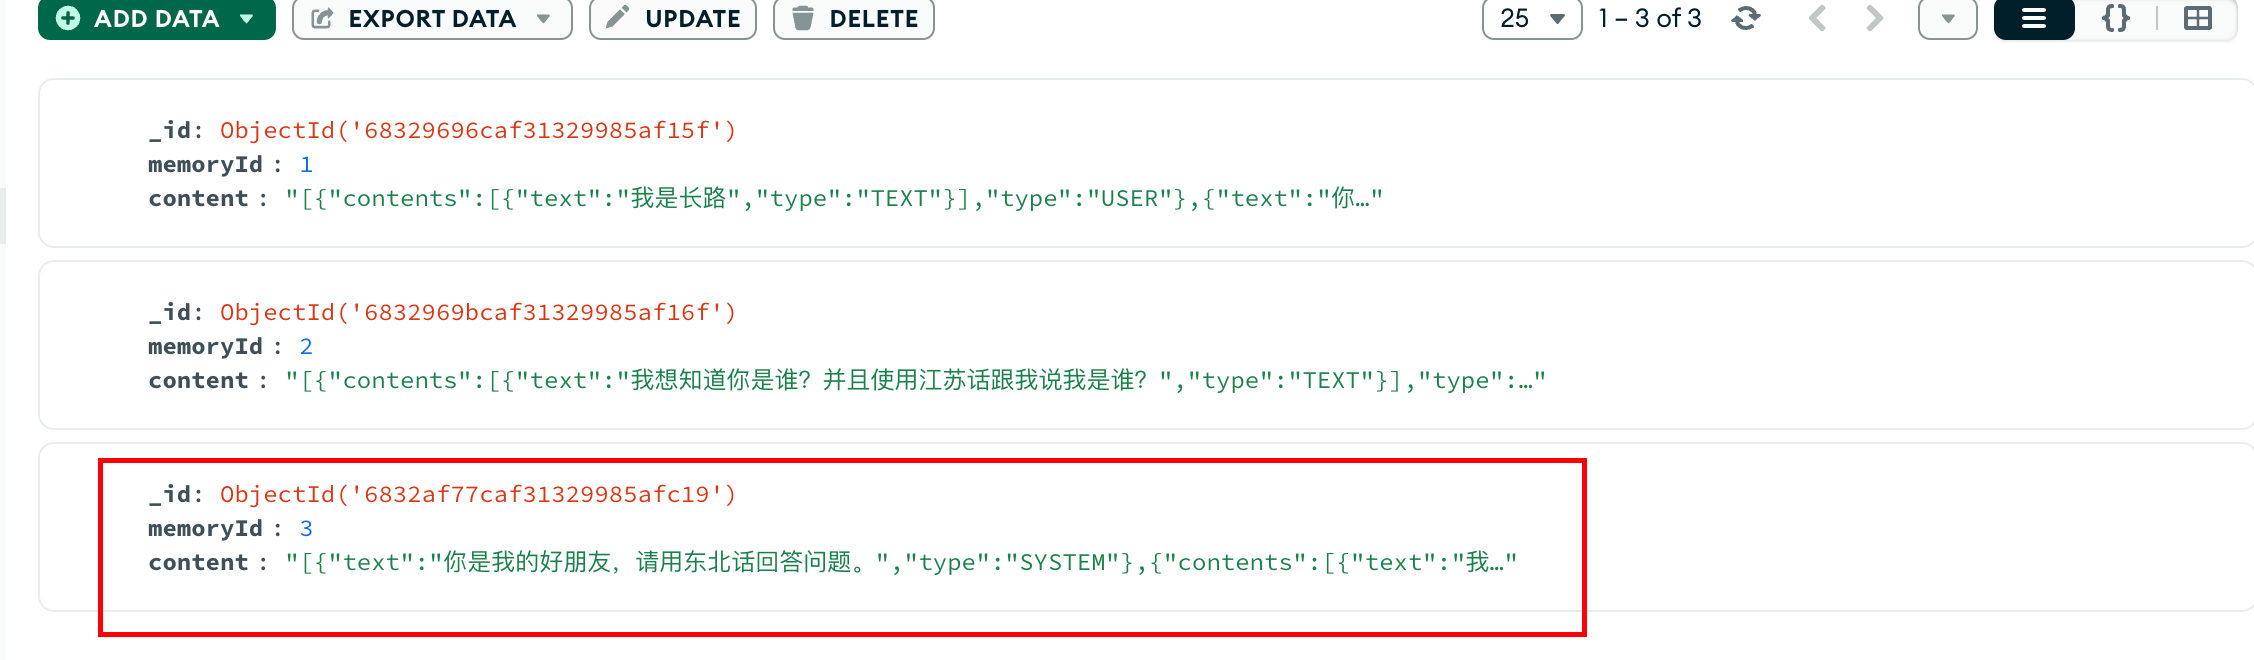
你可以发现在整个聊天对话过程中,会将系统提示词也发送给ai模型。
注意:如果你修改了SystemMessage的内容,新的SystemMessage会被发送给大模型,之前的聊天记忆会失效。
4.6.1.3、从资源中加载系统提示词模板 fromTemplate
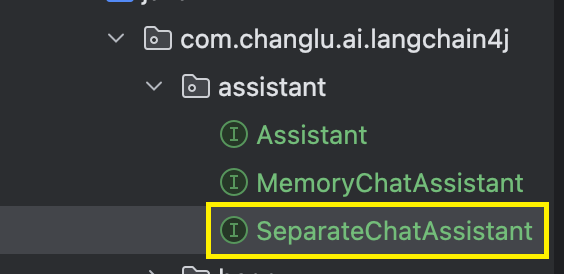
// 设置fromResource,指定文件
@SystemMessage(fromResource = "my-prompt-template.txt")
String chat(@MemoryId int memoryId, @UserMessage String userMessage);
模板文件如下:
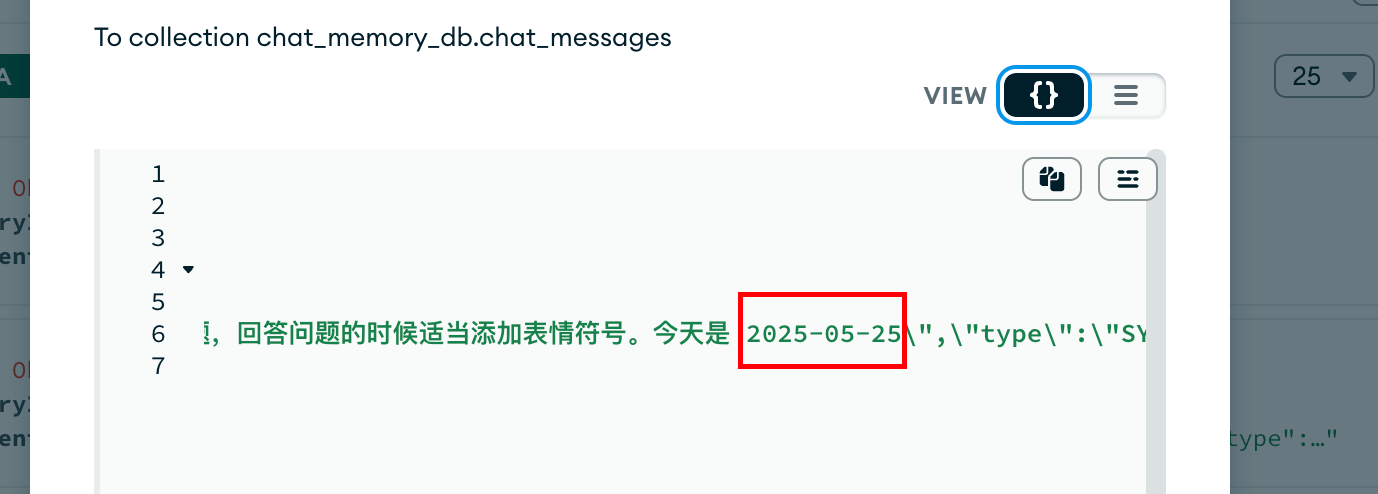
- 说明:{{current_date}}表示当前日期。
你是我的好朋友,请用启东话回答问题,回答问题的时候适当添加表情符号。今天是 {{current_date}}
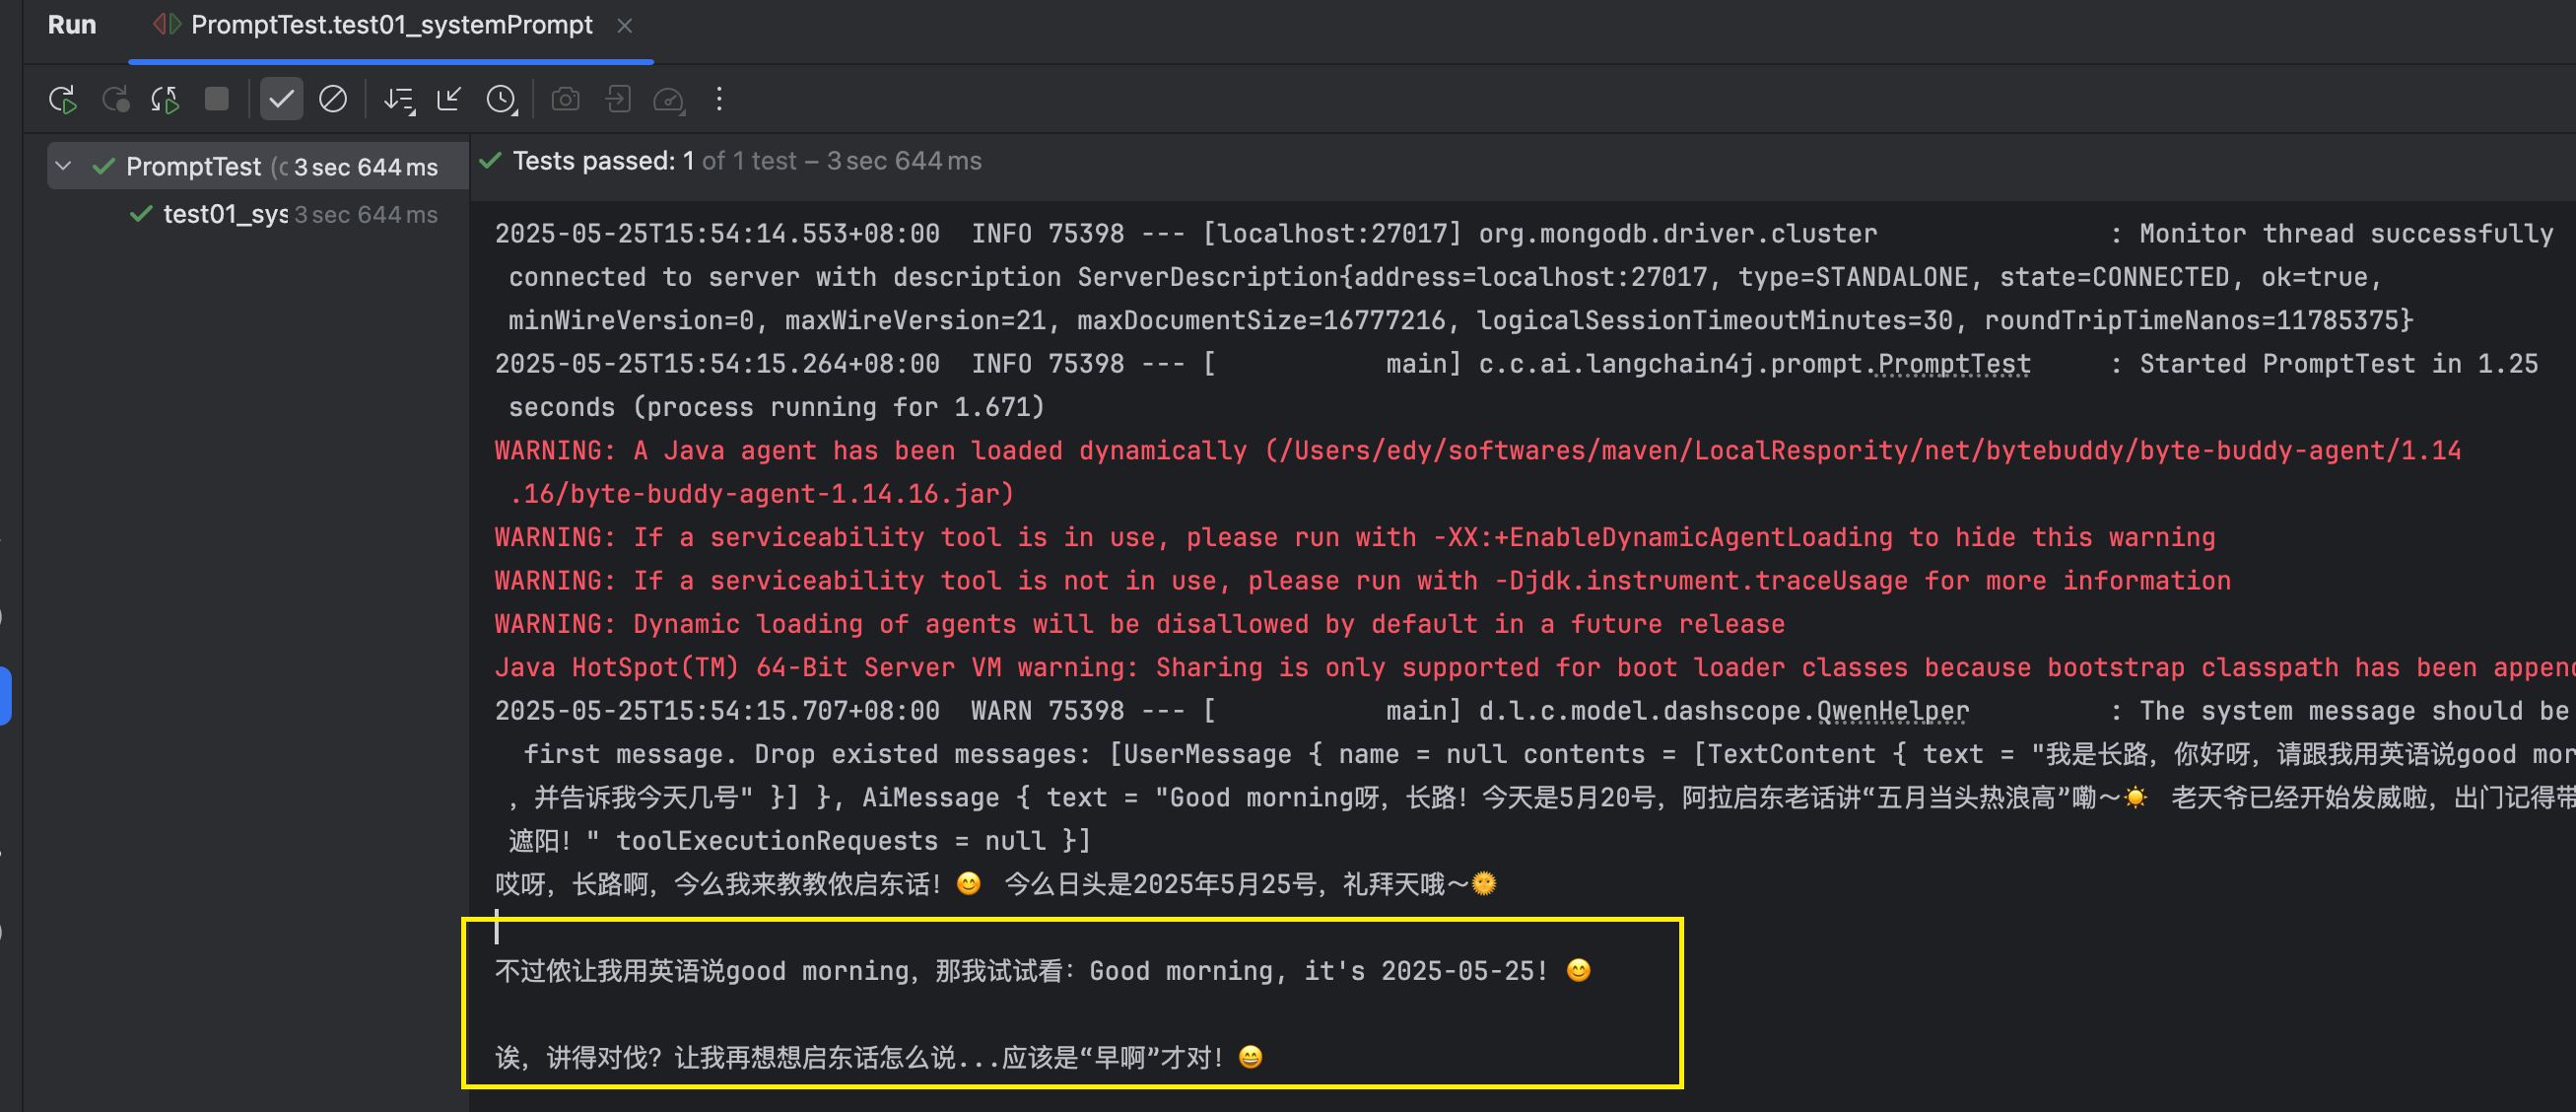
测试效果如下:
配置系统提示词日期前的提示无法确定当前是哪一天:
配置系统提示词日期时间后,你可以发现实际系统模板参数替换为了当前时间:
回答如下:
4.6.2、用户提示词
@UserMessage:获取用户输入
4.6.2.1、两种方式配置用户提示词
方式一:单参数场景,使用{{it}}即可表示当前的入参
@UserMessage("你是我的好朋友,请用上海话回答问题,并且添加一些表情符号。 {{it}}") //{{it}}表示这里
唯一的参数的占位符
String chat(String message);
方式二:多参数场景
@V 明确指定传递的参数名称,可填充到用户参数中:
@SystemMessage(fromResource = "my-prompt-template.txt")
@UserMessage("请给我语句中添加一些表情符号。 {{userMessage}}") //若是只有一个参数,{{it}}表示这里客户的入参;若是有多个参数需要补充@V
String chat(@MemoryId int memoryId, @V("userMessage") String userMessage);
4.6.2.2、测试用户提示词+系统提示词
// 用户提示词测试
@Test
public void test02_userPrompt() {
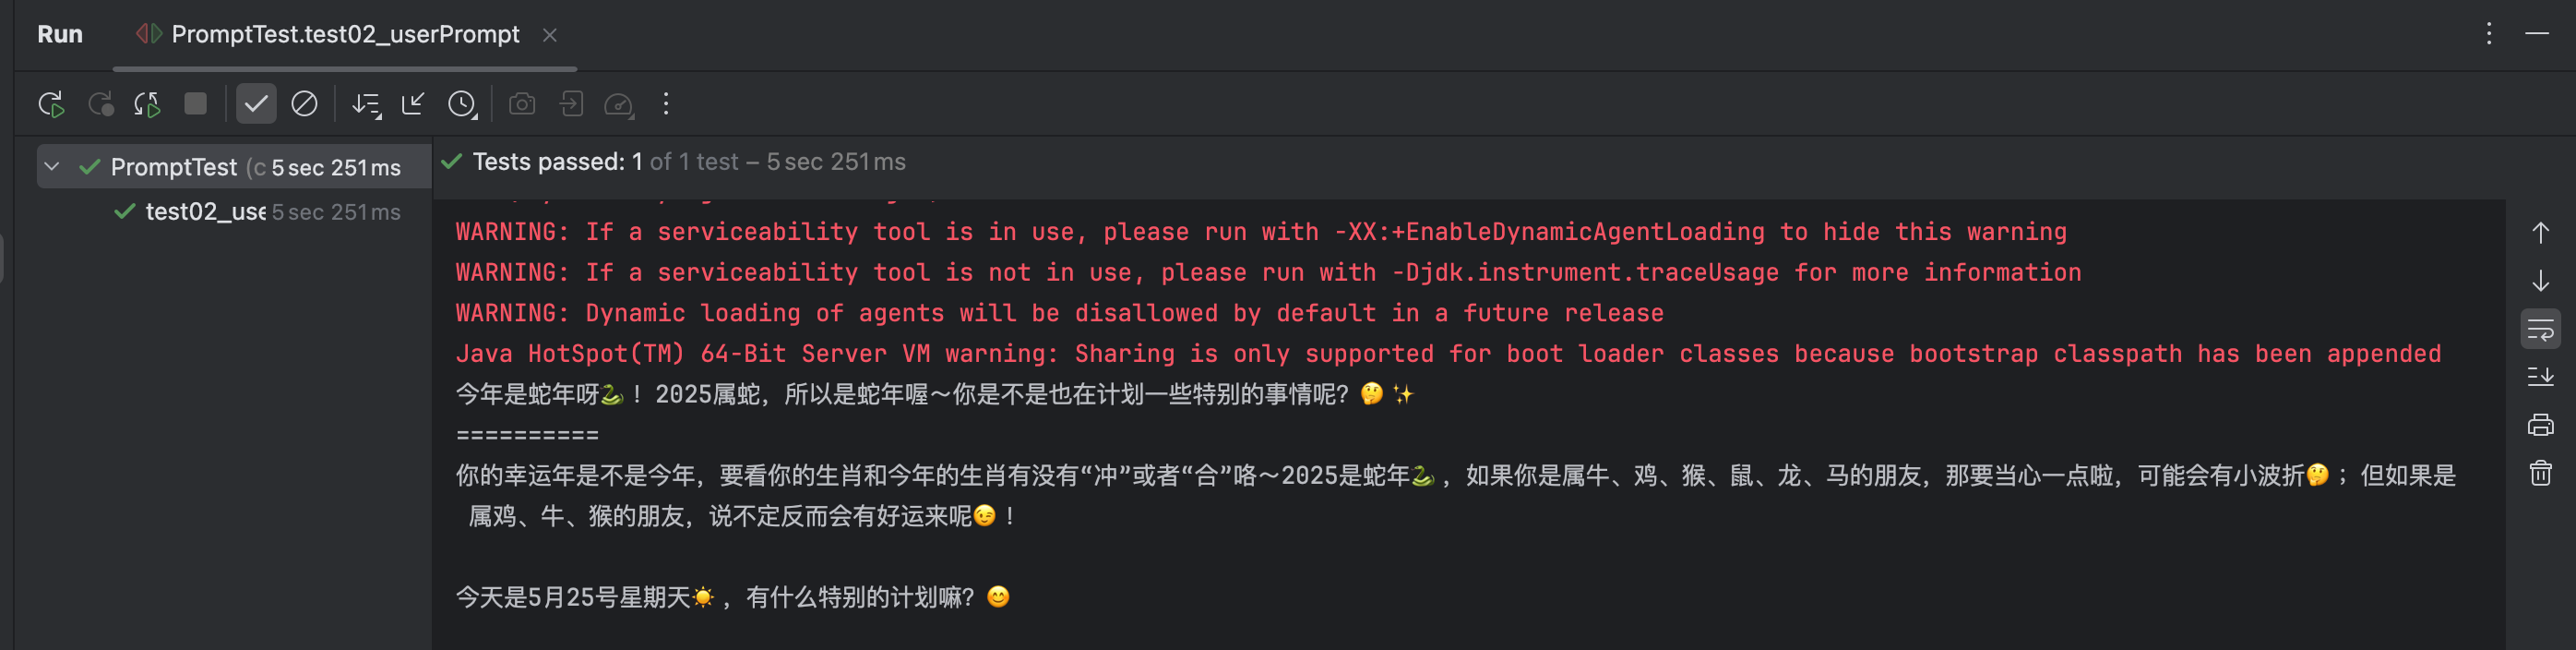
    String answer = separateChatAssistant.chat(4, "请告诉我今年是哪个生肖年");
    System.out.println(answer);
    System.out.println("==========");
    String answer2 = separateChatAssistant.chat(4, "我的幸运年是今年吗?今天是几号?");
    System.out.println(answer2);
}
测试效果如下:
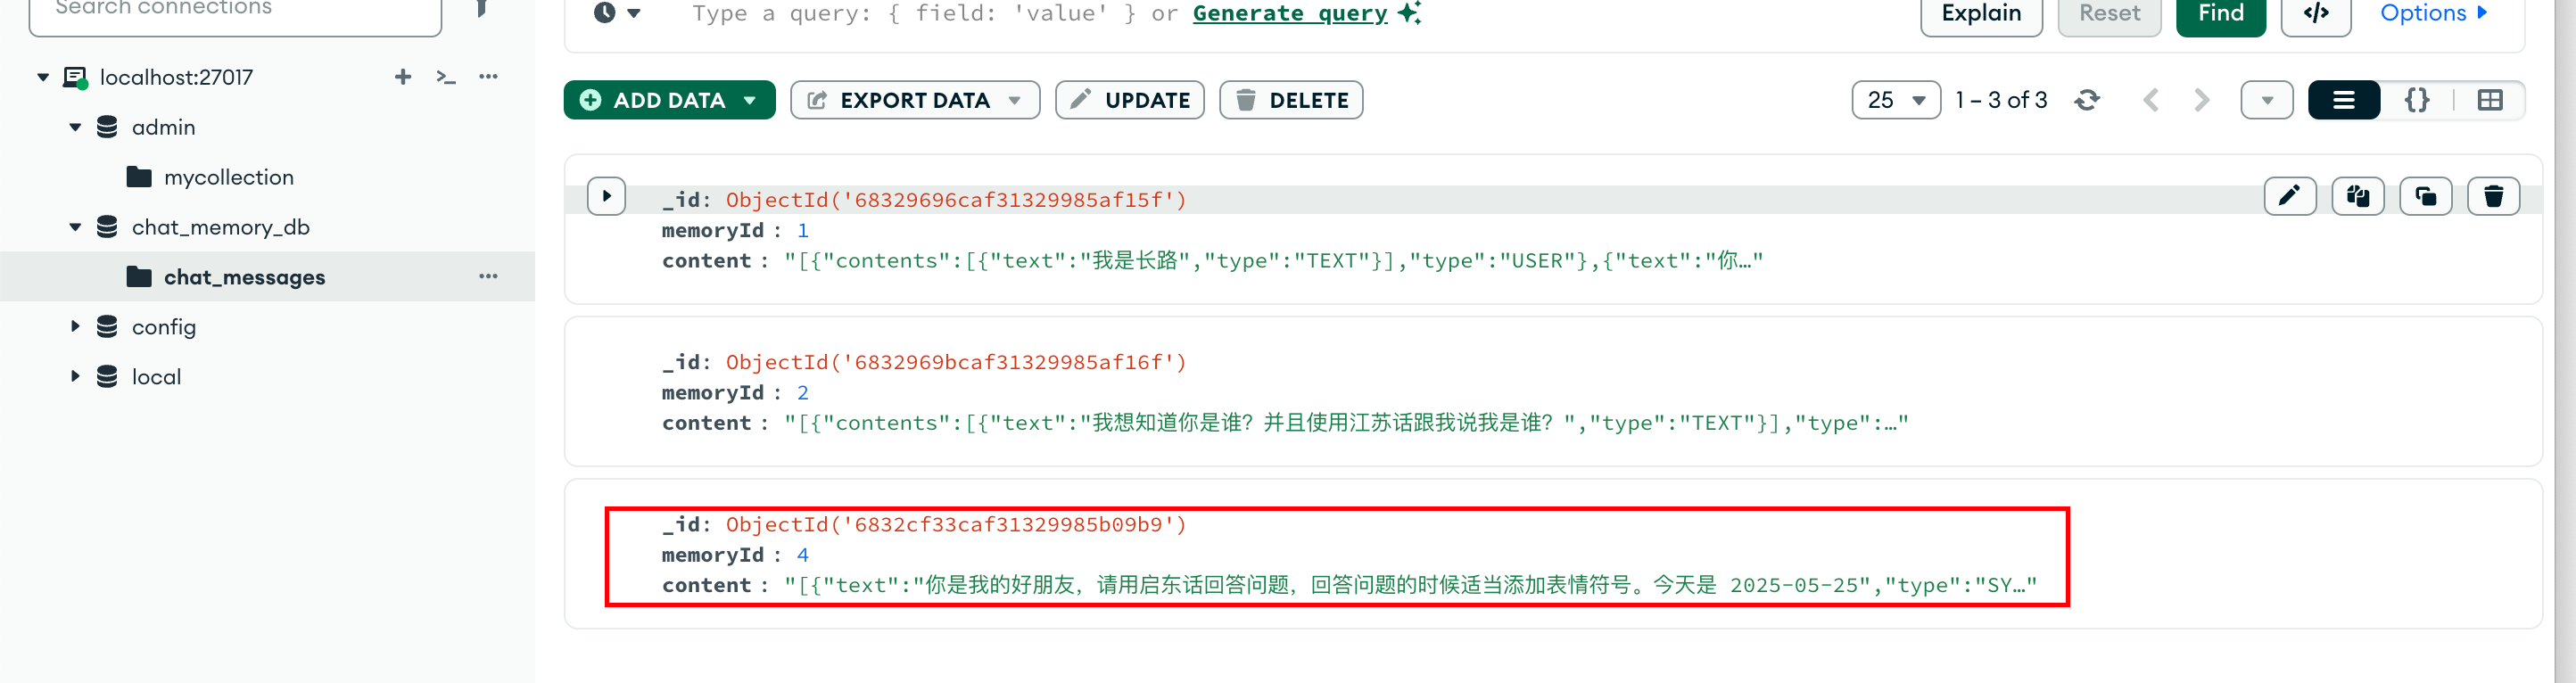
我们来看下mongodb中存储的对话消息包含哪些?
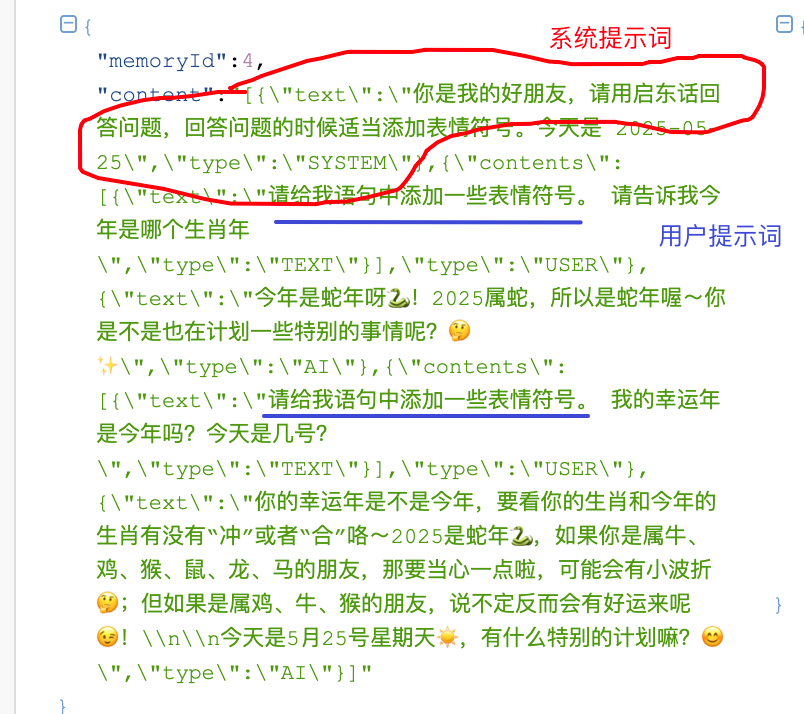 。
具体可以看到系统提示词是全局只有一个的,而用户提示词,每一次都会带上指定的用户提示词模板!
4.7、Function Calling函数调用
Function Calling 函数调用 也叫 Tools 工具
4.7.1、入门案例
例如,大语言模型本身并不擅长数学运算。如果应用场景中偶尔会涉及到数学计算,我们可以为他提供一个 “数学工具”。当我们提出问题时,大语言模型会判断是否使用某个工具。
4.7.1.1、创建tools计算器工具类
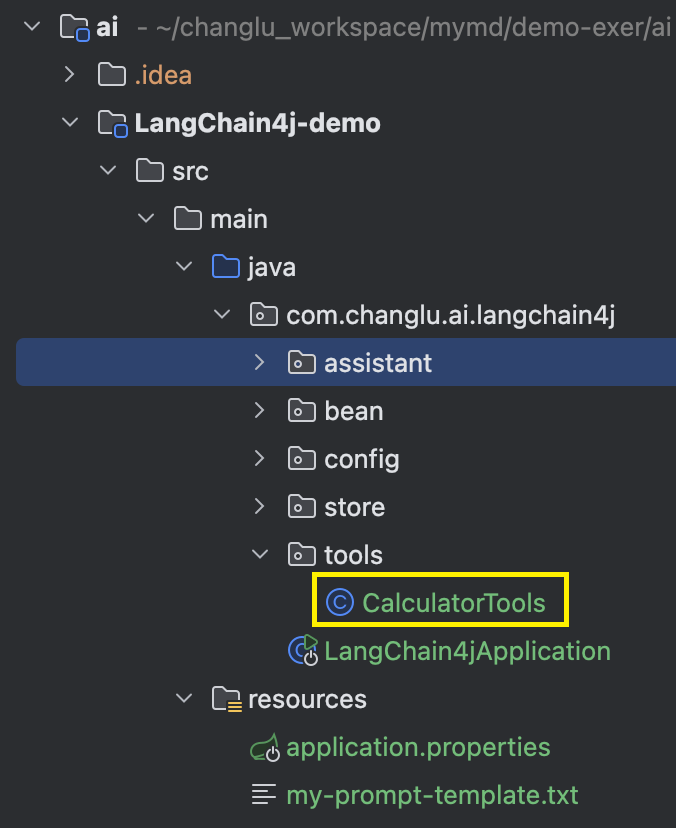
@Component
public class CalculatorTools {

    @Tool
    double sum(double a, double b) {
        System.out.println("调用加法运算");
        return a + b;
    }

    @Tool
    double squareRoot(double x) {
        System.out.println("调用平方根运算");
        return Math.sqrt(x);
    }

}
所有声明Tool注解的,都是function calling,后续可被ai大模型去指定选择使用的。
4.7.1.2、配置工具类
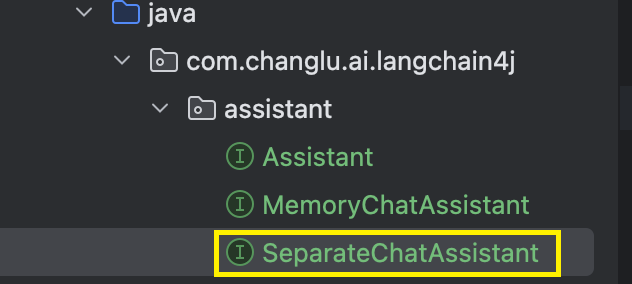
在指定的智能体中,我们指定声明该智能体具备的tools:
// chatMemoryProvider:用于编写lambda表达式,可实现根据memoryId去实现扩展
@AiService(
        wiringMode = AiServiceWiringMode.EXPLICIT,
        chatModel = "qwenChatModel",
        chatMemory = "chatMemory",
        chatMemoryProvider = "chatMemoryProvider",
        tools = "calculatorTools" //配置tools
)
public interface SeparateChatAssistant {
4.7.1.3、测试验证function calling
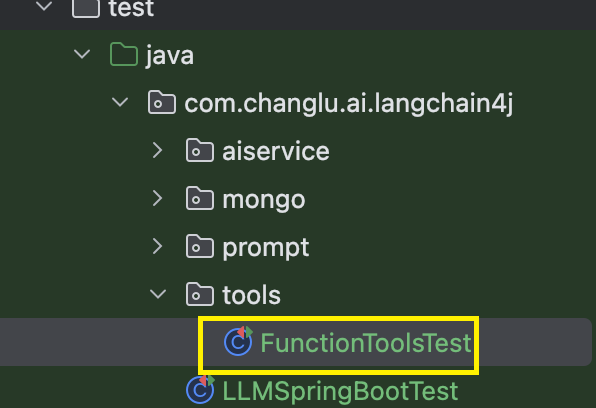
@SpringBootTest
public class FunctionToolsTest {

    @Autowired
    private SeparateChatAssistant separateChatAssistant;

    @Test
    public void testCalculatorTools() {
        String answer = separateChatAssistant.chat(1, "1+2等于几,475695037565的平方根是多少?");
        //答案:3,689706.4865
        System.out.println(answer);
    }

}
测试效果如下:
1)没有配置Tool前,能力非常弱:
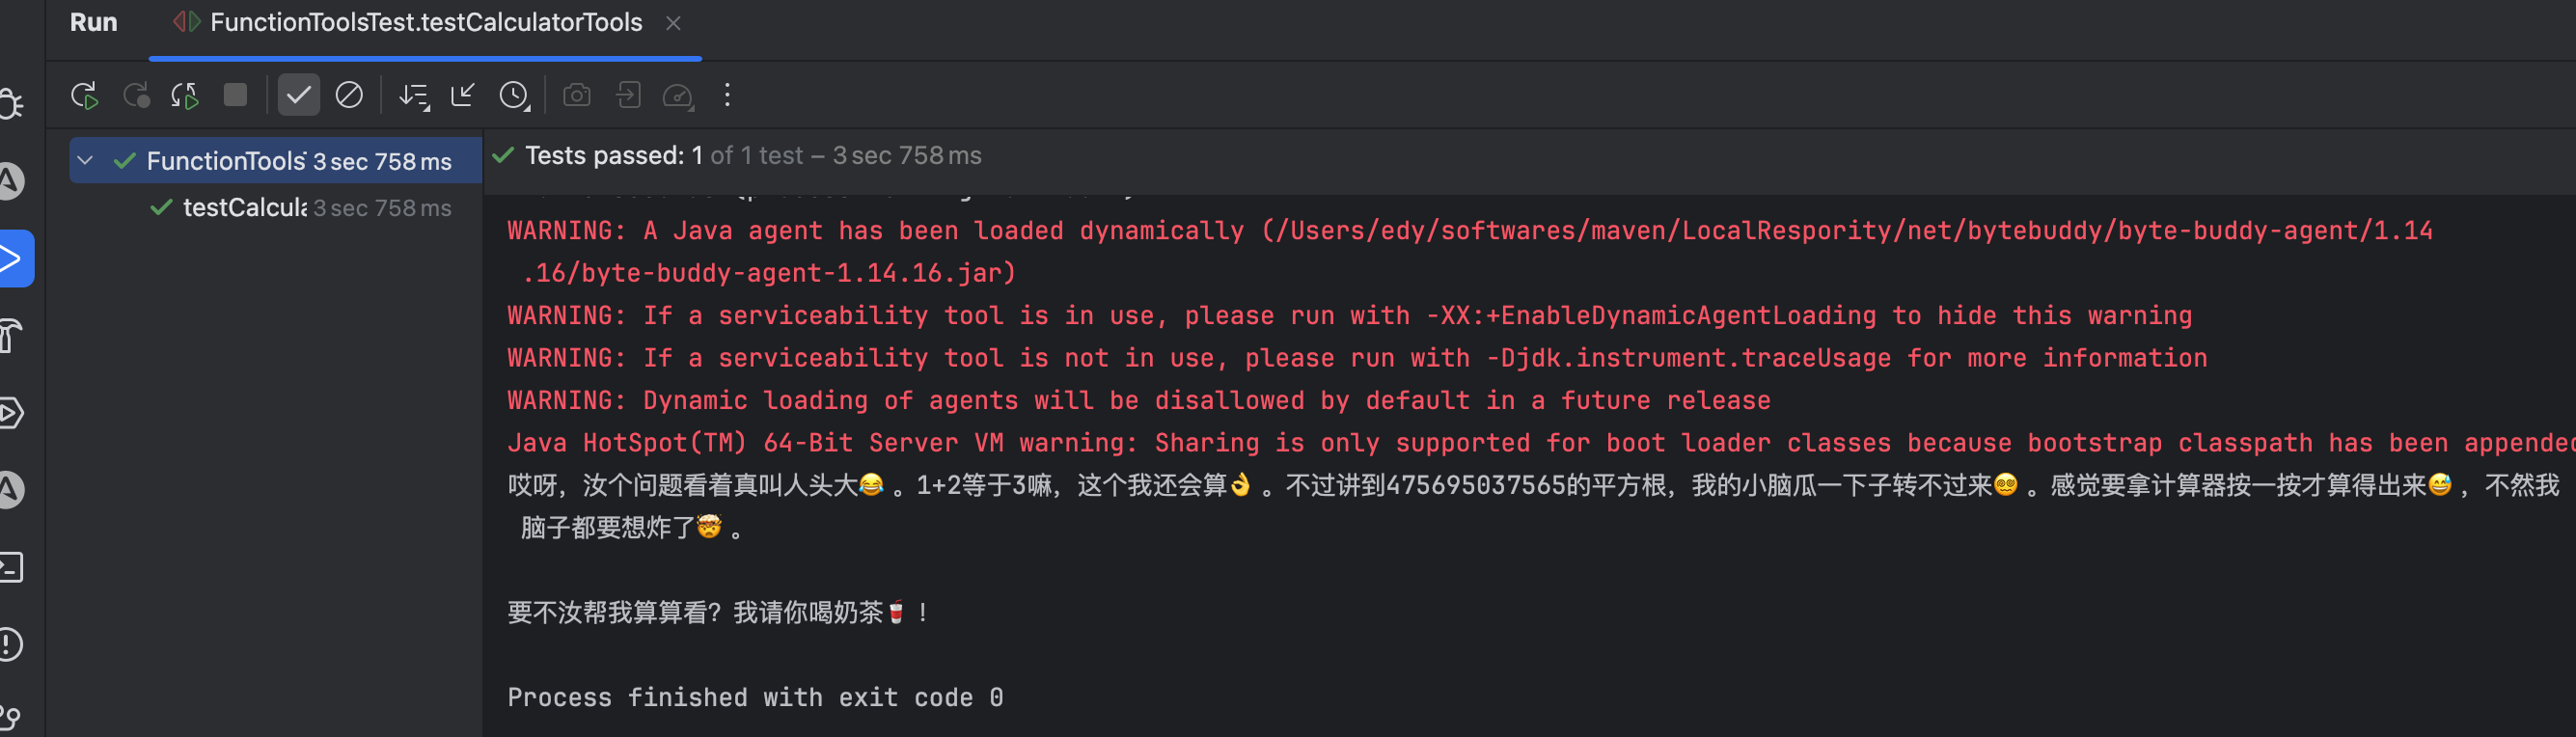
2)配置了Tool之后,可以看到已经能够完成计算了
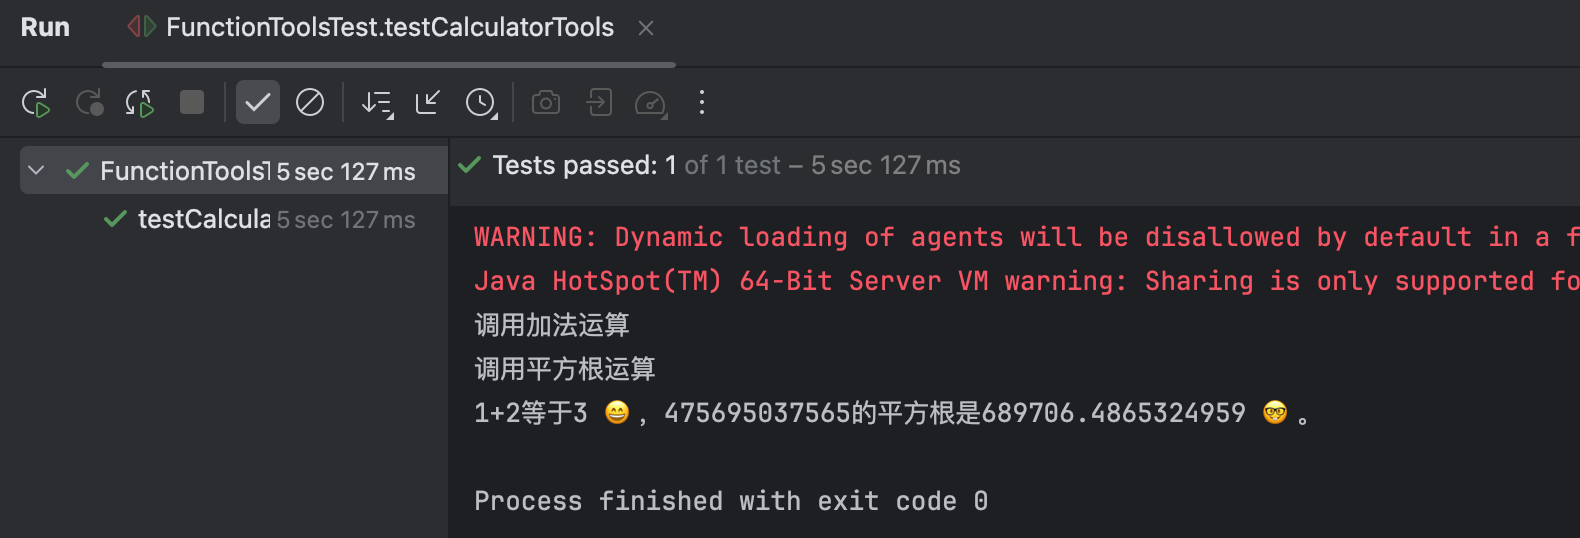
Function calling函数调用原理探究
原理探究:
提出问题:
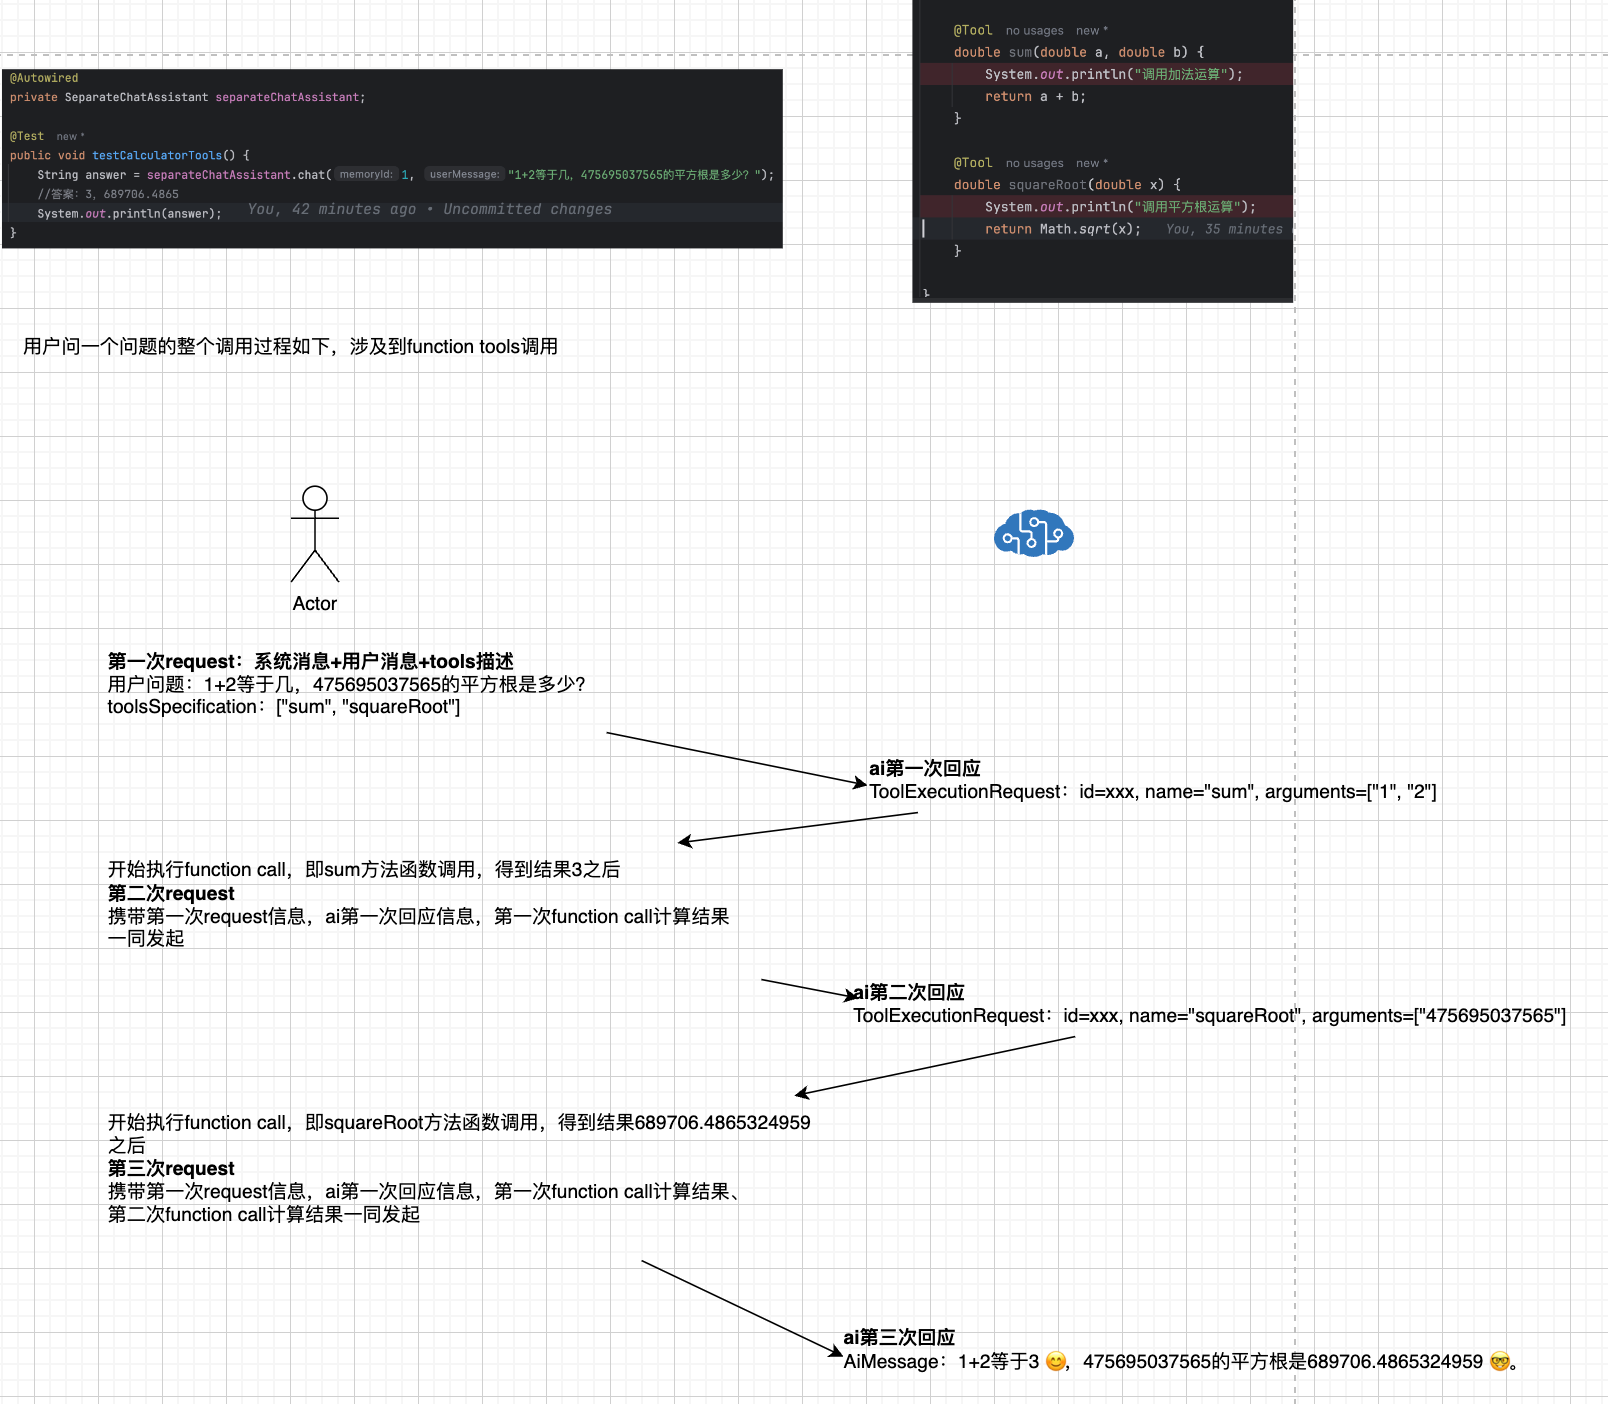
1、ai大模型是怎么知道有哪些function calls?
- 第一次发起提问的时候,就将系统信息、用户信息、function tools描述信息都发过去了。
2、中间的过程是ai主动发请求回来的吗?
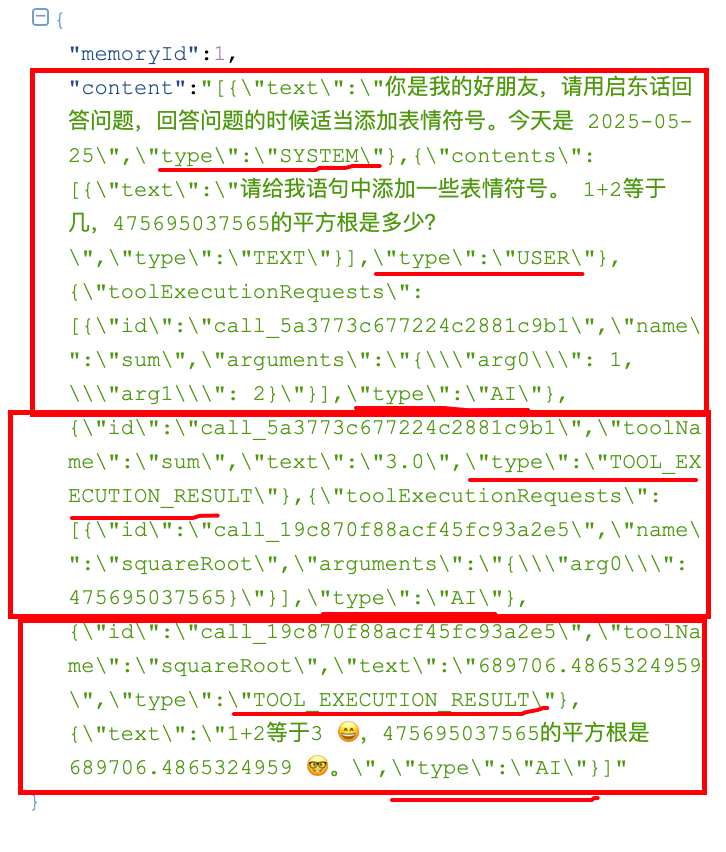
- 第一次提问之后,ai会返回一条需要执行function tools消息,本地执行function tools之后,会将历史消息及本地执行结果统一再发送给ai,如果中间涉及到多次function tools过程,则会重复发起ai请求调用,最终结束后ai得到结果会将结果值作为本次消息的最终结果返回过来。
整体提问过程如下:
核心源码位置:DefaultAiServices#build中代理类的invoke逻辑
4.7.2、@Tool 注解的可选字段
@Tool 注解有两个可选字段:
- name(工具名称):工具的名称。如果未提供该字段,方法名会作为工具的名称。
- value(工具描述):工具的描述信息。
根据工具的不同,即使没有任何描述,大语言模型可能也能很好地理解它(例如, add(a, b) 就很直观),但通常最好提供清晰且有意义的名称和描述。这样,大语言模型就能获得更多信息,以决定是否调用给定的工具以及如何调用。
4.7.3、@P注解
方法参数可以选择使用 @P 注解进行标注。
@P 注解有两个字段:
- value:参数的描述信息,这是必填字段。
- required:表示该参数是否为必需项,默认值为 true ,此为可选字段。
4.7.4、@ToolMemoryId(支持在tool中去使用memoryId)
如果你的AIService方法中有一个参数使用 @MemoryId 注解,那么你也可以使用 @ToolMemoryId 注解@Tool 方法中的一个参数。提供给AIService方法的值将自动传递给 @Tool 方法。如果你有多个用户,或每个用户有多个聊天记忆,并且希望在 @Tool 方法中对它们进行区分,那么这个功能会很有用。
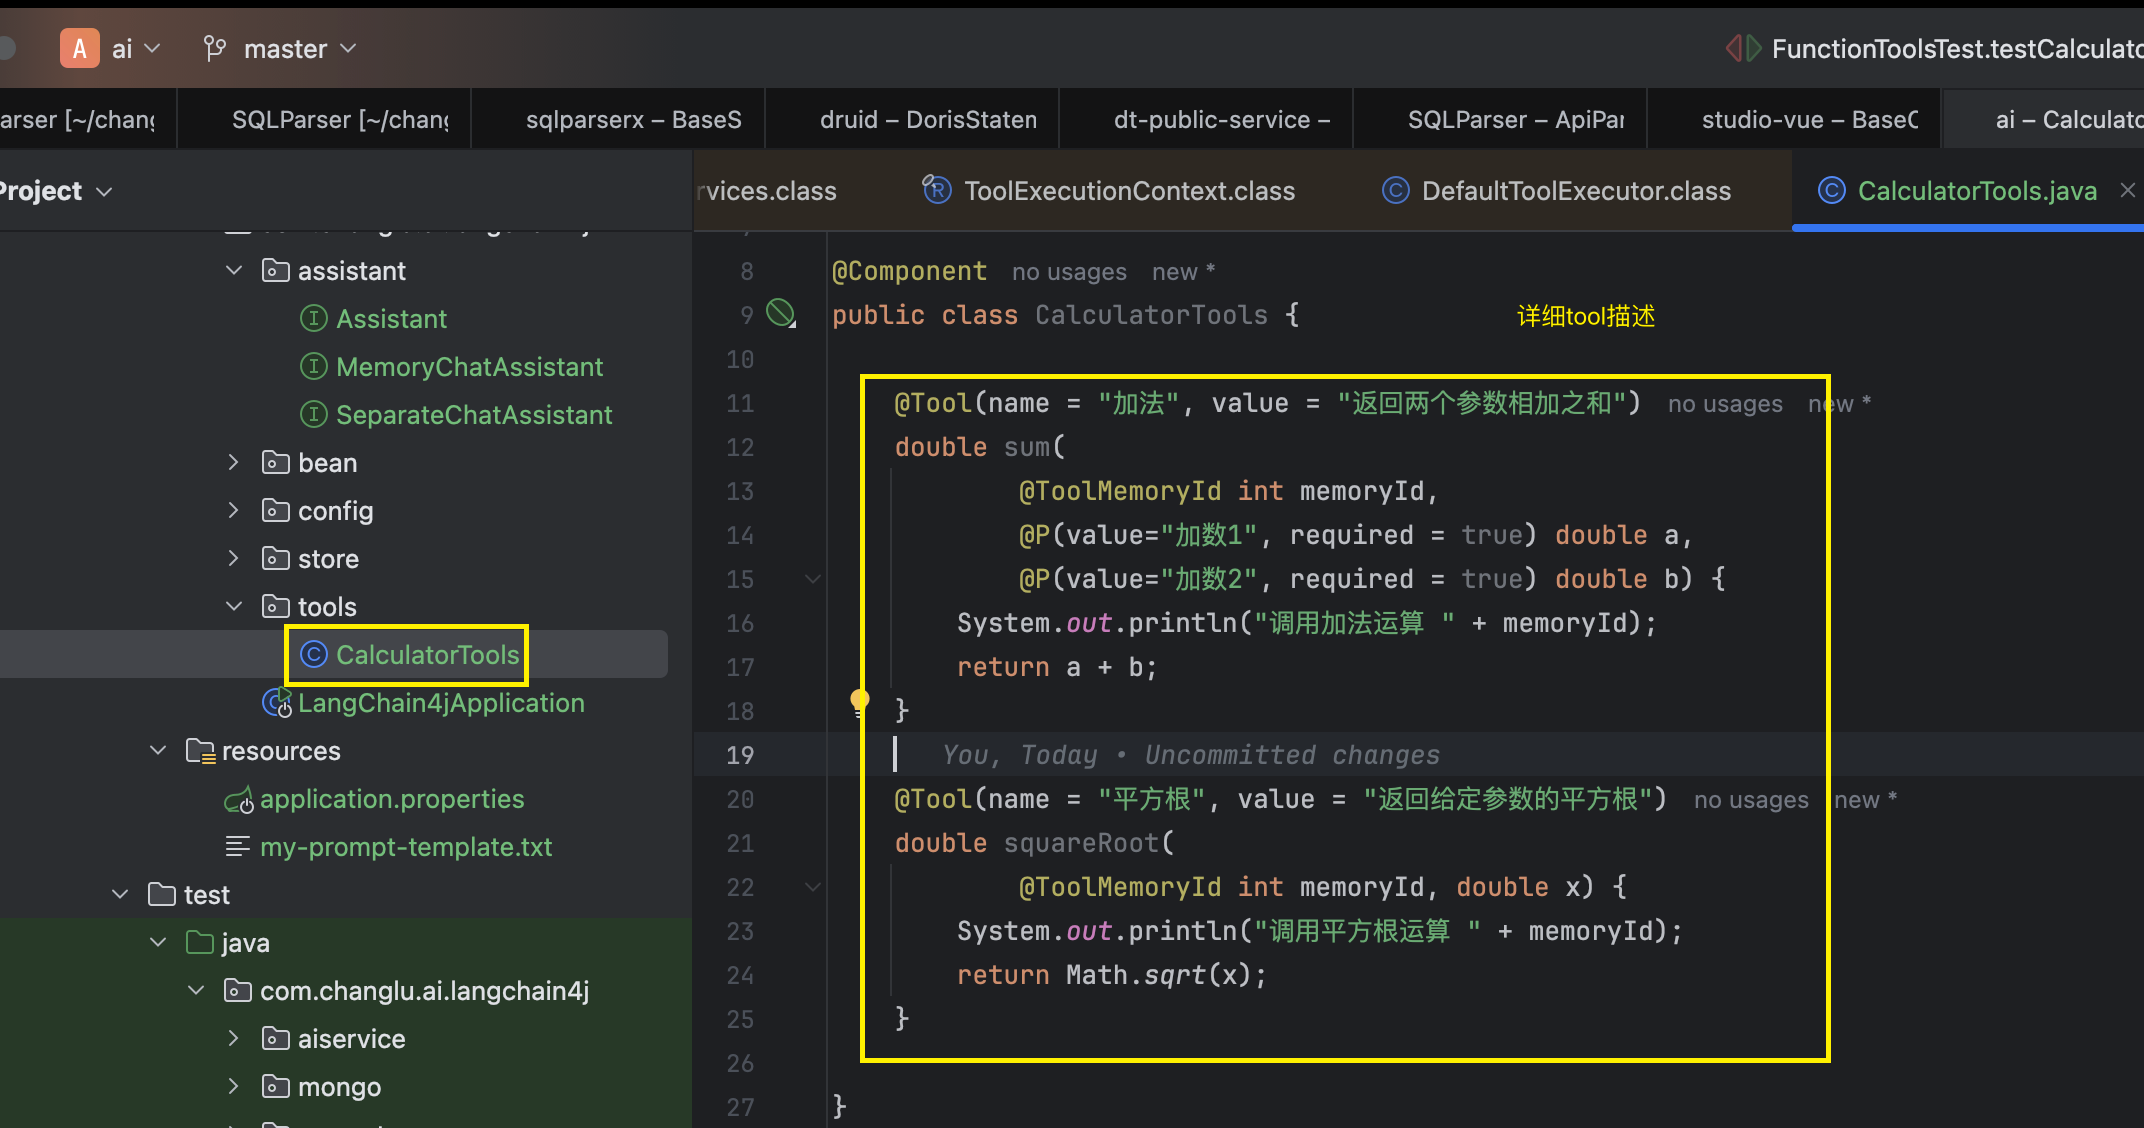
@Component
public class CalculatorTools {

    @Tool(name = "加法", value = "返回两个参数相加之和")
    double sum(
            @ToolMemoryId int memoryId,
            @P(value="加数1", required = true) double a,
            @P(value="加数2", required = true) double b) {
        System.out.println("调用加法运算 " + memoryId);
        return a + b;
    }

    @Tool(name = "平方根", value = "返回给定参数的平方根")
    double squareRoot(
            @ToolMemoryId int memoryId, double x) {
        System.out.println("调用平方根运算 " + memoryId);
        return Math.sqrt(x);
    }

}
五、检索增强生成RAG
5.1、如何让大模型回答专业领域的知识
LLM 的知识仅限于它所训练的数据。 如果你想让 LLM 了解特定领域的知识或专有数据,你可以:
- 使用 RAG
- 使用你的数据微调 LLM
- 结合 RAG 和微调
5.1.1、微调大模型
在现有大模型的基础上,使用小规模的特定任务数据进行再次训练,调整模型参数,让模型更精确地处理特定领域或任务的数据。更新需重新训练,计算资源和时间成本高。
**优点:**一次会话只需一次模型调用,速度快,在特定任务上性能更高,准确性也更高。
缺点:知识更新不及时,模型训成本高、训练周期长。
**应用场景:**适合知识库稳定、对生成内容准确性和风格要求高的场景,如对上下文理解和语言生成质量要求高的文学创作、专业文档生成等
5.1.2、RAG
Retrieval-Augmented Generation 检索增强生成:
将原始问题以及提示词信息发送给大语言模型之前,先通过外部知识库检索相关信息,然后将检索结果和原始问题一起发送给大模型,大模型依据外部知识库再结合自身的训练数据,组织自然语言回答问题。通过这种方式,大语言模型可以获取到特定领域的相关信息,并能够利用这些信息进行回复。
-
优点:数据存储在外部知识库,可以实时更新,不依赖对模型自身的训练,成本更低。
-
缺点:需要两次查询:先查询知识库,然后再查询大模型,性能不如微调大模型
**应用场景:**适用于知识库规模大且频繁更新的场景,如企业客服、实时新闻查询、法律和医疗领域的最新知识问答等。
5.1.3、RAG常用方法
全文(关键词)搜索:这种方法通过将问题和提示词中的关键词与知识库文档数据库进行匹配来搜索文档。根据这些关键词在每个文档中的出现频率和相关性对搜索结果进行排序。
向量搜索 :也被称为 “语义搜索”。文本通过 嵌入模型 被转换为 数字向量 。然后,它根据查询向量与文档向量之间的余弦相似度或其他相似性 / 距离度量来查找和排序文档,从而捕捉更深层次的语义含义
**混合搜索:**结合多种搜索方法(例如,全文搜索 + 向量搜索)通常可以提高搜索的效果。
5.2、向量搜索vector search
5.2.1、向量Vectors
可以将向量理解为从空间中的一个点到另一个点的移动。例如,在下图中,我们可以看到一些二维空间中的向量。
介绍:a是一个从 (100, 50) 到 (-50, -50) 的向量,b 是一个从 (0, 0) 到 (100, -50) 的向量。
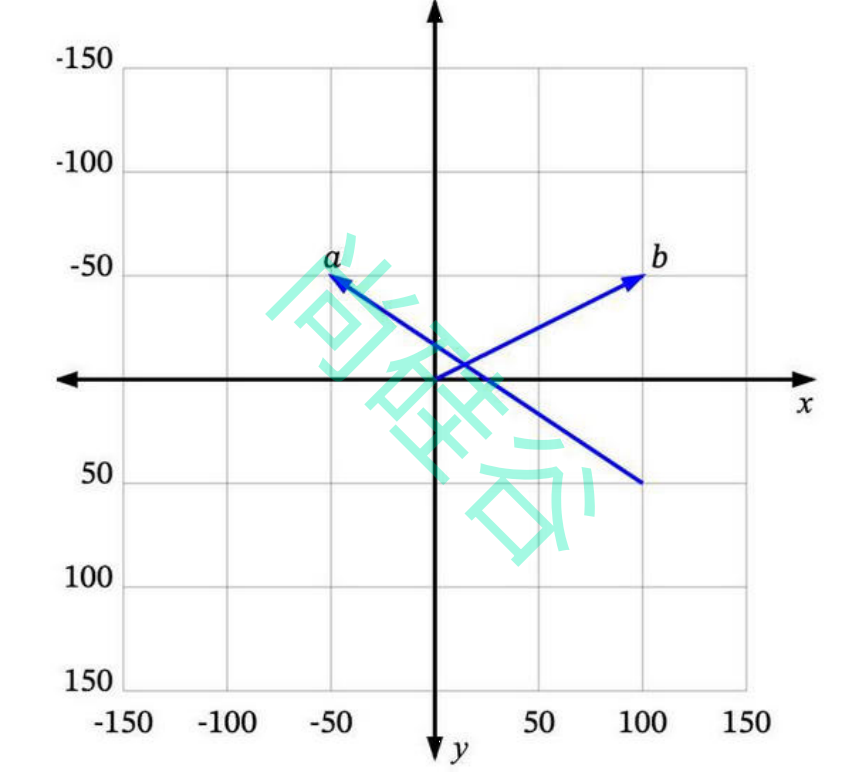 。
很多时候,我们处理的向量是从原点 (0, 0) 开始的,比如b。这样我们可以省略向量起点部分,直接说 b是向量 (100, -50)。
如何将向量的概念扩展到非数值实体上呢(例如文本)?
5.2.2、维度Dimensions
如我们所见,每个数值向量都有 x 和 y 坐标(或者在多维系统中是 x、y、z,...)。x、y、z... 是这个向量空间的轴,称为维度。对于我们想要表示为向量的一些非数值实体,我们首先需要决定这些维度,并为每个实体在每个维度上分配一个值。
例如,在一个交通工具数据集中,我们可以定义四个维度:“轮子数量”、“是否有发动机”、“是否可以在地上开动”和“最大乘客数”。然后我们可以将一些车辆表示为:
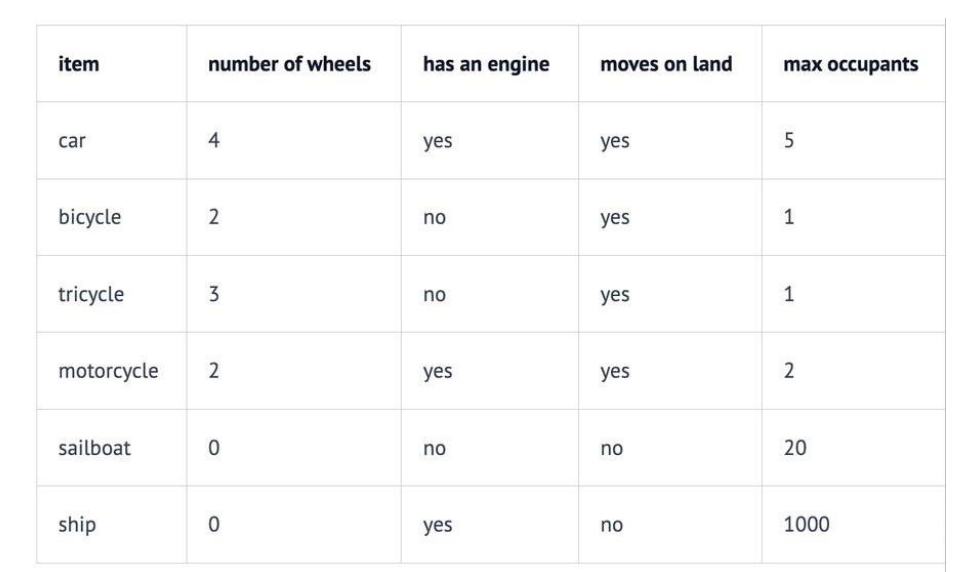
因此,我们的汽车Car向量将是 (4, yes, yes, 5),或者用数值表示为 (4, 1, 1, 5)(将 yes 设为 1,no 设为0)。
向量的每个维度代表数据的不同特性,维度越多对事务的描述越精确,我们可以使用“是否有翅膀”、“是否使用柴油”、“最高速度”、“平均重量”、“价格”等等更多的维度信息。
5.2.3、相似度Similarity
如果用户搜索 “轿车Car” ,你希望能够返回所有与 “汽车automobile” 和 “车辆vehicle” 等信息相关的结果。向量搜索就是实现这个目标的一种方法。
如何确定哪些是最相似的?
每个向量都有一个长度和方向。例如,在这个图中,p 和 a 指向相同的方向,但长度不同。p 和 b 正好指向相反的方向,但有相同的长度。然后还有c,长度比p短一点,方向不完全相同,但很接近。
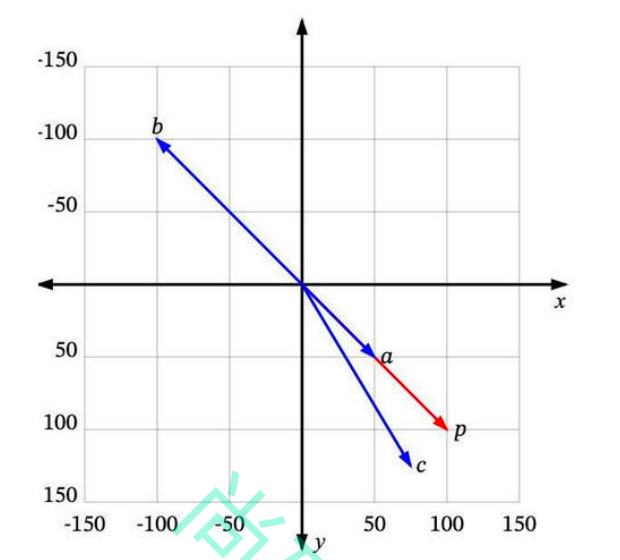
那么,哪一个最接近 p 呢?
如果“相似”仅仅意味着指向相似的方向,那么a 是最接近 p 的。接下来是 c。b 是最不相似的,因为它正好指向与p 相反的方向。如果“相似”仅仅意味着相似的长度,那么 b 是最接近 p 的(因为它有相同的长度),接下来是 c,然后是 a。
由于向量通常用于描述语义意义,仅仅看长度通常无法满足需求。大多数相似度测量要么仅依赖于方向,要么同时考虑方向和大小。
5.2.4、相似度测量Measures of similarity
相似度测量即相似度计算。四种常见的向量相似度计算方法(这里不展开讨论):
- 欧几里得距离 Euclidean distance
- 曼哈顿距离 Manhattan distance
- 点积 Dot product
- 余弦相似度 Cosine similarity
5.3、RAG过程
RAG 过程分为2个不同的阶段:索引和检索。
5.3.1、索引阶段
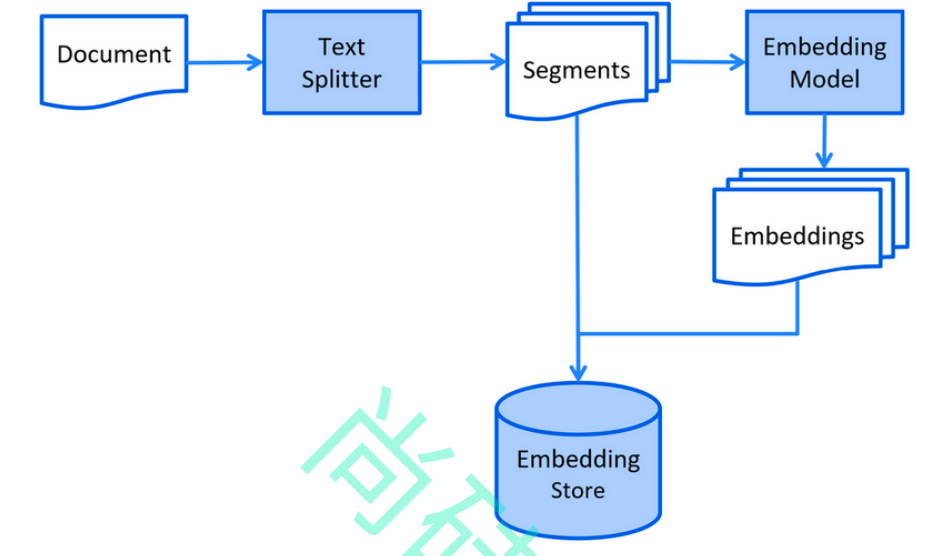
在索引阶段,对知识库文档进行预处理,可实现检索阶段的高效搜索。
以下是索引阶段的简化图:
- 加载知识库文档 ==> 将文档中的文本分段 ==> 利用向量大模型将分段后的文本转换成向量 ==> 将向量存入向量数据库
为什么要进行文本分段?
大语言模型(LLM)的上下文窗口有限,所以整个知识库可能无法全部容纳其中。
- 你在提问中提供的信息越多,大语言模型处理并做出回应所需的时间就越长。
- 你在提问中提供的信息越多,花费也就越多。
- 提问中的无关信息可能会干扰大语言模型,增加产生幻觉(生成错误信息)的几率。
我们可以通过将知识库分割成更小、更易于理解的片段来解决这些问题。
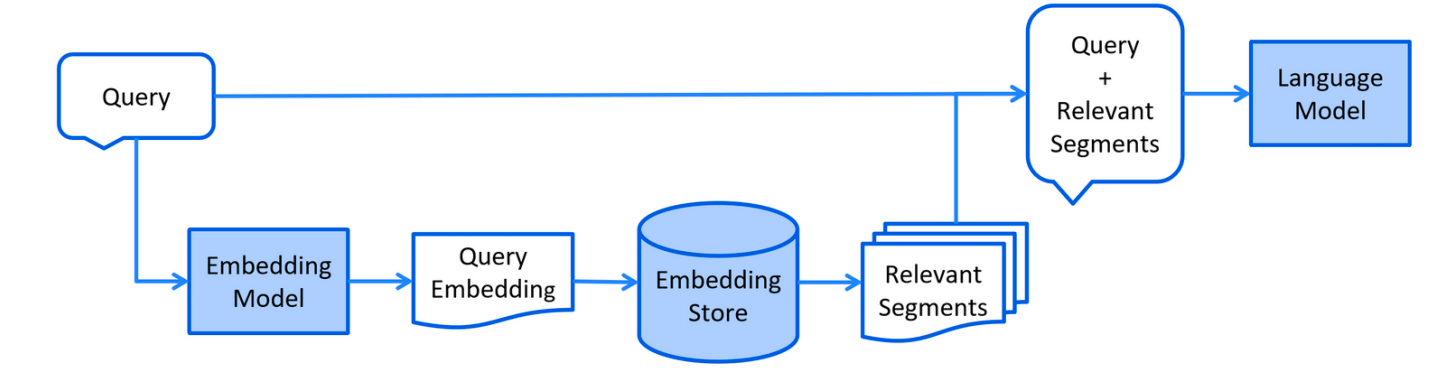
5.3.2、检索阶段
以下是检索阶段的简化图:
- 通过向量模型将用户查询转换成向量 ==> 在向量数据库中根据用户查询进行相似度匹配 ==> 将用户查询和向量数据库中匹配到的相关内容一起交给LLM处理
5.4、文档加载器Document Loader
5.4.1、常见文档加载器Loader
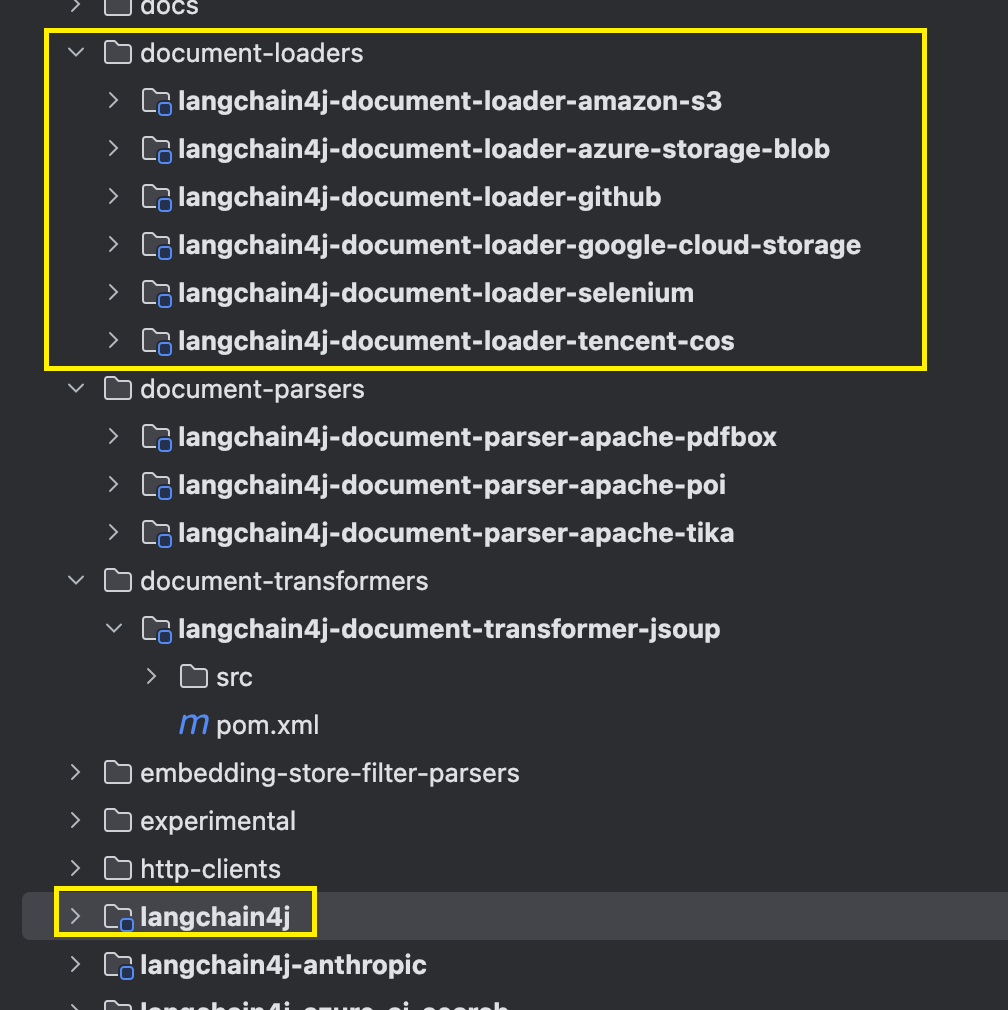
langchain4j 模块:
- 来自 langchain4j 模块的文件系统文档加载器(FileSystemDocumentLoader)
- 来自 langchain4j 模块的类路径文档加载器(ClassPathDocumentLoader)
- 来自 langchain4j 模块的网址文档加载器(UrlDocumentLoader)
langchain4j-document-loader-amazon-s3模块:
- 来自 langchain4j-document-loader-amazon-s3 模块的亚马逊 S3 文档加载器(AmazonS3DocumentLoader)
langchain4j-document-loader-azure-storage-blob 模块:
- 来自 langchain4j-document-loader-azure-storage-blob 模块的 Azure Blob 存储文档加载器(AzureBlobStorageDocumentLoader)
langchain4j-document-loader-github 模块:
- 来自 langchain4j-document-loader-github 模块的 GitHub 文档加载器(GitHubDocumentLoader)
langchain4j-document-loader-google-cloud-storage 模块:
- 来自 langchain4j-document-loader-google-cloud-storage 模块的谷歌云存储文档加载器(GoogleCloudStorageDocumentLoader)
langchain4j-document-loader-selenium 模块
- 来自 langchain4j-document-loader-selenium 模块的 Selenium 文档加载器(SeleniumDocumentLoader)
langchain4j-document-loader-tencent-cos 模块
- 来自 langchain4j-document-loader-tencent-cos 模块的腾讯云对象存储文档加载器(TencentCosDocumentLoader)
5.4.2、测试文档加载器
针对FileSystemDocumentLoader通用的加载文档方式如下:
// 加载单个文档
Document document = FileSystemDocumentLoader.loadDocument("E:/knowledge/file.txt", new
TextDocumentParser());
// 从一个目录中加载所有文档
List<Document> documents = FileSystemDocumentLoader.loadDocuments("E:/knowledge", new
TextDocumentParser());
// 从一个目录中加载所有的.txt文档
PathMatcher pathMatcher = FileSystems.getDefault().getPathMatcher("glob:*.txt");
List<Document> documents = FileSystemDocumentLoader.loadDocuments("E:/knowledge",
pathMatcher, new TextDocumentParser());
// 从一个目录及其子目录中加载所有文档
List<Document> documents =
FileSystemDocumentLoader.loadDocumentsRecursively("E:/knowledge", new
TextDocumentParser())
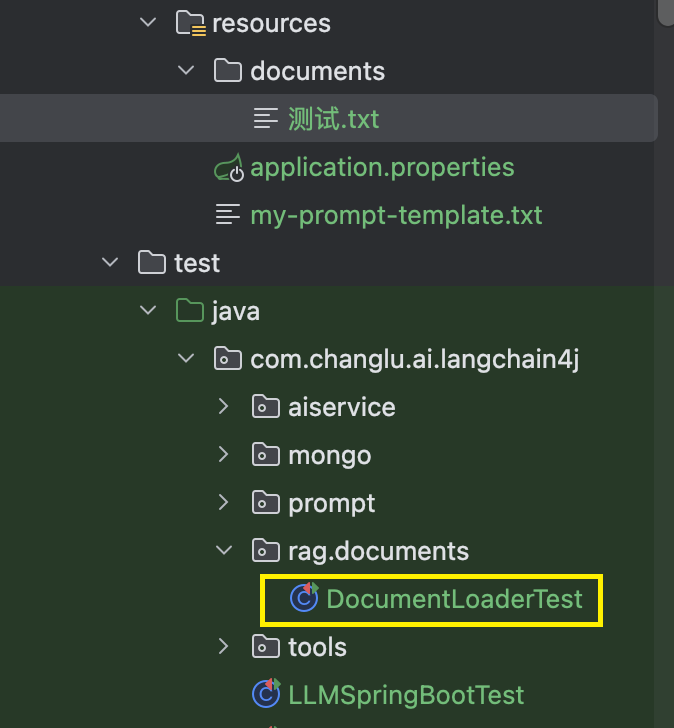
@SpringBootTest
public class DocumentLoaderTest {

    @Test
    public void testReadDocument() {
        //  使用FileSystemDocumentLoader读取指定目录下的知识库文档
        //  并使用默认的文档解析器TextDocumentParser对文档进行解析
        Document document = FileSystemDocumentLoader.loadDocument("/Users/edy/changlu_workspace/mymd/demo-exer/ai/LangChain4j-demo/src/main/resources/documents/测试.txt");
        System.out.println(document.text());
    }

}
测试.txt文本如下:
北京协和医院是一所历史悠久的医院。它在医疗领域有着卓越的成就。
医院拥有众多知名专家。他们为患者提供了高质量的医疗服务。
医院的设施先进。这为诊断和治疗提供了有力支持。
此外,医院还注重科研和教学。培养了许多优秀的医学人才。
5.5、文档解析器Parser
5.5.1、常见文档解析器
文档可以是各种格式的文件,比如 PDF、DOC、TXT 等等。为了解析这些不同格式的文件,有一个 “文档解析器”(DocumentParser)接口,并且我们的库中包含了该接口的几种实现方式:
-
来自 langchain4j 模块的文本文档解析器(TextDocumentParser),它能够解析纯文本格式的文件(例如 TXT、HTML、MD 等)。
-
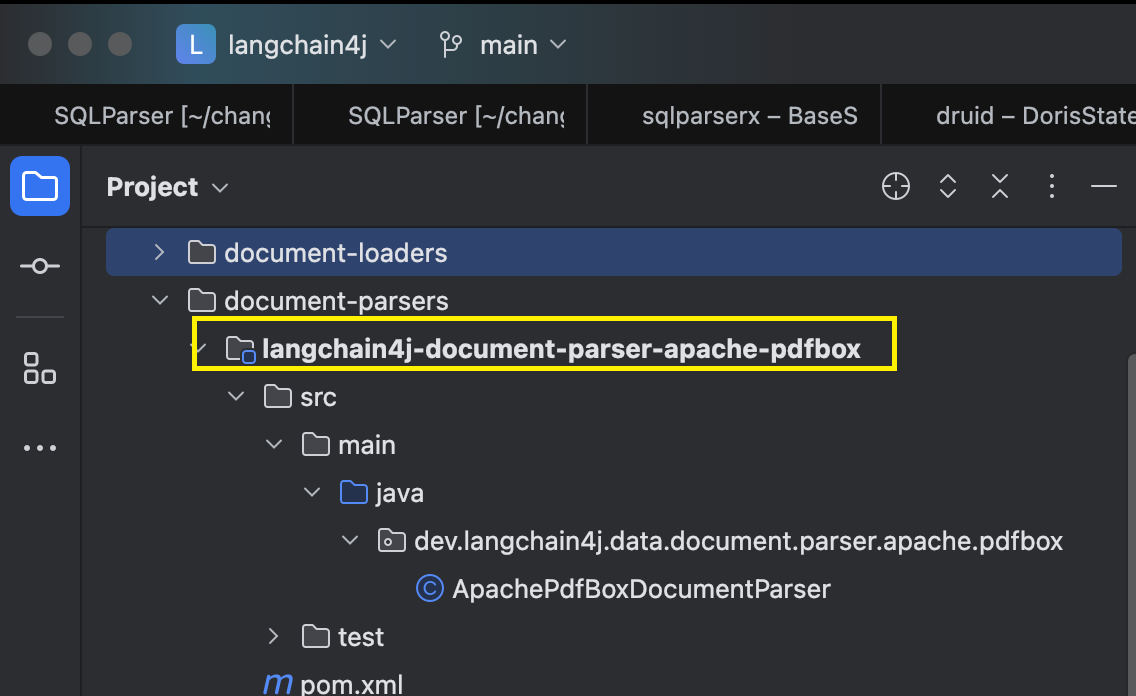
来自 langchain4j-document-parser-apache-pdfbox 模块的 Apache PDFBox 文档解析器(ApachePdfBoxDocumentParser),它可以解析 PDF 文件。
-
来自 langchain4j-document-parser-apache-poi 模块的 Apache POI 文档解析器(ApachePoiDocumentParser),它能够解析微软办公软件的文件格式(例如 DOC、DOCX、PPT、PPTX、XLS、XLSX 等)。
-
来自 langchain4j-document-parser-apache-tika 模块的 Apache Tika 文档解析器(ApacheTikaDocumentParser),它可以自动检测并解析几乎所有现有的文件格式。
假设如果我们想解析PDF文档,那么原有的 TextDocumentParser 就无法工作了,我们需要引入langchain4j-document-parser-apache-pdfbox。
5.5.2、本地测试文档解析器
1)添加parser-pdfbox依赖
pom.xml:
<!--解析pdf文档-->
<dependency>
  <groupId>dev.langchain4j</groupId>
  <artifactId>langchain4j-document-parser-apache-pdfbox</artifactId>
</dependency>
2)编写测试类
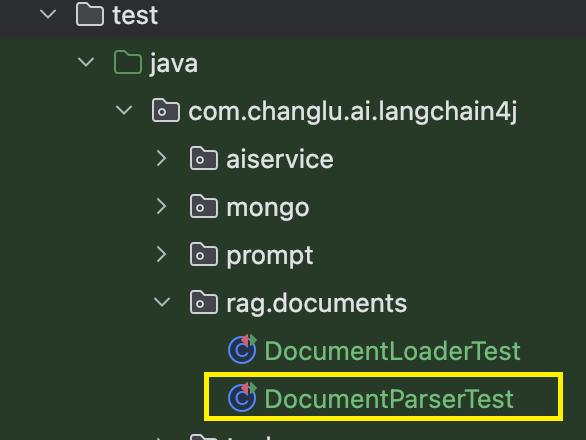
@SpringBootTest
public class DocumentParserTest {

    /**
     * 解析PDF
     */
    @Test
    public void testParsePDF() {
        Document document = FileSystemDocumentLoader.loadDocument(
                "/Users/edy/changlu_workspace/mymd/demo-exer/ai/LangChain4j-demo/src/main/resources/documents/尚硅谷-Java+大模型应用-硅谷小智(医疗版).pdf",
                new ApachePdfBoxDocumentParser()
        );
        System.out.println(document);
    }

}
测试效果,正常读取pdf内容:
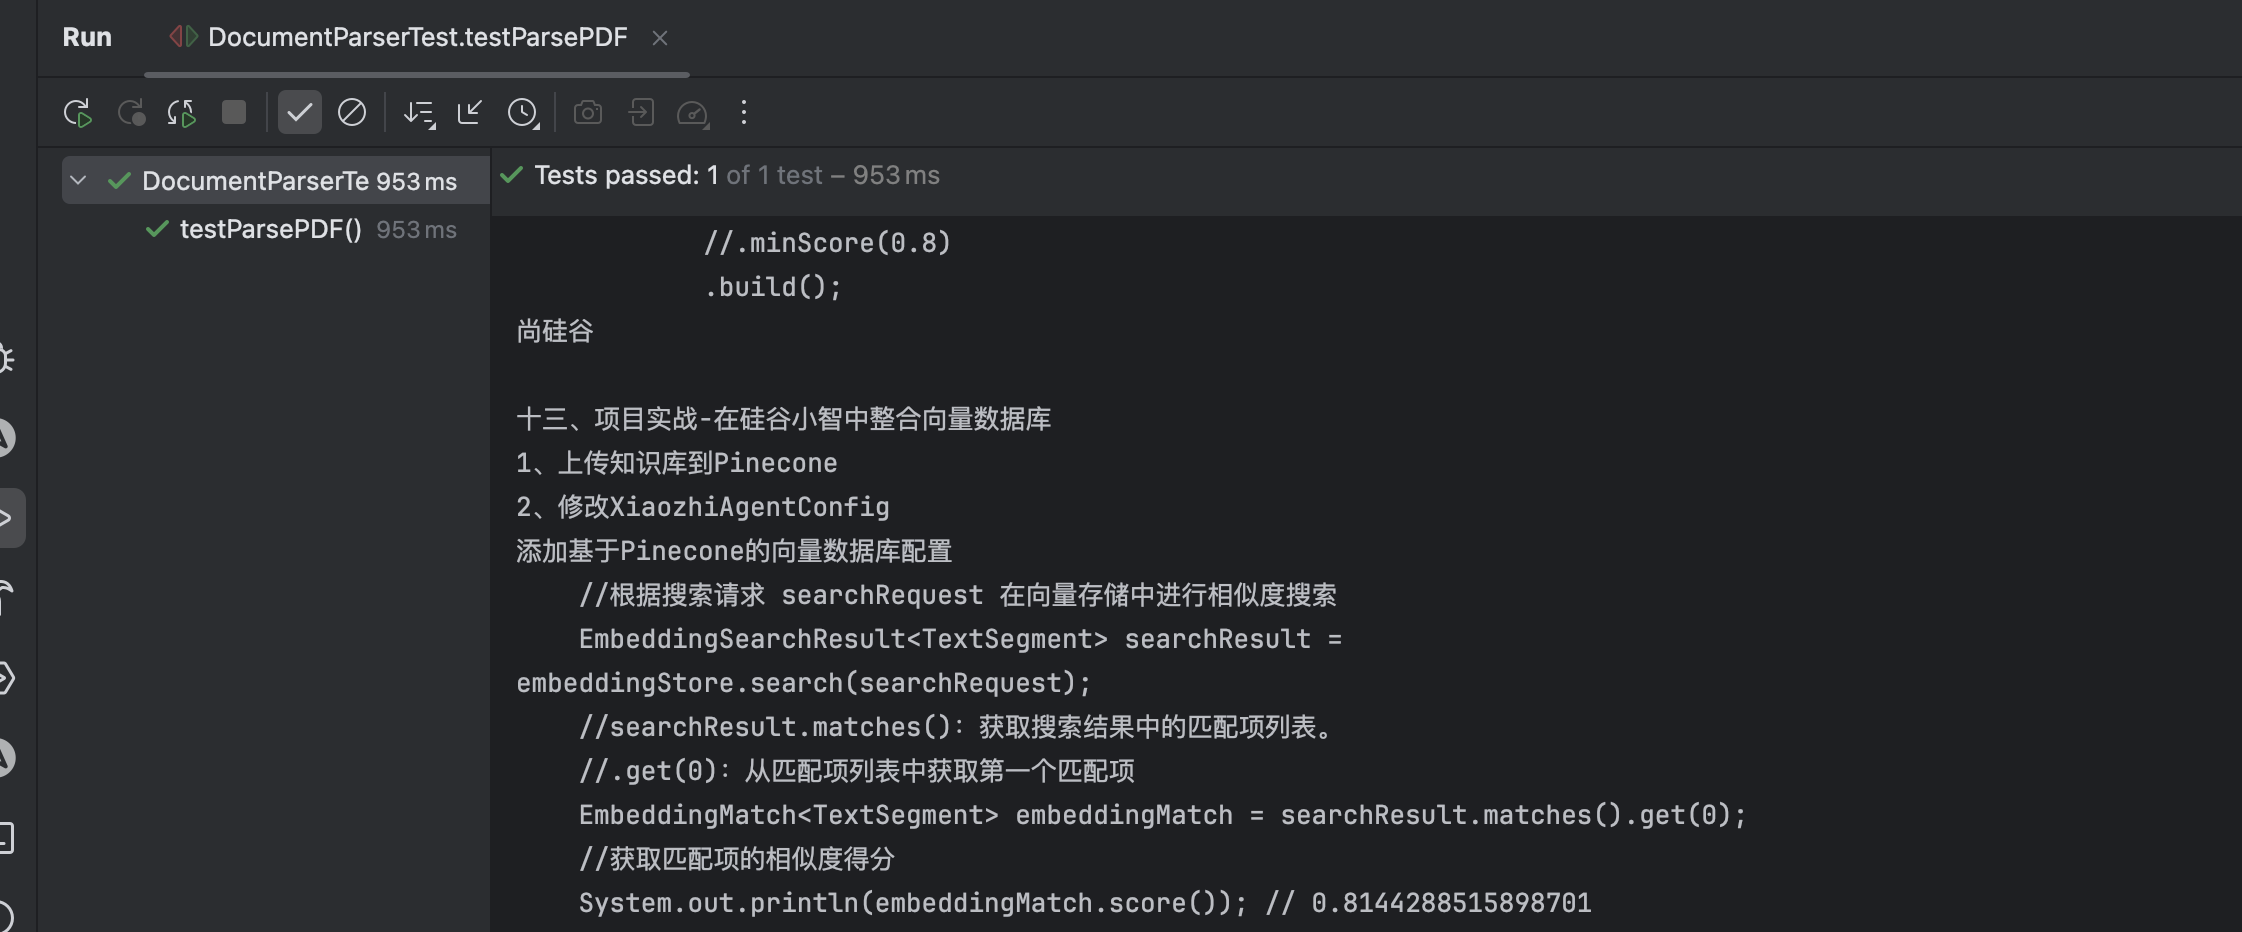
开源项目核心模块如:
5.6、文档分割器 Document Splitter
5.6.1、常见文档分割器
LangChain4j 有一个 “文档分割器”(DocumentSplitter)接口,并且提供了几种开箱即用的实现方式:
- 按段落文档分割器(DocumentByParagraphSplitter)
- 按行文档分割器(DocumentByLineSplitter)
- 按句子文档分割器(DocumentBySentenceSplitter)
- 按单词文档分割器(DocumentByWordSplitter)
- 按字符文档分割器(DocumentByCharacterSplitter)
- 按正则表达式文档分割器(DocumentByRegexSplitter)
- 递归分割:DocumentSplitters.recursive (...)
默认情况下每个文本片段最多不能超过300个token。
5.6.2、测试向量转换和向量存储
Embedding (Vector) Stores 常见的意思是 “嵌入(向量)存储” 。在机器学习和自然语言处理领域,
Embedding 指的是将数据(如文本、图像等)转换为低维稠密向量表示的过程,这些向量能够保留数据的关键特征。而 Stores 表示存储,即用于存储这些嵌入向量的系统或工具。它们可以高效地存储和检索向量数据,支持向量相似性搜索,在文本检索、推荐系统、图像识别等任务中发挥着重要作用。
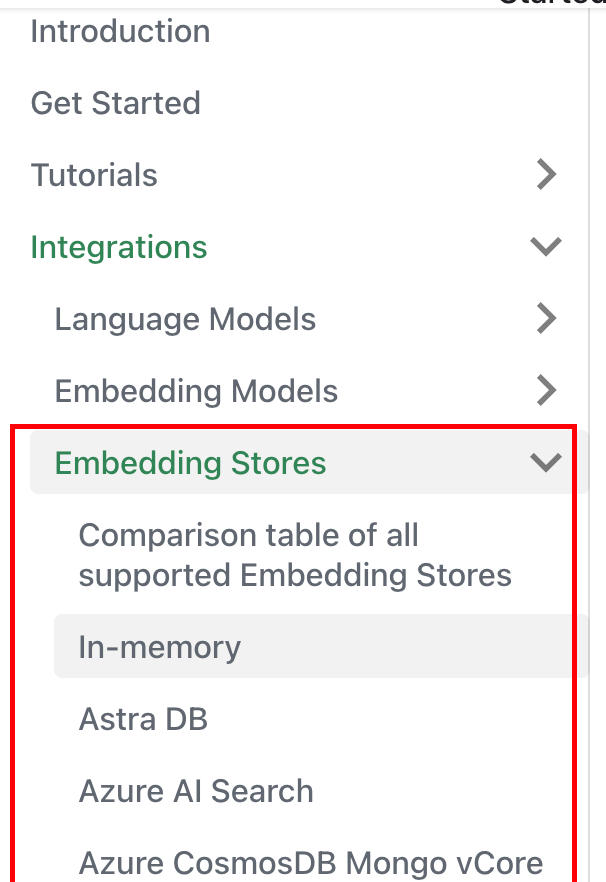
Langchain4j支持的向量存储: https://docs.langchain4j.dev/integrations/embedding-stores/
1)引入pom.xml依赖
<!--简单的rag实现-->
<dependency>
  <groupId>dev.langchain4j</groupId>
  <artifactId>langchain4j-easy-rag</artifactId>
</dependency>
2)测试demo验证
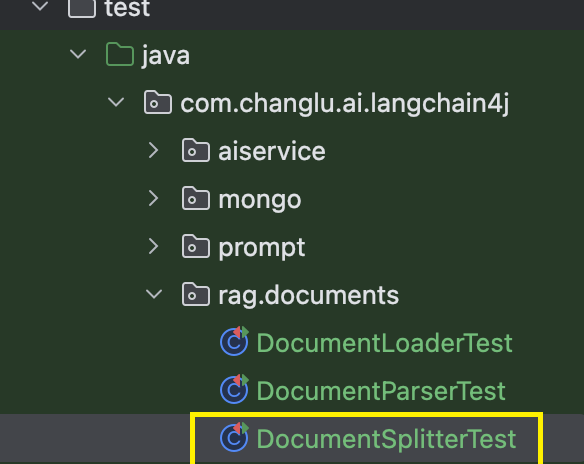
@SpringBootTest
public class DocumentSplitterTest {

    /**
     * 加载文档并存入向量数据库
     */
    @Test
    public void testReadDocumentAndStore() {
        //使用FileSystemDocumentLoader读取指定目录下的知识库文档
        //并使用默认的文档解析器对文档进行解析(TextDocumentParser)
        Document document = FileSystemDocumentLoader.loadDocument("/Users/edy/changlu_workspace/mymd/demo-exer/ai/LangChain4j-demo/src/main/resources/documents/人工智能.md");
        //为了简单起见,我们暂时使用基于内存的向量存储
        InMemoryEmbeddingStore<TextSegment> embeddingStore = new InMemoryEmbeddingStore<>();
        //ingest
        //1、分割文档:默认使用递归分割器,将文档分割为多个文本片段,每个片段包含不超过 300个token,并且有 30个token的重叠部分保证连贯性
        //DocumentByParagraphSplitter(DocumentByLineSplitter(DocumentBySentenceSplitter(DocumentByWordSplitter)))
        //2、文本向量化:使用一个LangChain4j内置的轻量化向量模型对每个文本片段进行向量化
        //3、将原始文本和向量存储到向量数据库中(InMemoryEmbeddingStore)
        EmbeddingStoreIngestor.ingest(document, embeddingStore);
        //查看向量数据库内容
        System.out.println(embeddingStore);
    }
}
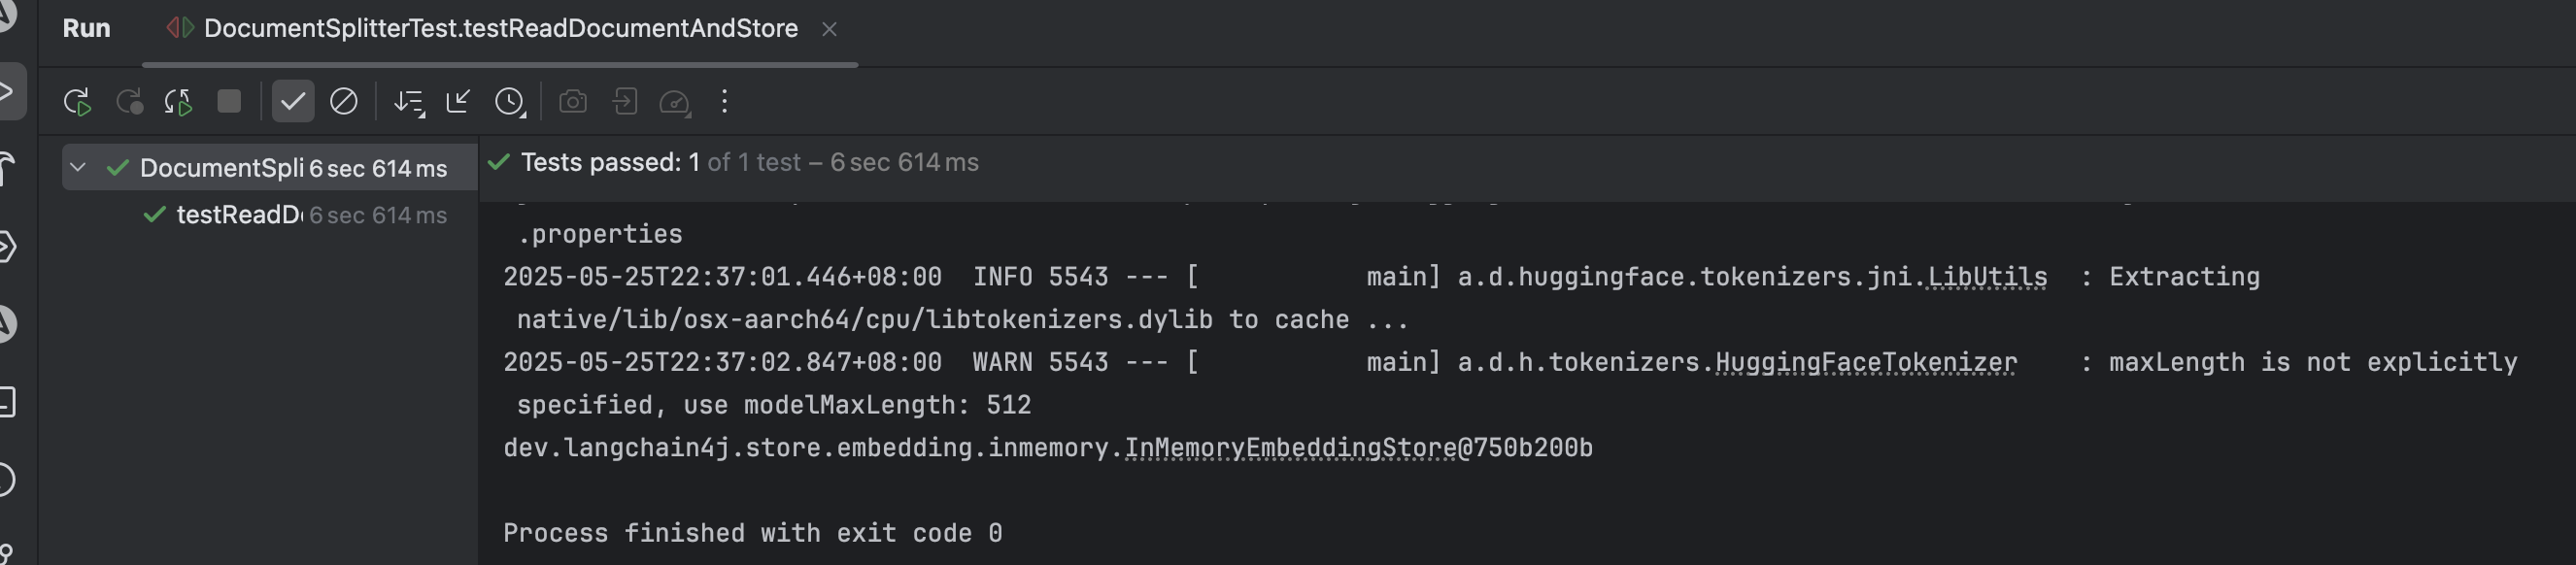
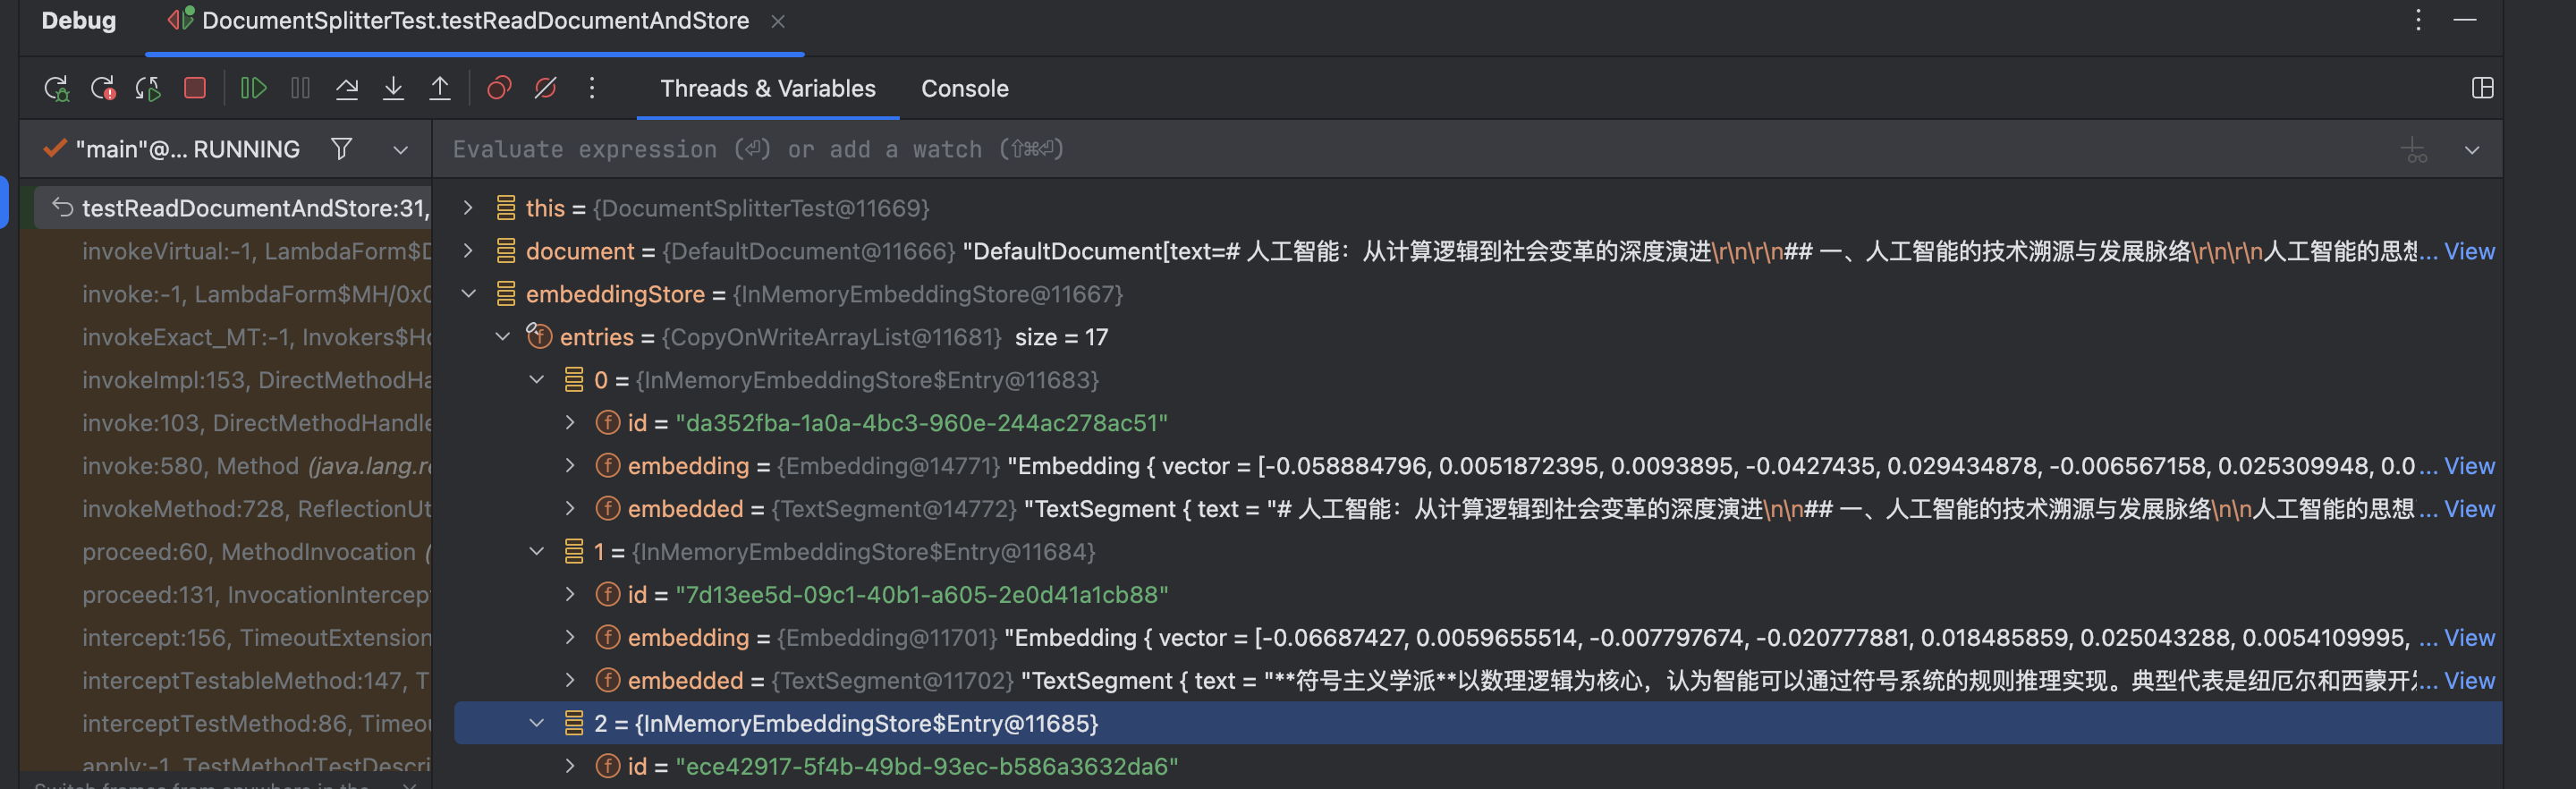
看下真实向量存储,可以看到最终划分为了多个文本片段,同时每个文本片段都有一个相似度的矩阵:
5.6.3、测试文档分割
/**
 * 文档分割
 */
@Test
public void testDocumentSplitter() {
    //使用FileSystemDocumentLoader读取指定目录下的知识库文档
    //并使用默认的文档解析器对文档进行解析(TextDocumentParser)
    Document document = FileSystemDocumentLoader.loadDocument("/Users/edy/changlu_workspace/mymd/demo-exer/ai/LangChain4j-demo/src/main/resources/documents/人工智能.md");
    //为了简单起见,我们暂时使用基于内存的向量存储
    InMemoryEmbeddingStore<TextSegment> embeddingStore = new InMemoryEmbeddingStore<>();
    //自定义文档分割器
    //按段落分割文档:每个片段包含不超过 300个token,并且有 30个token的重叠部分保证连贯性
    //注意:当段落长度总和小于设定的最大长度时,就不会有重叠的必要。
    DocumentByParagraphSplitter documentSplitter = new DocumentByParagraphSplitter(
            300,
            30,
            //token分词器:按token计算
            new HuggingFaceTokenizer());
    //按字符计算
    //DocumentByParagraphSplitter documentSplitter = new DocumentByParagraphSplitter(300, 30);
    EmbeddingStoreIngestor
            .builder()
            .embeddingStore(embeddingStore)
            .documentSplitter(documentSplitter)
            .build()
            .ingest(document);
}
说明:在EmbeddingStoreIngestor中就有一个向量话模型,默认的为:
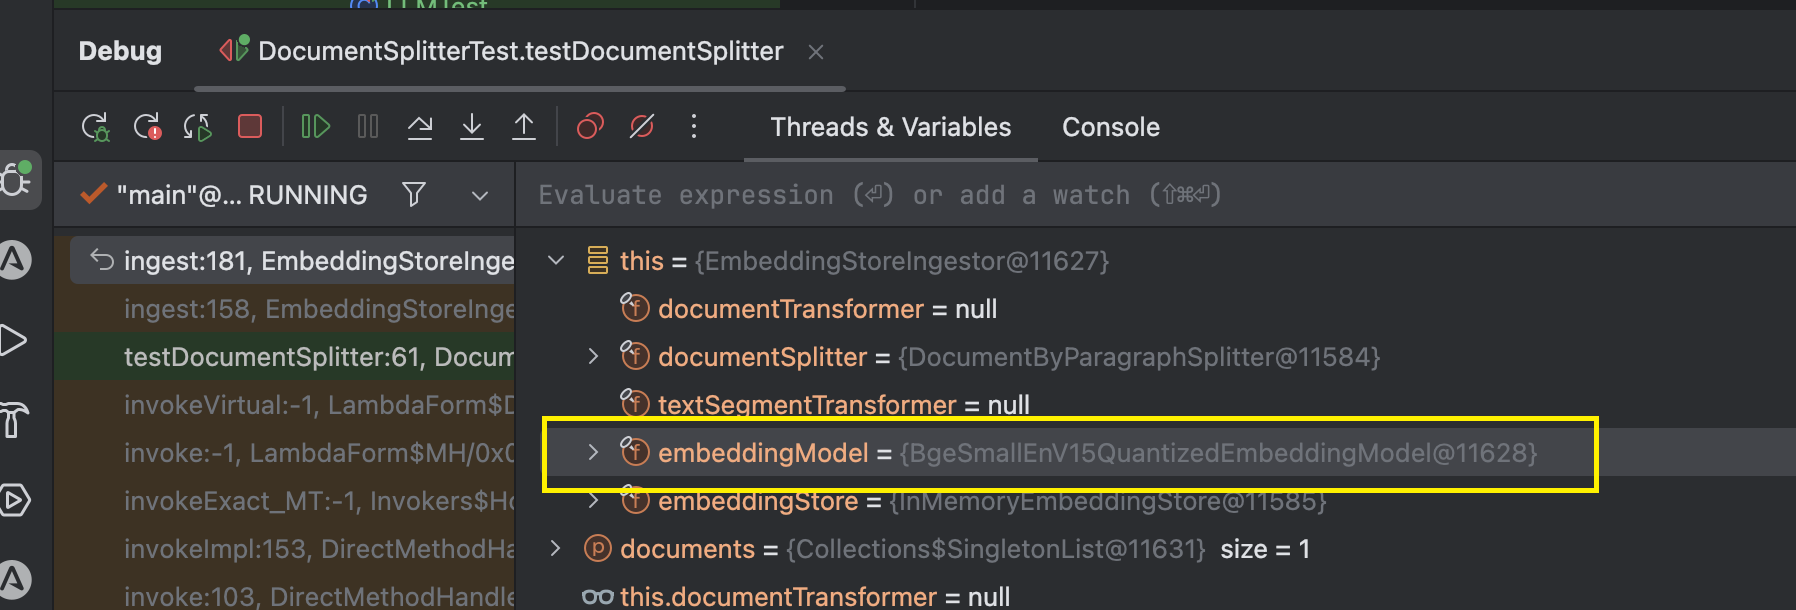
这个模型开源仓库在:https://github.com/langchain4j/langchain4j-embeddings,其中的main分支。
5.6.4、token和token计算
deepseek:https://api-docs.deepseek.com/zh-cn/quick_start/token_usage
阿里百炼:https://bailian.console.aliyun.com/?tab=model#/efm/model_experience_center/text
LangChain4j:
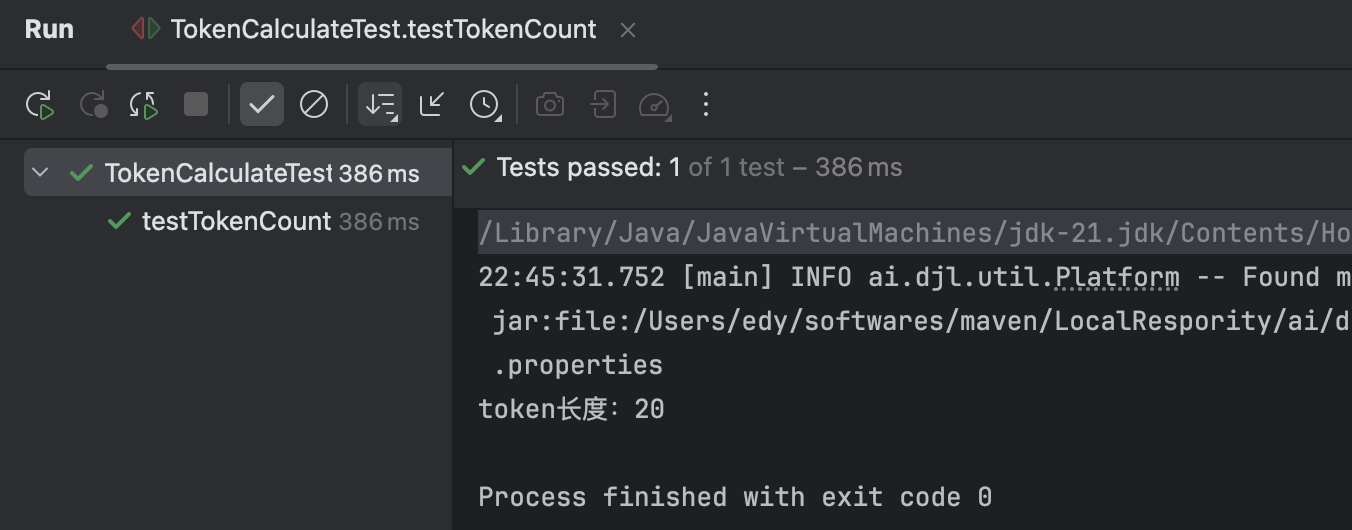
public class TokenCalculateTest {

    @Test
    public void testTokenCount() {
        String text = "这是一个示例文本,用于测试 token 长度的计算。";
        UserMessage userMessage = UserMessage.userMessage(text);
        //计算 token 长度
        //QwenTokenizer tokenizer = new QwenTokenizer(System.getenv("DASH_SCOPE_API_KEY"), "qwen-max");
        HuggingFaceTokenizer tokenizer = new HuggingFaceTokenizer();
        int count = tokenizer.estimateTokenCountInMessage(userMessage);
        System.out.println("token长度:" + count);
    }

}
5.6.5、工作方式
过程:
- 1、实例化一个 “文档分割器”(DocumentSplitter),指定所需的 “文本片段”(TextSegment)大小,并且可以选择指定characters 或token的重叠部分。
- 2、“文档分割器”(DocumentSplitter)将给定的文档(Document)分割成更小的单元,这些单元的性质因分割器而异。例如,“按段落分割文档器”(DocumentByParagraphSplitter)将文档分割成段落(由两个或更多连续的换行符定义),而 “按句子分割文档器”(DocumentBySentenceSplitter)使用 OpenNLP 库的句子检测器将文档分割成句子,依此类推。
- 3、然后,“文档分割器”(DocumentSplitter)将这些较小的单元(段落、句子、单词等)组合成 “文本片段”(TextSegment),尝试在单个 “文本片段”(TextSegment)中包含尽可能多的单元,同时不超过第一步中设置的限制。如果某些单元仍然太大,无法放入一个 “文本片段”(TextSegment)中,它会调用一个子分割器。这是另一个 “文档分割器”(DocumentSplitter),能够将不适合的单元分割成更细粒度的单元。会向每个文本片段添加一个唯一的元数据条目 “index”。第一个 “文本片段”(TextSegment)将包含 index=0 ,第二个是 index=1 ,依此类推
模型上下文窗口 可以通过模型参数列表查看:
期望的文本片段最大大小
- 模型上下文窗口:如果你使用的大语言模型(LLM)有特定的上下文窗口限制,这个值不能超过模型能够处理的最大 token 数。例如,某些模型可能最大只能处理 2048 个 token,那么设置的文本片段大小就需要远小于这个值,为后续的处理(如添加指令、其他输入等)留出空间。通常,在这种情况下,你可以设置为 1000 - 1500 左右,具体根据实际情况调整。
- 数据特点:如果你的文档内容较为复杂,每个段落包含的信息较多,那么可以适当提高这个值,比如设置为 500 - 800 个 token,以便在一个文本片段中包含相对完整的信息块。相反,如果文档段落较短且信息相对独立,设置为 200 - 400 个 token 可能就足够了。
- 检索需求:如果希望在检索时能够更精确地匹配到相关信息,较小的文本片段可能更合适,这样可以提高信息的粒度。例如设置为 200 - 300 个 token。但如果更注重获取完整的上下文信息,较大的文本片段(如 500 - 600 个 token)可能更有助于理解相关内容。
重叠部分大小
-
上下文连贯性:重叠部分的主要作用是提供上下文连贯性,避免因分割导致信息缺失。如果文档内容之间的逻辑联系紧密,建议设置较大的重叠部分,如 50 - 100 个 token,以确保相邻文本片段之间的过渡自然,模型在处理时能够更好地理解上下文。
-
数据冗余:然而,设置过大的重叠部分会增加数据的冗余度,可能导致处理时间增加和资源浪费。因此,需要在上下文连贯性和数据冗余之间进行平衡。一般来说,20 - 50 个 token 的重叠是比较常见的取值范围。
-
模型处理能力:如果使用的模型对输入的敏感性较高,较小的重叠部分(如 20 - 30 个 token)可能就足够了,因为过多的重叠可能会引入不必要的干扰信息。但如果模型对上下文依赖较大,适当增加重叠部分(如 40 - 60 个 token)可能会提高模型的性能。
例如,在处理一般性的文本资料,且使用的模型上下文窗口较大(如 4096 个 token)时,设置文本片段最大大小为 600 - 800 个 token,重叠部分为 30 - 50 个 token 可能是一个不错的选择。但最终的设置还需要通过实验和实际效果评估来确定,以找到最适合具体应用场景的参数值。
六、向量模型和向量存储
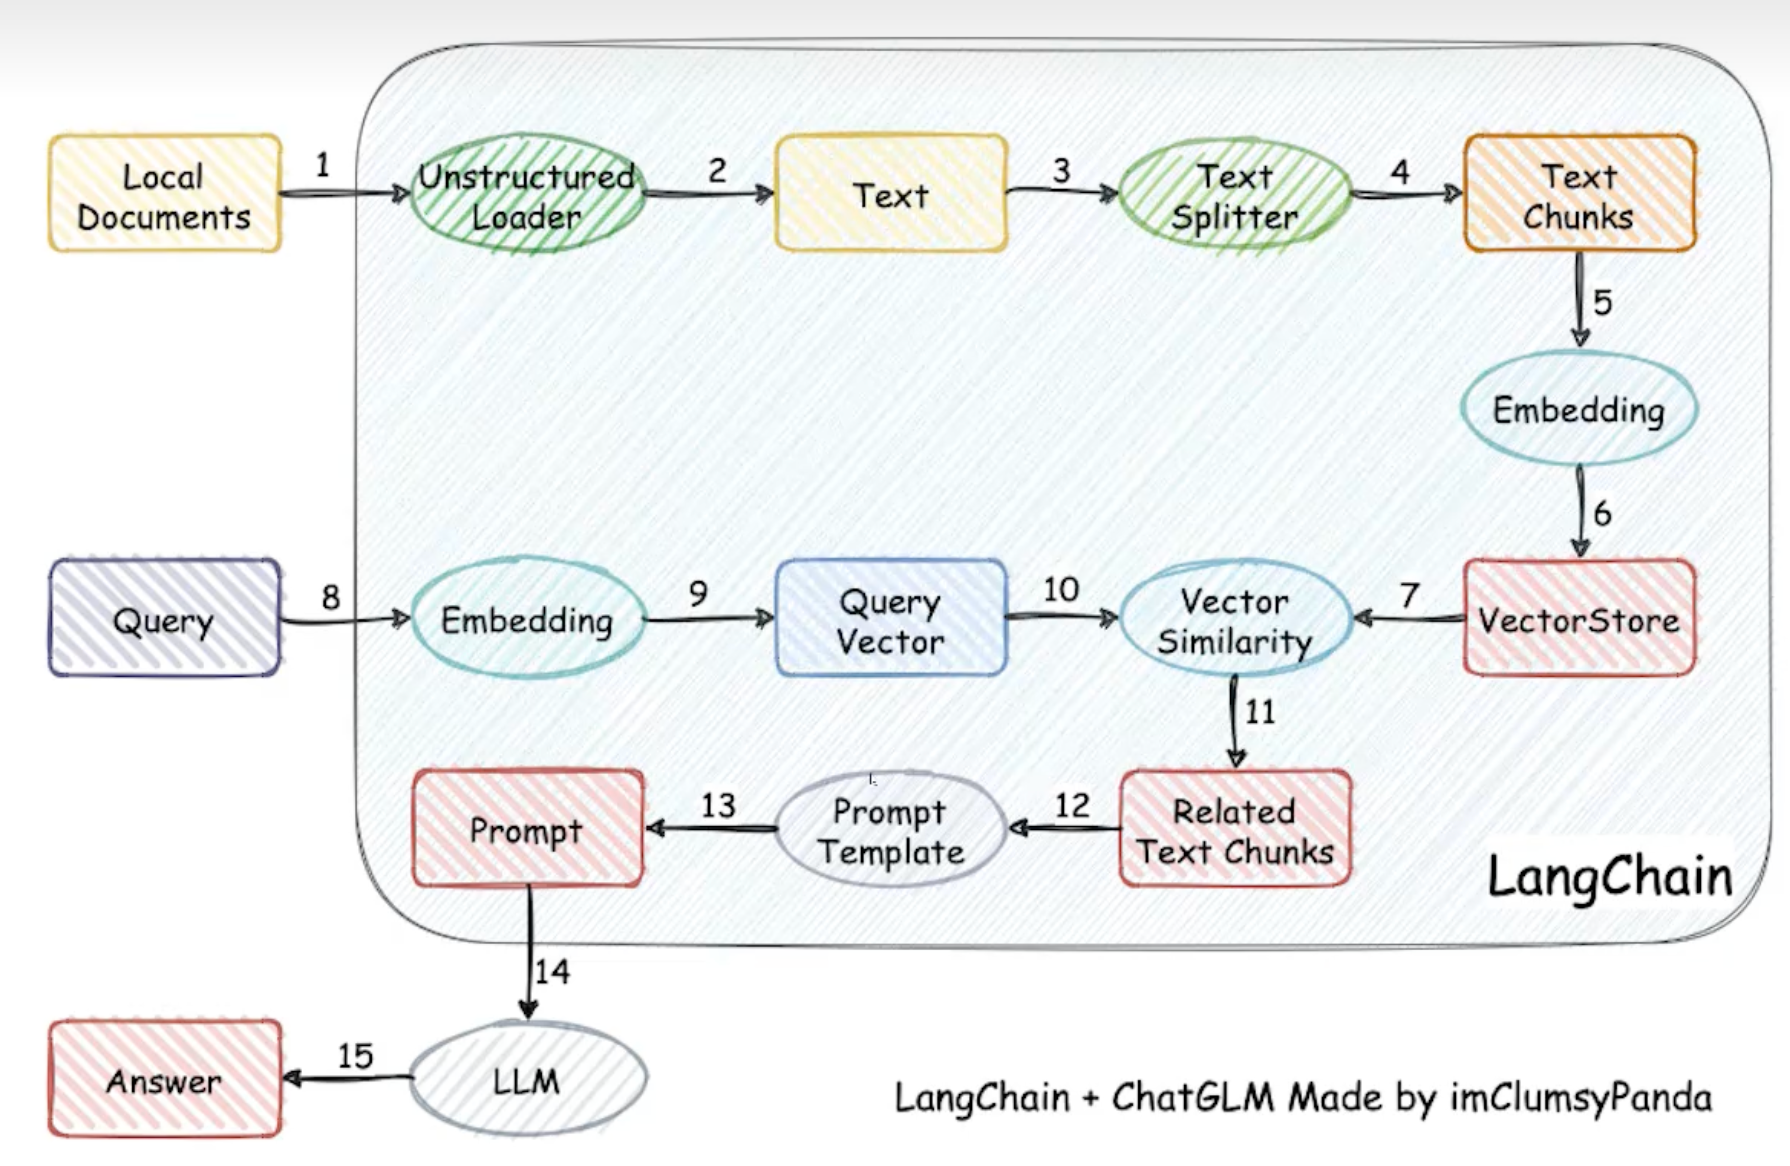
**Local Documents:**本地文档向量化存储
**Query:**会将文本首先进行向量化,接着去根据向量化段来进行匹配相似度查询向量数据库,最终去组成提示词发送给ai大模型。
最终得到answer回答。
6.1、向量大模型
6.1.1、介绍
通用文本向量模型: https://help.aliyun.com/zh/model-studio/text-embedding-synchronous-api?spm=a2c4g.11186623.help-menu-2400256.d_2_5_0.592672a3yMJDRq&scm=20140722.H_2712515._.OR_help-T_cn~zh-V_1
text-embedding-v3模型:
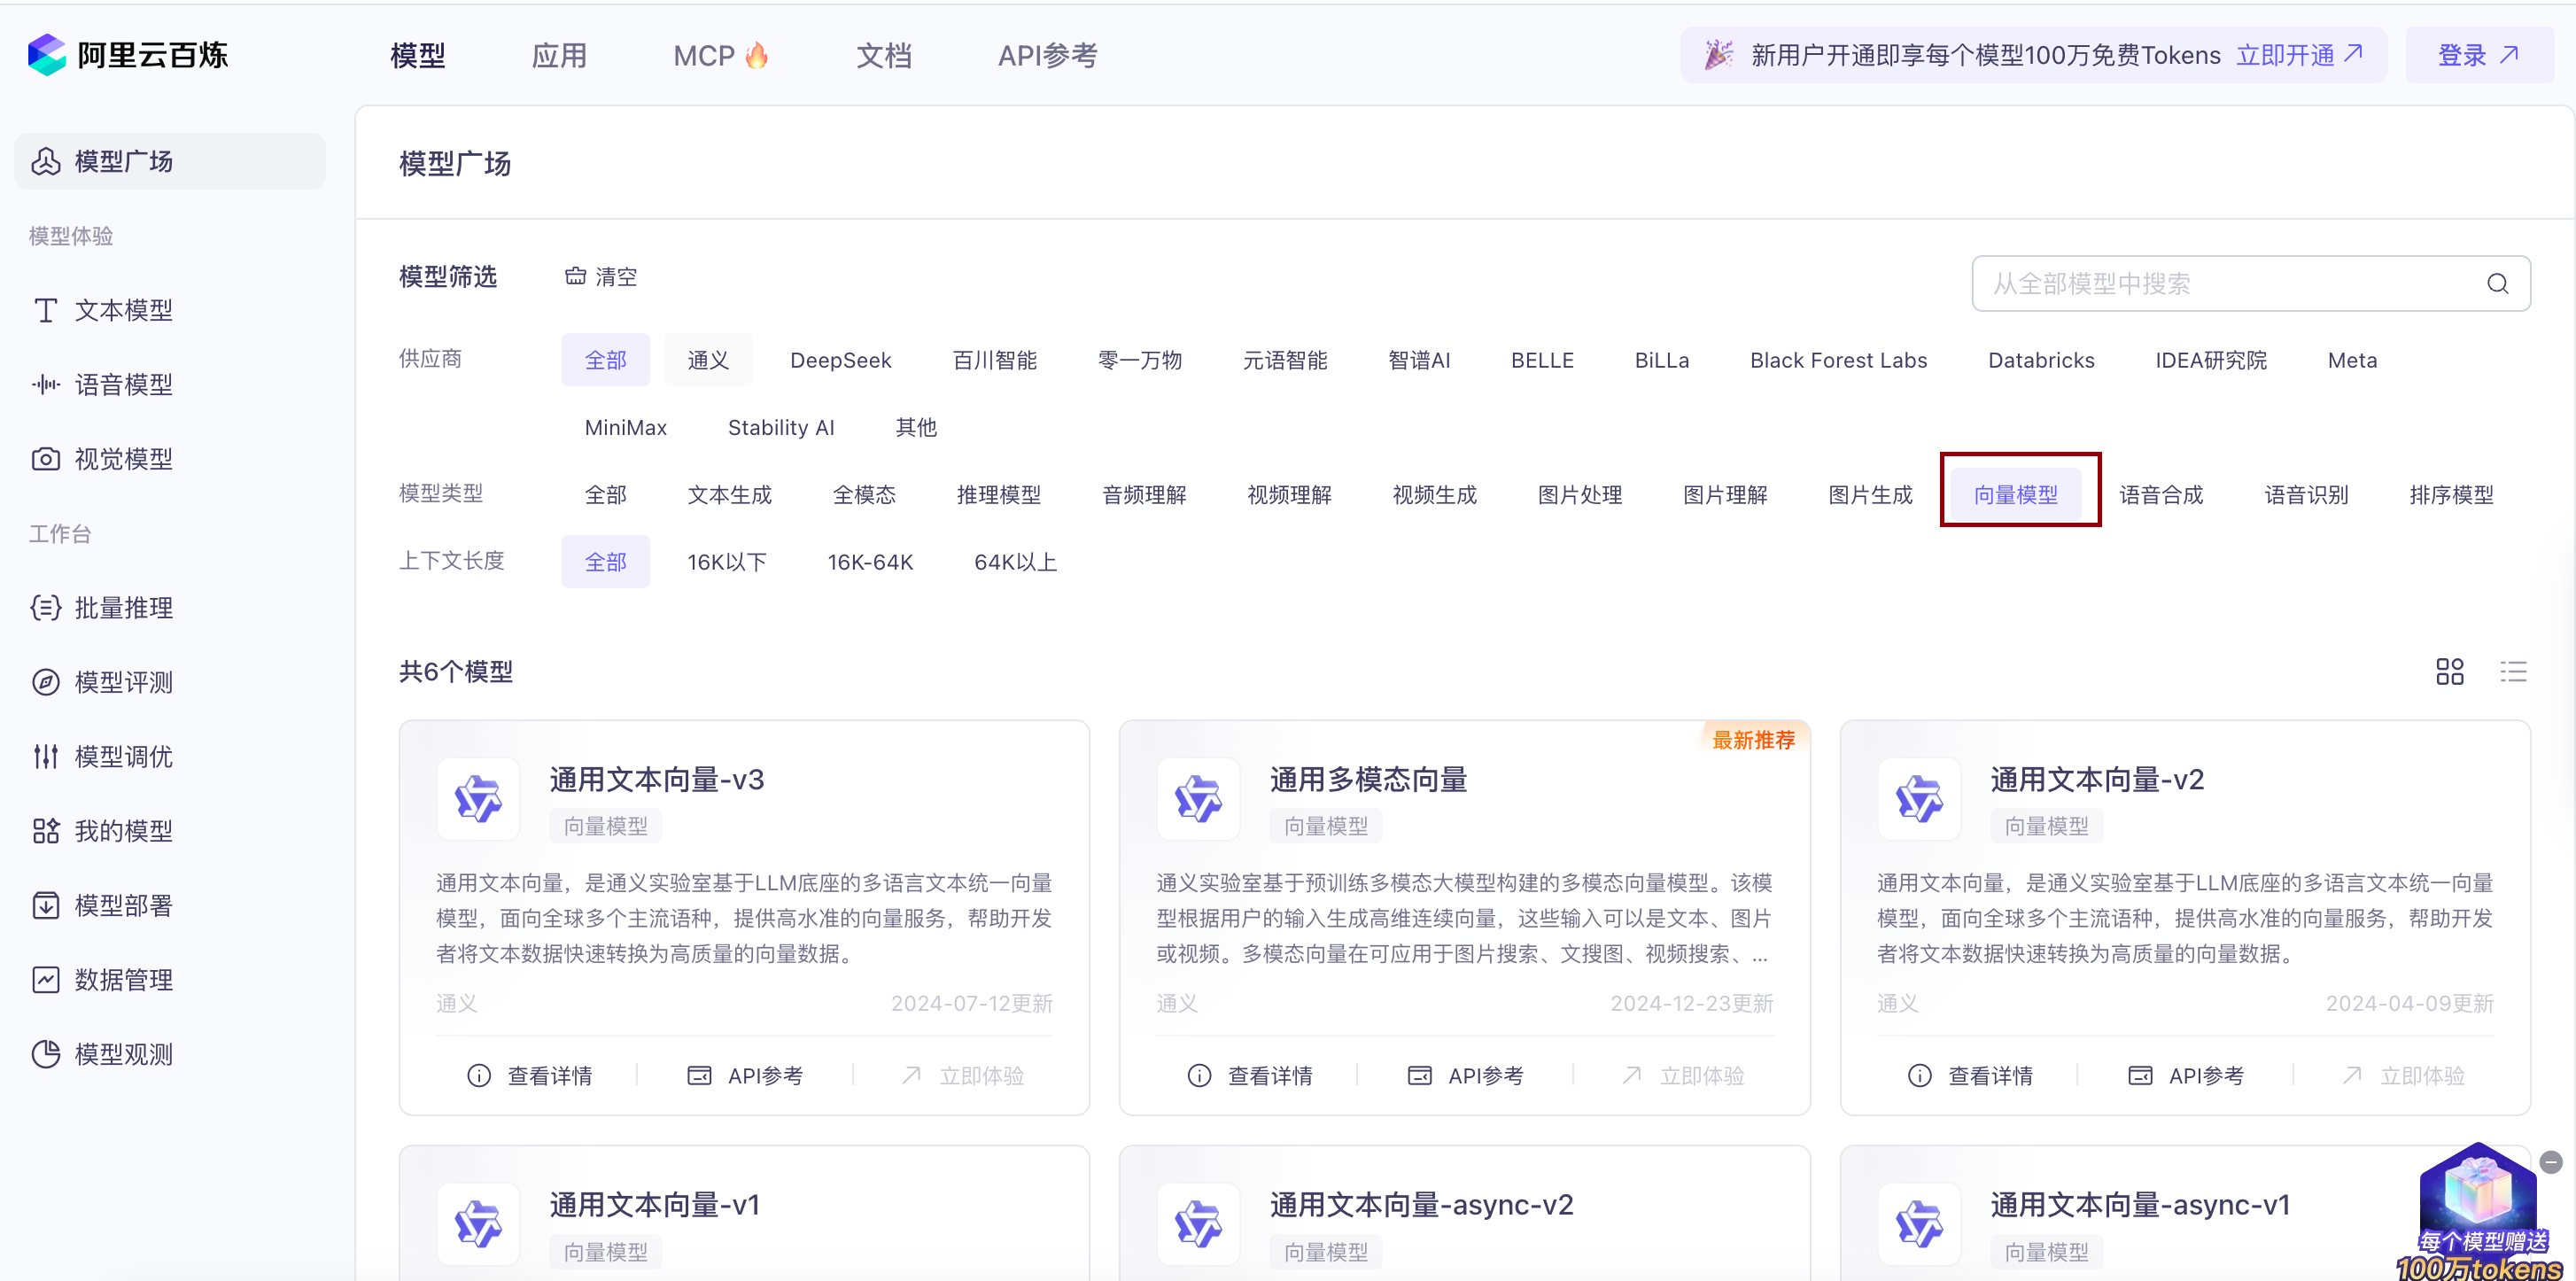
- 阿里云百炼平台:https://bailian.console.aliyun.com/?tab=model#/model-market/detail/text-embedding-v3
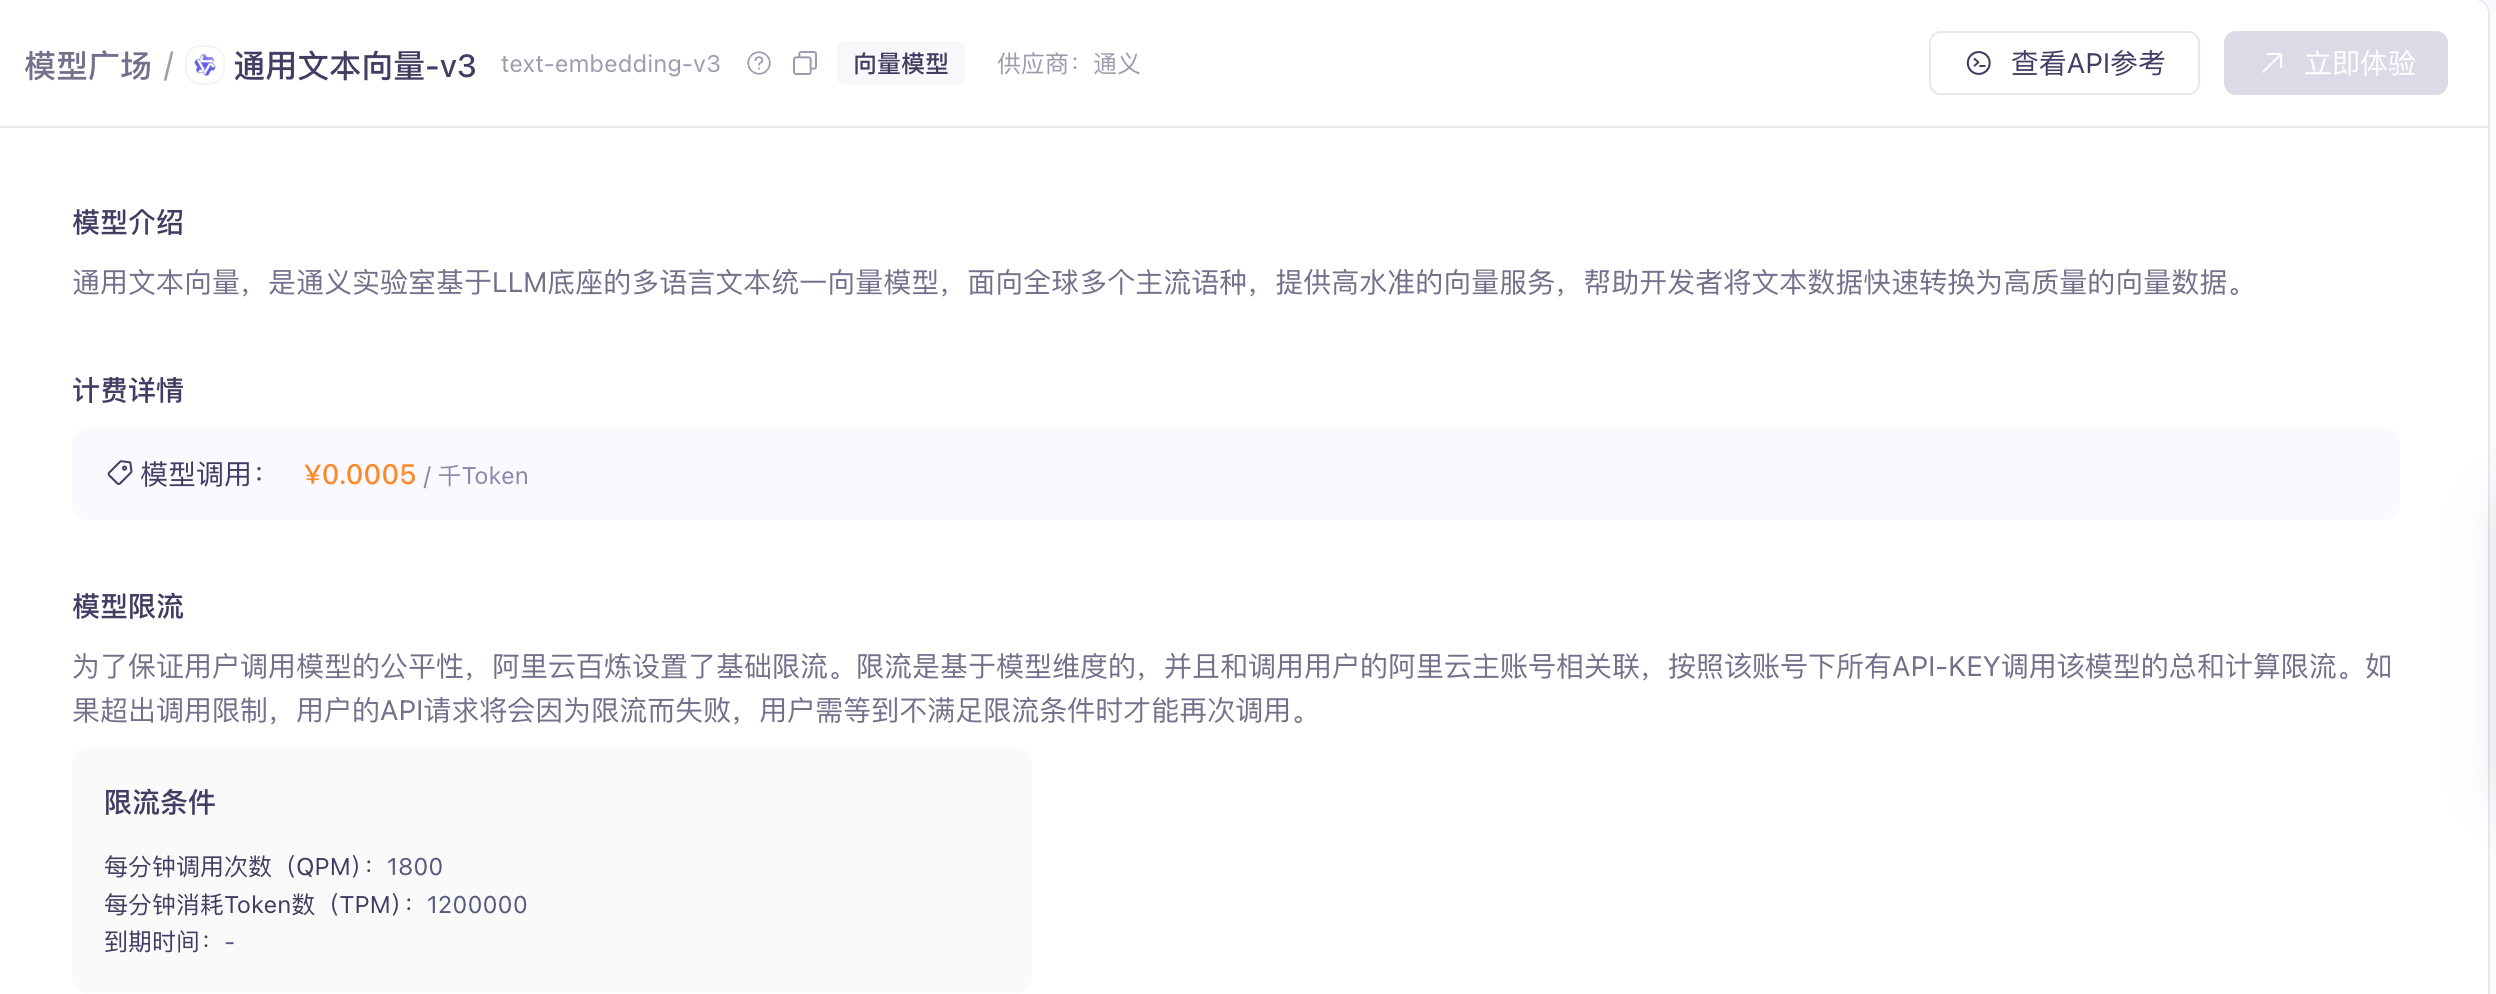
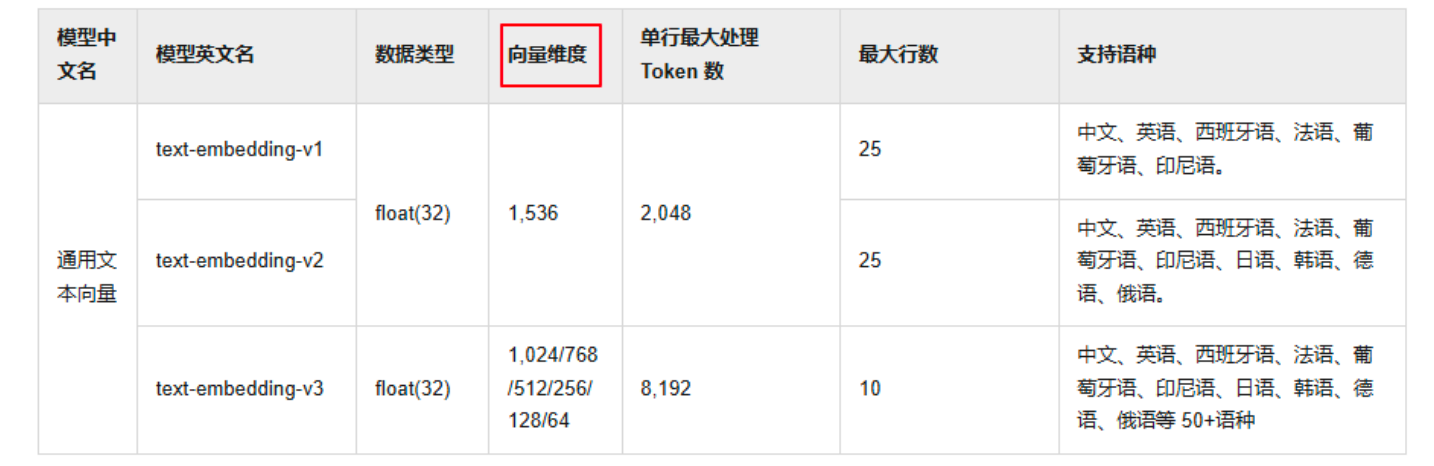
使用通用文本向量 text-embedding-v3,维度1024,维度越多,对事务的描述越精准,信息检索的精度越高。
可以在阿里模型广场搜索到:
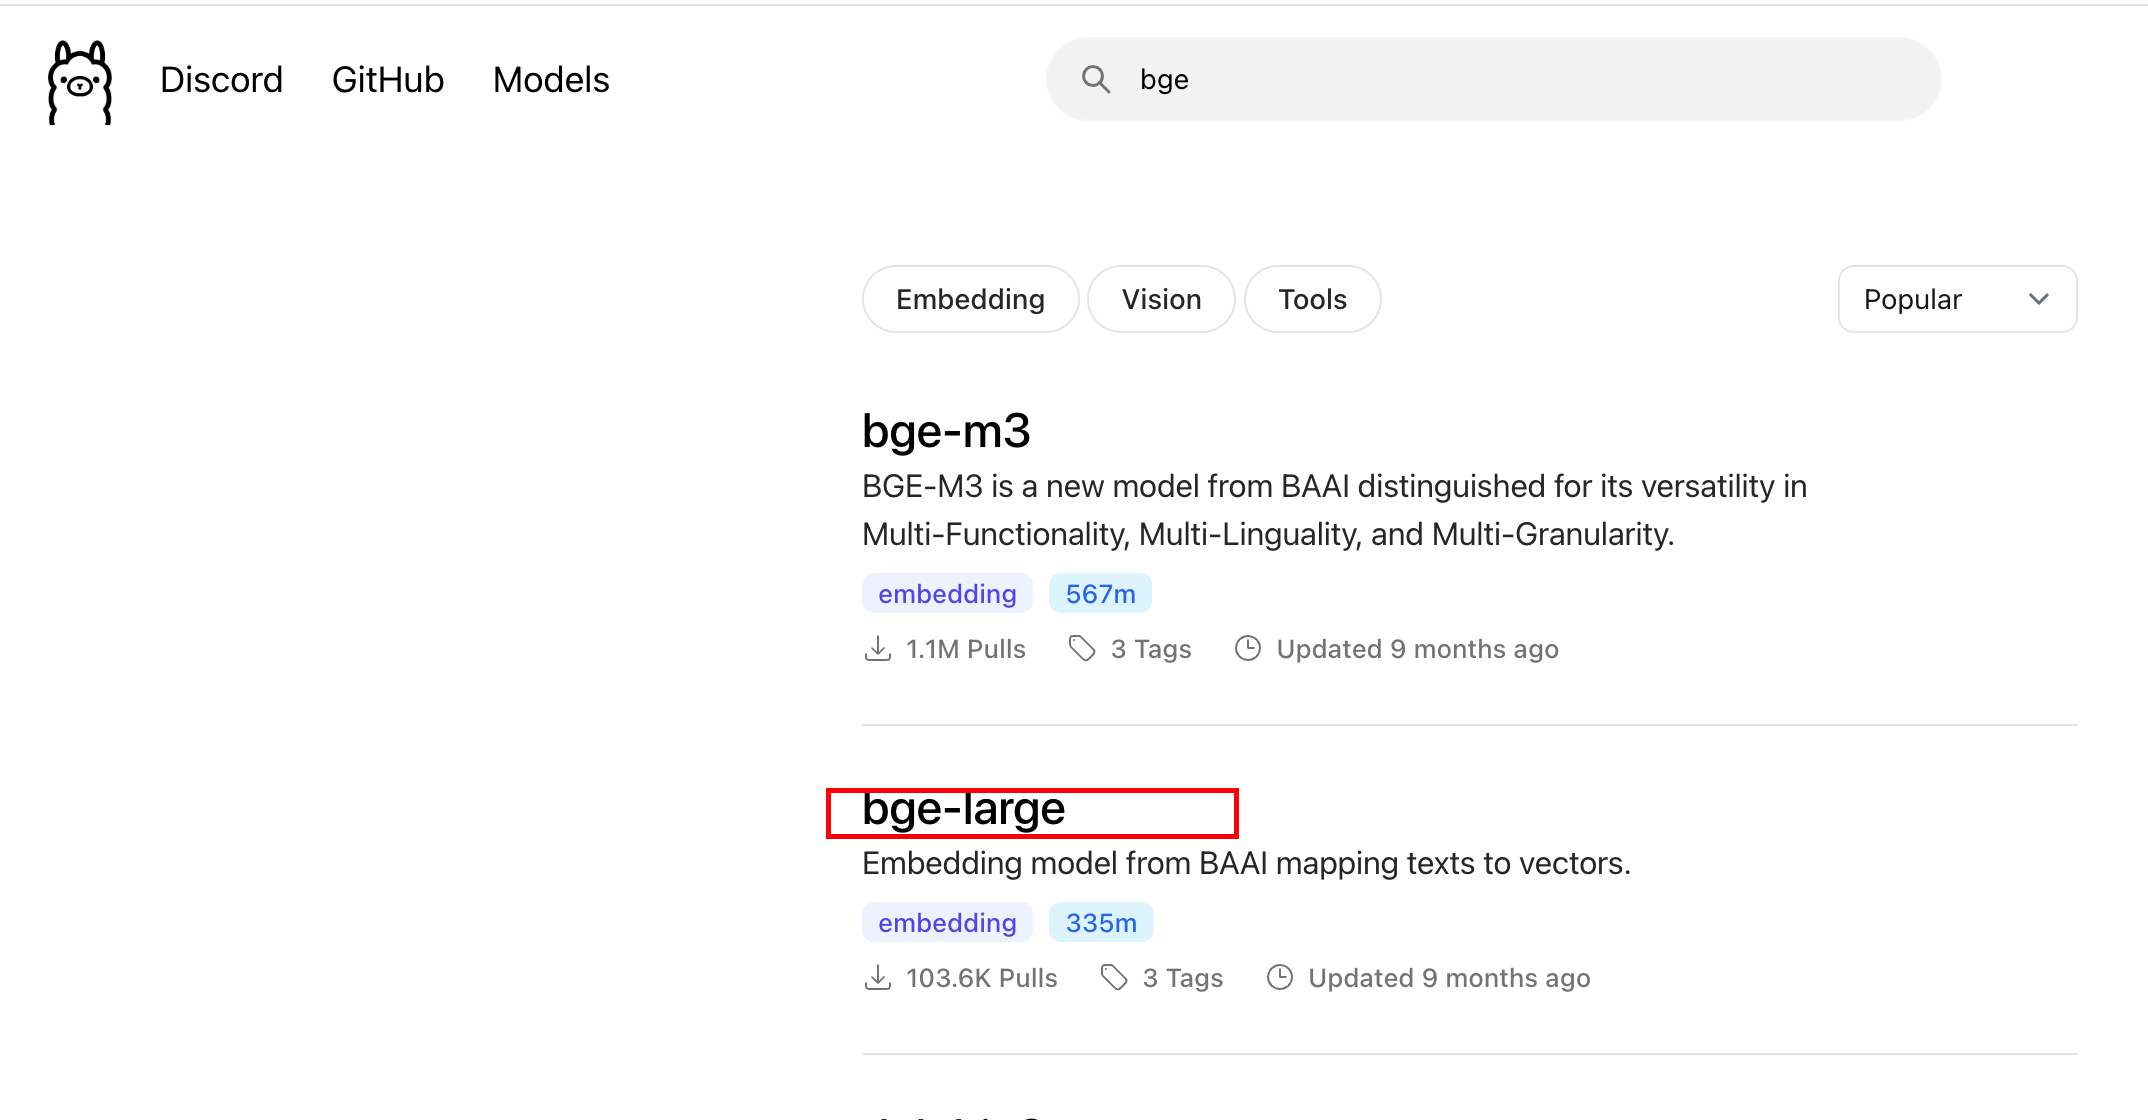
ollama也提供向量模型的场景:https://ollama.com/search?q=bge
6.1.2、模型配置
使用 text-embedding-v3 依然需要添加 langchain4j-community-dashscope 依赖,我们之前已经添加过了。
配置向量模型 application.properties:
#集成阿里通义千问-通用文本向量-v3
langchain4j.community.dashscope.embedding-model.api-key=${DASH_SCOPE_API_KEY}
langchain4j.community.dashscope.embedding-model.model-name=text-embedding-v3
6.1.3、文本向量化测试验证
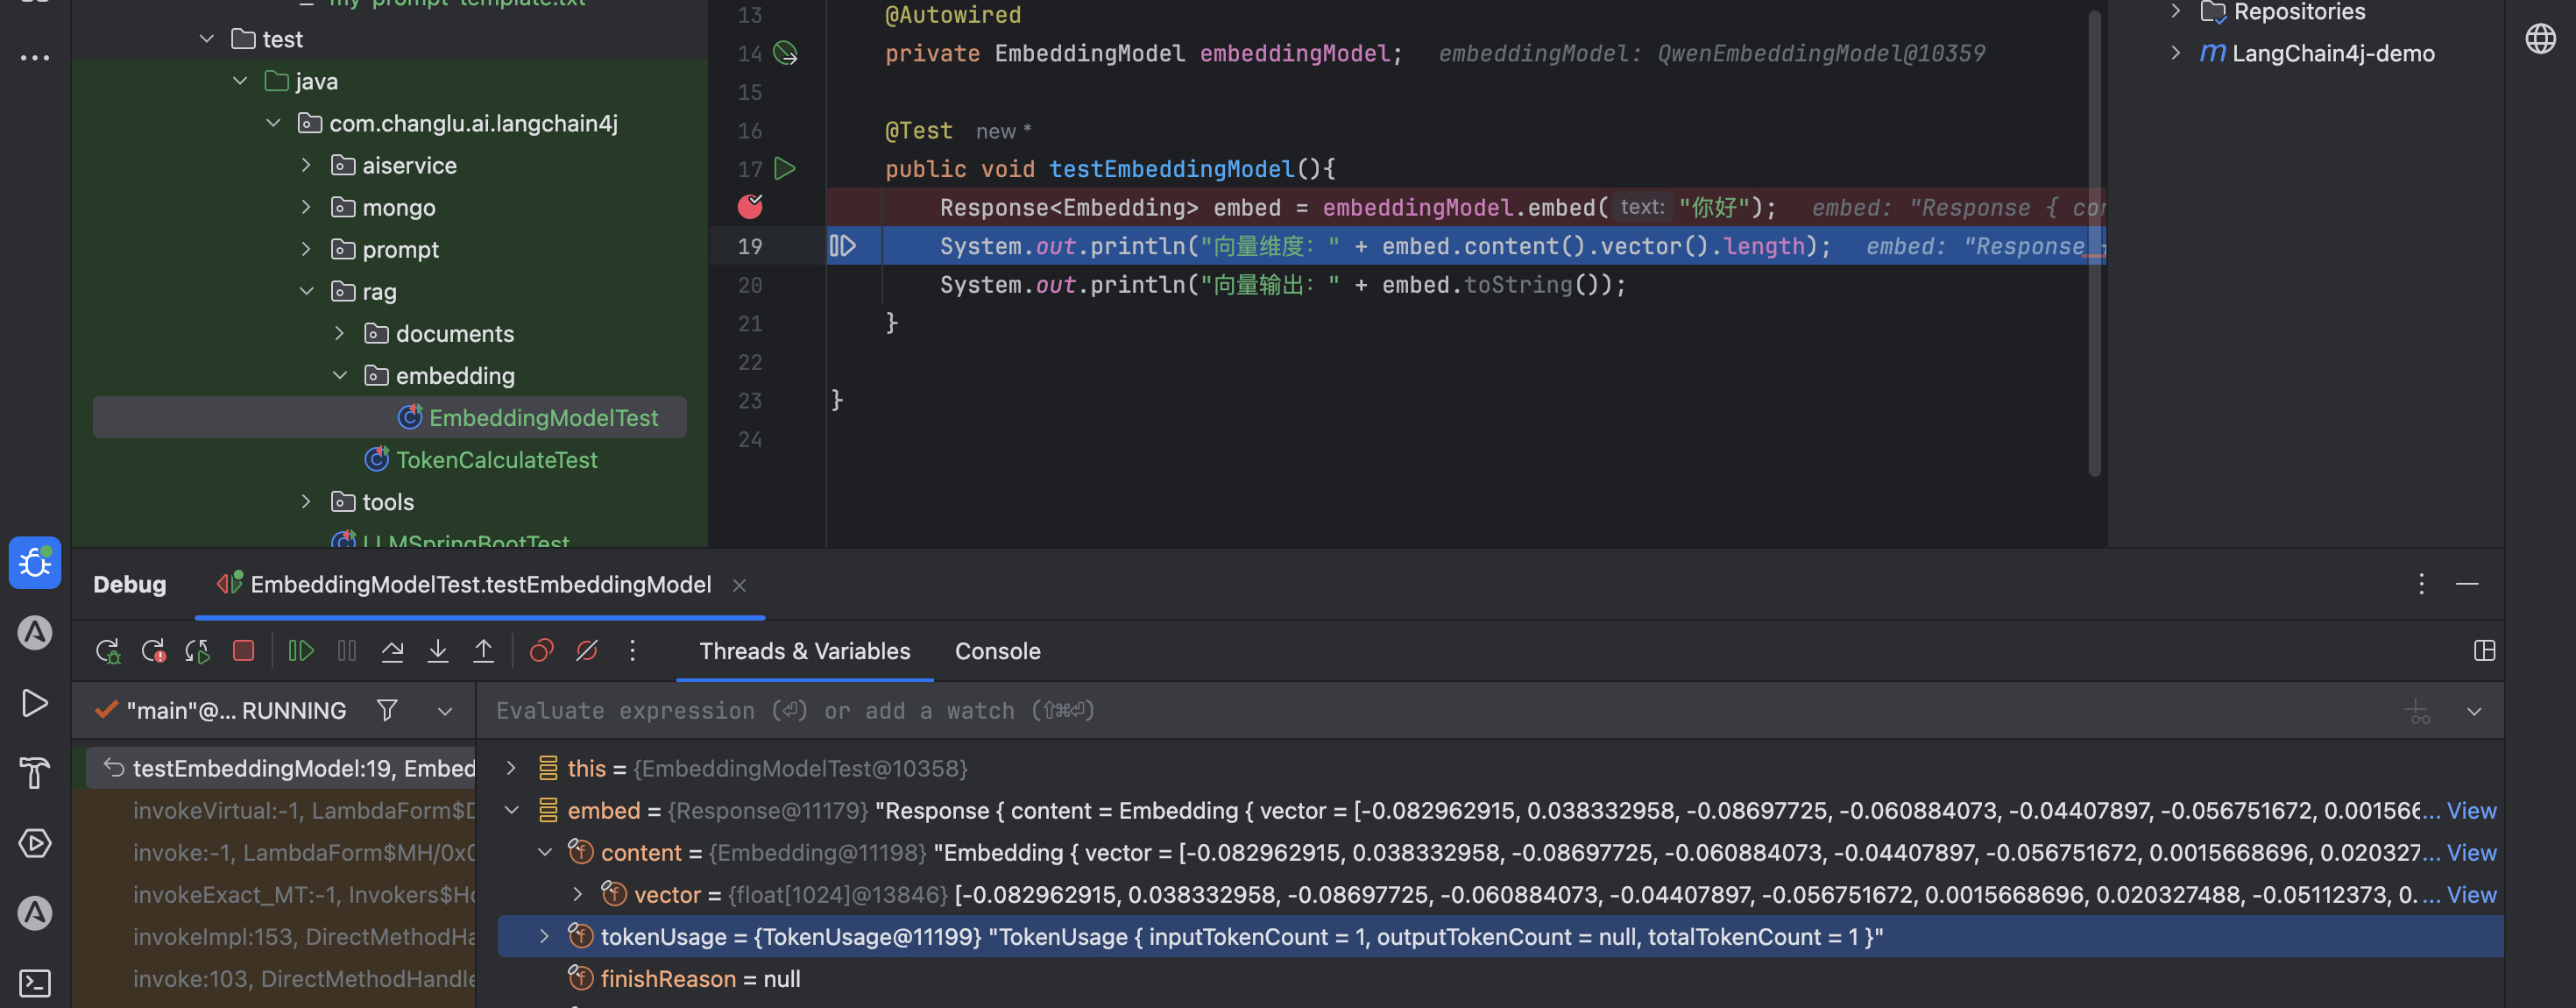
我们这里EmbeddingModel使用的则是
@SpringBootTest
public class EmbeddingModelTest {

    @Autowired
    private EmbeddingModel embeddingModel;

    @Test
    public void testEmbeddingModel(){
        Response<Embedding> embed = embeddingModel.embed("你好");
        System.out.println("向量维度:" + embed.content().vector().length);
        System.out.println("向量输出:" + embed.toString());
    }

}
测试效果如下:
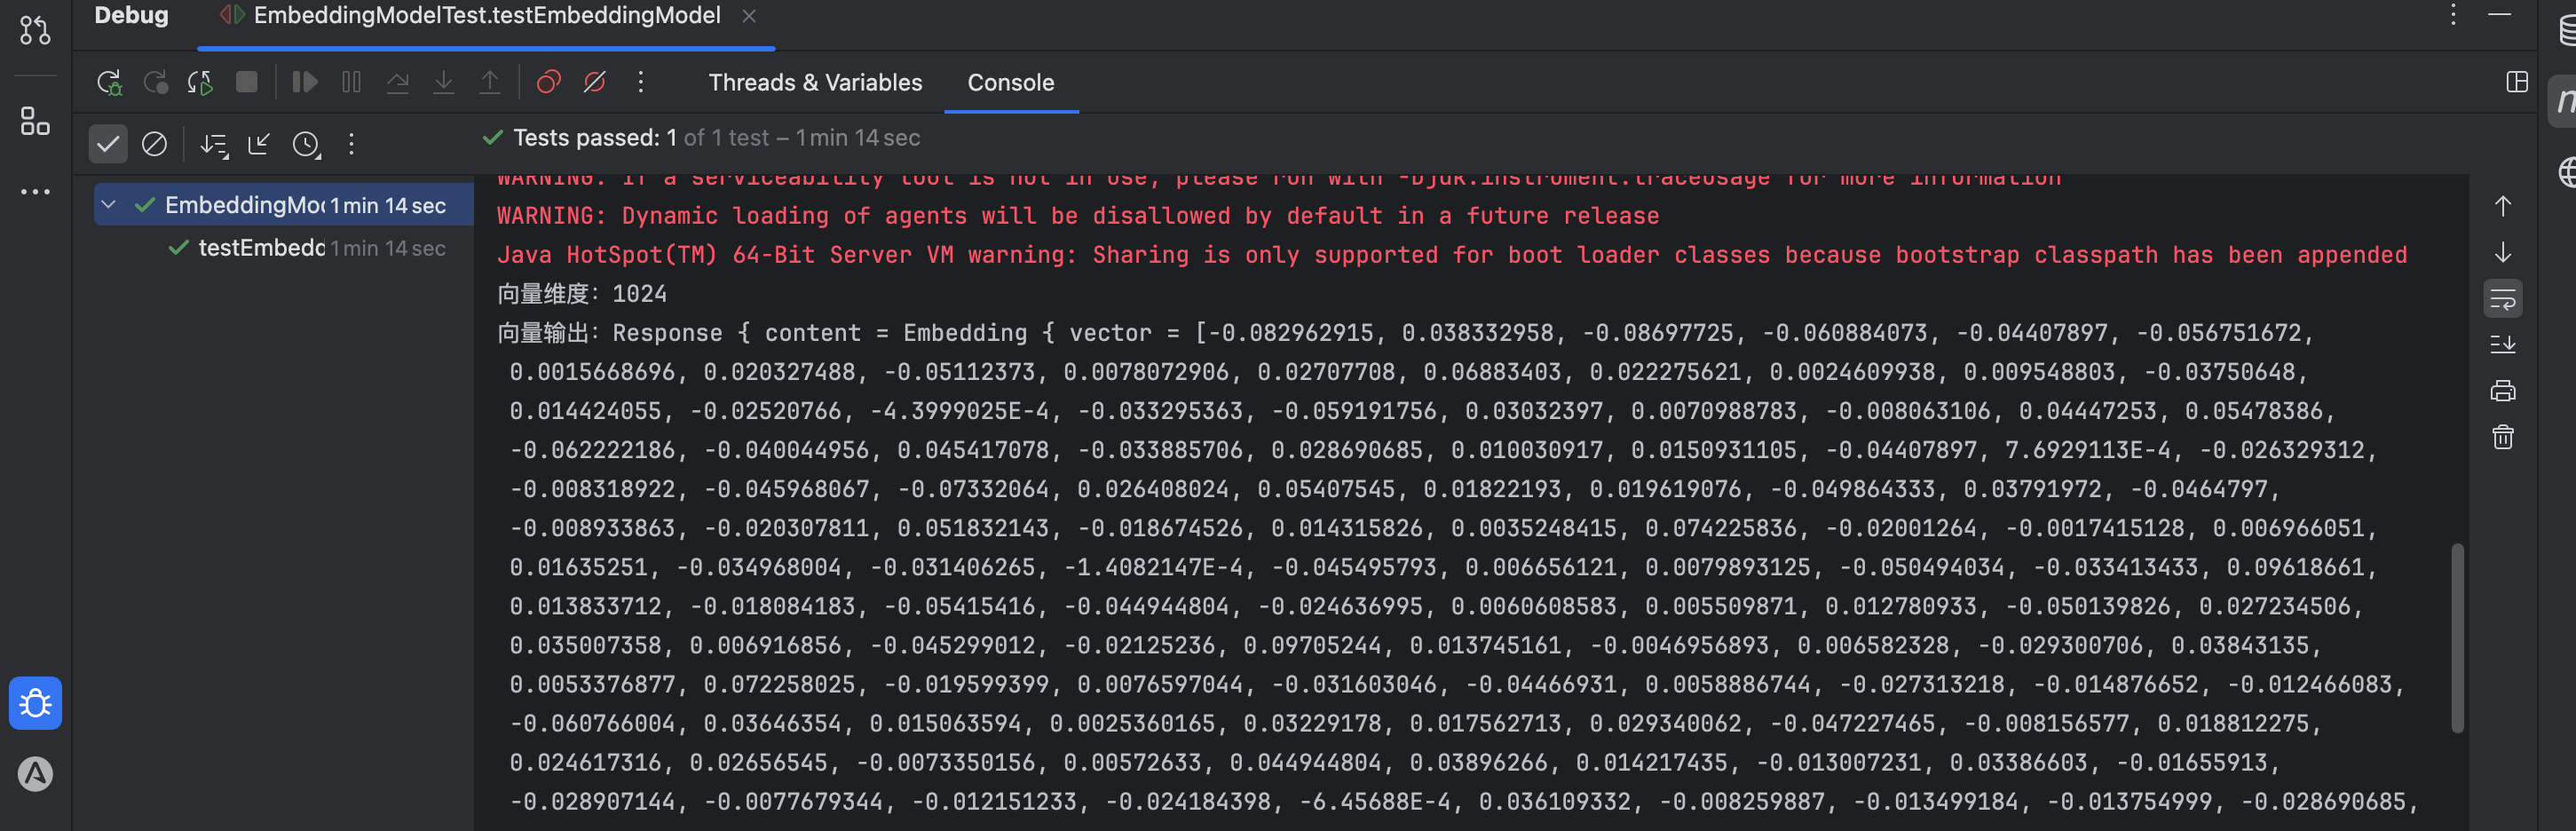
debug内容:
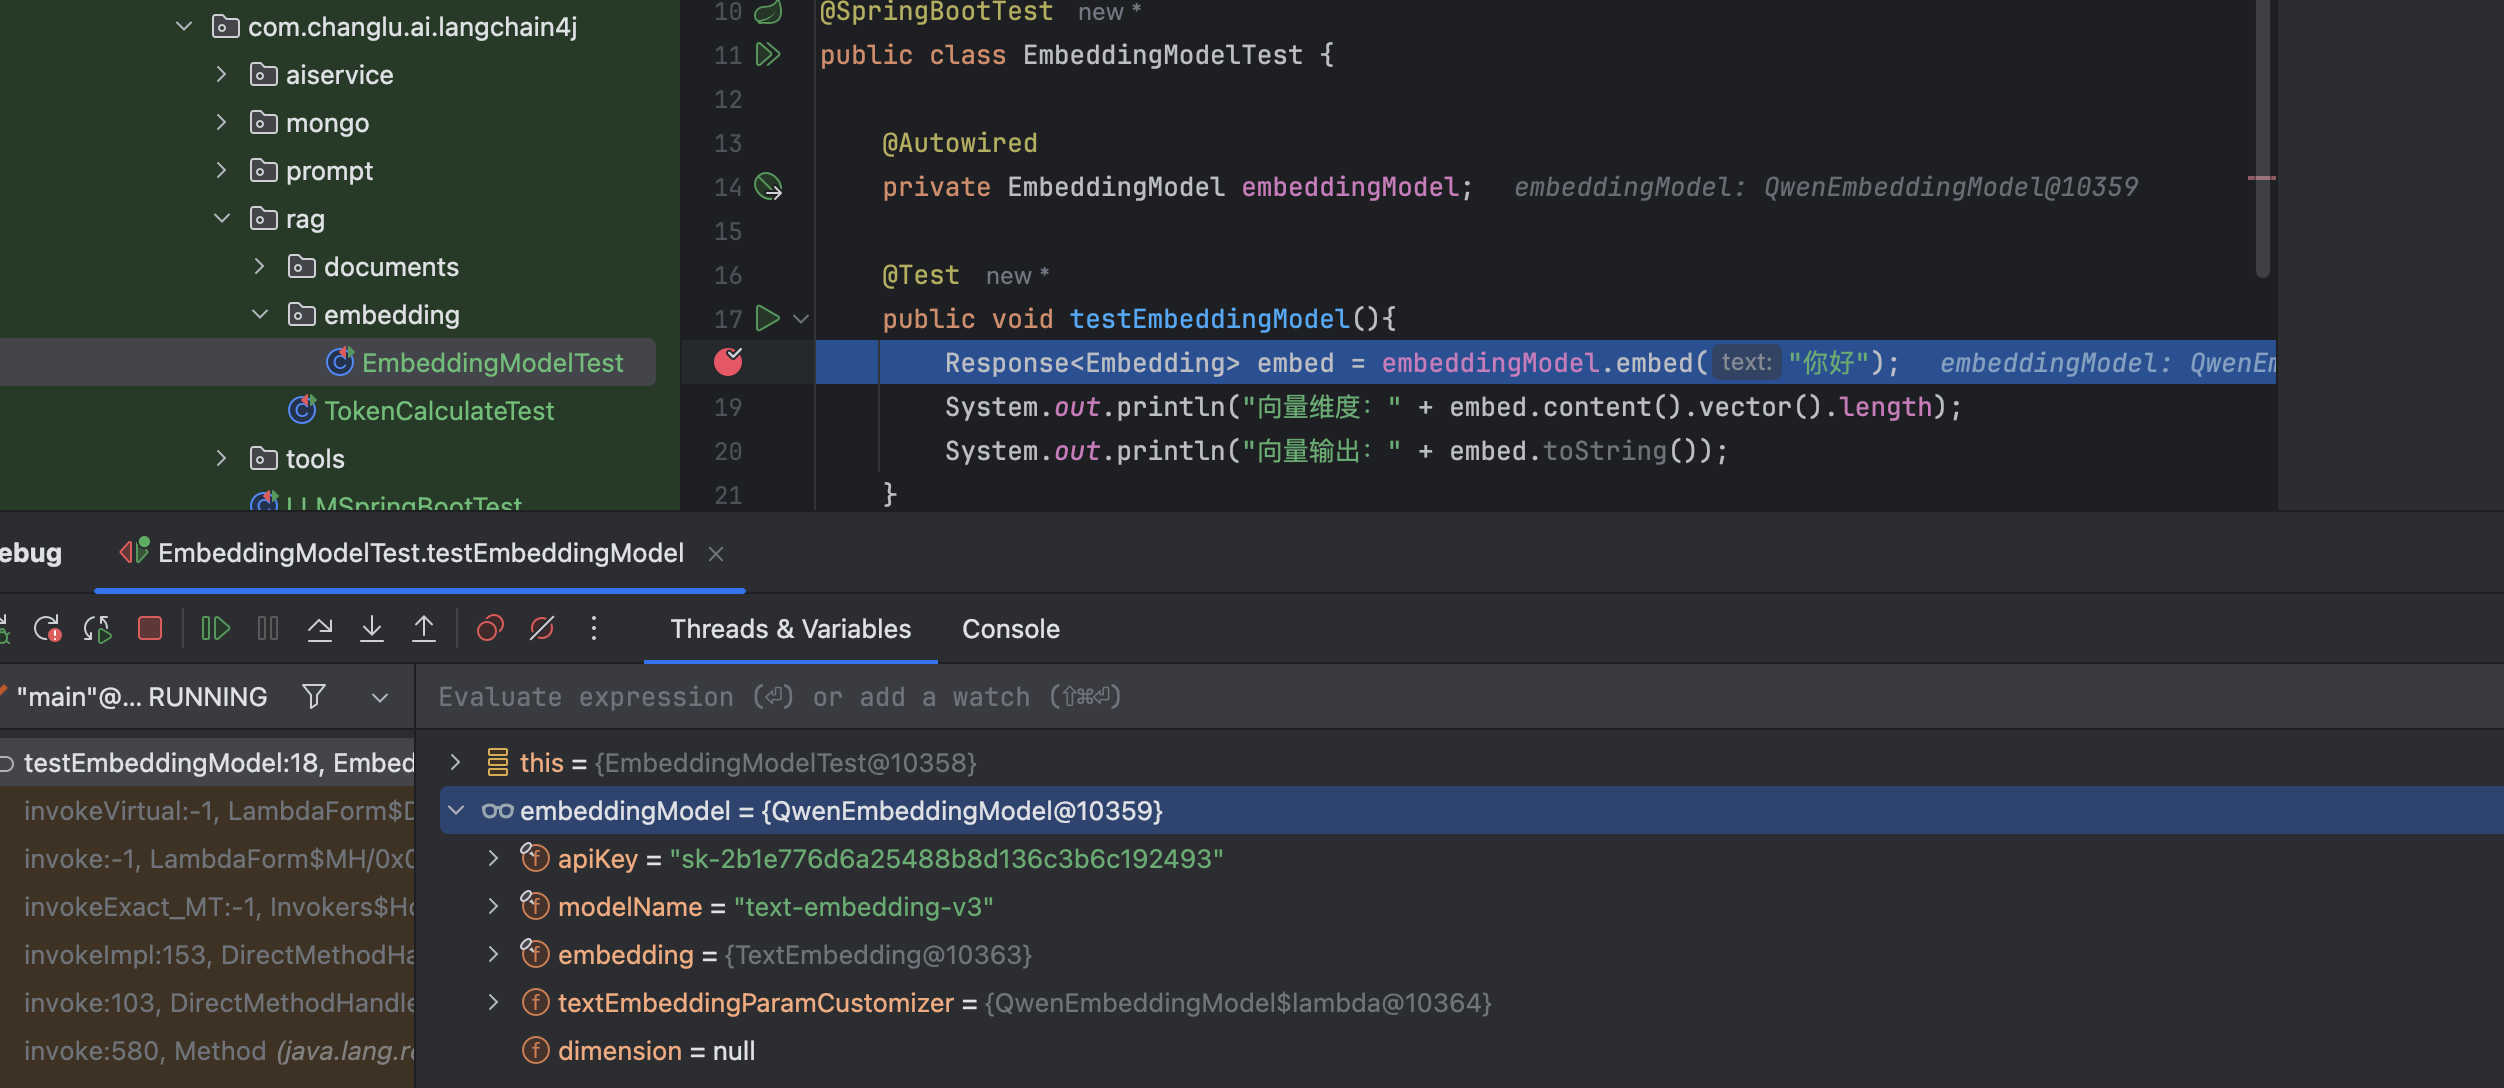
执行向量化效果:
6.2、向量化存储
dify使用的向量数据库为:Chroma,以易用性和高效性著称,适合中小规模的数据存储与检索场景。不过,Dify 也支持替换为其他向量数据库,如 Pinecone、Weaviate、Milvus 等。此外,Dify 云服务中默认使用的向量数据库是 Weaviate。
- RAG 落地必备的 1 个开源 AI 原生向量数据库 —Chroma:https://mp.weixin.qq.com/s?__biz=MjM5MzQ5NTU0Mw==&mid=2455052377&idx=1&sn=38829994cbd6e8a0fb01d177384d488d&poc_token=HEE8M2ijcS-wO8X1KPfFlpO0KA6Z0QXXxglHuX98
- Spring Boot 集成 Milvus 向量数据库(DeepSeek RAG):https://juejin.cn/post/7473339067854553128
- Springboot集成Milvus和Embedding服务,实现向量化检索:https://blog.csdn.net/wxz258/article/details/145574017
6.2.1、Pinecone简介
之前我们使用的是InMemoryEmbeddingStore作为向量存储,但是不建议在生产中使用基于内存的向量存储。因此这里我们使用Pinecone作为向量数据库。
**官方网站:**https://www.pinecone.io/
访问官方网站、注册、登录、获取apiKey且配置在环境变量中。默认有2GB的免费存储空间。
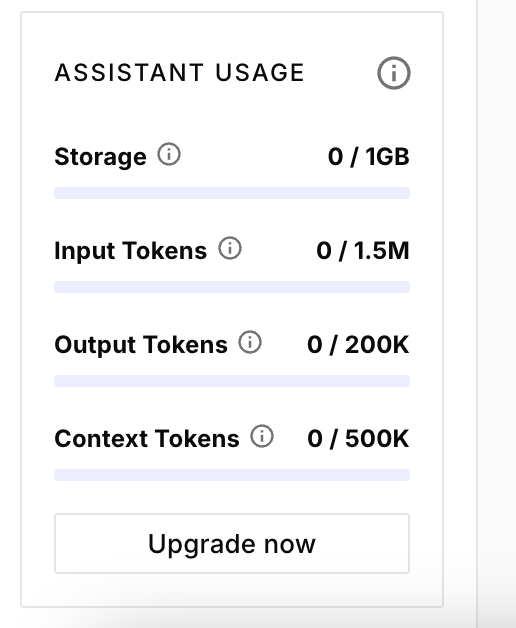
默认使用github登陆之后,给到的空间量。
6.2.2、Pinecone的使用
得分的含义:
- 在向量检索场景中,当我们把查询文本转换为向量后,会在嵌入存储( EmbeddingStore )里查找与之最相似的向量(这些向量对应着文档片段等内容)。为了衡量查询向量和存储向量之间的相似程度,会使用某种相似度计算方法(例如余弦相似度等)来得出一个数值,这个数值就是得分。得分越高,表明查询向量和存储向量越相似,对应的文档片段与查询文本的相关性也就越高。
得分的作用:
- 筛选结果:通过设置 minScore 阈值,能够过滤掉那些与查询文本相关性较低的结果。在代码里, minScore(0.8) 意味着只有得分大于等于 0.8 的结果才会被返回,低于这个阈值的结果会被舍弃。这样可以确保返回的结果是与查询文本高度相关的,提升检索结果的质量。
- 控制召回率和准确率:调整 minScore 的值可以在召回率和准确率之间进行权衡。如果把阈值设置得较低,那么更多的结果会被返回,召回率会提高,但可能会包含一些相关性不太强的结果,导致准确率下降;反之,如果把阈值设置得较高,返回的结果数量会减少,准确率会提高,但可能会遗漏一些相关的结果,使得召回率降低。在实际应用中,需要根据具体的业务需求来合理设置minScore 的值。
举例说明:
- 假设我们有一个关于水果的文档集合,嵌入存储中存储了这些文档片段的向量。当我们使用 “苹果的营养价值” 作为查询文本时,向量检索会计算查询向量与存储向量的相似度得分。如果 minScore 设置为0.8,那么只有那些与 “苹果的营养价值” 相关性非常高的文档片段才会被返回,而一些只简单提及苹果但没有详细讨论其营养价值的文档片段可能由于得分低于 0.8 而不会被返回。
6.2.3、Pinecone账号注册与配置
参考文档:https://docs.langchain4j.dev/integrations/embedding-stores/pinecone
langchain实现了很多的向量存储对接:
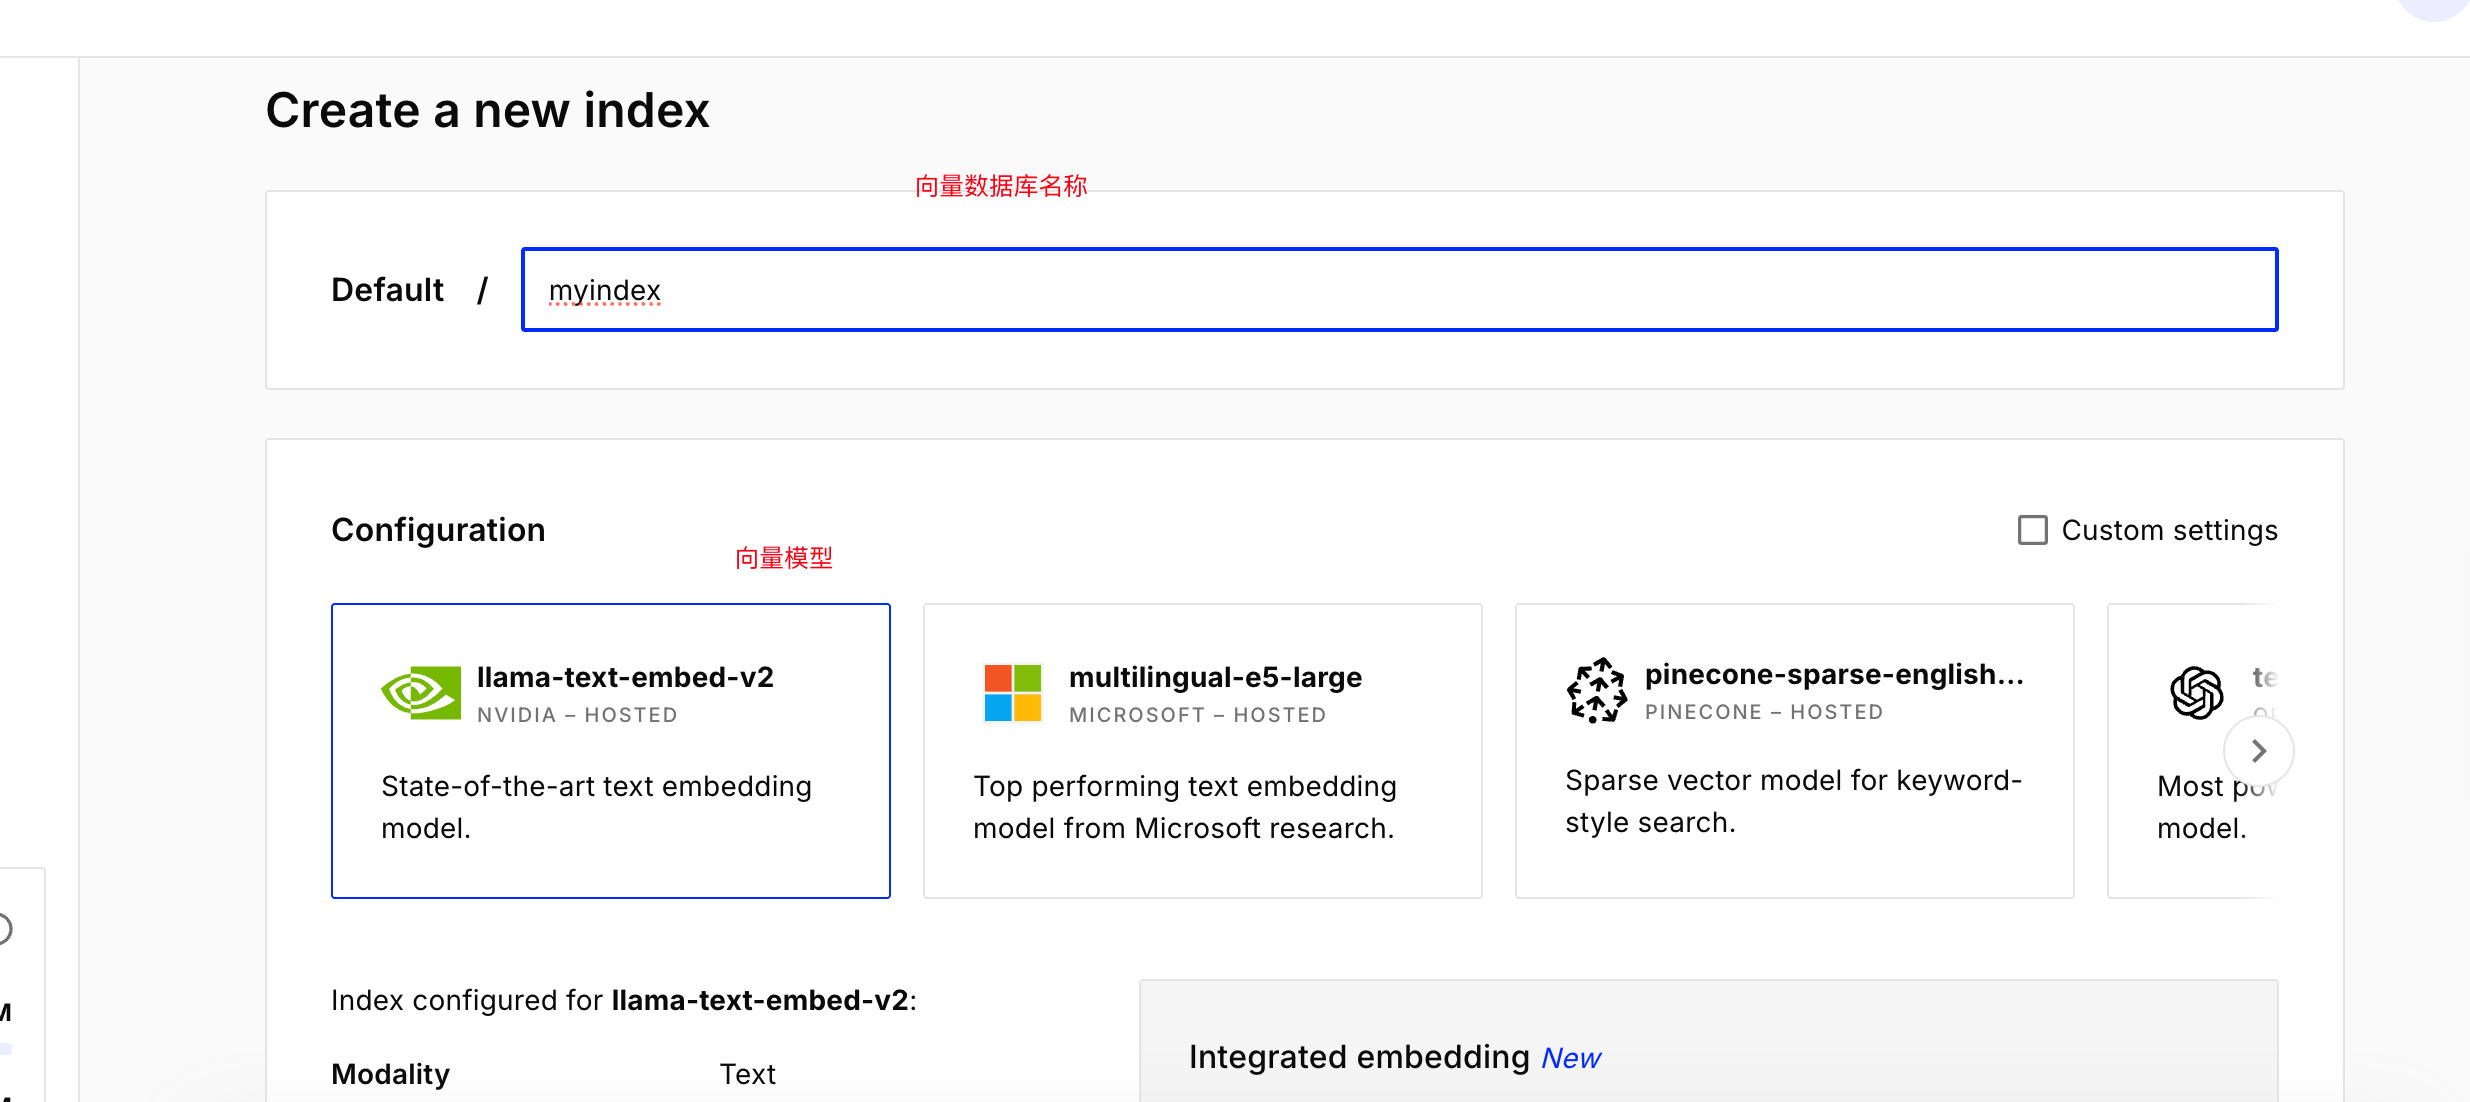
点击创建一个index:https://app.pinecone.io/organizations/-OR7LiDThGfrtrg1qhK-/projects/9d89b9a4-6e75-48bd-abda-a595ba052634/indexes
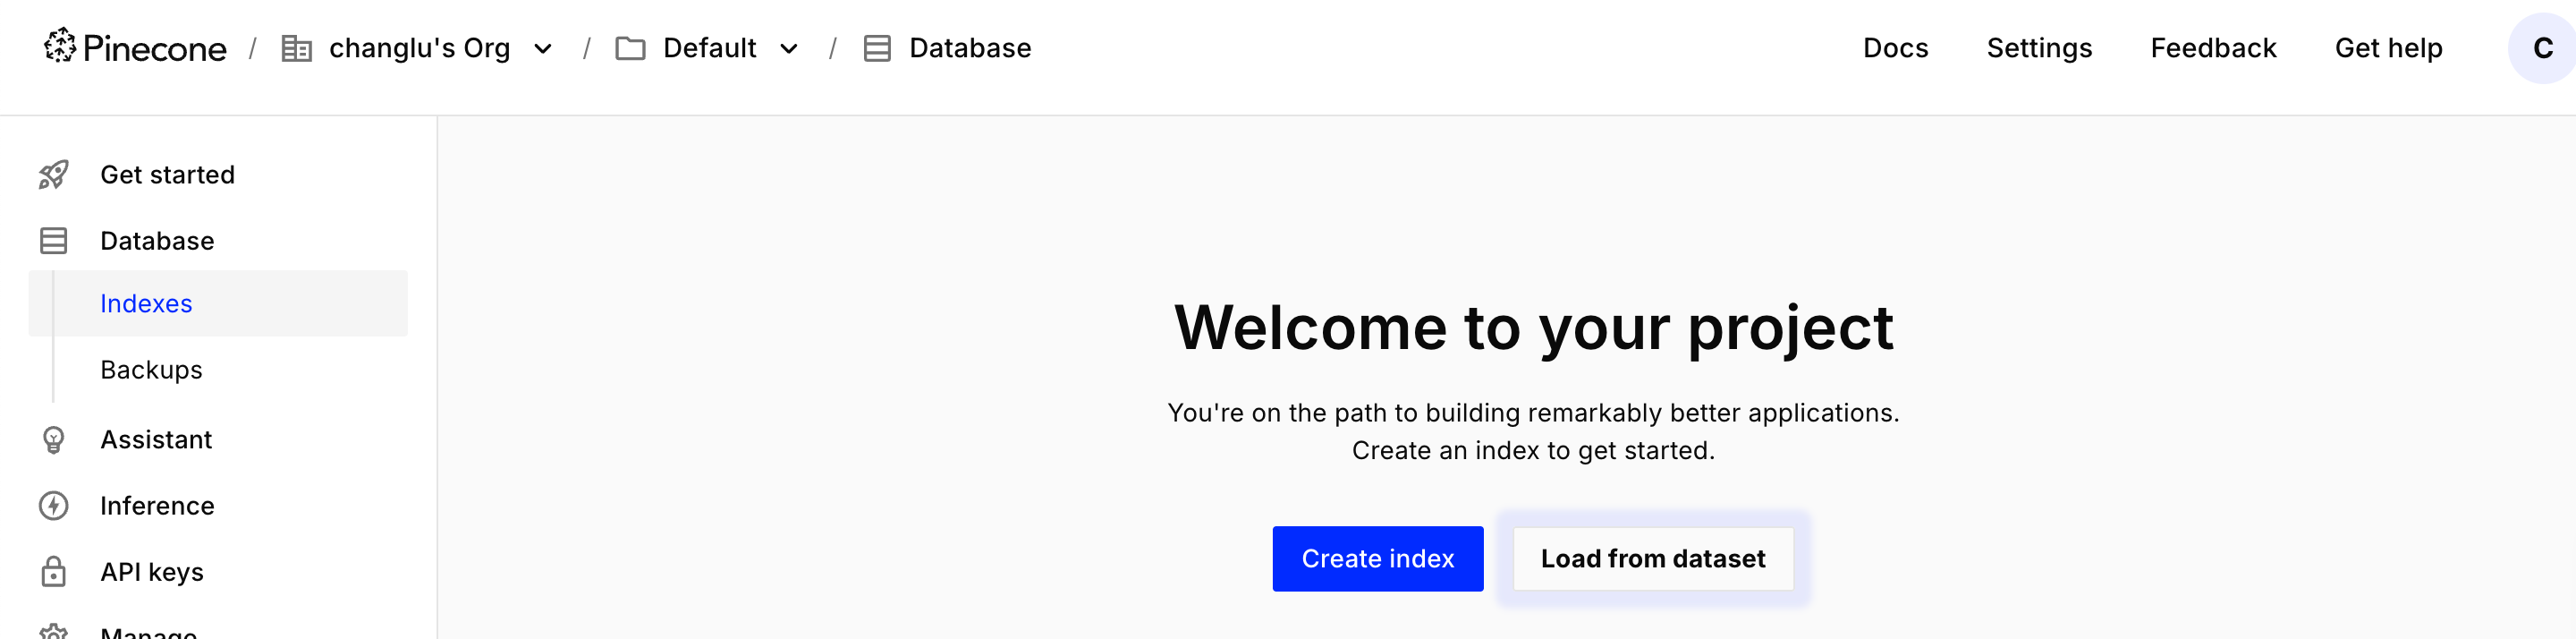
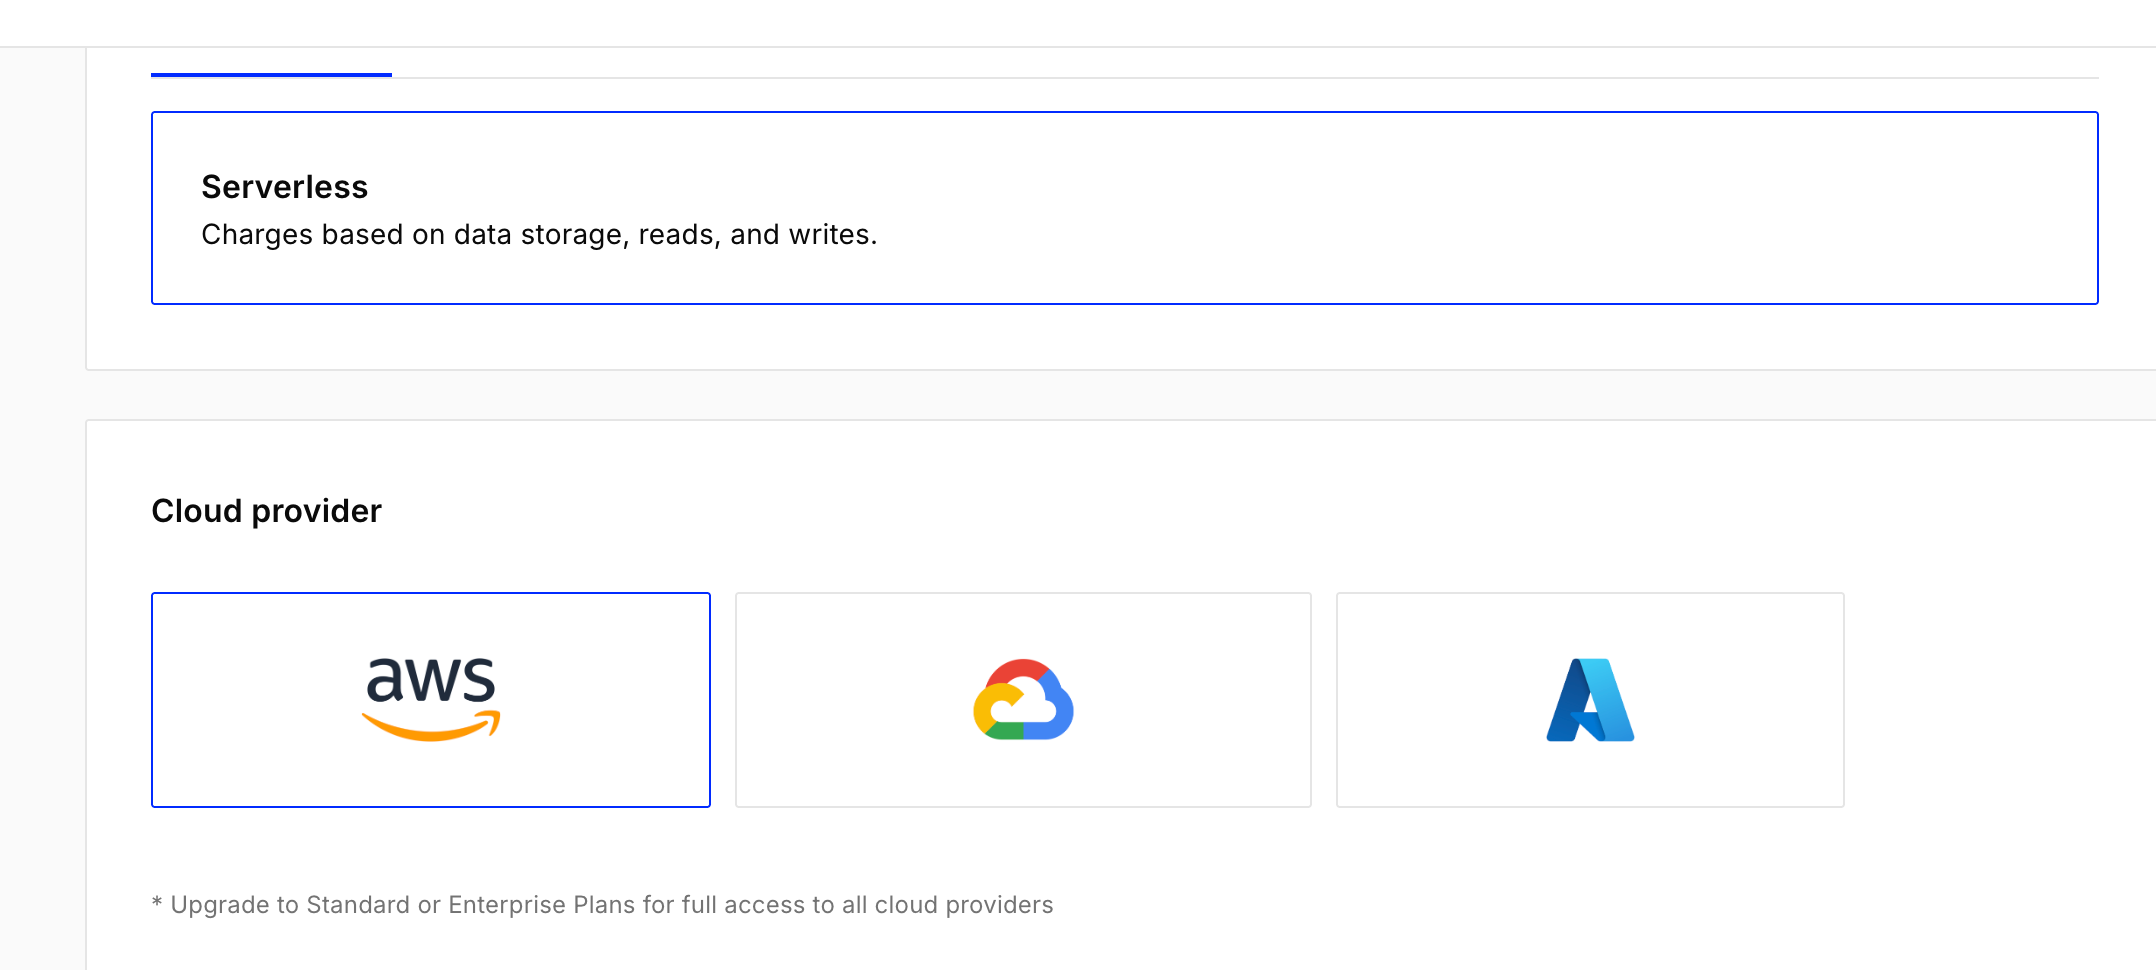
服务器选择:亚马逊
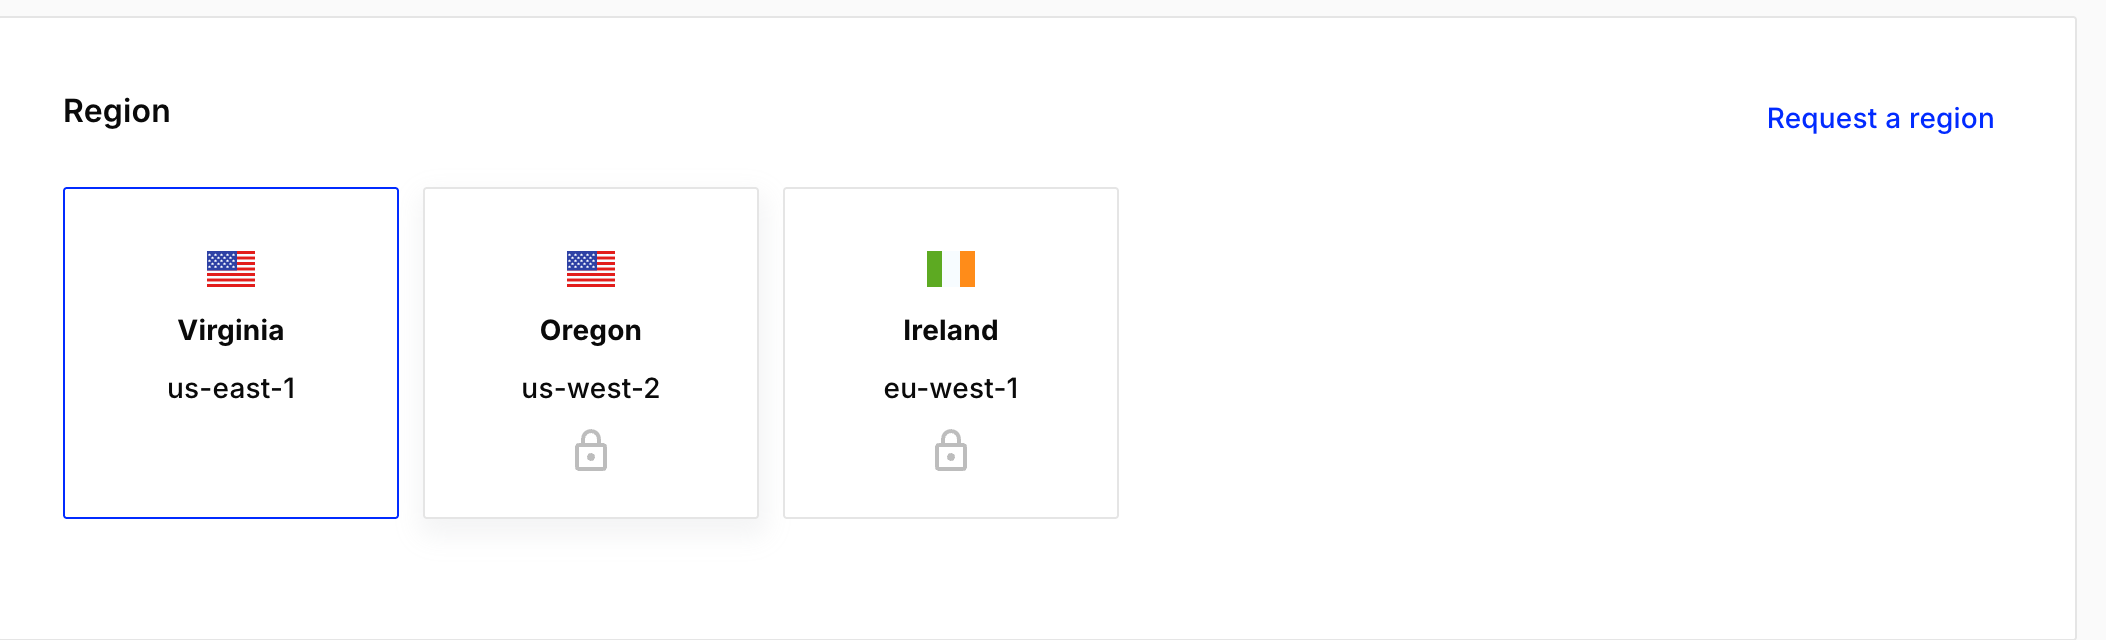
地区选择第一个即可:
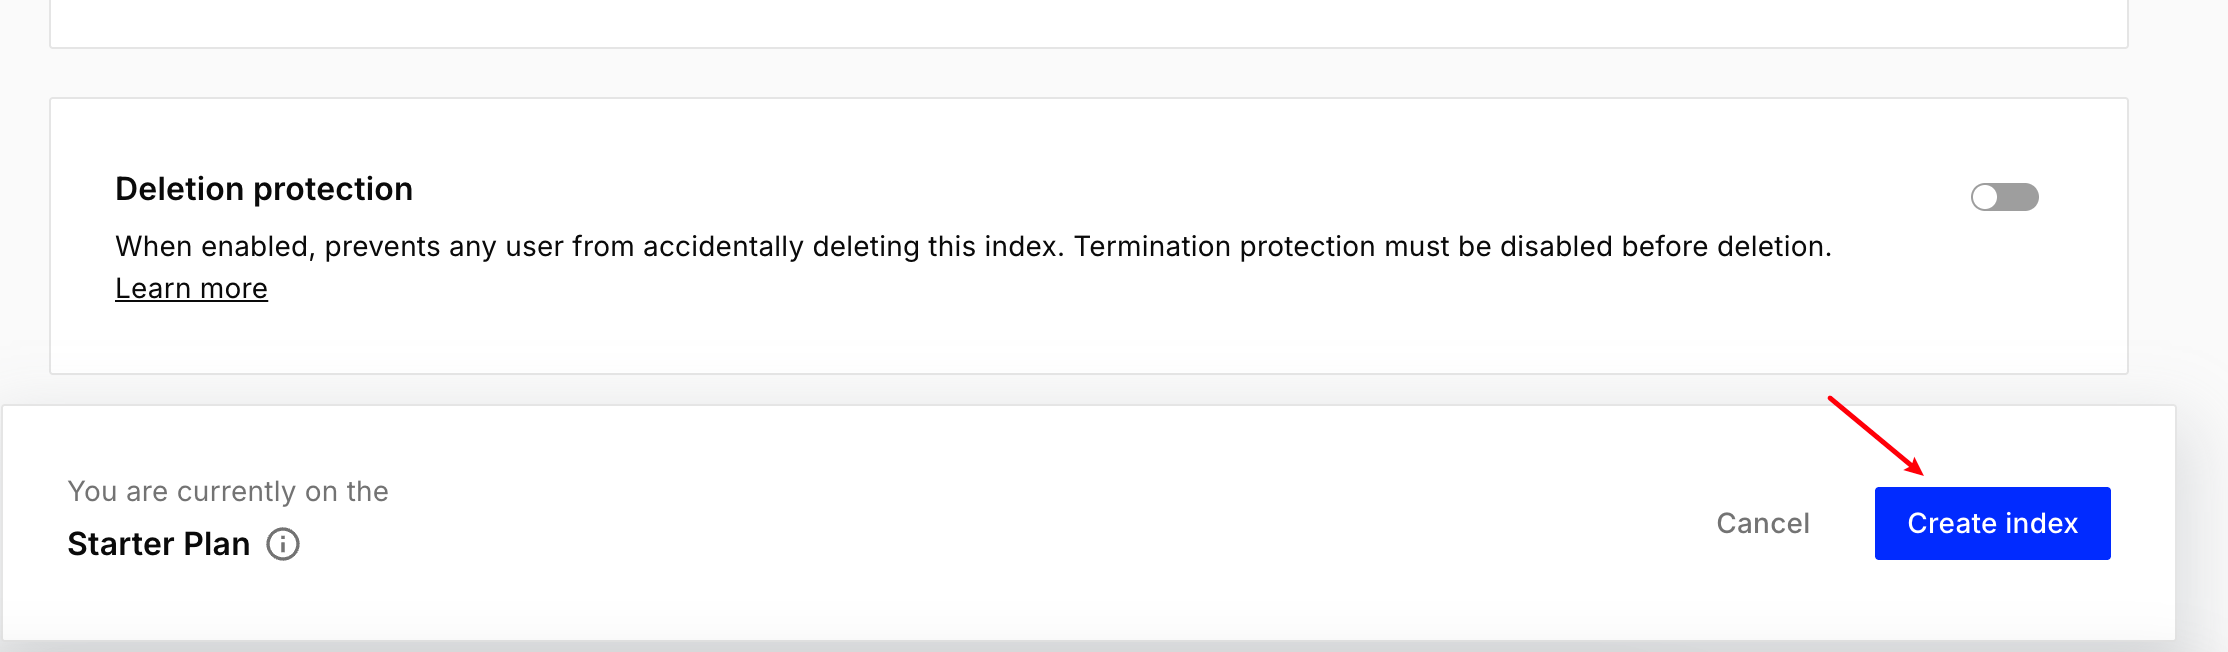
最后create index即可:
此时index创建完成:
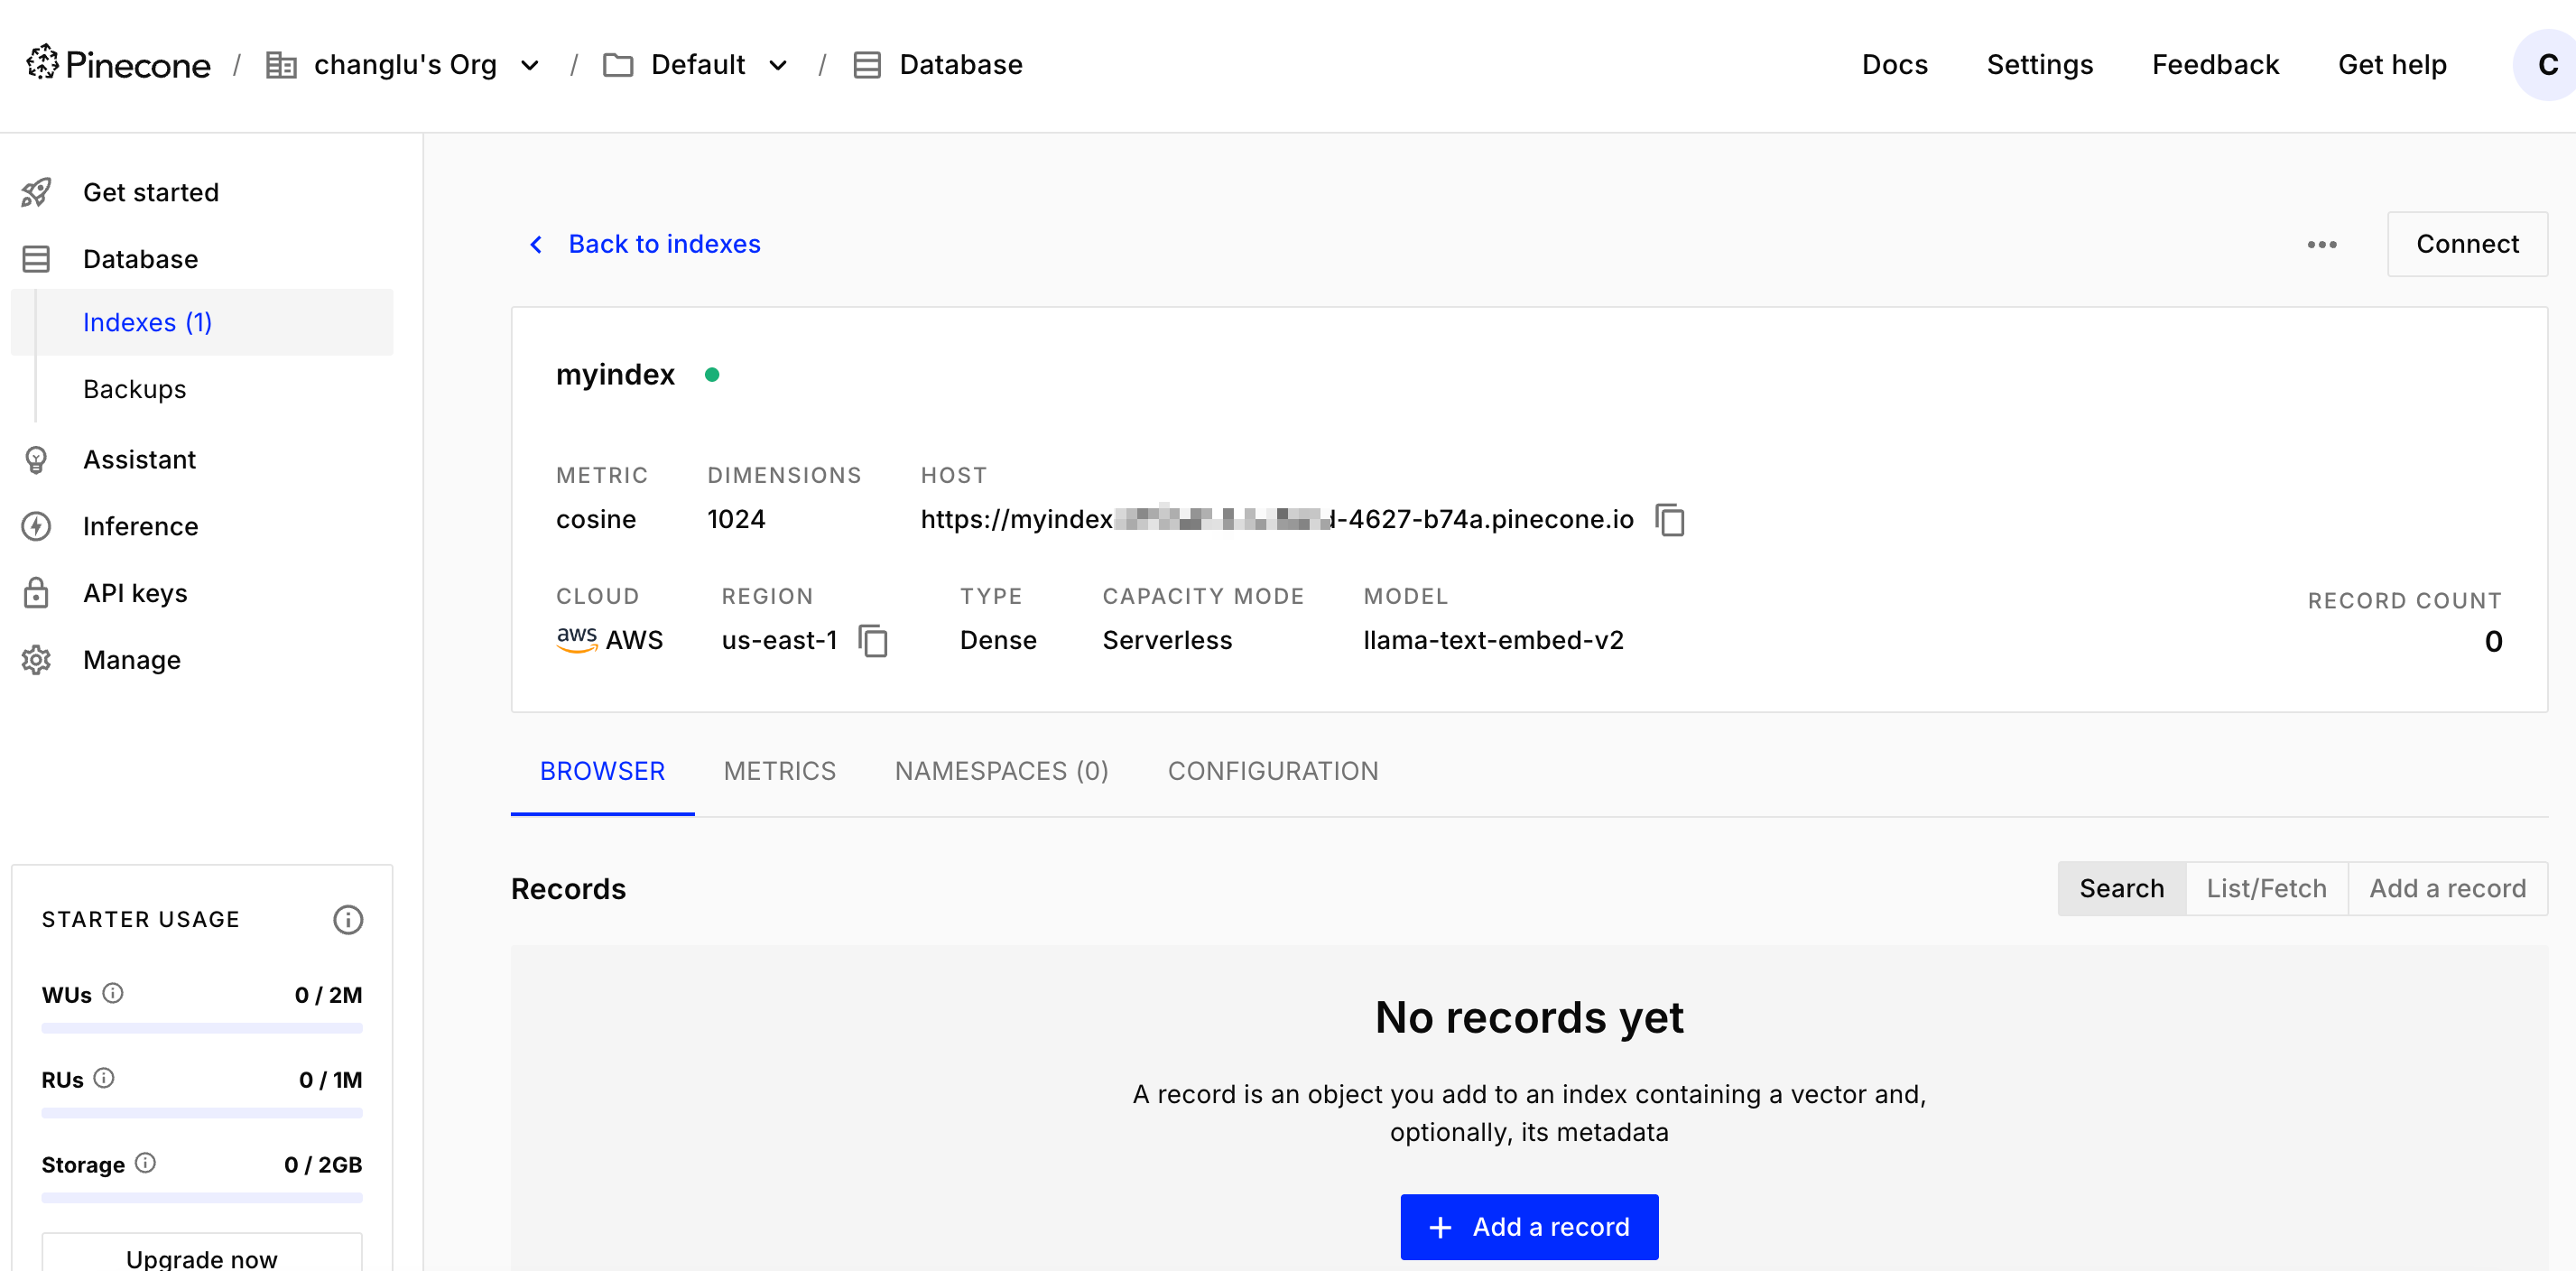
其中myindex可以当作我们的数据库。
接下来测试去创建一条向量:
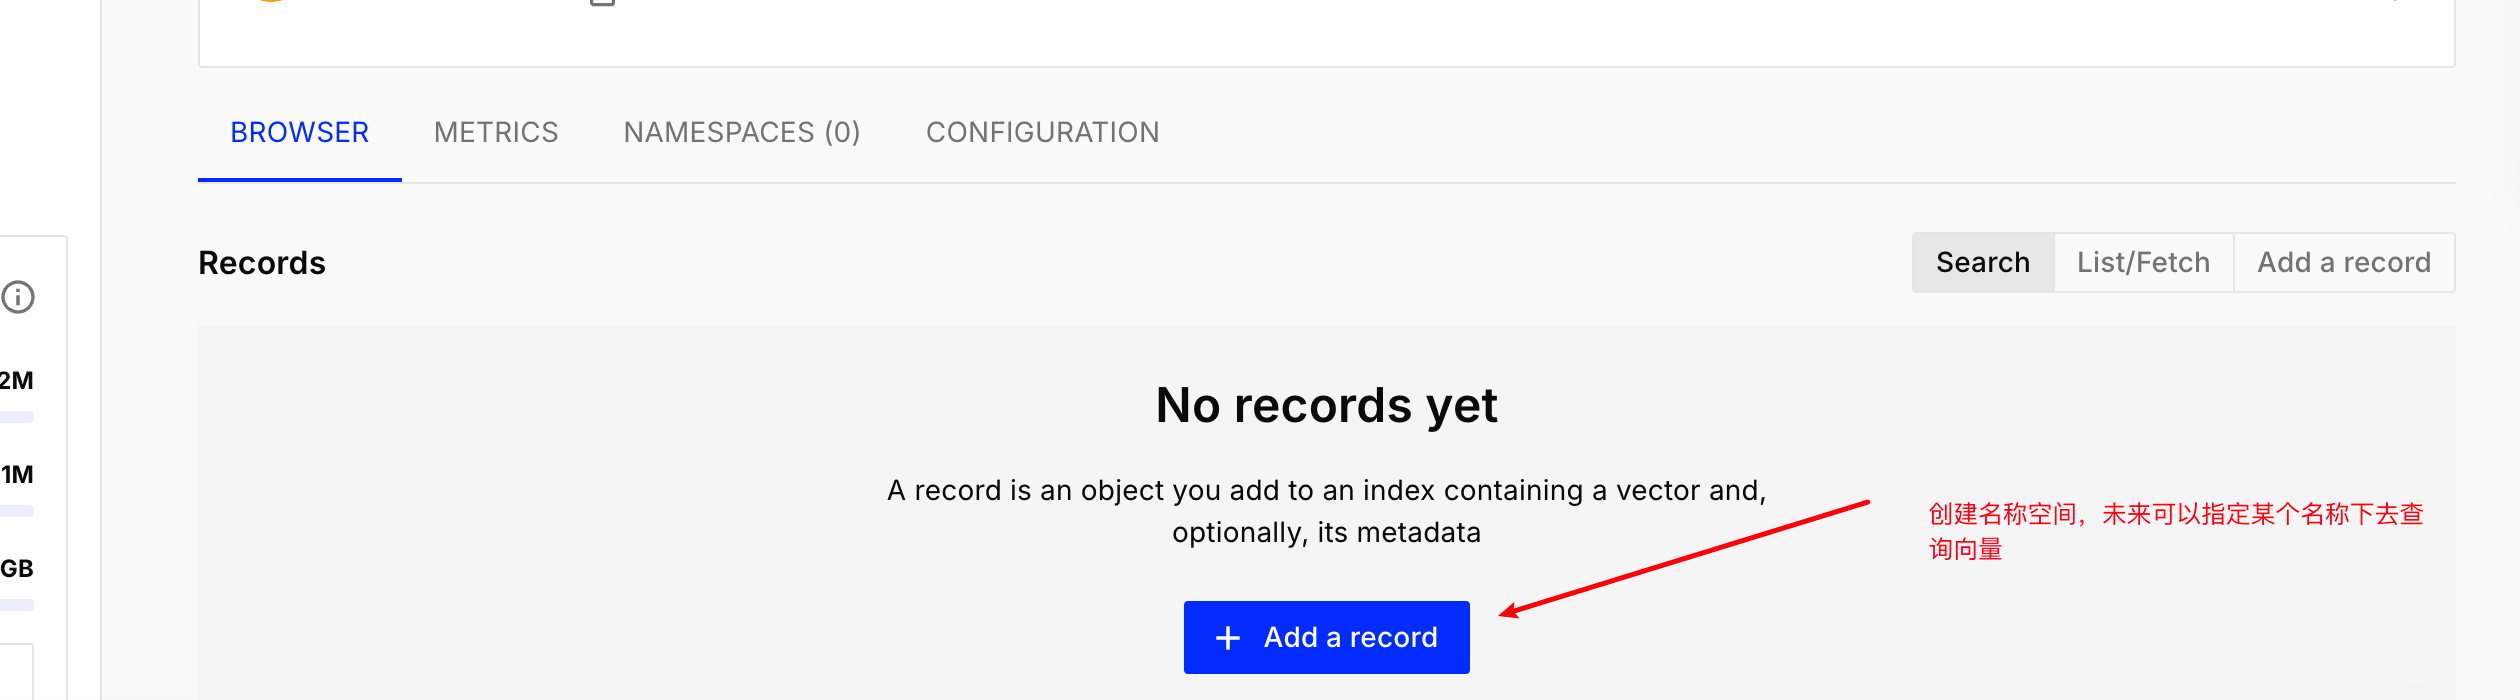
输入内容如下:
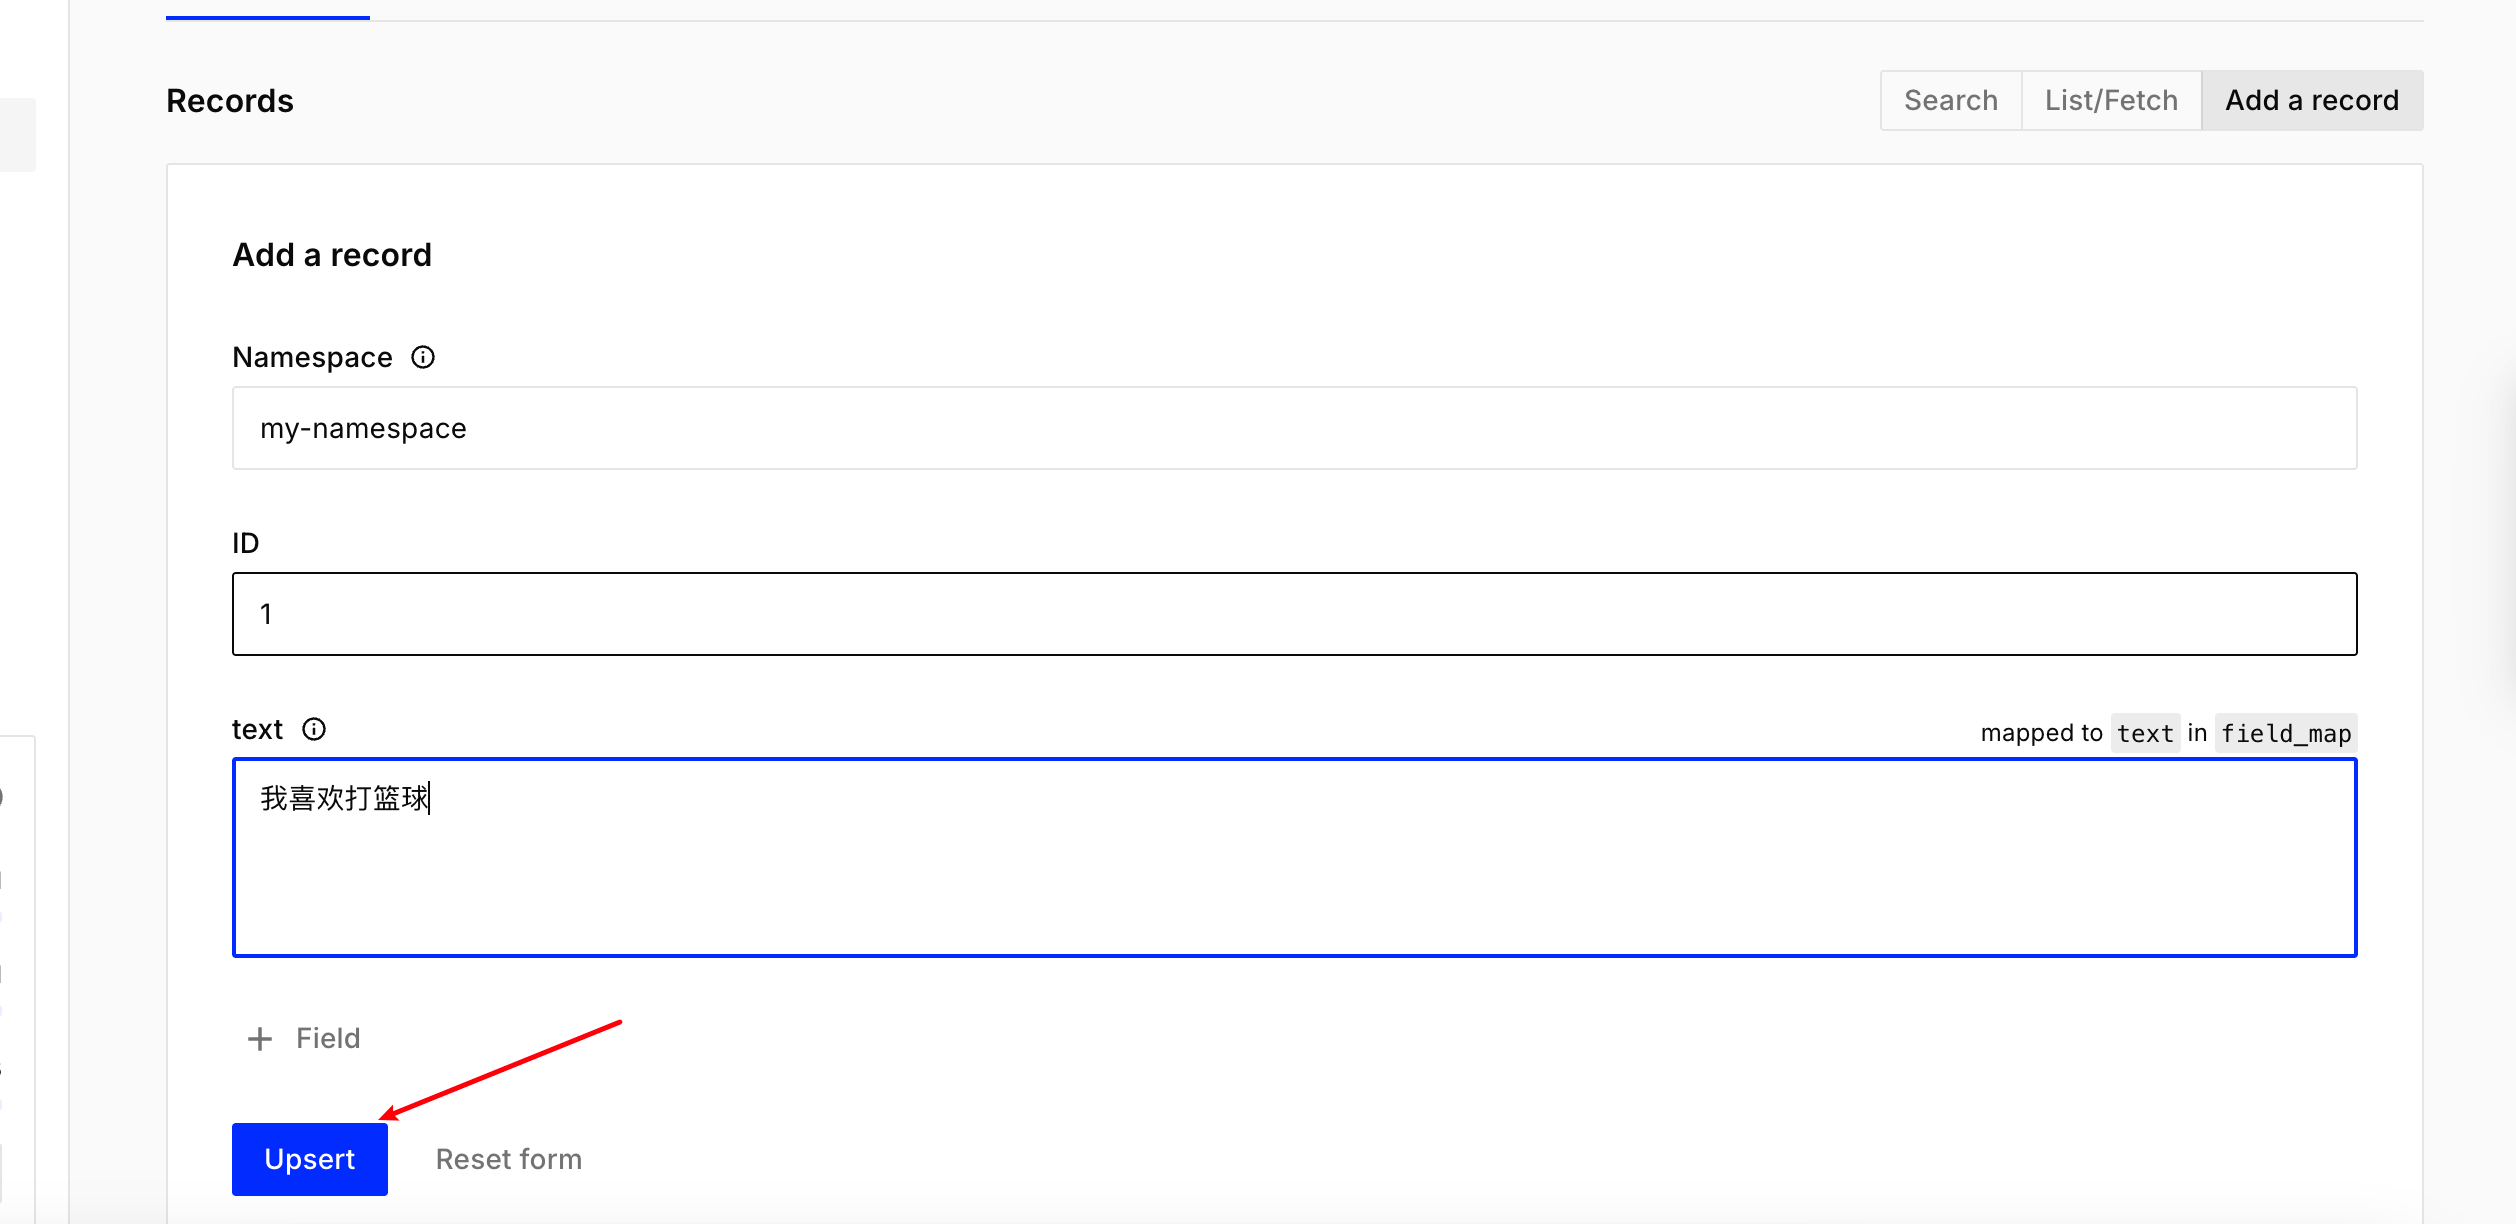
此时在myindex中就有了一条记录:
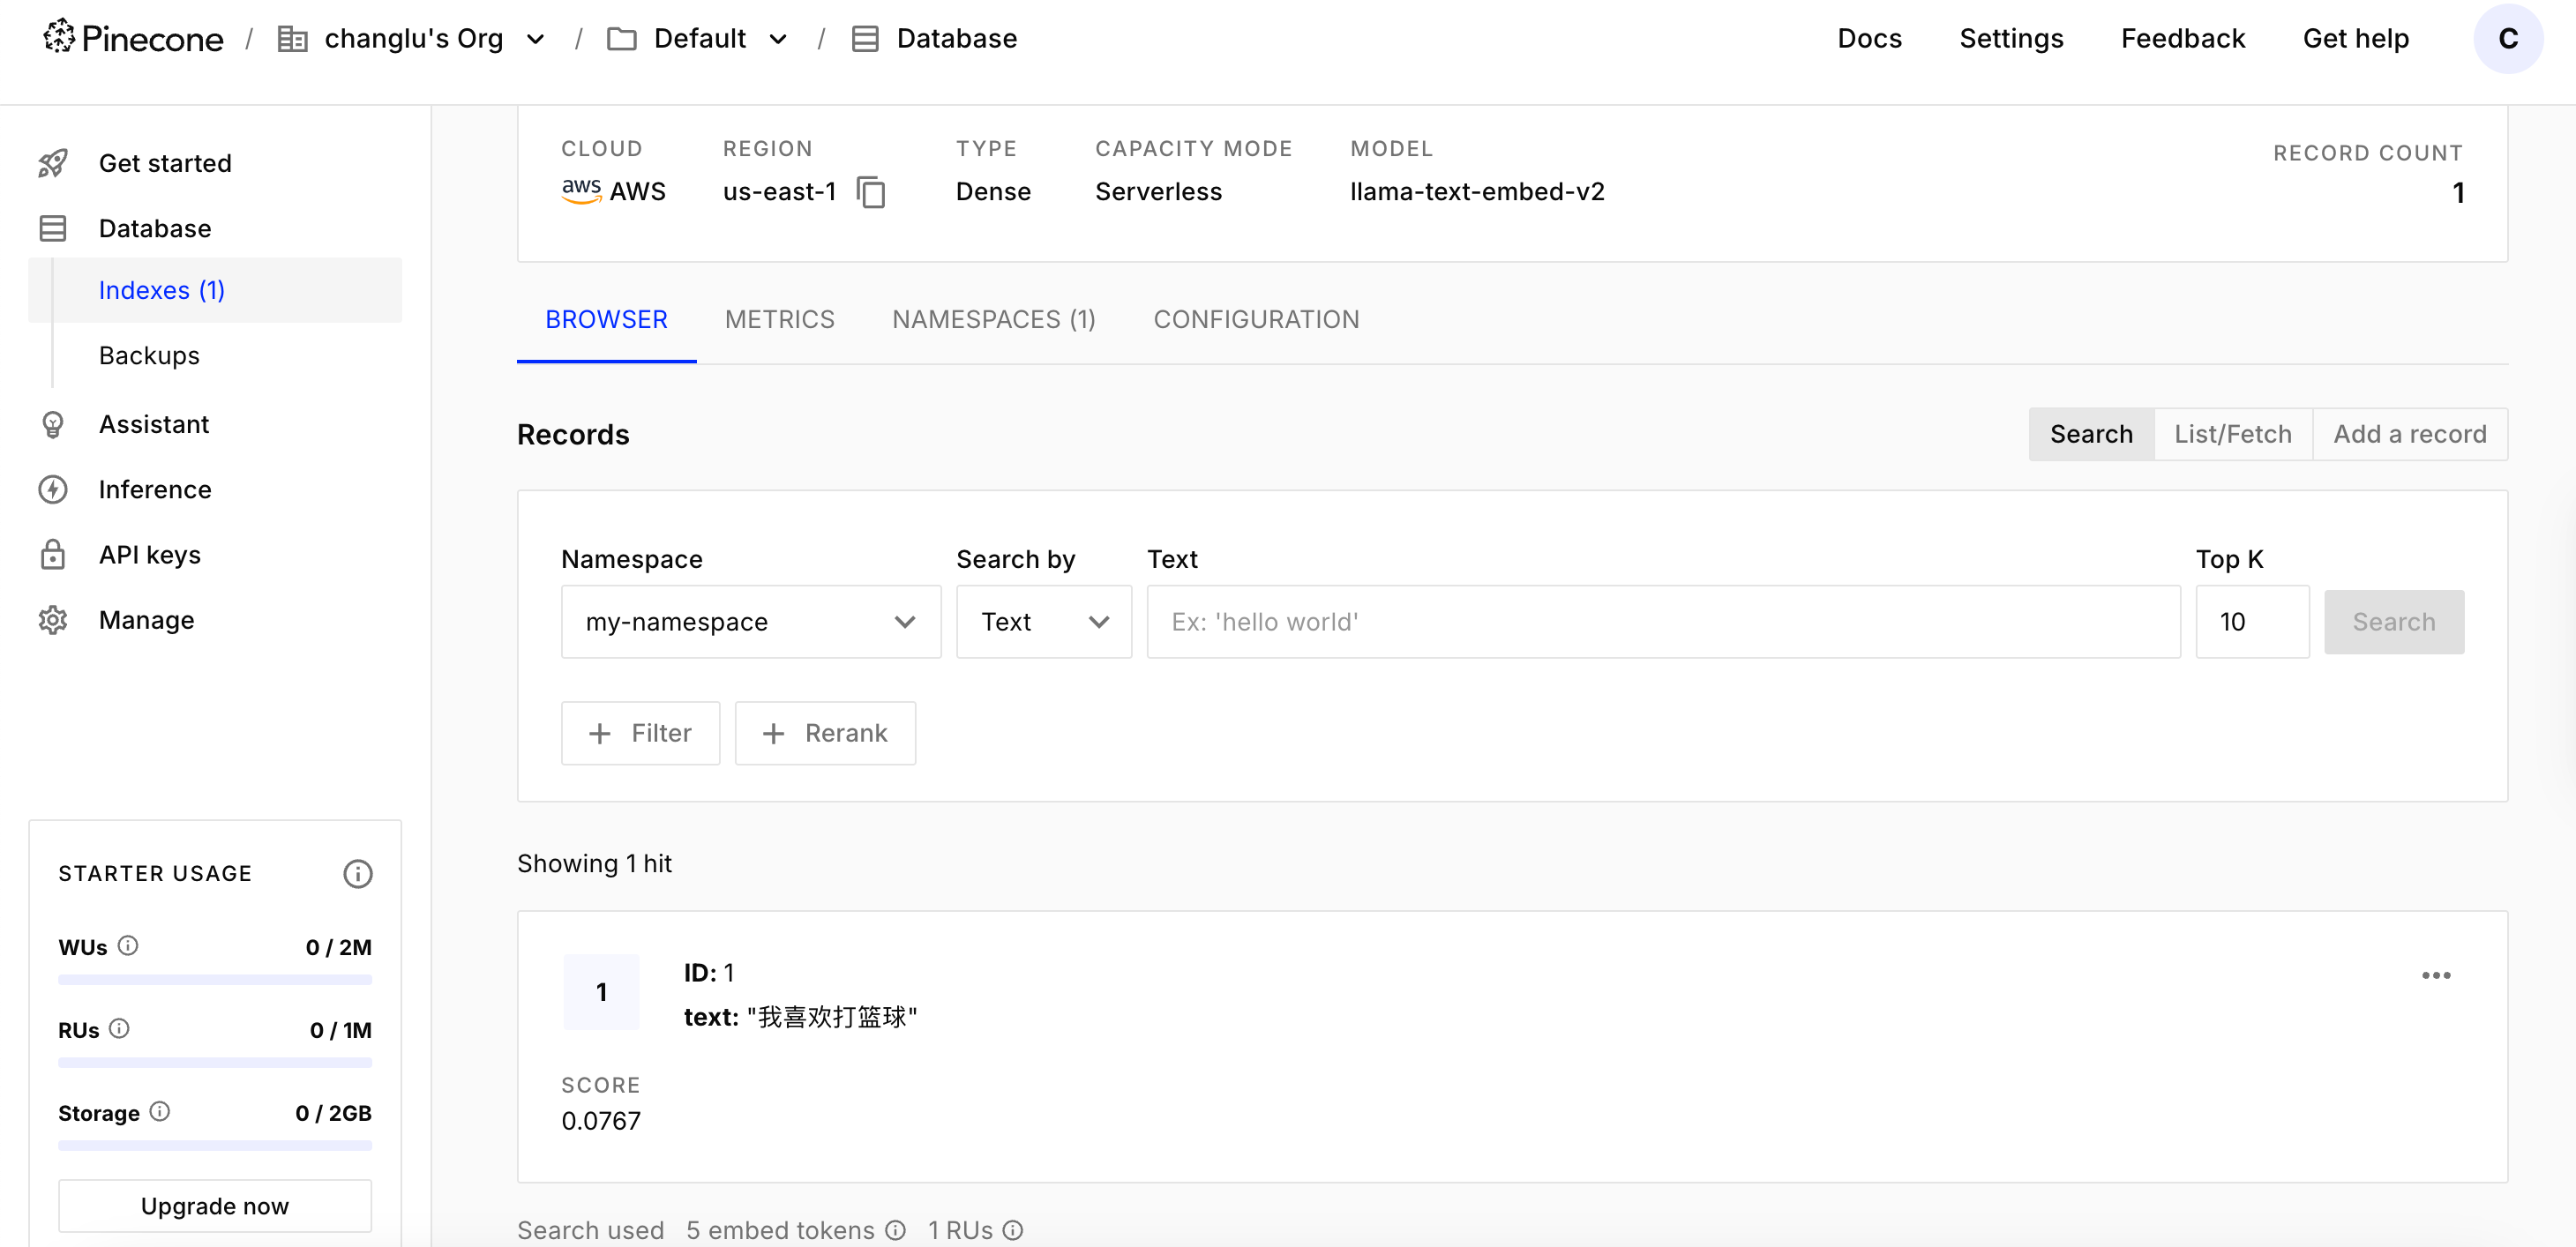
测试下查询条件:
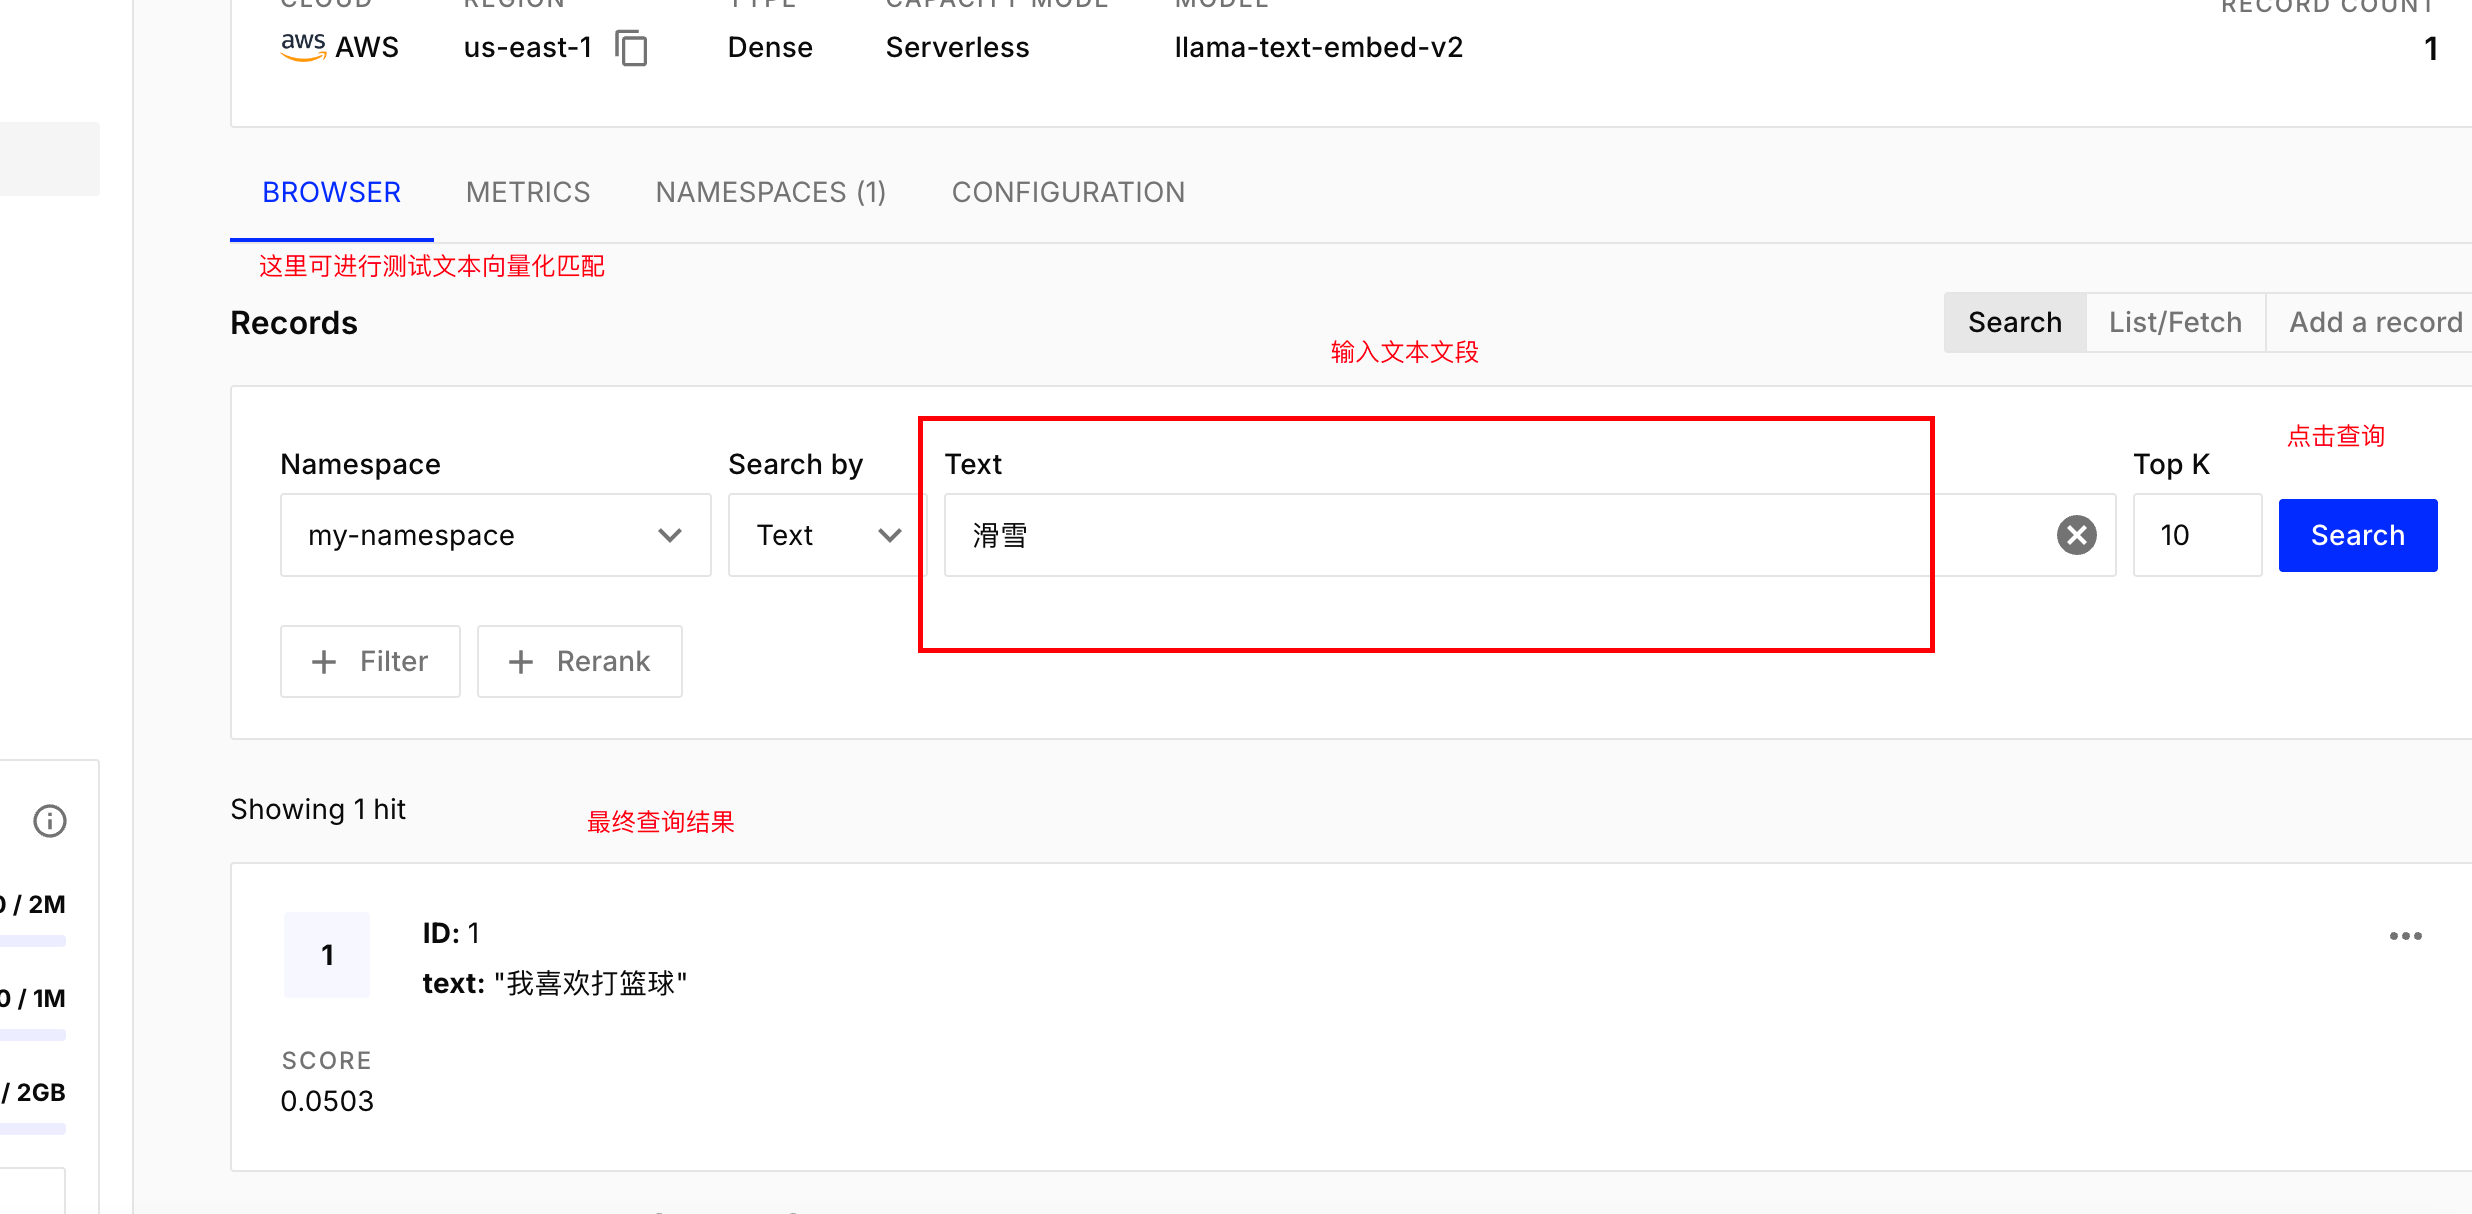
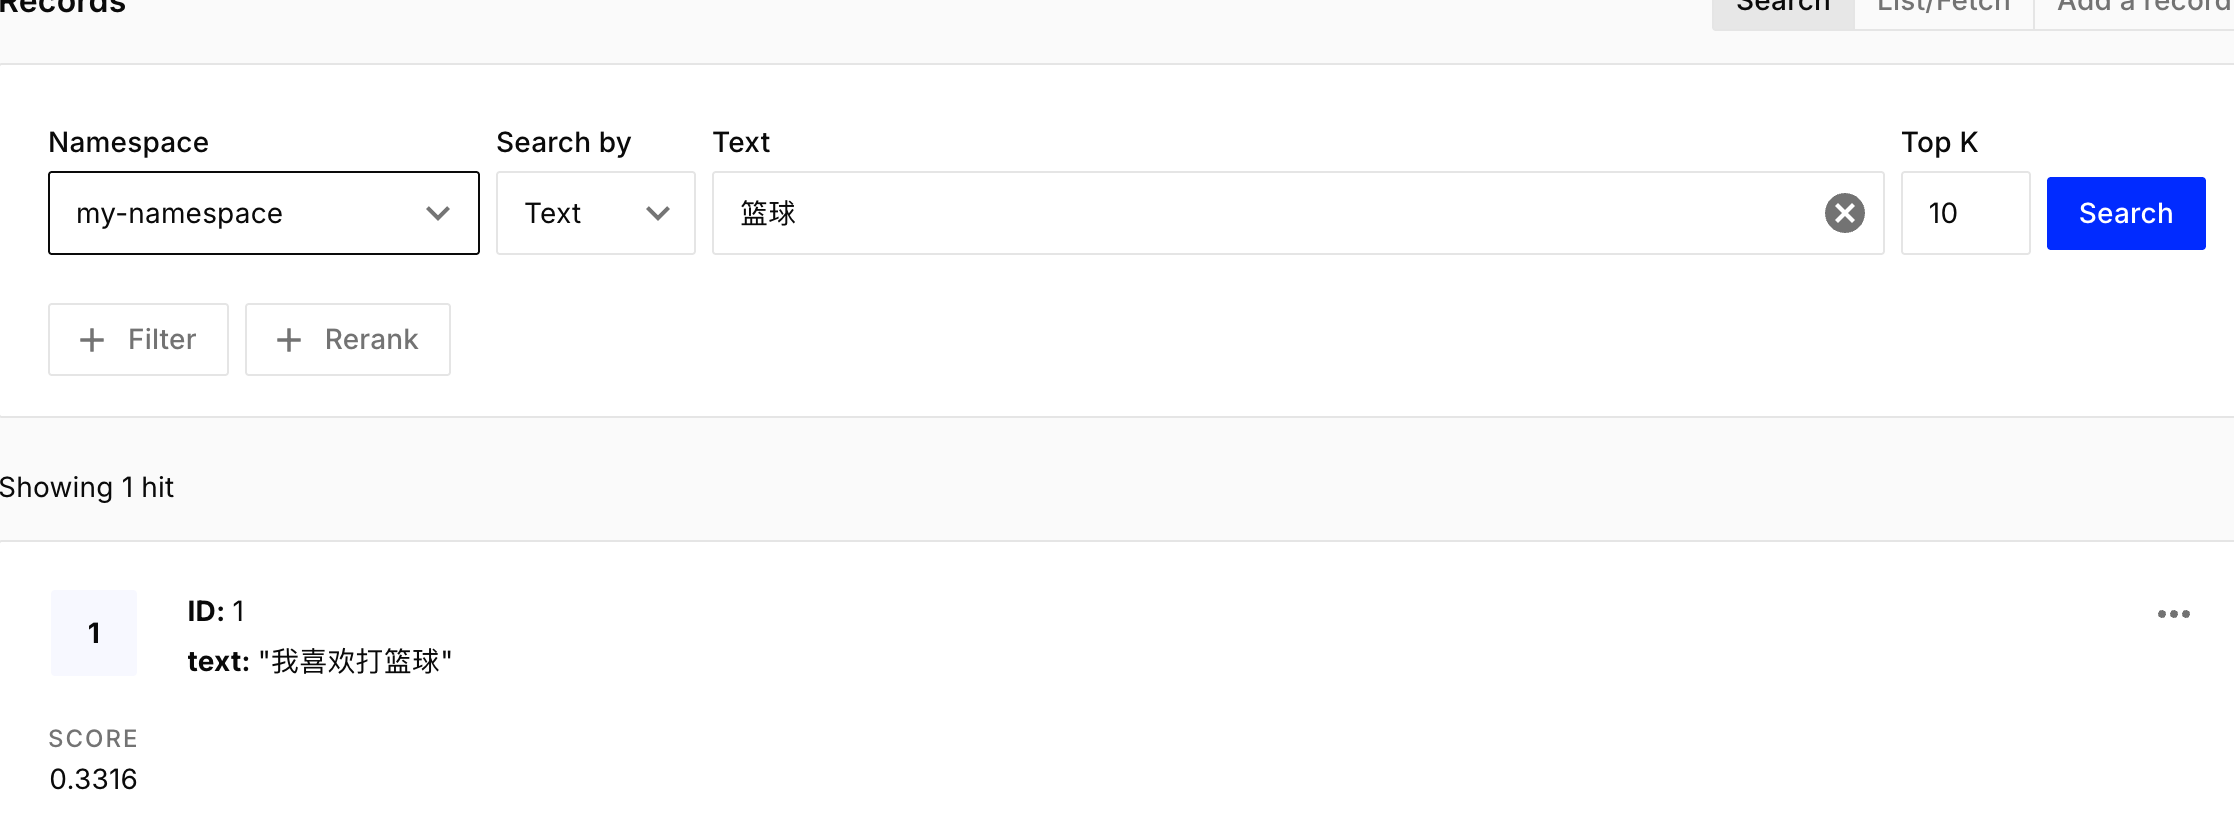
其中底部就有一个score分数,用于表示匹配的权重。
6.2.4、集成Pinecone
6.2.4.1、pom引入Pinecone依赖
pom.xml引入依赖:
<!-- pinecone向量       -->
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-pinecone</artifactId>
</dependency>
6.2.4.2、配置环境变量
配置pinecone的密钥变量参数:
vim ~/.zshrc

# 配置内容
# pinecone
export PINECONE_API_KEY="xxxxxxxxx"

# 生效配置文件
source ~/.zshrc
注意:变量参数配置完之后,IDEA需要进行重启。
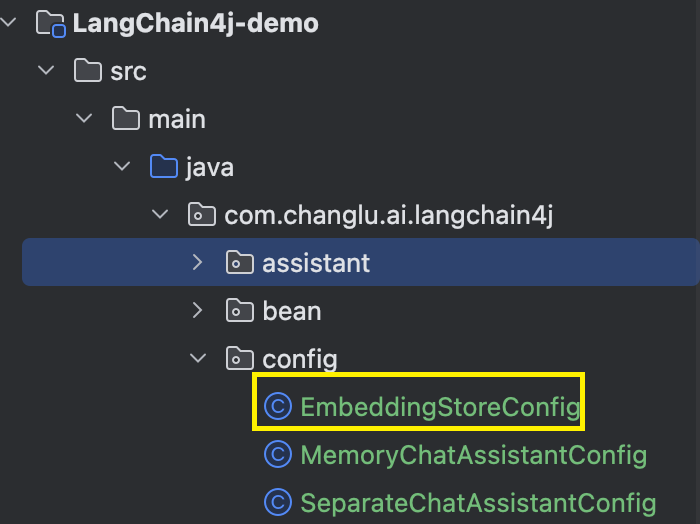
6.2.4.3、配置向量存储对象EmbeddingStore
@Configuration
public class EmbeddingStoreConfig {

    @Autowired
    private EmbeddingModel embeddingModel;

    @Bean
    public EmbeddingStore<TextSegment> embeddingStore() {
        //创建向量存储
        EmbeddingStore<TextSegment> embeddingStore = PineconeEmbeddingStore.builder()
                .apiKey(System.getenv("PINECONE_API_KEY"))
                .index("myindex")//如果指定的索引不存在,将创建一个新的索引
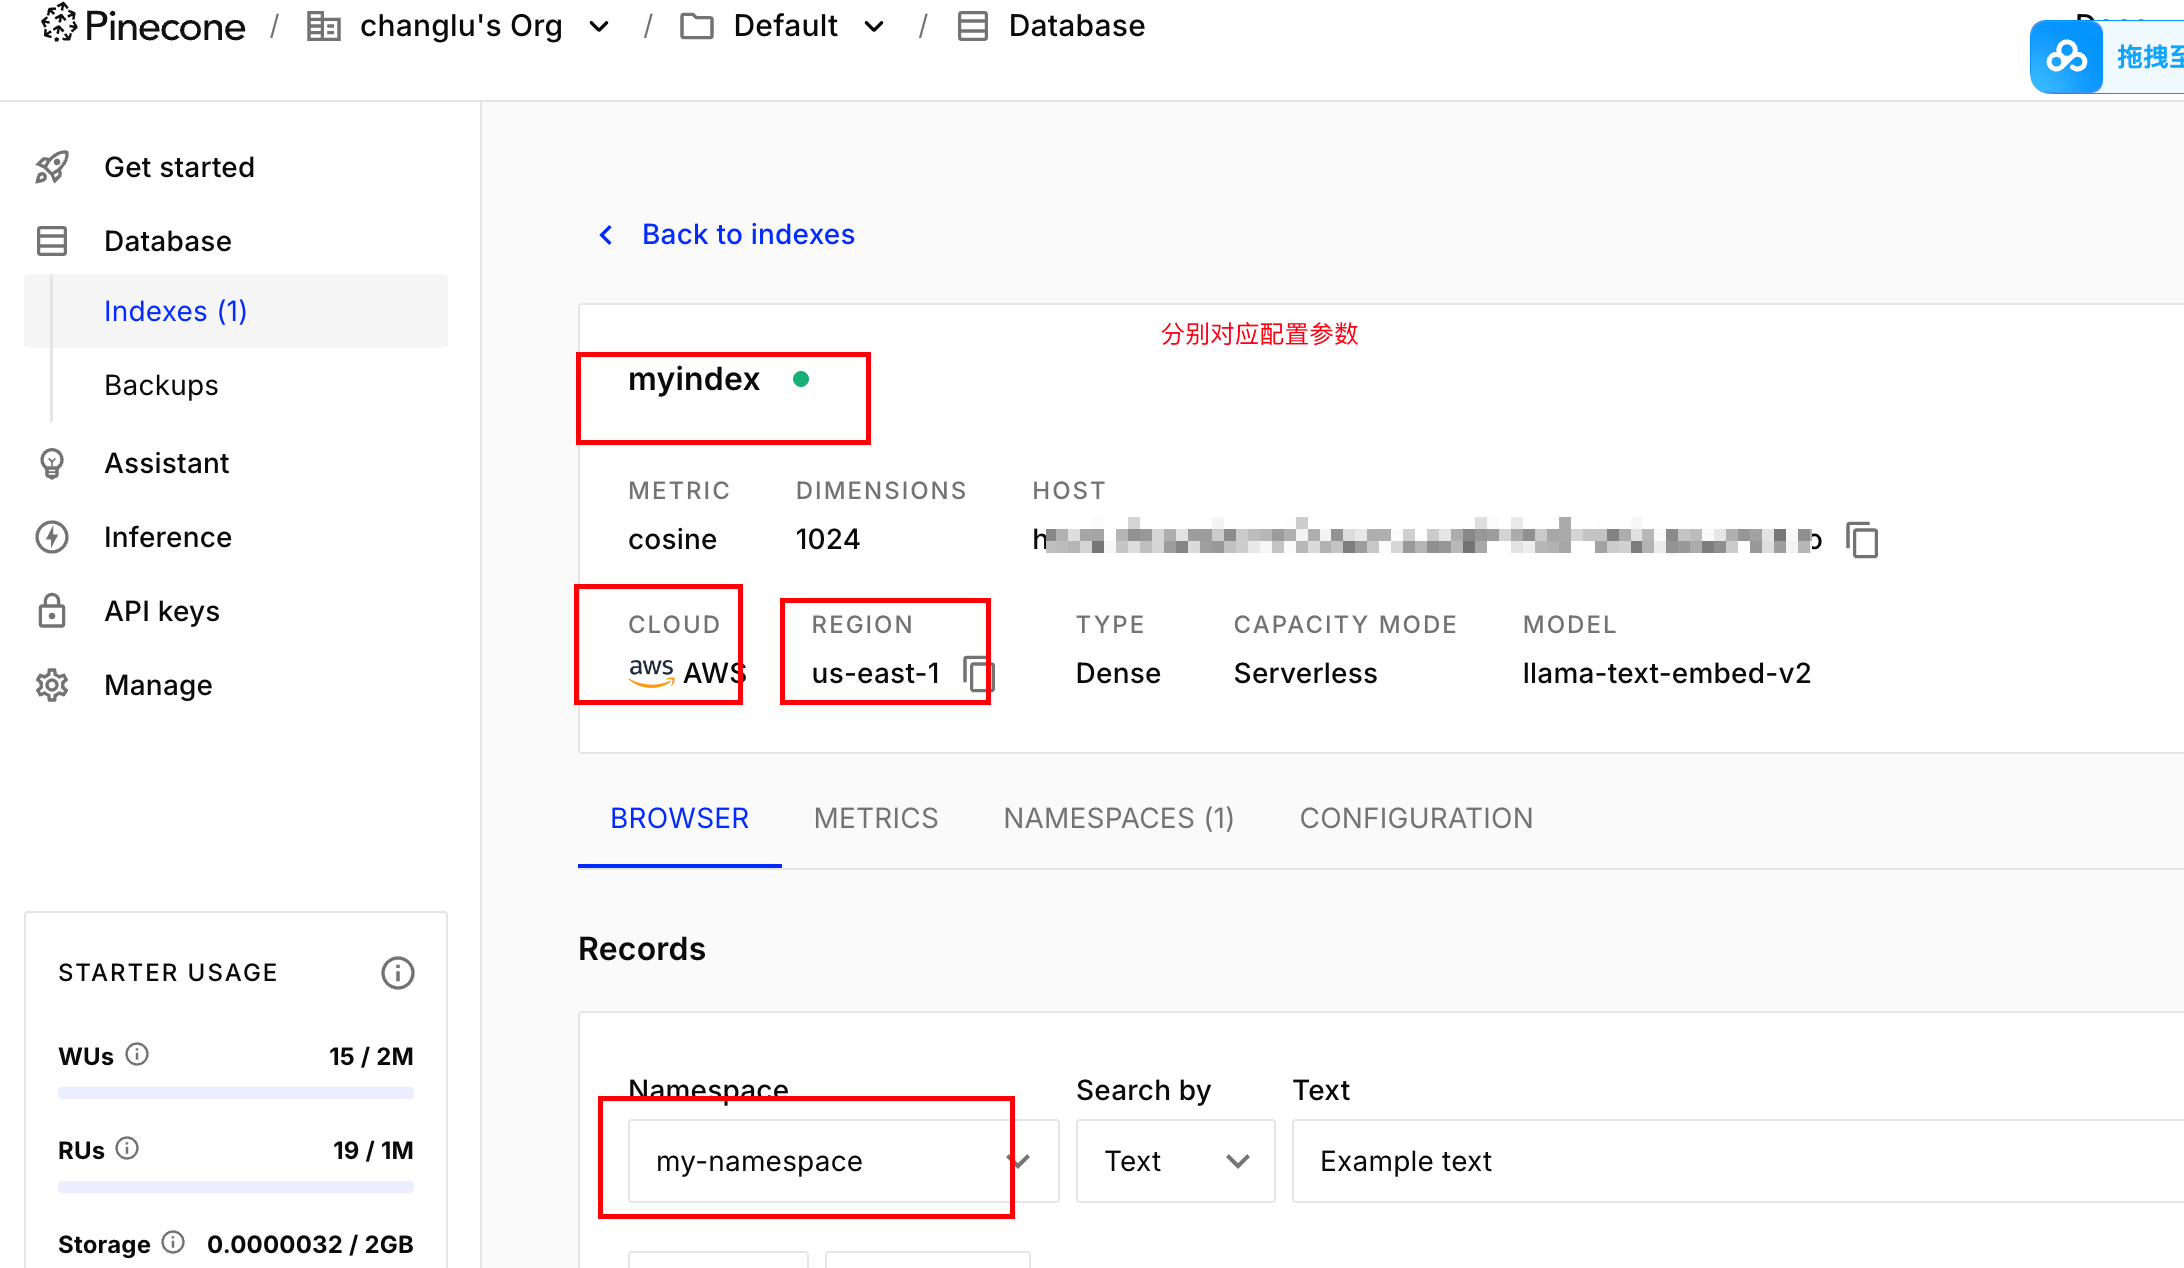
                .nameSpace("my-namespace") //如果指定的名称空间不存在,将创建一个新的名称空间
                .createIndex(
                        PineconeServerlessIndexConfig.builder()
                                .cloud("AWS") //指定索引部署在 AWS 云服务上。
                                .region("us-east-1") //指定索引所在的 AWS 区域为 us-east-1。
                                .dimension(embeddingModel.dimension())
                                .build() //指定索引的向量维度,该维度与 embeddedModel 生成的向量维度相同。
                )
                .build();
        return embeddingStore;
    }
}
关于配置参数:
6.2.4.4、测试向量存储
 .
@SpringBootTest
public class PineconeEmbededTest {

    @Autowired
    private EmbeddingStore embeddingStore;

    @Autowired
    private EmbeddingModel embeddingModel;

    @Test
    public void testPineconeEmbeded() {
        //将文本转换成向量
        TextSegment segment1 = TextSegment.from("我喜欢羽毛球");
        Embedding embedding1 = embeddingModel.embed(segment1).content();
        //存入向量数据库
        embeddingStore.add(embedding1, segment1);
        TextSegment segment2 = TextSegment.from("今天天气很好");
        Embedding embedding2 = embeddingModel.embed(segment2).content();
        embeddingStore.add(embedding2, segment2);
    }

}
debug测试:
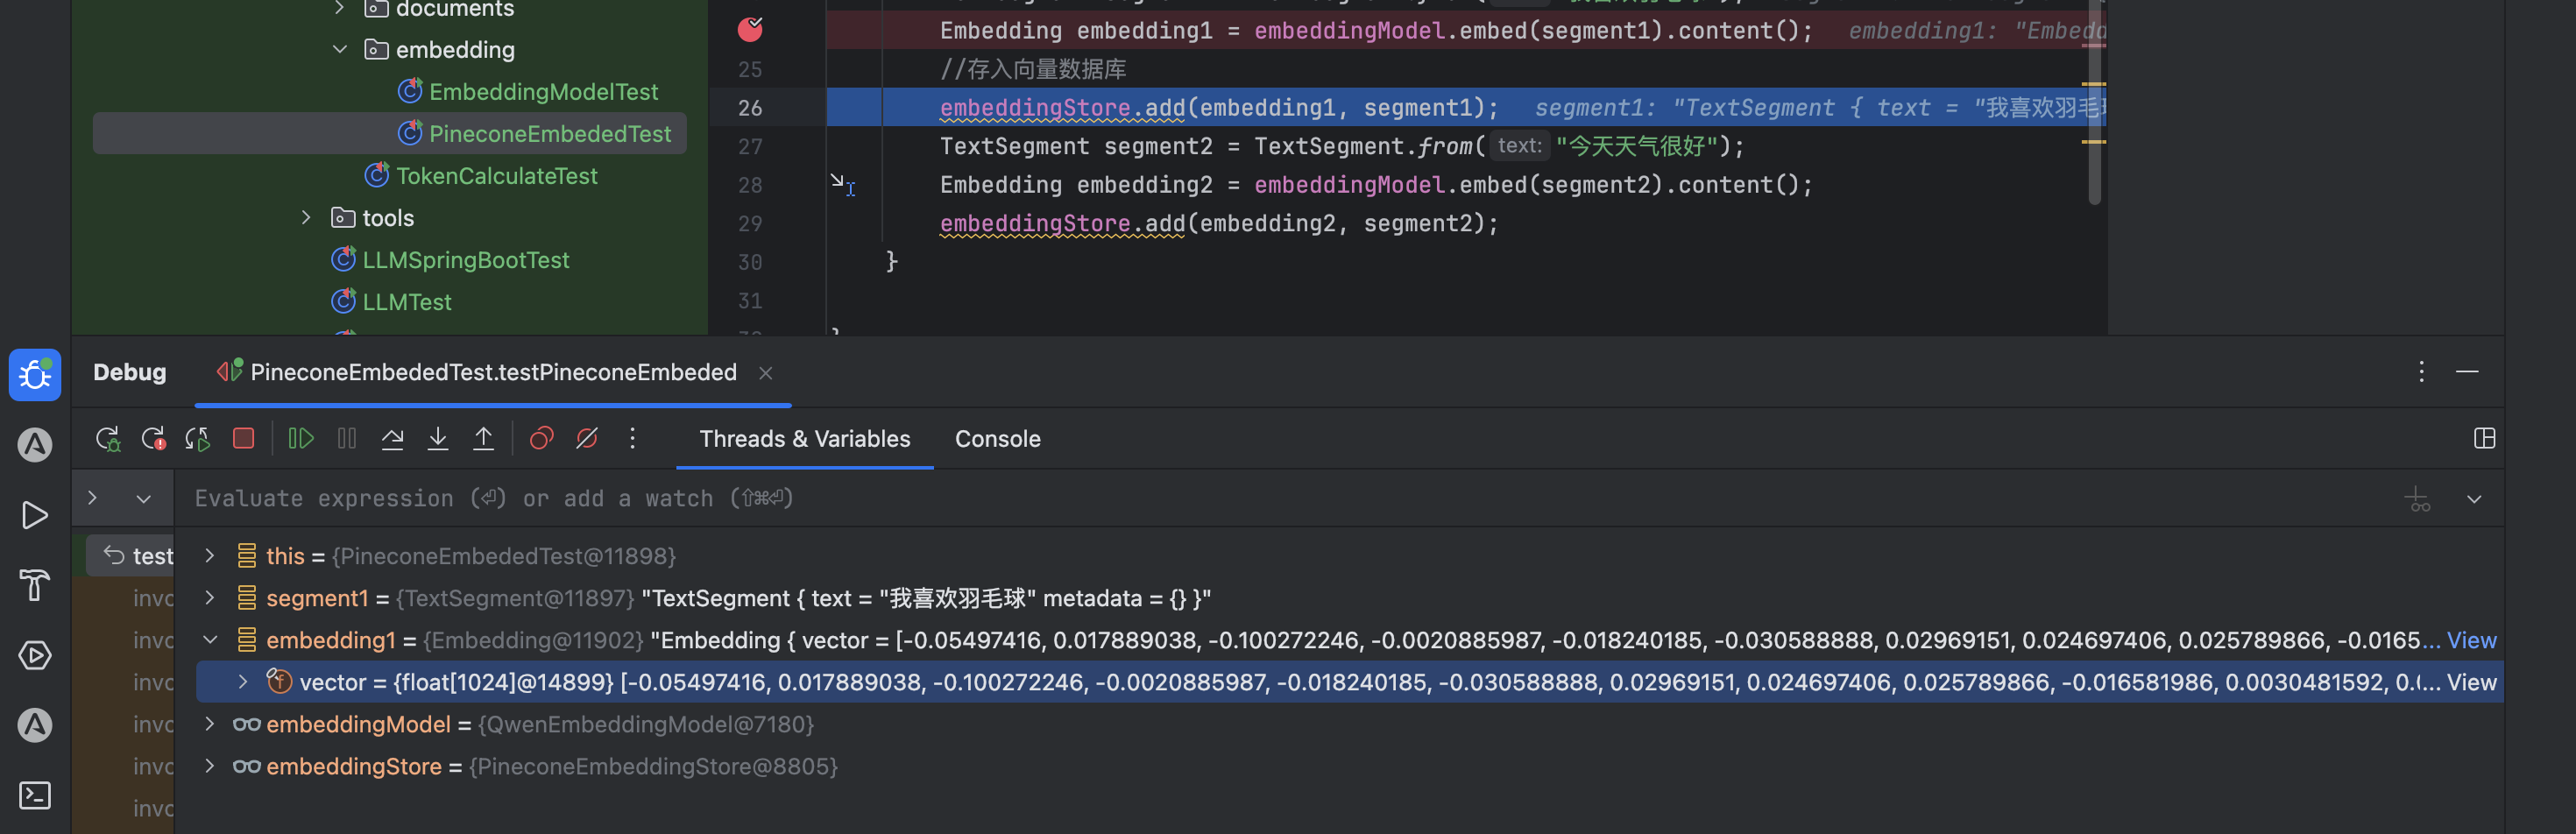
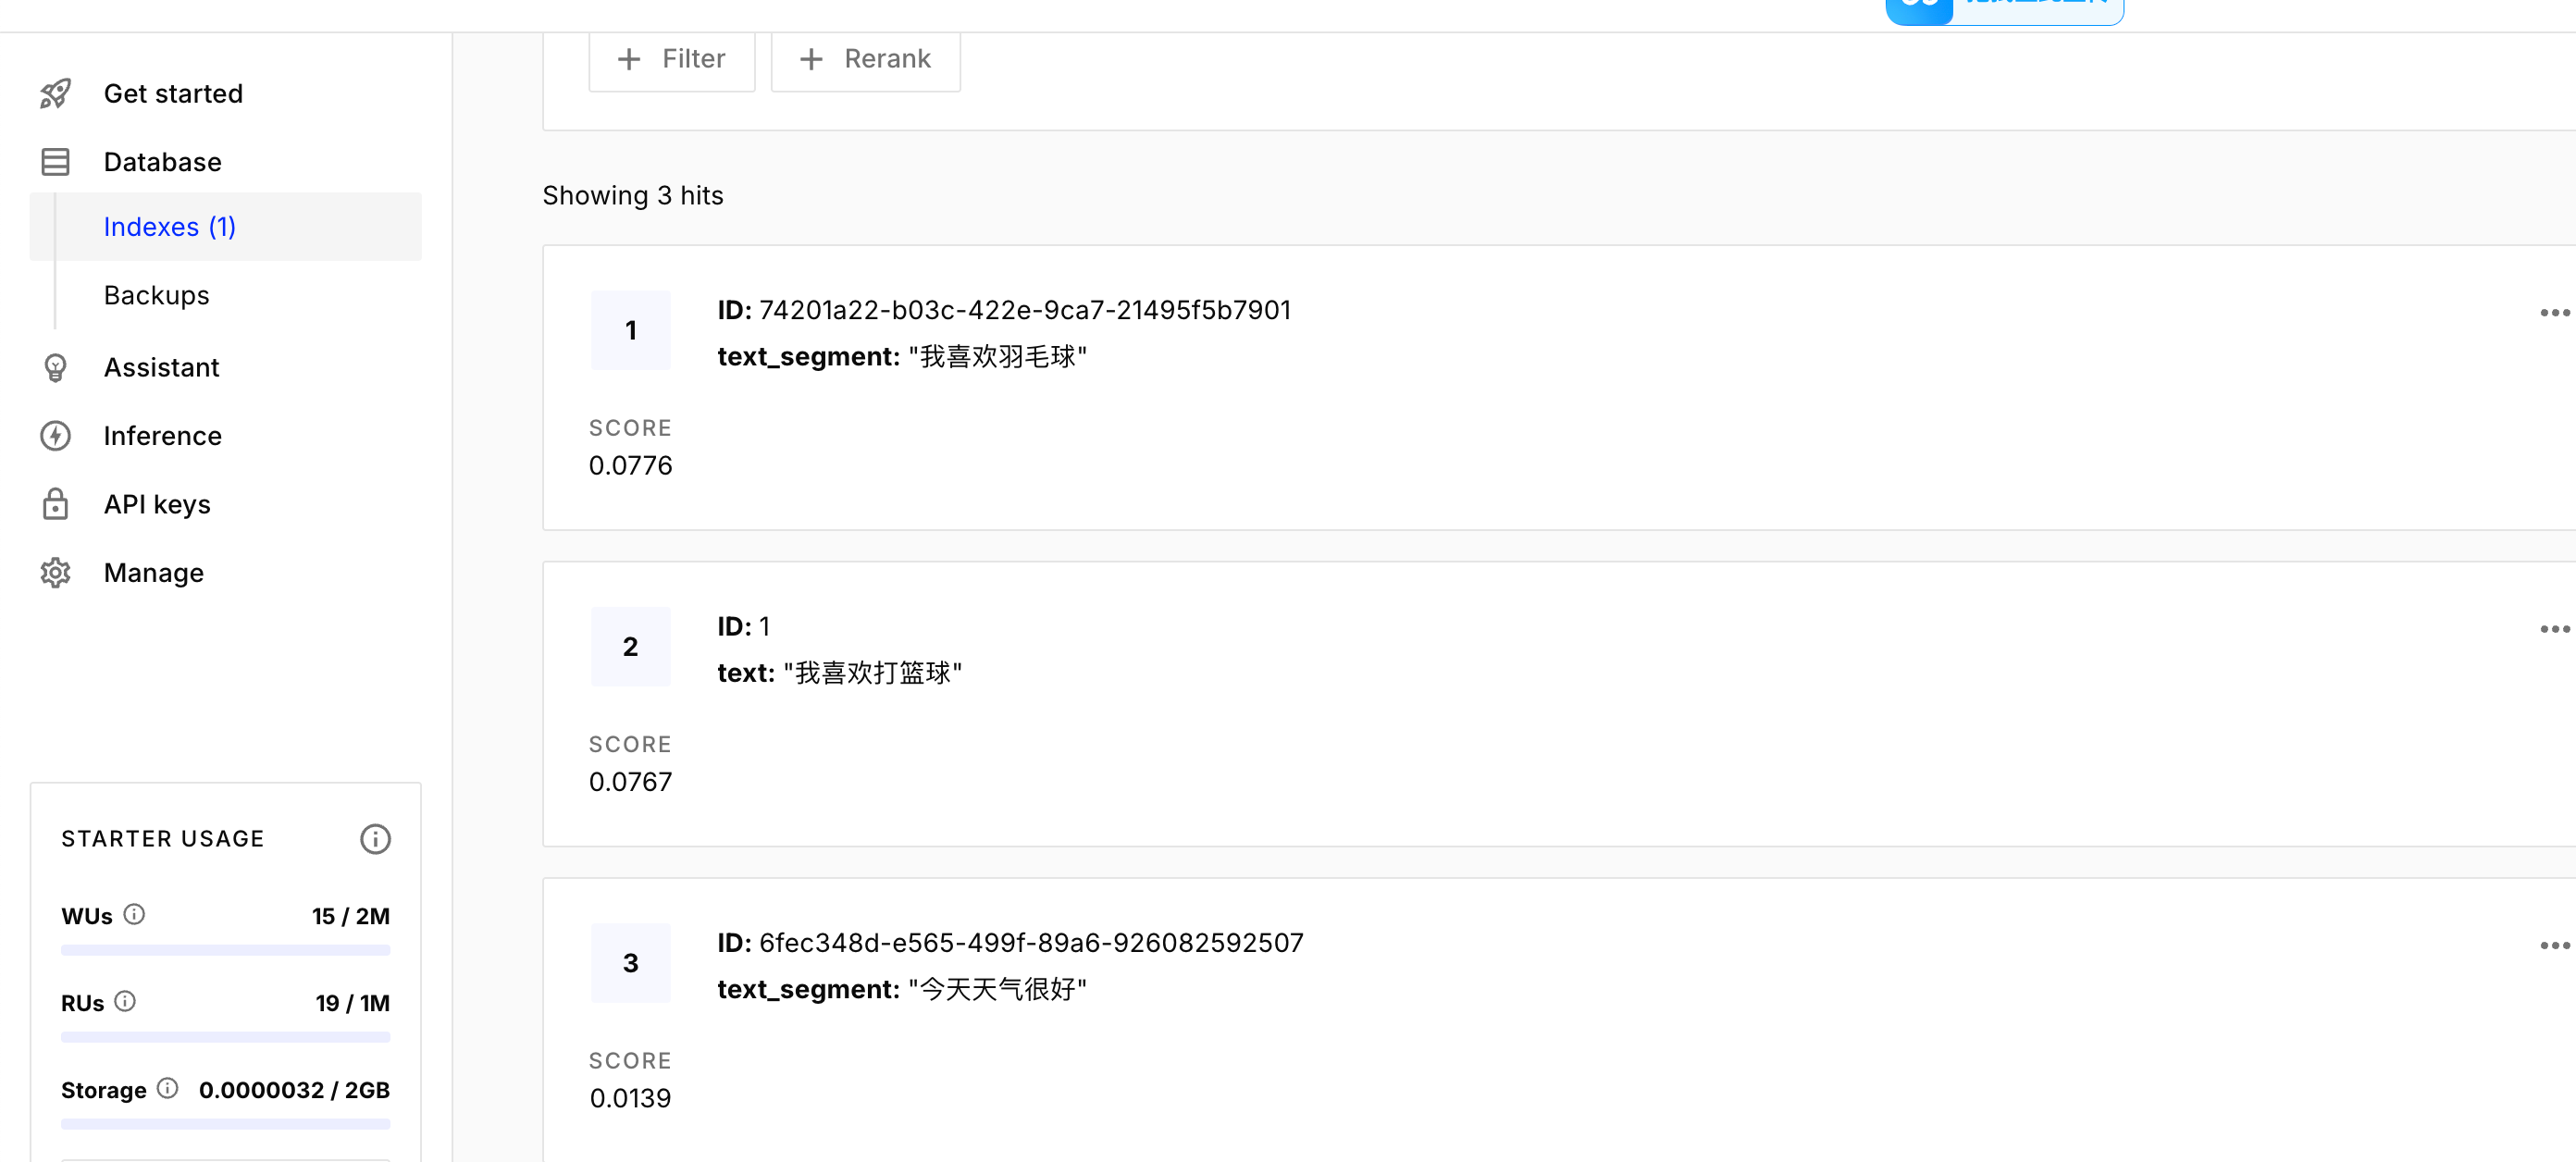
我们进入到Pinecone官网查看下,成功添加两条向量:
6.2.4.5、测试向量相似度匹配
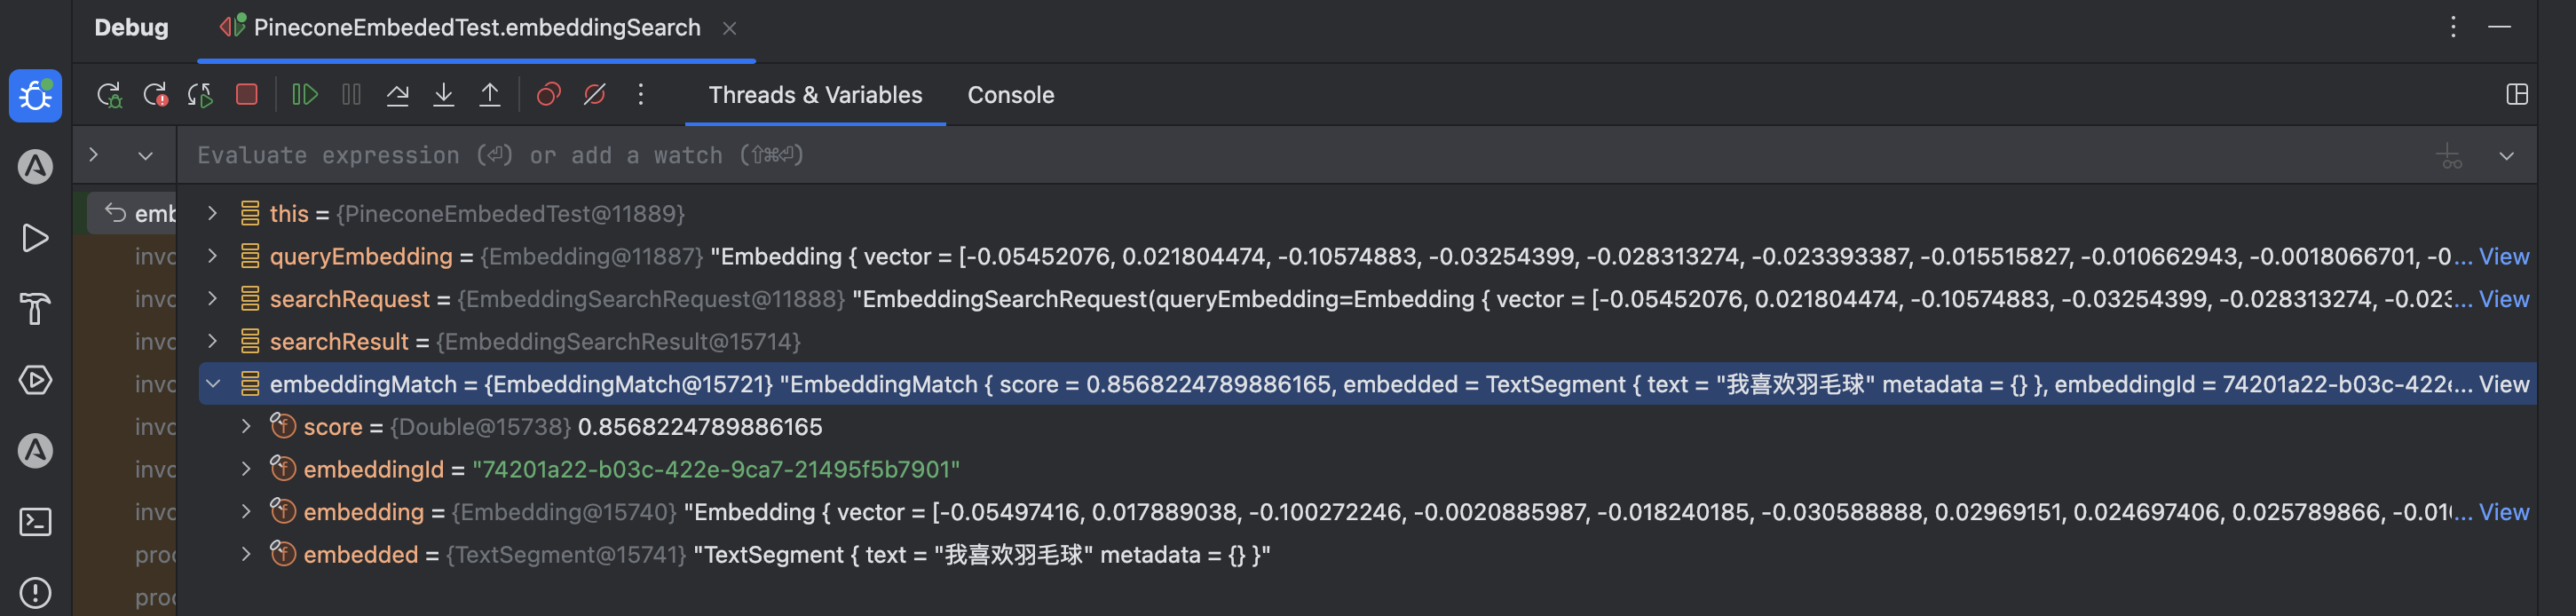
此时会搜索到一个得分最高的向量:
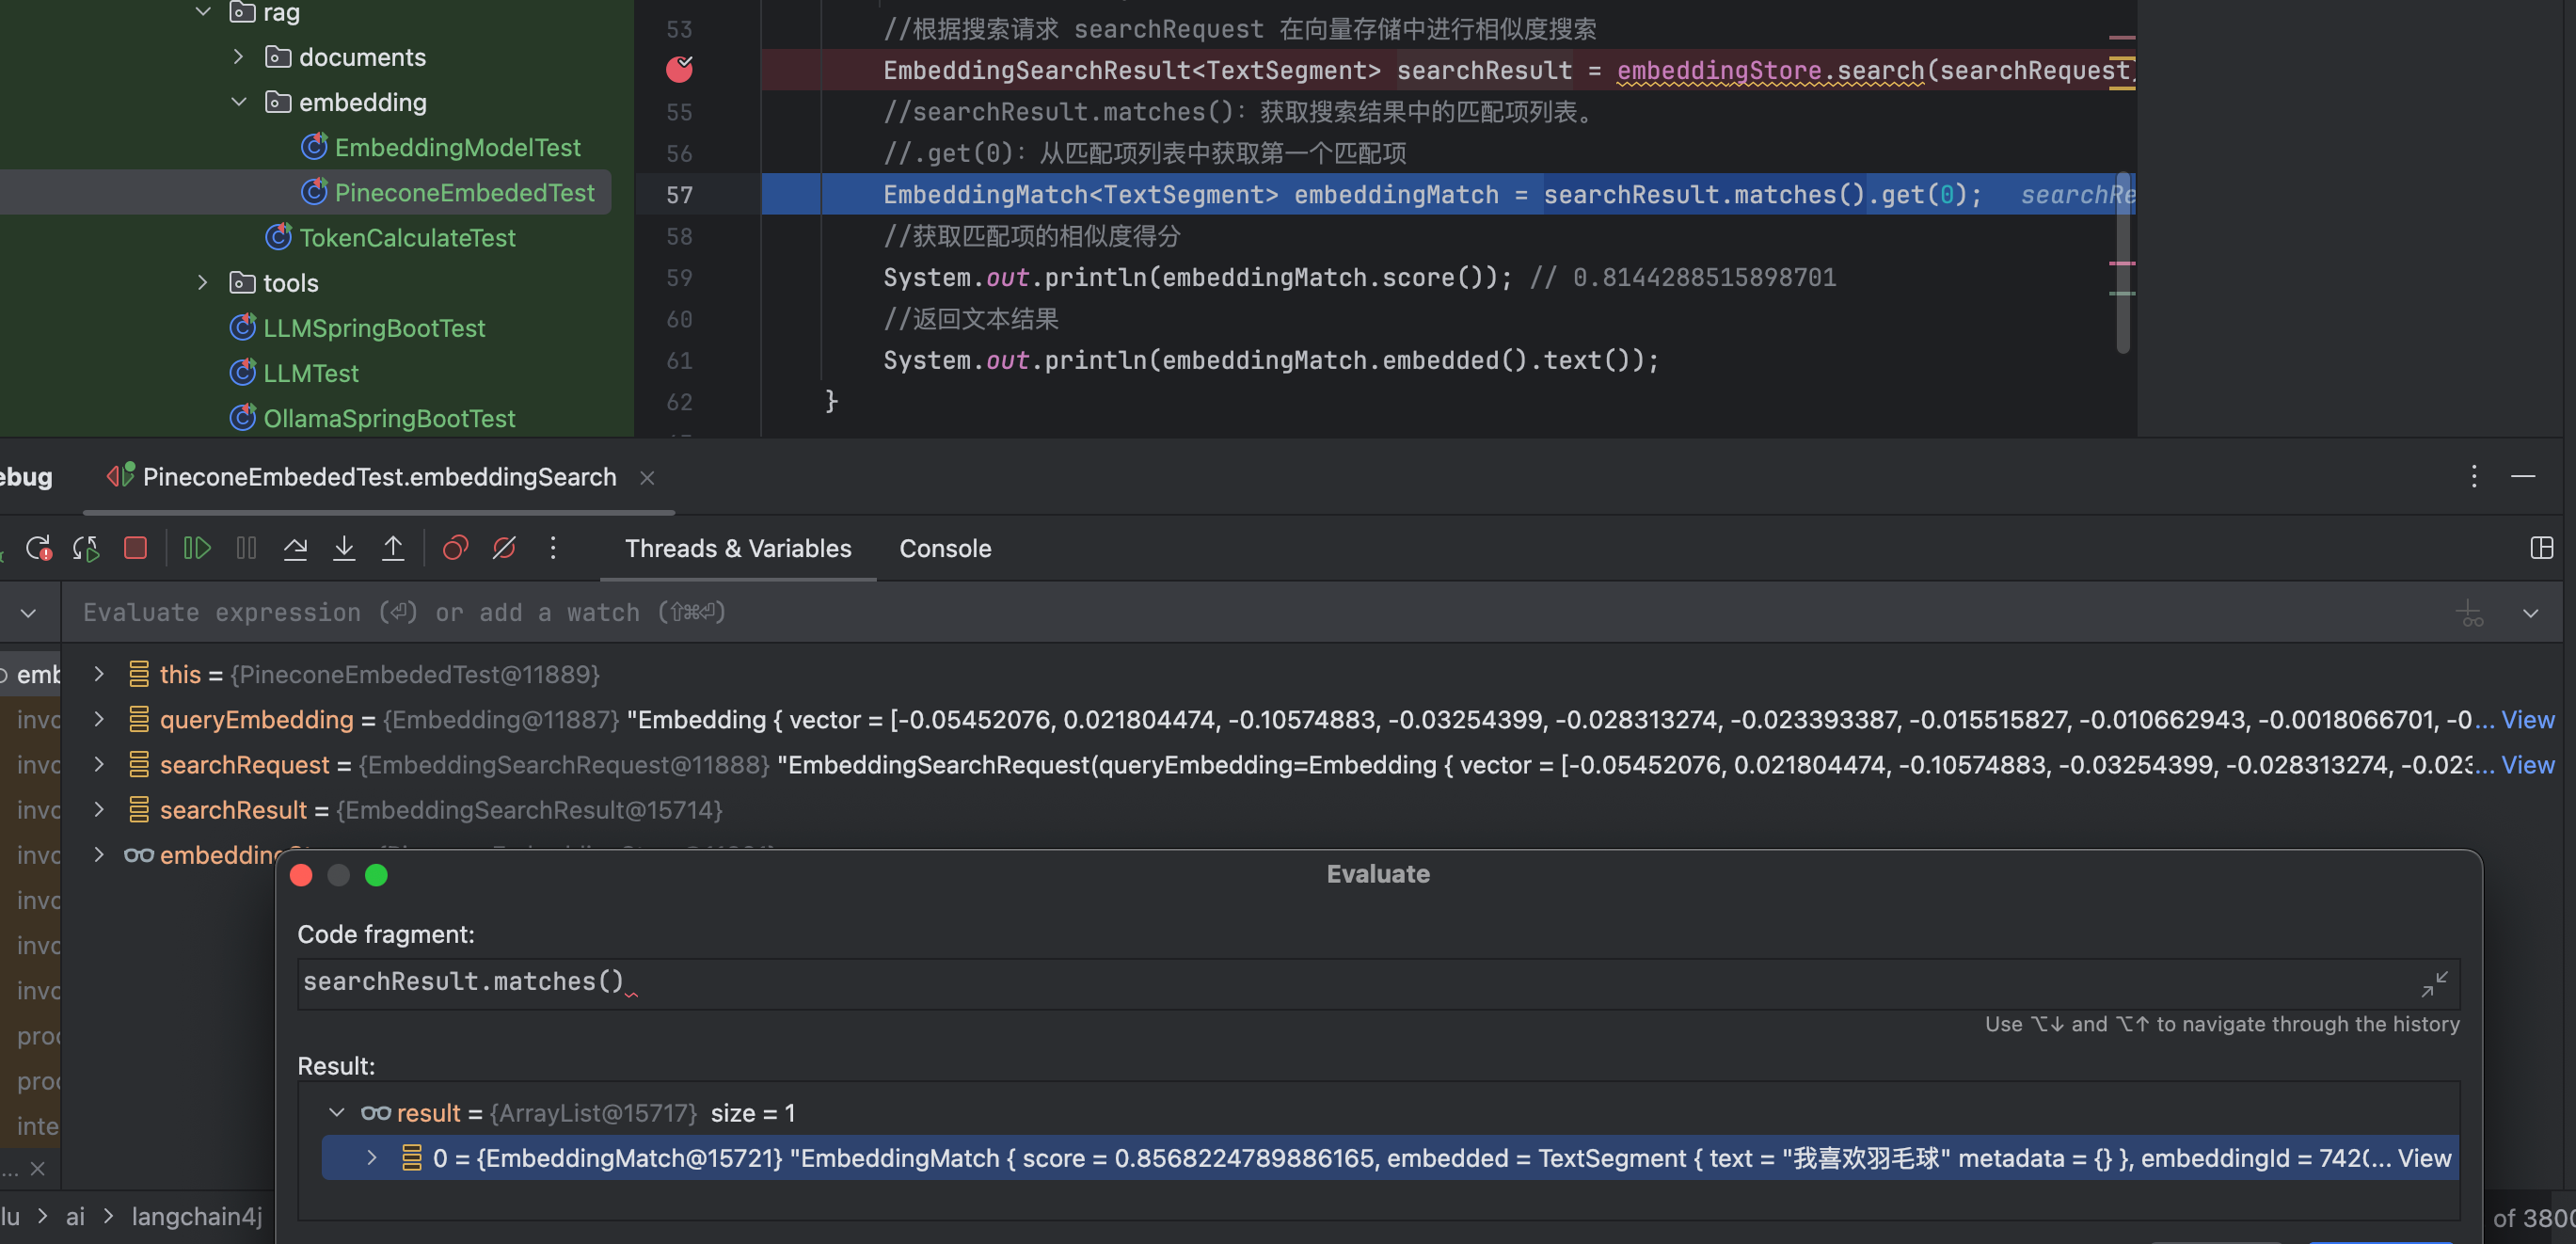
可以看到其得分:
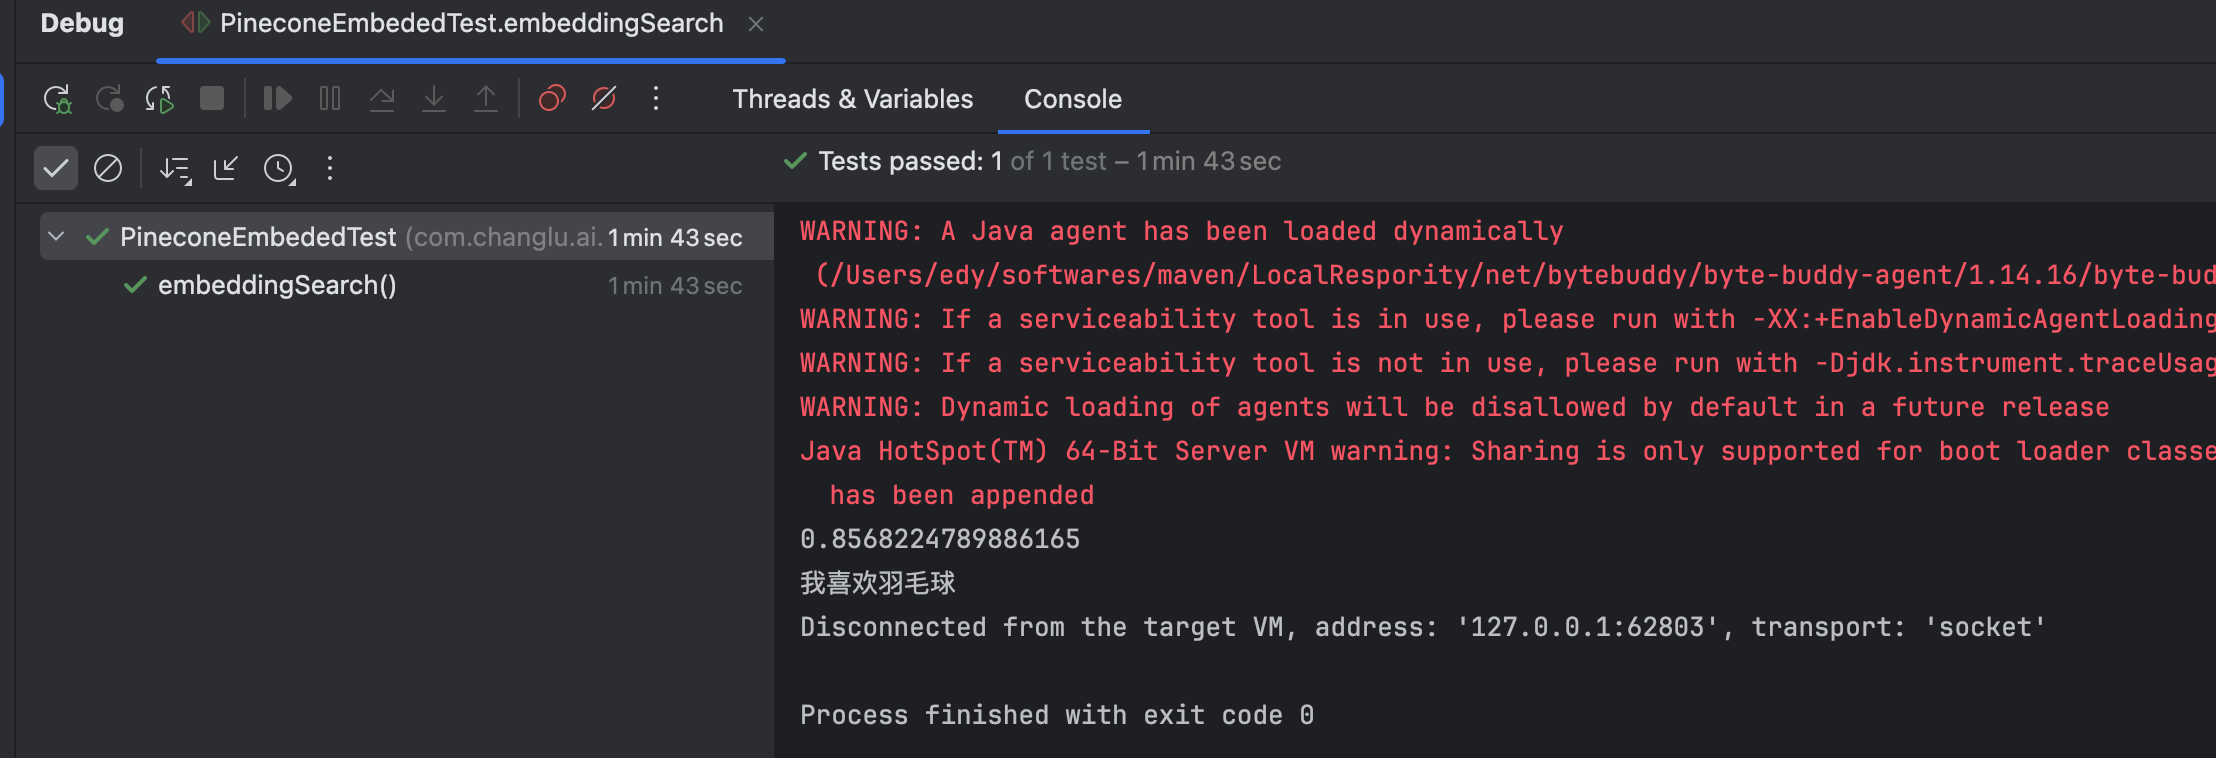
打印内容如下:
资料获取
大家点赞、收藏、关注、评论啦~
精彩专栏推荐订阅:在下方专栏👇🏻
- 长路-文章目录汇总(算法、后端Java、前端、运维技术导航):博主所有博客导航索引汇总
- 开源项目Studio-Vue—校园工作室管理系统(含前后台,SpringBoot+Vue):博主个人独立项目,包含详细部署上线视频,已开源
- 学习与生活-专栏:可以了解博主的学习历程
- 算法专栏:算法收录
更多博客与资料可查看👇🏻获取联系方式👇🏻,🍅文末获取开发资源及更多资源博客获取🍅
整理者:长路 时间:2025.5.17.
评论区请在客户端页面查看