原理实现
在搜索引擎中,每个文档都有一个对应的文档 ID,文档内容被表示为一系列关键词的集合。例如,文档 1 经过分词,提取了 20 个关键词,每个关键词都会记录它在文档中出现的次数和出现位置。
那么,倒排索引就是关键词到文档 ID 的映射,每个关键词都对应着一系列的文件,这些文件中都出现了关键词。
举个栗子。
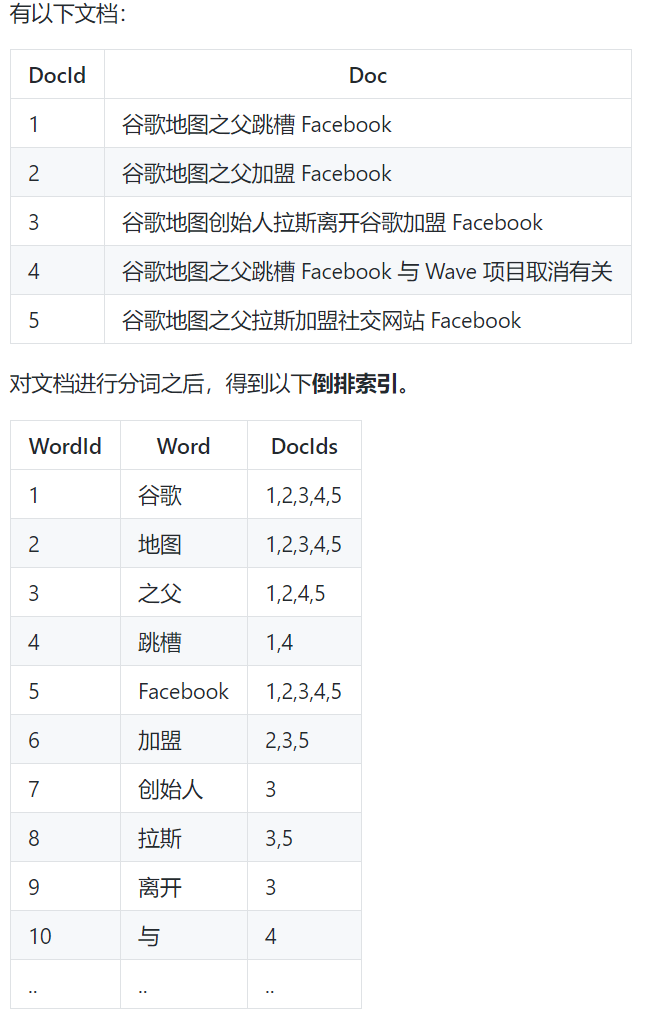
另外,实用的倒排索引还可以记录更多的信息,比如文档频率信息,表示在文档集合中有多少个文档包含某个单词。
那么,有了倒排索引,搜索引擎可以很方便地响应用户的查询。比如用户输入查询 Facebook,搜索系统查找倒排索引,从中读出包含这个单词的文档,这些文档就是提供给用户的搜索结果。
要注意倒排索引的两个重要细节:
- 倒排索引中的所有词项对应一个或多个文档;
- 倒排索引中的词项根据字典顺序升序排列
问题思考
1、如果搜索的字段不在分词中的呢?(N-gram分词器)
**问题:**如果不在倒排索引中,比如分词 java学习,java、学习两个词。我单独搜索j 能搜到嘛?
不能。 如果您在搜索框中只输入一个字母 j,而您的倒排索引里只记录了完整的词项(如 java, 学习),那么搜索引擎不会返回包含 java 的文档。
倒排索引中的词项根据字典顺序升序排列。
- 倒排索引的“查找”是精确匹配
当您搜索关键词
Facebook时,搜索引擎并不是去扫描所有文档,而是在这个已经排序的倒排索引字典里,执行一次非常高效的二分查找,直接找到词项Facebook,然后取出它对应的文档列表。 同样,如果您搜索java,它会去精确查找词项java。 但是,如果您搜索j,搜索引擎会去查找词项j。由于您的索引里只有java、学习等,没有j这个独立的词项,所以这次查找会失败,返回“未找到”。 - 分词的重要性
您提到的例子
java学习被分词成java和学习,这本身就是构建倒排索引的第一步——文本分析。 这个过程通常包括:
-
- 分词:将文本拆分成独立的词元。
- 规范化:如转为小写。
- 去除停用词:如去掉“的”、“了”等无实际意义的词。
- 词干提取:如将 “running” 转为 “run”。
经过这些步骤后,只有像 java, 学习 这样的完整词项才会被存入倒排索引。j 只是 java 这个词的一部分,它本身不是一个有效的词项。
如何实现输入 **j** 就能搜到 **java** 呢?
这正是现代搜索引擎改进的地方。为了实现这种“模糊”或“前缀”搜索,主要有以下几种技术:
- 前缀查询
-
- 原理:专门为词项构建一个前缀索引。例如,对于词项
java,系统会将其前缀j,ja,jav,java都单独记录下来并关联到java这个词项。 - 实现:这种数据结构通常使用 Trie树(字典树) 或 有限状态转换器(FST) 来实现,它们非常擅长处理前缀查询。
- 应用:这就是为什么您在搜索框输入内容时,下拉框会立刻出现搜索建议。
- 原理:专门为词项构建一个前缀索引。例如,对于词项
- N-gram 分词
-
- 原理:在构建索引时,除了完整的词项,还会将一个词切分成更小的片段。
- 例子:对于
java,可能会生成以下 bi-gram(2元语法)片段:ja,av,va。或者 character n-gram,如j,ja,av,va,a。 - 过程:搜索
j时,系统会查找所有包含j这个 n-gram 片段的词项(比如java,javascript,jquery),然后再找到这些词项对应的文档。 - 缺点:会使索引体积变得非常大。
- 通配符查询
-
- 有些搜索引擎支持通配符,比如搜索
j*,这意味着“查找所有以j开头的词项”。在底层,实现这种查询的技术通常就是上面提到的 前缀查询 或 反转索引(对反转后的词项也建一个索引,用于处理后缀查询)。
- 有些搜索引擎支持通配符,比如搜索
| 需求场景 | 推荐方案 | 优点 | 缺点 |
|---|---|---|---|
搜索框自动补全 (输入 j 提示 java) |
**completion** 提示器 |
性能极致,延迟极低 | 需要专门的数据结构和映射 |
| 简单的前缀搜索 | **prefix** 查询 |
使用简单,无需特殊映射 | 性能不如 completion,但优于通配符 |
复杂的模式匹配 (如 j*v?) |
**wildcard** 查询 |
功能最灵活 | 性能最差,容易有性能问题 |
任意部分的匹配 (如 av 匹配 java) |
N-gram 分词器 | 功能强大,匹配灵活 | 索引体积大,存储和查询开销高 |
对于您提出的“输入 j 搜到 java”这种典型的搜索框补全需求,在 ES 中最佳实践是使用 **completion** 提示器。它正是为这种高性能、低延迟的交互场景而设计的。
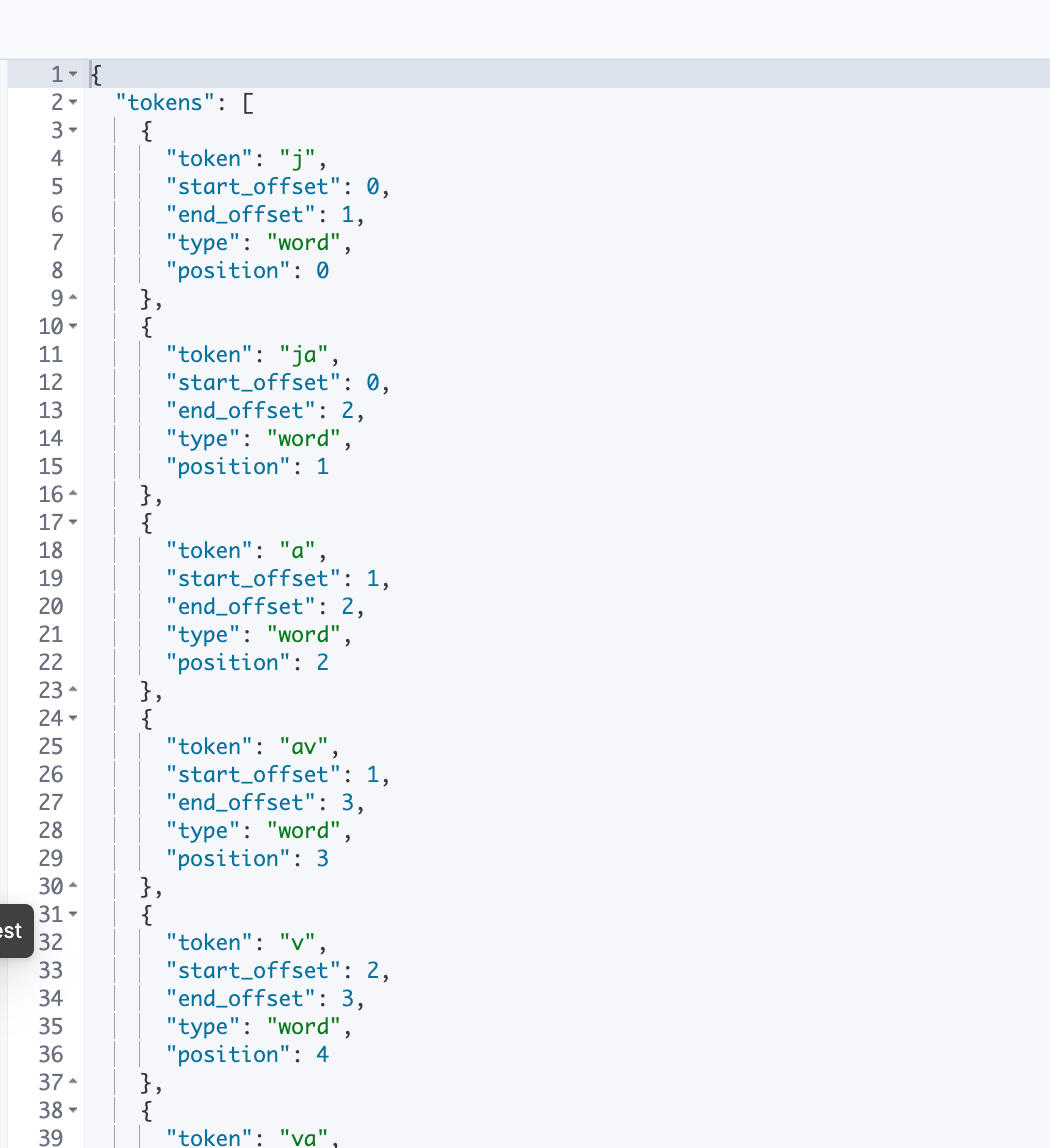
快速测试:
POST /_analyze
{
  "tokenizer": {
    "type": "ngram",
    "min_gram": 1,
    "max_gram": 2,
    "token_chars": ["letter", "digit"]
  },
  "text": "java学习"
}
评论区请在客户端页面查看