前言
本篇博客是Redis的学习笔记,若文章中出现相关问题,请指出!
所有博客文件目录索引:博客目录索引(持续更新)
一、Redis键(key)
由于redis是单线程的,其所有的操作都是原子性的!
# 查看
keys *:查看当前库所有key    (匹配:keys *1)
exists 【key】:判断某个key是否存在
type 【key】:查看你的key是什么类型

# 删除
del 【key】:删除指定的key数据
unlink 【key】:根据value选择非阻塞删除,仅将keys从keyspace元数据中删除,真正的删除会在后续异步操作。
	执行该命令后会直接将元数据进行删除并返回信息已删除,实际上内部并没有真正删除,后序会慢慢删掉,作一个异步的操作

# 设置过期时间
expire 【key】 10:10秒钟:为给定的key设置过期时间
ttl 【key】:查看还有多少秒过期,-1表示永不过期,-2表示已过期

# 数据库相关
select 【index】:命令切换数据库
dbsize:查看当前数据库的key的数量
flushdb:清空当前库
flushall:通杀全部库
二、Redis的五大数据类型
2.1、字符串(String)
2.1.1、简介
String是Redis最基本的类型,你可以理解成与Memcached一模一样的类型,一个key对应一个value。
String类型是二进制安全的。意味着Redis的string可以包含任何数据。比如jpg图片或者序列化的对象。
String类型是Redis最基本的数据类型,一个Redis中字符串value最多可以是512M
2.1.2、常用命令
①设置与获取键值对:
set 键 值  # 新增键值对,若是键相同的后新增的会覆盖之前的
setnx  键 值:只有在key不存在时,设置key的值,否则失败。
append 键 值:对某个字符串最后进行追加,也可以当做新建指令。
get 键    # 获取当前数据库中对应名的值,无查询结果(nil)
exists 键   # 存在为(integer) 0,不存在(integer) 1
DEL key  # 删除指定键,1表示删除成功,0表示删除失败
strlen 键:获取到该键的长度

# 设置/获取字符串指定范围,相当于substring
setrange  <key> <起始位置> <value>  # 用 <value>  覆写<key>所储存的字符串值,从<起始位置>开始(索引从0开始)
getrange  <key> <起始位置> <结束位置> # 获得值的范围,类似java中的substring,[begin,end]。类似于substring
②批量设置键值对:
mset 键1 值1 键2 值2   # 批量设置多个键值对,如 mset k1 v1 k2 v2  ,返回ok即为成功,可对已有的key进行覆盖。
mget 键1 键2 键3       # 批量获取多个,返回一个列表  如 mget key key1 key2 =》 1) "value"2) "value1"3) "value2"
msetnx 键1 值1 键2 值2  # 同时设置一个或多个 key-value 对,当且仅当所有给定 key 都不存在才能够新增键值对,一旦有一个失败,其他的也都不会新增成功。
③设置过期时间:对 key 设置过期时间,到时间会被自动删除,用来控制缓存的失效时间,过期可以是任意数据结构
expire <key> <过期时间>  # 设置键为key的过期时间  如 expire k1 10 => 键为k1的键值对在10秒后会被删除
# SETEX命令:相当于set+expire
setx <key> <过期时间> <value>  # 新增指定key,并且设置指定过期时间,单位秒。 如 setex p 10 p1  => 设置了p=p1的键值对,在10秒后删除
④计数:若是value为整数,可以使用incr命令另其进行自增操作
set count 100  # 设置键值对count=100,该value为整数# incr:自增1incr key  # 令键key的value自增1 如 incr count => (integer) 101# incrby:自增自定义数量incrby key increment # 令键key的value自增increment个1 如 incrby count 50 => (integer) 151
incr 键  # 该键是数字就会进行+1,否则执行失败。
decr 键  # 该键是数字就会进行-1,否则执行失败。
incrby / decrby  <key> <步长>  # 将 key 中储存的数字值增减。自定义步长。
⑤覆盖并返回值:GETSET,为 key 设置一个值并返回原有值
# 第一次执行该命令:创建键值对,返回nil(因为之前没有设置过该key)getset k3 v3# 第二次、第n次执行该命令:同样对k3进行操作getset k3 v4 # 将键为k3的value设置为v4,并且返回原有值v3
实际应用:对于某一些需要隔一段时间就统计的 key 很方便的设置和查看。例如:系统每当由用户进入的时候你就是用 INCR 命令操作一个 key,当需要统计时候你就把这个 key 使用 GETSET 命令重新赋值为0,这样就达到了统计的目的。
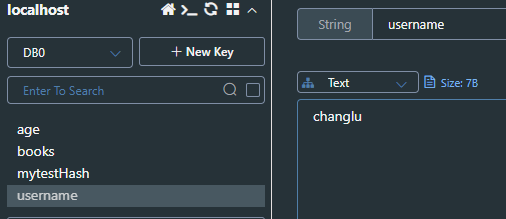
2.1.3、数据结构
String的数据结构为简单动态字符串(Simple Dynamic String,缩写SDS)。是可以修改的字符串,内部结构实现上类似于Java的ArrayList,采用预分配冗余空间的方式来减少内存的频繁分配。
- 简而言之:就是一旦string字符串的长度不够用就会进行动态扩容。
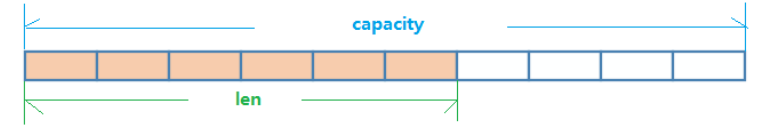
如图中所示,内部为当前字符串实际分配的空间capacity一般要高于实际字符串长度len。当字符串长度小于1M时,扩容都是加倍现有的空间,如果超过1M,扩容时一次只会多扩1M的空间。需要注意的是字符串最大长度为512M。
2.2、列表(List)
2.2.1、简介
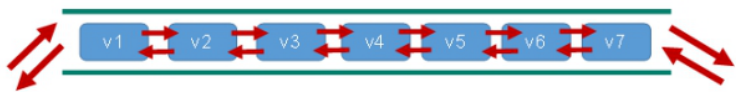
Redis列表是简单的字符串列表,按照插入顺序排序。相当于 Java 语言中的 LinkedList,注意它是链表而不是数组,你可以添加一个元素到列表的头部(左边)或者尾部(右边)。 list 的插入和删除操作非常快,时间复杂度为 O(1),但是索引定位很慢,时间复杂度为 O(n)。
它的底层实际是个双向链表,对两端的操作性能很高,通过索引下标的操作中间的节点性能会较差。
在redis中给出了左右添加、指定位置添加的一些API。
2.2.2、常用命令
# 查询(对于列表就不能够使用get)
lrange <key><start><stop>  # 按照索引下标获得元素(从左到右),坐标从0开始,获取某个key所有值,lrange k 0 -1
lindex <key><index>  # 按照索引下标获得元素(从左到右)。如:lindex k1 1,查询k1的左侧第二个元素内容
llen <key>  # 获得列表长度

# 新增
lpush/rpush <key> <value1><value2><value3> ....  # 从左边/右边插入一个或多个值。 如lpush k1 a b c,依次从k1的左边插入值
linsert <key> before/after <value><newvalue>   # 在<value>的前面或后面插入<newvalue>插入值。如:linsert k1 before b 66,插入值66到key为k1列表中值为b的前面

# 删除
lpop/rpop  <key>  # 从左边/右边吐出一个值。值在键在,值光键亡。如lpop k1,从左边弹出一个元素。
lrem <key><n><value>   # 从左边删除n个value(从左到右)。如:lrem k1 2 66,删除key为k1中列表的前两个值66

# 删除+插入
rpoplpush <key1> <key2>  # 从<key1>列表右边吐出一个值,插到<key2>列表左边。如:rpoplpush k2 k1,从k2左边弹出一个元素插入到k1中(从左边插入)

# 替换
lset <key><index><value>  # 将列表key下标为index的值替换成value。如:lset k1 0 789,key为k1的列表从左开始第1个替换为789
2.2.3、实现队列、栈
list实现队列
队列是先进先出的数据结构,常用于消息排队和异步逻辑处理,它会确保元素的访问顺序
127.0.0.1:6379> rpush mylist books python java golang   # 创建一个队列,并向底部插入四个值
(integer) 4
127.0.0.1:6379> lpop mylist  # mylist从左(头部)弹出一个值(即从链表中删除)
"books"
127.0.0.1:6379>  lpop mylist
"python"
127.0.0.1:6379>  lpop mylist
"java"
127.0.0.1:6379>  lpop mylist  # mylist从左弹出最后一个值时,就会自动删除该列表即key为mylist就会被删除掉
"golang"
注意:每次弹出都会将原本列表中的元素移除,直至最后一个元素被移除键值对销毁!
list实现栈
栈是先进后出的数据结构,将上面队列的从左取改为从右取(也就是底部)即可实现栈。
127.0.0.1:6379> rpush mylist books python java golang
(integer) 4
127.0.0.1:6379> rpop mylist  # 这里改为从链表底部弹出,即可实现栈!
"golang"
127.0.0.1:6379> rpop mylist
"java"
127.0.0.1:6379> rpop mylist
"python"
127.0.0.1:6379> rpop mylist
"books"
127.0.0.1:6379> exists mylist
(integer) 0
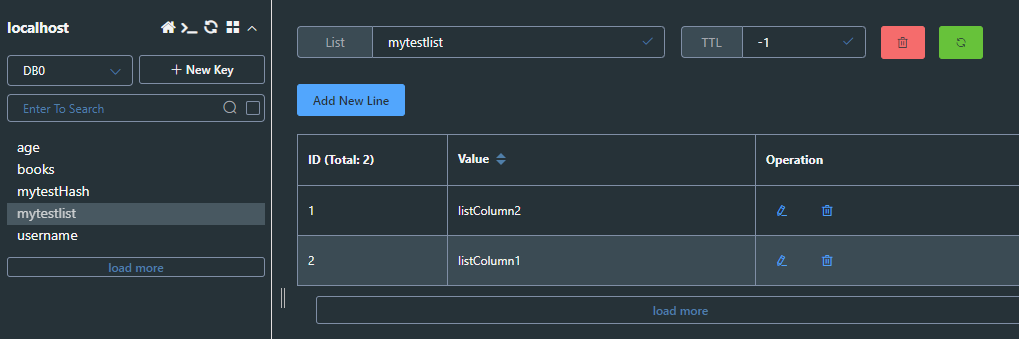
2.2.4、数据结构
List的数据结构为快速链表quickList,这是最终形态,其中还包含了ziplist。
①首先在列表元素较少的情况下会使用一块连续的内存存储,这个结构是ziplist,也即是压缩列表。
- 它将所有的元素紧挨着一起存储,分配的是一块连续的内存。
②当数据量比较多的时候才会改成quicklist。
-
因为普通的链表需要的附加指针空间太大,会比较浪费空间。比如这个列表里存的只是int类型的数据,结构上还需要两个额外的指针
prev和next。
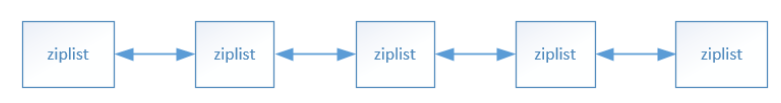
Redis将链表和ziplist结合起来组成了quicklist。也就是将多个ziplist使用双向指针串起来使用。这样既满足了快速的插入删除性能,又不会出现太大的空间冗余。下面就是quicklist,由ziplist组成:
2.3、集合(Set)
2.3.1、简介
Redis set对外提供的功能与list类似是一个列表的功能,特殊之处在于set是可以自动排重的,当你需要存储一个列表数据,又不希望出现重复数据时,set是一个很好的选择,并且set提供了判断某个成员是否在一个set集合内的重要接口,这个也是list所不能提供的。
Redis的Set是string类型的无序集合。它底层其实是一个value为null的hash表,所以添加,删除,查找的复杂度都是O(1)。
2.3.2、常用命令
# 查询
smembers <key>  # 取出该集合的所有值,无序。
sismember <key> <value>   # 判断集合<key>是否为含有该<value>值,有1,没有0
scard <key>  # 返回该集合的元素个数。

# 随机
spop <key>   # 随机从该集合中吐出一个值。
srandmember <key> <n>   # 随机从该集合中取出n个值(默认不写n,查看1个)。不会从集合中删除 。

# 添加
sadd <key> <value1><value2> .....  # 将一个或多个 member 元素加入到集合 key 中,已经存在的 member 元素将被忽略(去重)

# 删除
srem <key> <value1><value2> ....   # 删除集合中的某个元素,若是某个值不存在也不影响删除。

# 移动
smove <source> <destination> value   # 把集合中一个值从一个集合移动到另一个集合。如:smove k2 k1 bb,将k2中的值bb取出并移动到k1中

# 交、并、查集
sinter <key1> <key2>   # 返回两个集合的交集元素。
sunion <key1> <key2>   # 返回两个集合的并集元素。
sdiff  <key1> <key2>     # 返回两个集合的差集元素(key1中有的,key2中没有的)
2.3.3、数据结构
Set数据结构是dict字典,字典是用哈希表实现的。
Java中HashSet的内部实现使用的是HashMap,只不过所有的value都指向同一个对象。Redis的set结构也是一样,它的内部也使用hash结构,所有的value都指向同一个内部值。
2.4、哈希(Hash)
2.4.1、简介
介绍
Redis hash是一个键值对集合。
Redis hash是一个string类型的field和value的映射表,hash特别适合用于存储对象。类似Java里面的Map<String,Object>。
hash也有缺点:hash 结构的存储消耗要高于单个字符串,所以到底该使用 hash 还是字符串,需要根据实际情况再三权衡。
实际应用
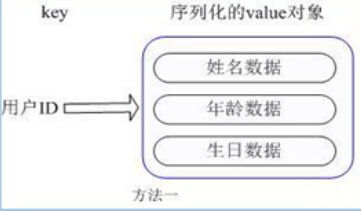
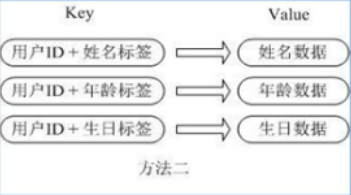
用户ID为查找的key,存储的value用户对象包含姓名,年龄,生日等信息,如果用普通的key / value结构来存储。
主要有以下2种存储方式:采用字符串类型存储(key,value),不推荐这样存储
方式一:value存储的是json序列化的字符串内容
- 缺点:每次修改用户的某个属性需要,先反序列化改好后再序列化回去。开销较大。
方式二:key存储的是对应的用户id+属性,value是对应属性值
- 缺点:用户ID数据冗余。
上面的两种方式不推荐使用,对于一个对象存储我们最好使用**哈希(hash)**来存储:
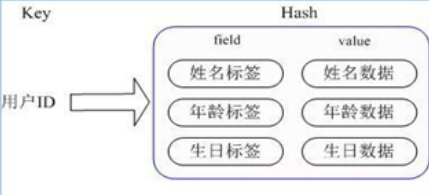
优点:通过 key(用户ID) + field(属性标签) 就可以操作对应属性数据了,既不需要重复存储数据,也不会带来序列化和并发修改控制的问题。
2.4.2、常用命令
# 查询
hget <key1><field>从<key1>集合<field>取出 value
hkeys <key>列出该hash集合的所有field
hvals <key>列出该hash集合的所有value

# 新增
hset <key> <field><value>  # 给<key>集合中的  <field>键赋值<value>
hsetnx <key> <field><value> # 将哈希表 key 中的域 field 的值设置为 value ,当且仅当域 field 不存在 .
hmset <key1> <field1><value1> <field2><value2>... # 批量设置hash的值
hincrby <key> <field> <increment>  # 为哈希表 key 中的域 field 的值加上指定增加值 1成功,-1失败。

# 检测是否存在
hexists<key1><field>  # 查看哈希表 key 中,给定域 field 是否存在。
2.4.3、数据结构
Hash类型对应的数据结构是两种:ziplist(压缩列表),hashtable(哈希表)。
当field-value长度较短且个数较少时,使用ziplist,否则使用hashtable。
原理分析
Redis中的字典相当于 Java 中的 HashMap,通过 "数组 + 链表" 的链地址法来解决部分哈希冲突,结构也吸收了两种不同数据结构的优点。
字典结构的内部包含两个 hashtable,通常情况下只有一个hashtable 是有值的,但是在字典扩容缩容时,需要分配新的 hashtable,然后进行 渐进式搬迁。
渐进式Rehash过程:渐进式 rehash 会在 rehash 的同时,保留新旧两个 hash 结构,如上图所示,查询时会同时查询两个hash 结构,然后在后续的定时任务以及 hash 操作指令中,循序渐进的把旧字典的内容迁移到新字典中。当搬迁完成了,就会使用新的 hash 结构取而代之
扩缩容的条件:当 hash 表中 元素的个数等于第一维数组的长度时,就会开始扩容,扩容的新数组是 原数组大小的 2 倍。如果 Redis 正在做 bgsave(持久化命令) ,为了减少内存也得过多分离,Redis 尽量不去扩容,但是如果 hash 表非常满了,达到了第一维数组长度的 5 倍了,这个时候就会 强制扩容。
当 hash 表因为元素逐渐被删除变得越来越稀疏时,Redis 会对 hash 表进行缩容来减少 hash 表的第一维数组空间占用。所用的条件是元素个数低于数组长度的 10%,缩容不会考虑 Redis 是否在做bgsave。
2.5、有序集合Zset(sorted set)
2.5.1、简介
Redis有序集合zset与普通集合set非常相似,是一个没有重复元素的字符串集合。
不同之处是有序集合的每个成员都关联了一个评分(score),这个评分(score)被用来按照从最低分到最高分的方式排序集合中的成员。集合的成员是唯一的,但是评分可以是重复了 。
因为元素是有序的, 所以你也可以很快的根据评分(score)或者次序(position)来获取一个范围的元素。
访问有序集合的中间元素也是非常快的,因此你能够使用有序集合作为一个没有重复成员的智能列表。
2.5.2、常用命令
# 查
zrange <key> <start><stop>  [WITHSCORES]   # 返回有序集 key 中,下标在<start><stop>之间的元素带WITHSCORES,可以让分数一起和值返回到结果集。如:zrange topn  0 -1 withscores,查询所有元素并带分数
zrangebyscore key min max [withscores] [limit offset count]   # 返回有序集 key 中,所有 score 值介于 min 和 max 之间(包括等于 min 或 max )的成员。有序集成员按 score 值递增(从小到大)次序排列。 如:zrangebyscore  topn  100 400 withscores,分数在[100,400]之间的成员带分数
zrevrangebyscore key max min [withscores] [limit offset count]  # 同上,改为从大到小排列。 注意分数区间也要倒过来。如:zrevrangebyscore  topn  400 100 withscores。

# 统计
zcount <key> <min><max>   # 统计该集合,分数区间内的元素个数
zrank <key> <value>       # 返回该值在集合中的排名,从0开始。

# 增
zadd  <key><score1><value1><score2><value2>…   # 将一个或多个 member 元素及其 score 值加入到有序集 key 当中。如:zadd topn 200 java 300 python 100 c++ 600 vb,key名称为topn。后面对应首先是score分数,接着是对应的value,一对一对的
zincrby <key><increment><value>      # 为元素的score加上增量。如:zincrby topn 20 vb,给value为vb的分数+20。

# 删除
zrem <key> <value>  # 删除该集合下,指定值的元素
实际应用:zset实现一个文章访问量的排行版?
# 1、下面这条指令记录了key为text的5个专栏的阅读量
zadd text 1000 Java 100 Python 40 php 60 C 200 JQuery
# 2、显示所有并且从小到大排序
zrange text 0 -1
# 3、根据所选范围从大到小排序
zrevrangebyscore text 200 10
2.5.3、数据结构(重点:跳跃表)
认识底层数据结构
SortedSet(zset)是Redis提供的一个非常特别的数据结构,一方面它等价于Java的数据结构Map<String, Double>,可以给每一个元素value赋予一个权重score,另一方面它又类似于TreeSet,内部的元素会按照权重score进行排序,可以得到每个元素的名次,还可以通过score的范围来获取元素的列表。
zset底层使用了两个数据结构
- hash,hash的作用就是关联元素value和权重score,保障元素value的唯一性,可以通过元素value找到相应的score值。
- 跳跃表,跳跃表的目的在于给元素value排序,根据score的范围获取元素列表。
跳跃表
有序集合在生活中比较常见,例如根据成绩对学生排名,根据得分对玩家排名等。
对于有序集合的底层实现,可以用数组、平衡树、链表等。数组不便元素的插入、删除;
-
平衡树或红黑树虽然效率高但结构复杂;
-
链表查询需要遍历所有效率低。
Redis采用的是跳跃表。跳跃表效率堪比红黑树,实现远比红黑树简单。
实例对比:同样查询51
①首先是普通有序链表
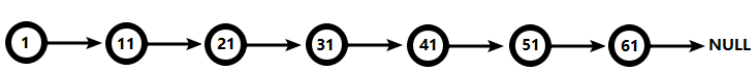
要查找值为51的元素,需要从第一个元素开始依次查找、比较才能找到。共需要6次比较。
②跳跃表
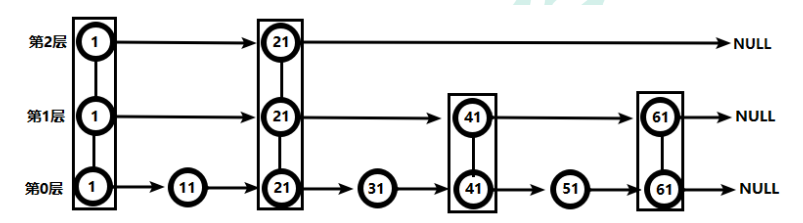
首先从2层出发,1->21,51比21大,继续往后,后面是null没有找到,那么进入到第1层。
从第1层的21出发,21->41,51比41大,继续往后,是61,61>51,回到41,进入到第0层。
从第0层41出发,41->51,最终找51。
总共进行4次查找定位,从高层开始逐步再进行定位。
从此可以看出跳跃表比有序链表效率要高!
三、新数据类型(三种)
3.1、Bitmaps
应用场景:记录网站访客来访、统计访客、最近登录...
3.1.1、简介
本质就是一组字符串,该字符串能够按位计算
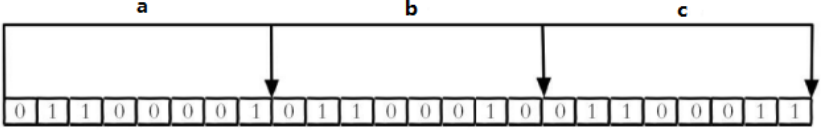
现代计算机用二进制(位) 作为信息的基础单位, 1个字节等于8位, 例如“abc”字符串是由3个字节组成, 但实际在计算机存储时将其用二进制表示, “abc”分别对应的ASCII码分别是97、 98、 99, 对应的二进制分别是01100001、 01100010和01100011,如下图:
合理地使用操作位能够有效地提高内存使用率和开发效率。Redis提供了Bitmaps这个“数据类型”可以实现对位的操作:
(1)Bitmaps本身不是一种数据类型, 实际上它就是字符串(key-value) , 但是它可以对字符串的位进行操作。
(2)Bitmaps单独提供了一套命令, 所以在Redis中使用Bitmaps和使用字符串的方法不太相同。 可以把Bitmaps想象成一个以位为单位的数组, 数组的每个单元只能存储0和1, 数组的下标在Bitmaps中叫做偏移量。

3.1.2、命令
3.1.2.1、setbit
格式
setbit <key> <offset> <value>:设置Bitmaps中某个偏移量的值(0或1)。*offset:偏移量从0开始
实例
每个独立用户是否访问过网站存放在Bitmaps中, 将访问的用户记做1, 没有访问的用户记做0, 用偏移量作为用户的id。
设置键的第offset个位的值(从0算起), 假设现在有20个用户,userid=1, 6, 11, 15, 19的用户对网站进行了访问, 那么当前
Bitmaps初始化结果如图:示例图如下,返回值表示是在此之前的值
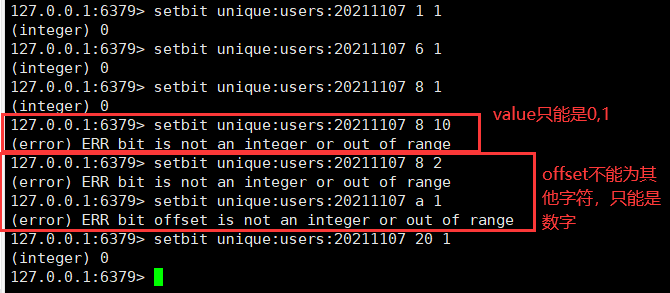
下面是一个下标实际就是offset,对应的值只能是0或1。
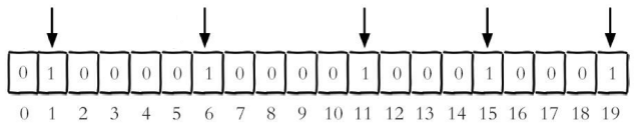
- ps:这里只做演示,并不与上面命令行相对应。
注意点说明:很多应用的用户id以一个指定数字(例如10000) 开头, 直接将用户id和Bitmaps的偏移量对应势必会造成一定的浪费, 通常的做法是每次做setbit操作时将用户id减去这个指定数字。在第一次初始化Bitmaps时, 假如偏移量非常大, 那么整个初始化过程执行会比较慢, 可能会造成Redis的阻塞。
3.1.2.2、getbit
格式
getbit <key> <offset>:获取Bitmaps中某个偏移量的值,0或1。获取键的第offset位的值(从0开始算)
实例
应用:获取id=8的用户是否在2020-11-06这天访问过, 返回0说明没有访问过,1则表示访问过。
getbit unique:users:20211107 8
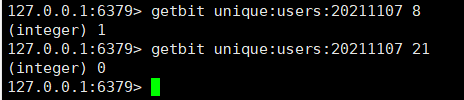
通过该命令我们即可判断出该用户是否在指定的日期访问过!第二条返回0,则表示没有set过或者其他的含义。
3.1.2.3、bitcount(统计)
概念
统计字符串被设置为1的bit数。一般情况下,给定的整个字符串都会被进行计数,通过指定额外的 start 或 end 参数,可以让计数只在特定的位上进行。
start和end参数的设置,都可以使用负数值:比如 -1 表示最后一个位,而 -2 表示倒数第二个位,start、end 是指bit组的字节的下标数,二者皆包含。
语法
bitcount <key> [start end]: 统计字符串从start字节到end字节比特值为1的数量,start从0开始计。若是想获取所有位如:bitcount unique:users:20211107 0 -1
实例
应用:计算2021-11-07这天的独立访问用户数量。
bitcount unique:users:20211107 0 2
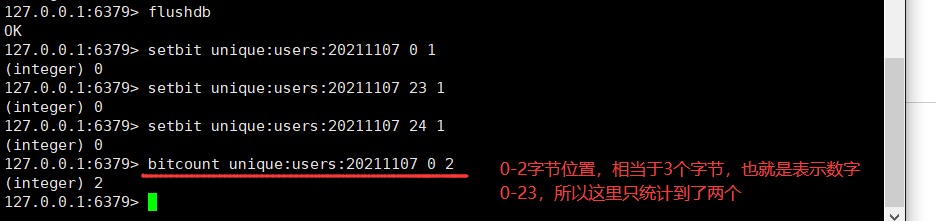
我觉得这一个例子完全够了: K1 【01000001 01000000 00000000 00100001】,对应【0,1,2,3】字节。
注意:redis的setbit设置或清除的是bit位置,而bitcount计算的是byte位置。
3.1.2.4、bitop(复合操作,可进行交、或、非、异)
格式
bitop and(or/not/xor) <destkey> [key…]:bitop是一个复合操作, 它可以做多个Bitmaps的and(交集) 、 or(并集) 、 not(非) 、 xor(异或) 操作并将结果保存在destkey中。
实例
2020-11-04 日访问网站的userid=1,2,5,9。
setbit unique:users:20201104 1 1
setbit unique:users:20201104 2 1
setbit unique:users:20201104 5 1
setbit unique:users:20201104 9 1

2020-11-03 日访问网站的userid=0,1,4,9。
setbit unique:users:20201103 0 1
setbit unique:users:20201103 1 1
setbit unique:users:20201103 4 1
setbit unique:users:20201103 9 1
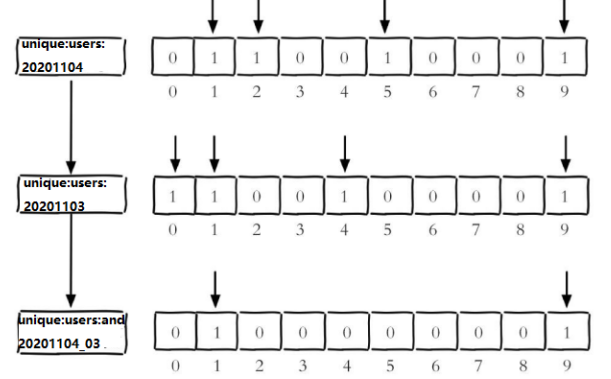
要求1:计算出两天都访问过网站的用户数量。
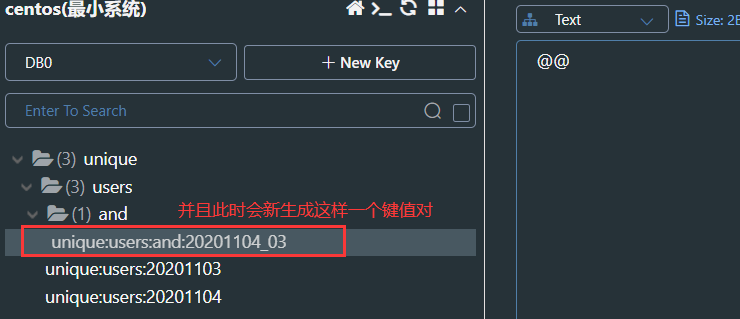
bitop and unique:users:and:20201104_03 unique:users:20201103 unique:users:20201104:and表示交集,第三个则是后面两个合并后的值赋到该key上。
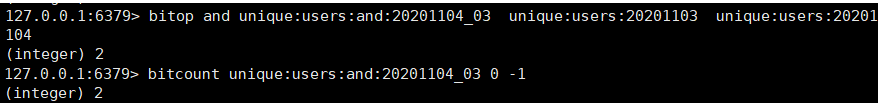
最终统计出了2个
整个过程如下:
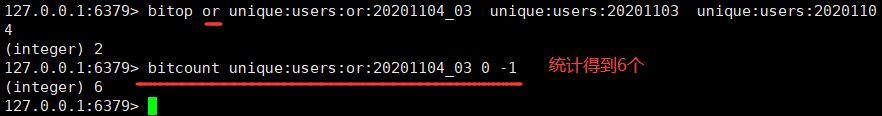
要求2:计算出任意一天都访问过网站的用户数量(例如月活跃就是类似这种)。此时就可以使用or来求。
# 进行or或操作
bitop or unique:users:or:20201104_03  unique:users:20201103  unique:users:20201104
# 统计值
bitcount unique:users:or:20201104_03 0 -1
3.1.3、Bitmaps(redis)与set(Java集合)对比
假设网站有1亿用户, 每天独立访问的用户有5千万, 如果每天用集合类型Set和Bitmaps分别存储活跃用户可以得到表。
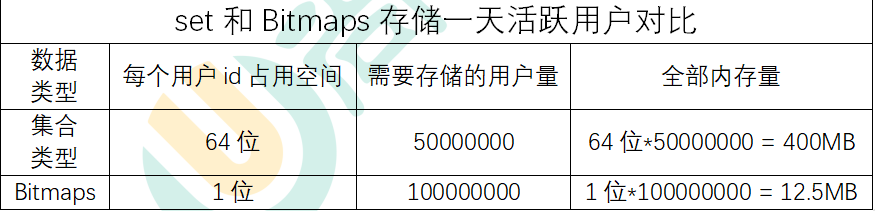
很明显, 这种情况下使用Bitmaps能节省很多的内存空间, 尤其是随着时间推移节省的内存还是非常可观的。
但Bitmaps并不是万金油, 假如该网站每天的独立访问用户很少, 例如只有10万(大量的僵尸用户),那么两者的对比如下表所示, 很显然, 这时候使用Bitmaps就不太合适了, 因为基本上大部分位都是0。
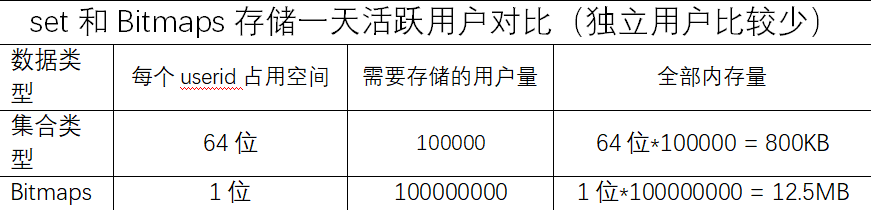
总结:任何数据结构有优势的地方也会有劣势的地方,若是用户数据量特别大并且日活跃量也特别多那么推荐使用Bitmaps相对更能够省内存量(每个比特为都能够利用起来);若是活跃用户较少并且用户量也较多,那么使用Bitmaps的话就可能会造成大量位浪费。
整理者:长路 时间:2021.11.6
评论区请在客户端页面查看